Абстракция
Асбтрация - это путь к тому, чтобы опустить излишнюю сложность.
Пример - когда мы используем в работе библиотеки, мы не должны уметь ее писать.
Абстракция базы данных
Транзакции — это абстракция базы данных, которая скрывает множество проблемных результатов, когда одновременные пользователи читают, пишут или изменяют данные, и предоставляет простой интерфейс фиксации в случае успеха или отмены в случае неудачи.
В любом случае данные перемещаются из одного согласованного состояния в новое согласованное состояние. Транзакция позволяет конечным пользователям не увязнуть в тонких угловых случаях одновременной мутации данных, а сосредоточиться на своей бизнес-логике.
https://habr.com/ru/articles/537594/
Рубрика объясни мне это будто мне 10 лет
Представь, что ты играешь в компьютерную игру, где нужно выполнять разные задания. Когда ты выполняешь задание, игра сама сохраняет твой прогресс. Если ты что-то делаешь неправильно, ты можешь вернуться назад и попробовать снова.
Транзакции в базе данных работают похожим образом. Когда много людей одновременно работают с одними и теми же данными (например, покупают игрушки в интернет-магазине), транзакция помогает все правильно организовать. Если всё прошло хорошо, изменения сохраняются, как будто ты успешно прошел уровень в игре. Если что-то пошло не так, можно "откатиться назад" и попробовать снова.
Почему это важно?
Транзакция делает так, чтобы все данные оставались правильными, даже если многие люди работают с ними одновременно. Это как если бы в игре, независимо от того, сколько игроков участвуют, всегда был порядок, и каждый мог сосредоточиться на своих задачах, не беспокоясь о том, что кто-то другой сломает игру.
Абстракции в распределенных системах
Абстракции в распределенных системах помогают инженерам упростить свою работу и снять с них бремя работы с базовой сложностью распределенных систем.
Абстракция распределенных систем стала популярной, поскольку многие крупные компании, такие как Amazon AWS, Google Cloud и Microsoft Azure, предоставляют распределенные сервисы. Каждый сервис предлагает разные уровни абстракции. Детали реализации этих распределенных сервисов скрыты от пользователей, что позволяет разработчикам сосредоточиться на приложении, а не вникать в глубины распределенных систем, которые часто очень сложны.
Современные приложения не могут оставаться отзывчивыми/функциональными, если они основаны на одном узле из-за экспоненциально растущего числа пользователей. Абстракции в распределенных системах помогают инженерам быстро переходить на распределенные системы для масштабирования своих приложений.
Рубрика объясни мне это будто мне 10 лет
Абстракции в распределенных системах
Представь, что ты строишь огромный город из LEGO. В этом городе много зданий, дорог и мостов, и они все соединены между собой. Но тебе не нужно строить каждую деталь с нуля — у тебя есть готовые блоки и инструкции, как их соединять. Эти блоки и инструкции — это как абстракции в распределенных системах.
Абстракции помогают инженерам упростить работу с очень сложными системами. Вместо того чтобы разбираться во всех мелочах, инженеры используют готовые решения, которые делают часть работы за них. Например, компании вроде Amazon, Google и Microsoft уже сделали много сложной работы, и теперь они предлагают другим людям использовать их готовые решения.
Почему это важно?
Вместо того чтобы самому собирать каждую деталь и проводить много времени на этом, ты можешь использовать готовые блоки и быстрее построить свой город. Это позволяет тебе сосредоточиться на создании чего-то уникального и интересного, а не на том, чтобы разбираться, как работают все мелкие детали.
Точно так же современные приложения и игры, которые используют тысячи и миллионы людей, не могут работать быстро и стабильно, если они зависят от одного компьютера. Благодаря абстракциям инженеры могут легко подключать больше серверов и быстро адаптировать свои приложения под растущее количество пользователей, не вникая в сложные технические подробности.
Сетевые абстракции: удаленные вызовы процедур - Network Abstractions: Remote Procedure Calls
Удаленные вызовы процедур (RPC) предоставляют разработчикам абстракцию локального вызова процедуры, скрывая сложности упаковки и отправки аргументов функции на удаленный сервер, получения возвращаемых значений и управления любыми сетевыми повторными попытками.
Remote procedure calls (RPCs) provide an abstraction of a local procedure call to the developers by hiding the complexities of packing and sending function arguments to the remote server, receiving the return values, and managing any network retries.
Что такое RPC?
RPC — это протокол межпроцессного взаимодействия, который широко используется в распределенных системах. В модели OSI сетевого взаимодействия RPC охватывает транспортный и прикладной уровни.
Механизмы RPC используются, когда компьютерная программа вызывает выполнение процедуры или подпрограммы в отдельном адресном пространстве.
Примечание: процедура или подпрограмма кодируется как обычный/локальный вызов процедуры без явного кодирования программистом деталей для удаленного взаимодействия.
Среда выполнения RPC отвечает за передачу сообщений между клиентом и сервером через сеть. Обязанности среды выполнения RPC также включают повторную передачу, подтверждение и шифрование.
Как работает RPC?
Когда мы делаем удаленный вызов процедуры, вызывающая среда приостанавливается, и параметры процедуры отправляются по сети в среду, где должна быть выполнена процедура.
Когда выполнение процедуры завершается, результаты возвращаются в вызывающую среду, где выполнение возобновляется как обычный вызов процедуры.
Чтобы увидеть, как это работает, давайте рассмотрим пример клиент-серверной программы. В программе RPC задействовано пять основных компонентов, как показано на следующем рисунке:
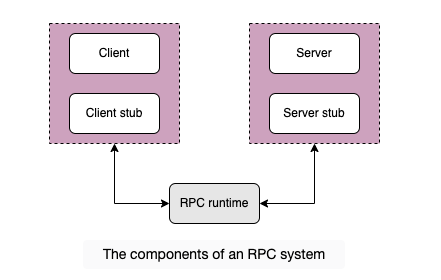
На клиентском компьютере работают клиент, заглушка клиента и один экземпляр среды выполнения RPC. На сервере работают сервер, заглушка сервера и один экземпляр среды выполнения RPC.
В процессе RPC происходят следующие этапы:
- Клиент инициирует процесс клиентской заглушки, передавая параметры как обычно. Клиентская заглушка хранится в адресном пространстве клиента.
- Клиентская заглушка преобразует параметры в стандартизированный формат и упаковывает их в сообщение. После упаковки параметров в сообщение клиентская заглушка запрашивает у локального времени выполнения RPC доставку сообщения на сервер.
- Время выполнения RPC на клиенте передает сообщение на сервер по сети. После отправки сообщения серверу клиент ожидает ответное сообщение от сервера.
- Время выполнения RPC на сервере получает сообщение и передает его серверной заглушке.
Примечание: Время выполнения RPC отвечает за передачу сообщений между клиентом и сервером через сеть. К обязанностям времени выполнения RPC также относятся повторная передача, подтверждение и шифрование.
- Серверная заглушка распаковывает сообщение, извлекает из него параметры и вызывает необходимую серверную процедуру с помощью локального вызова процедуры для выполнения требуемого действия.
Рабочий процесс RPC:
- После выполнения серверной процедуры результат передается обратно серверной заглушке.
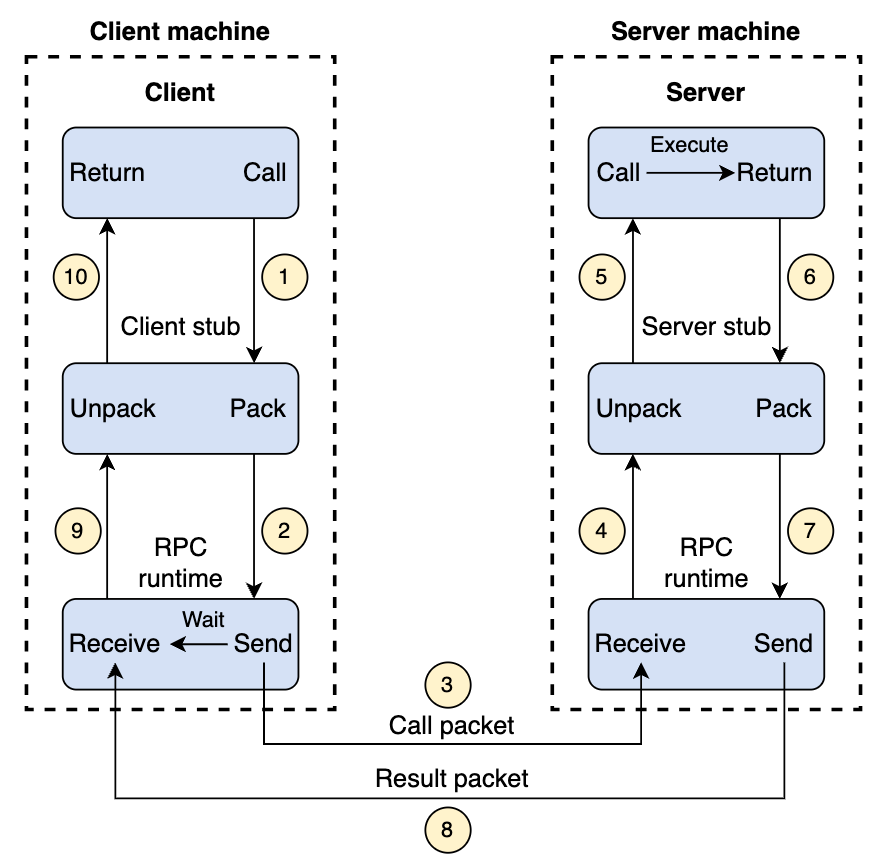
- Серверная заглушка упаковывает результат в сообщение и отправляет его в RPC время выполнения на стороне сервера на транспортном уровне.
- Время выполнения RPC на сервере передает упакованный результат времени выполнения RPC на стороне клиента через сеть.
- Время выполнения RPC на клиенте, которое ожидало результат, получает его и передает клиентской заглушке.
- Клиентская заглушка распаковывает результат, и процесс выполнения возвращается к вызывающему процессу на этом этапе.
Реальное использование
RPC используются во многих реальных сервисах. Взгляните на примеры, приведенные ниже
- Google: Google использует RPC в различных частях своей распределенной инфраструктуры. Они разработали gRPC, фреймворк с открытым исходным кодом, который использует RPC для создания эффективных и высокопроизводительных распределенных систем. Он используется для таких сервисов, как Google Search, YouTube и т. д., где он позволяет Google поддерживать связь и обмен данными между различными компонентами своих сервисов, что необходимо для достижения производительности в реальном времени.
- Uber: Uber использует RPC для различных функций, включая отслеживание местоположения в реальном времени, сопоставление поездок и связь между водителями и пассажирами. RPC позволяет Uber предоставлять быстрые и отзывчивые сервисы, упрощая обмен данными между приложением пользователя и сервером.
- Facebook: Большинство сервисов в Facebook написаны с использованием Thrift для RPC, а некоторые системы хранения используют Thrift для сериализации записей на диске. Это дает Facebook несколько преимуществ. Например, он обеспечивает взаимодействие между различными языками, такими как клиент Python, взаимодействующий с сервером C++.
Резюме
Метод RPC похож на вызов локальной процедуры, за исключением того, что вызываемая процедура обычно выполняется в другом процессе и на другом компьютере.
RPC позволяет разработчикам создавать приложения поверх распределенных систем. Разработчики могут использовать метод RPC, не зная деталей сетевого взаимодействия. В результате они могут сосредоточиться на аспектах проектирования, а не на специфике машинного и коммуникационного уровня.
Рубрика объясни мне это будто мне 10 лет
Что такое RPC?
Представь, что у тебя есть друг, который живет в другом городе. Ты хочешь, чтобы он помог тебе с домашним заданием, но не можешь пойти к нему лично. Вместо этого ты отправляешь ему сообщение с вопросами, и он отправляет тебе ответы.
RPC (Удаленный вызов процедур) — это что-то похожее. Это способ для одного компьютера (назовем его "клиент") попросить другой компьютер (назовем его "сервер") выполнить какое-то задание. Клиент отправляет сообщение с запросом, сервер выполняет работу и отправляет результаты обратно.
Почему это полезно?
Допустим, у тебя есть игрушечный робот, но он слишком далеко, чтобы управлять им напрямую. Вместо этого у тебя есть пульт управления. Когда ты нажимаешь кнопку на пульте, робот движется. RPC — это как пульт управления для робота, но вместо робота это другой компьютер, который выполняет за тебя задачи.
Spectrum of Consistency Models - Спектр моделей согласованности
Что такое согласованность?
В распределенных системах согласованность может означать много вещей.
Во-первых, каждый узел-реплика имеет одинаковое представление данных в определенный момент времени.
Во-вторых, каждый запрос на чтение получает значение недавней записи.
Это не единственные определения согласованности, поскольку существует множество форм согласованности. Обычно модели согласованности предоставляют нам абстракции для рассуждений о корректности распределенной системы, выполняющей параллельные чтения, записи и мутации данных.
Если нам нужно спроектировать или создать приложение, в котором нам нужна сторонняя система хранения, такая как S3 или Cassandra, мы можем изучить гарантии согласованности, предоставляемые S3, чтобы решить, использовать ее или нет. Давайте рассмотрим различные типы согласованности.
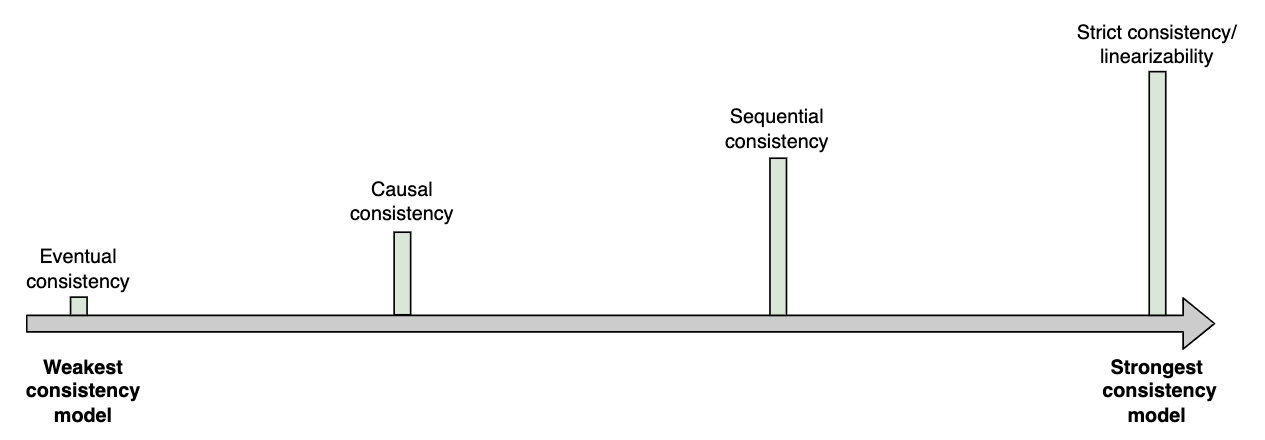
Два конца спектра согласованности:
- Самая сильная согласованность
- Самая слабая согласованность
Между этими двумя концами лежат модели согласованности, некоторые из которых показаны на следующем рисунке
Рубрика объясни мне это будто мне 10 лет
Что такое консистентность?
Представь, что у тебя есть несколько коробок с игрушками, и эти коробки находятся в разных комнатах. Консистентность — это когда в каждой коробке всегда лежат одинаковые игрушки. Если ты добавишь игрушку в одну коробку, она должна появиться в других коробках тоже, чтобы во всех коробках был одинаковый набор игрушек.
Два варианта консистентности
- Самая сильная консистентность: Когда ты кладешь новую игрушку в одну коробку, она сразу же появляется во всех остальных коробках. Это значит, что, заглянув в любую коробку в любой момент, ты всегда увидишь одинаковый набор игрушек.
- Самая слабая консистентность: Когда ты кладешь новую игрушку в одну коробку, она может не сразу появиться в других коробках. Если ты сразу заглянешь в другую коробку, там может не быть новой игрушки, но через некоторое время она все равно там окажется.
Почему это важно?
Представь, что ты играешь в прятки с друзьями и нужно, чтобы у всех были одинаковые игрушки в коробках. Если игрушки появляются в других коробках сразу, то играть будет легко. Но если игрушки появляются с задержкой, то нужно будет подождать, чтобы все снова было одинаково. Выбирая, как быстро игрушки должны появляться в коробках, ты выбираешь между самой сильной и самой слабой консистентностью.
Мы сталкиваемся с консистентность в 2 местах сразу. Cуществует разница между консистентностью в ACID-свойствах и консистентностью в теореме CAP. Вот в чем разница:
Консистентность в ACID-свойствах (Atomicity, Consistency, Isolation, and Durability)
ACID — это набор свойств, которые определяют поведение транзакции в базе данных:
- Atomicity (Атомарность): Транзакция выполняется либо полностью, либо не выполняется вовсе. Если одна часть транзакции не удается, вся транзакция откатывается.
- Consistency (Консистентность): Консистентность в ACID означает, что транзакция переводит базу данных из одного правильного состояния в другое правильное состояние, соблюдая все правила, ограничения и триггеры базы данных. Перед началом и после завершения транзакции база данных находится в согласованном состоянии.
- Isolation (Изоляция): Транзакции выполняются независимо друг от друга. Промежуточные состояния одной транзакции не видны другим транзакциям.
- Durability (Долговечность): После завершения транзакции ее результаты сохраняются навсегда. Даже если система выйдет из строя, изменения, сделанные транзакцией, не будут потеряны.
Консистентность в ACID основывается на правилах базы данных. Если схема определяет, что значение должно быть уникальным, то консистентная система гарантирует, что это значение останется уникальным во всех операциях. Если внешний ключ указывает, что при удалении одной строки должны быть удалены и связанные строки, то консистентная система гарантирует, что после удаления базовой строки связанных строк не останется.
Консистентность в теореме CAP
Теорема CAP относится к распределенным системам и утверждает, что невозможно обеспечить одновременно все три следующие свойства в распределенной системе:
- Consistency (Консистентность): Каждый запрос на чтение получает самые последние данные, которые были записаны, или ошибку.
- Availability (Доступность): Каждый запрос на чтение или запись получает ответ (успех или отказ), но система всегда доступна.
- Partition Tolerance (Устойчивость к разделению): Система продолжает работать, даже если существует разделение сети, которое нарушает связь между узлами системы.
Консистентность в CAP гарантирует, что в распределенной системе каждая реплика одного и того же логического значения имеет одно и то же точное значение в любой момент времени. Важно отметить, что это логическая, а не физическая гарантия. Из-за скорости света распространение данных по всему кластеру может занять некоторое время. Однако, предотвращая доступ клиентов к различным значениям на отдельных узлах, кластер все равно может предоставить логически согласованную картину.
В чем разница?
- Консистентность в ACID касается внутреннего состояния базы данных после выполнения транзакции, гарантируя, что все правила и ограничения соблюдаются.
- Консистентность в CAP касается согласованности данных в распределенной системе, обеспечивая, что все узлы видят одно и то же состояние данных в один и тот же момент времени, несмотря на возможные разделения сети.
Таким образом, хотя оба понятия связаны с тем, чтобы данные оставались правильными, они относятся к разным аспектам систем и имеют разные цели.
Eventual consistency
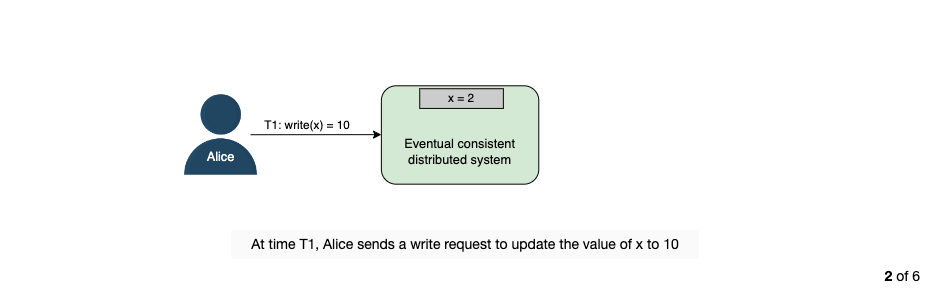
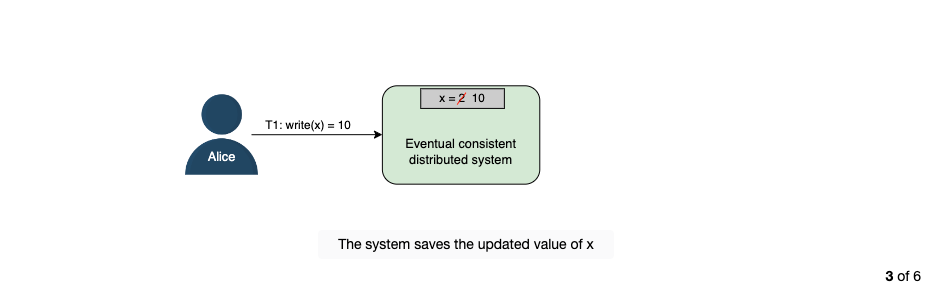
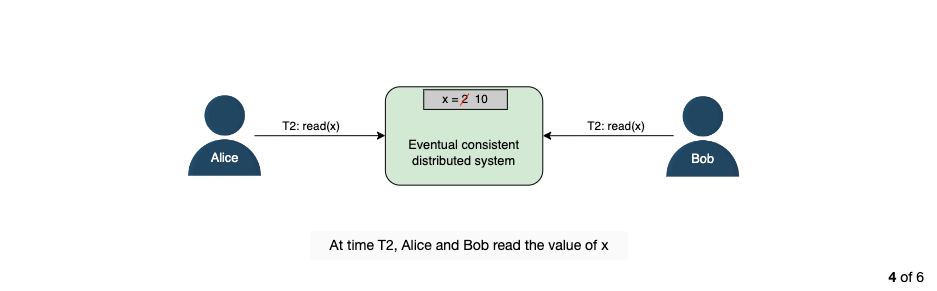
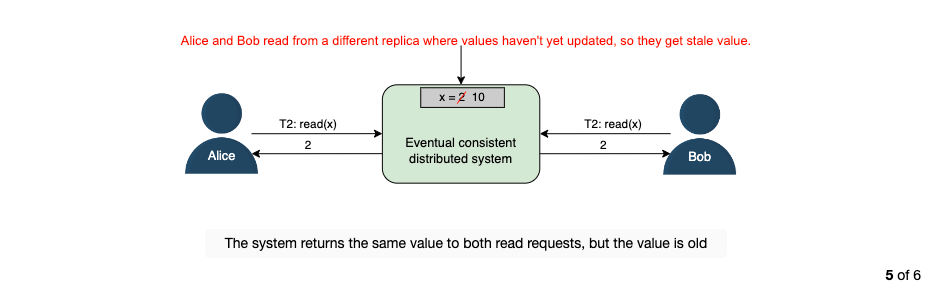
Конечная согласованность — самая слабая модель согласованности. Приложения, не имеющие строгих требований к порядку и не требующие чтения для возврата последней записи, выбирают эту модель. Конечная согласованность гарантирует, что все реплики сходятся к конечному значению по истечении конечного времени и когда больше не поступают записи. Если новые записи продолжают поступать, реплики в конечном итоге согласованной системы могут никогда не достичь того же состояния. Пока реплики не сойдутся, разные реплики могут возвращать разные значения.
Рубрика объясни мне это будто мне 10 лет
Представь, что ты и твои друзья строите замок из песка на пляже. Вы все работаете над разными частями замка, и иногда ваш песок может выглядеть по-разному. Но если вы остановитесь и подождете, замок в конце концов будет выглядеть одинаково у всех.
Конечная согласованность — это как этот замок. Она означает, что все части (или реплики) данных в системе в конечном итоге станут одинаковыми, если больше не будут добавляться новые данные. Это самая слабая модель согласованности, потому что данные могут быть разными в разное время, но если подождать, все станет одинаковым.
Почему это важно?
Иногда приложения, такие как социальные сети или игры, не требуют, чтобы все изменения данных сразу были видны всем пользователям. Они могут выбрать конечную согласованность, потому что она проще и быстрее. Главное, чтобы в конце концов, когда все изменения остановятся, данные стали одинаковыми для всех.
Но если новые данные продолжают поступать, система может никогда не достичь полного согласия, и разные части системы могут показывать разные данные в разное время.
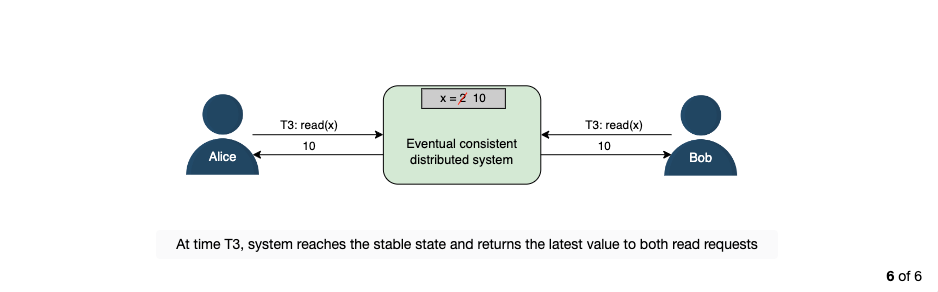
Пример
Система доменных имен — это высокодоступная система, которая позволяет выполнять поиск имен на сотне миллионов устройств по всему Интернету. Она использует eventual consistency model и не обязательно отражает последние значения.
Примечание: Cassandra — это высокодоступная база данных NoSQL, которая обеспечивает eventual consistency model.
Causal consistency
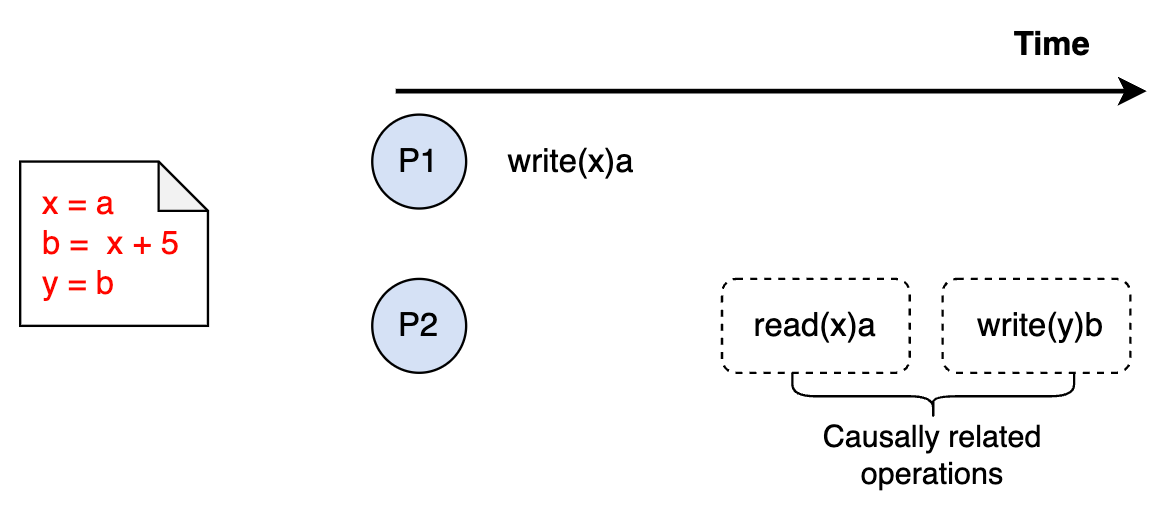
Causal consistency работает путем категоризации операций на зависимые и независимые. Зависимые операции также называются причинно-связанными операциями. Причинная согласованность сохраняет порядок причинно-связанных операций.
На следующем рисунке процесс P1 записывает значение a в позицию x. Чтобы P2 записал значение b в позицию y, ему сначала нужно вычислить b. Поскольку b=x+5, операция чтения для x должна быть выполнена до записи b в позицию y. Вот почему read(x)a и write(y)b причинно связаны.
Causal consistency
Эта модель не гарантирует упорядочение для операций, которые не являются причинно-связанными. Эти операции можно увидеть в разных возможных порядках.
Причинная согласованность в целом слабее, но сильнее, чем модель окончательной согласованности. Она используется для предотвращения неинтуитивного поведения.
Пример
Модель причинной согласованности используется в системе комментирования. Например, для ответов на комментарий к посту в Facebook мы хотим отображать комментарии после комментария, на который он отвечает. Это связано с тем, что между комментарием и его ответами существует причинно-следственная связь.
Примечание: существует множество моделей согласованности, помимо четырех, обсуждаемых в этом уроке, и все еще есть место для новых моделей согласованности. Исследователи разработали новые модели согласованности. Например, Уайетт Ллойд и др. предложили модель причинно-следственной связи для ускорения некоторых определенных типов транзакций.
Sequential consistency
Последовательная согласованность сильнее модели причинной согласованности.
Она сохраняет порядок, указанный программой каждого клиента. Однако последовательная согласованность не гарантирует, что записи будут видны мгновенно или в том же порядке, в котором они произошли в соответствии с некоторыми глобальными часами.
Пример
В приложениях социальных сетей мы обычно не заботимся о порядке, в котором появляются некоторые сообщения наших друзей.
Однако мы все равно ожидаем, что сообщения одного друга будут появляться в правильном порядке, в котором они были созданы. Аналогично мы ожидаем, что комментарии наших друзей в сообщении будут отображаться в том порядке, в котором они были отправлены. Модель последовательной согласованности охватывает все эти качества.
Strict consistency aka linearizability
Строгая согласованность или линеаризуемость — самая сильная модель согласованности.
Эта модель гарантирует, что запрос на чтение от любых реплик получит последнее значение записи. Как только клиент получит подтверждение о том, что операция записи была выполнена, другие клиенты смогут прочитать это значение.
Линеаризуемость сложно достичь в распределенной системе. Некоторые из причин таких проблем — это переменные задержки сети и сбои. На следующих слайдах показано, как переменные задержки сети позволяют разным сторонам видеть разные значения.
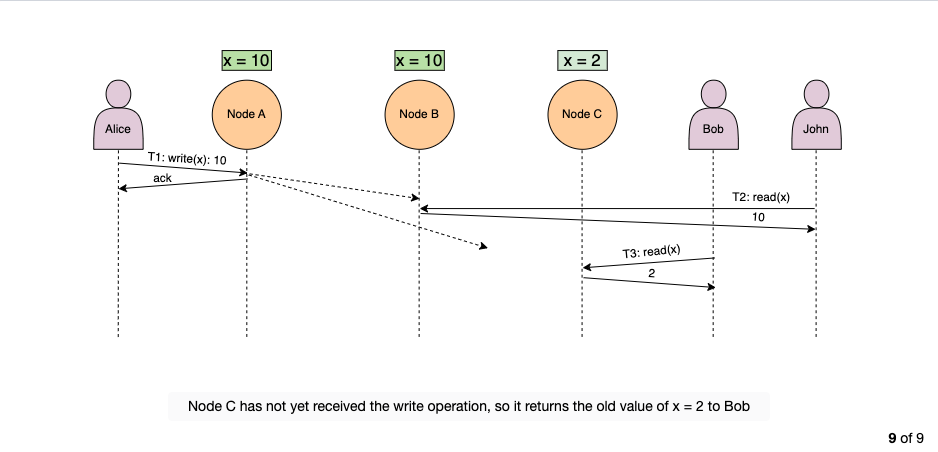
Обычно синхронная репликация является одним из компонентов для достижения строгой согласованности, хотя сама по себе она недостаточна. Для достижения строгой согласованности нам могут понадобиться алгоритмы консенсуса, такие как Paxos и Raft.
Линеаризуемость влияет на доступность системы, поэтому она не всегда используется. Приложения с жесткими требованиями к согласованности используют такие методы, как репликация на основе кворума, для повышения доступности системы.
Пример
Обновление пароля учетной записи требует строгой согласованности. Например, если мы подозреваем подозрительную активность на нашем банковском счете, мы немедленно меняем свой пароль, чтобы никакие неавторизованные пользователи не могли получить доступ к нашему счету. Если бы можно было получить доступ к нашему счету, используя старый пароль из-за отсутствия строгой согласованности, то смена паролей была бы бесполезной стратегией безопасности.
Резюме
Линеаризуемые сервисы, по-видимому, выполняют транзакции/операции в последовательном порядке в реальном времени. Они упрощают создание подходящих приложений поверх них, ограничивая количество значений, которые сервисы могут возвращать процессам приложений.
Линеаризуемые сервисы имеют худшие показатели производительности, чем сервисы с более слабой согласованностью в обмен на их сильные гарантии. Подумайте о чтении в хранилище ключей-значений, которое возвращает значение, записанное параллельной записью. Чтение не накладывает ограничений на будущие чтения, если хранилище ключей-значений является слабо согласованным.
Программистам приложений приходится идти на компромисс с производительностью и доступностью, если они используют сервисы с моделями сильной согласованности. Модели могут нарушать инварианты приложений, построенных поверх них, в обмен на повышенную производительность.
Почему нужно знать о моделях согласованности для интервью на системный дизайн?
Понимание различных моделей согласованности важно для системного дизайна, потому что это помогает проектировать распределенные системы, которые работают правильно и эффективно. На интервью вас могут спросить, как вы бы спроектировали систему, которая обрабатывает большое количество данных, работает с высокой доступностью или требует строгой безопасности. Знание различных моделей согласованности поможет вам выбрать подходящую стратегию для достижения целей проекта.
Представьте, что вы создаете распределенную базу данных для глобальной компании, где тысячи пользователей одновременно читают и пишут данные. Вам нужно решить, какой уровень согласованности подходит для вашего проекта. Например, для финансовой системы может понадобиться строгая согласованность, чтобы каждый пользователь видел только актуальные данные. А для системы социальных сетей можно выбрать более слабую модель, чтобы ускорить работу приложения, даже если иногда данные обновляются с небольшой задержкой.
Рубрика объясни мне это будто мне 10 лет
Представь, что ты и твои друзья строите большой замок из LEGO, но каждый из вас находится в разных комнатах. Если у вас есть строгая согласованность, это значит, что каждый раз, когда ты добавляешь новый блок к замку, все твои друзья тоже сразу видят этот новый блок и могут продолжить строительство. Если у вас слабая согласованность, это как если бы твои друзья видели новый блок не сразу, а через какое-то время, и пока ждут, могут продолжать строить свою часть замка. Иногда это нормально, например, если не важно, что замок выглядит одинаково у всех в каждый момент времени, но важно, чтобы он строился быстрее.
Как это связано с интервью
Если тебя на интервью спросят, как ты бы спроектировал игру, где много игроков одновременно строят замок из LEGO, ты сможешь объяснить, какую модель согласованности ты бы выбрал, чтобы игра была быстрой и интересной, или наоборот — безопасной и точной.
The Spectrum of Failure Models - Спектр модели отказов
Сбои очевидны в мире распределенных систем и могут проявляться по-разному.
Они могут появляться и исчезать или сохраняться в течение длительного периода.
Модели сбоев предоставляют нам основу для рассуждений о влиянии сбоев и возможных способах их устранения.
Вот иллюстрация, которая представляет спектр различных моделей сбоев:
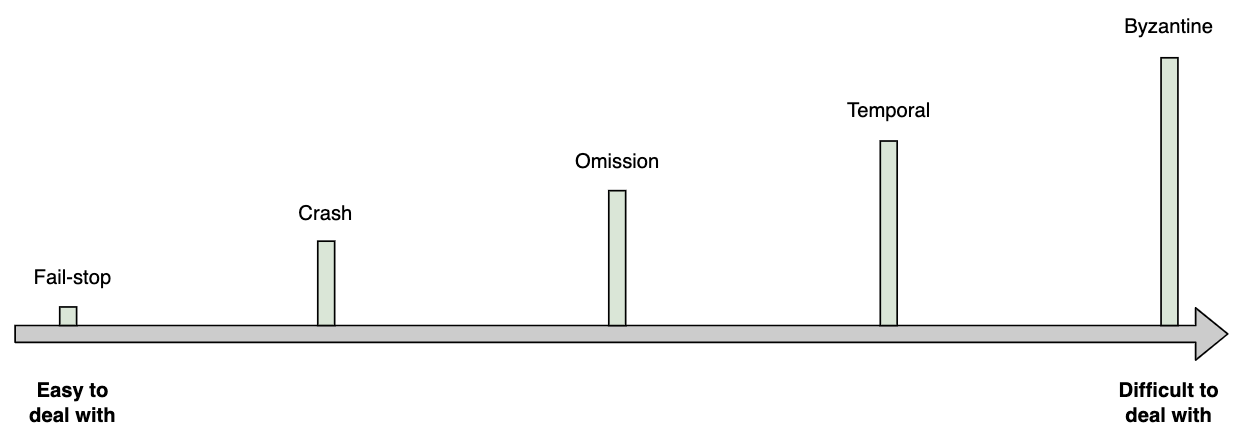
Это спектр моделей сбоев. Уровень сложности при работе со сбоями увеличивается по мере того, как мы движемся вправо
В примере ниже узел — это один из компьютеров или устройств, которые участвуют в распределенной системе.
Узлы работают вместе, обмениваются данными и выполняют задачи.
Например, в сети банкоматов каждый банкомат является узлом, а в онлайн-игре каждый игрок с его устройством тоже считается узлом.
Fail-stop
В этом типе сбоя узел в распределенной системе останавливается навсегда. Однако другие узлы все еще могут обнаружить этот узел, связавшись с ним.
С точки зрения того, кто строит распределенные системы, сбои fail-stop являются самыми простыми и удобными.
Crash
В этом типе сбоя узел в распределенной системе останавливается молча, и другие узлы не могут обнаружить, что узел перестал работать.
Omission failures
В сбоях из-за пропусков узел не может отправлять или получать сообщения. Существует два типа сбоев из-за пропусков. Если узел не отвечает на входящий запрос, это называется ошибкой пропуска отправки. Если узел не получает запрос и, таким образом, не может его подтвердить, это называется ошибкой пропуска приема.
Временные сбои
Во время временных сбоев узел генерирует правильные результаты, но слишком поздно, чтобы быть полезным. Этот сбой может быть вызван плохими алгоритмами, плохой стратегией проектирования или потерей синхронизации между тактами процессора.
Византийские сбои
Во время византийских сбоев узел демонстрирует случайное поведение, например, передает произвольные сообщения в произвольное время, выдает неправильные результаты или останавливается на полпути. Это в основном происходит из-за атаки вредоносного объекта или ошибки программного обеспечения. Византийский сбой — это самый сложный тип сбоя.
Рубрика объясни мне это будто мне 10 лет
Представь, что ты и твои друзья играете в онлайн-игру, где каждый управляет своим персонажем. Если у одного из друзей игра внезапно вылетает (crash), ты не знаешь, что произошло, и его персонаж просто перестает двигаться. Если друг играет, но его персонаж ведет себя странно, как будто сам по себе (Byzantine failure), это может быть потому, что в его игре что-то пошло не так, или кто-то специально пытается испортить игру.
Как это связано с интервью
Если на интервью по системному дизайну вас спросят о том, как вы бы справились с различными типами отказов в распределенной системе, вы сможете объяснить, как обнаруживать и исправлять эти проблемы, чтобы система продолжала работать корректно.