The Distributed Task Scheduler
Что такое планировщик задач?
Задача — это часть вычислительной работы, которая требует ресурсов (процессорного времени, памяти, хранилища, сетевой пропускной способности и так далее) на определенное время. Например, загрузка фотографии или видео на Facebook или Instagram включает следующие фоновые задачи:
- Кодирование фотографии или видео в нескольких разрешениях.
- Проверка фотографии или видео на соответствие авторским правам на монетизацию контента и многое другое.
Успешное выполнение всех вышеперечисленных задач делает фото или видео доступным для просмотра. Однако загрузчик фотографий и видео не должен останавливать выполнение этих задач для их завершения.
Еще один пример — публикация комментария в Facebook. Мы не ждем, пока комментарий будет доставлен всем подписчикам. Эта доставка поручается асинхронному планировщику задач для выполнения в фоновом режиме.
В системе многие задачи борются за ограниченные вычислительные ресурсы. Система, которая посредничает между задачами и ресурсами, интеллектуально распределяя ресурсы между задачами для достижения целей на уровне задач и системы, называется планировщиком задач.
Когда использовать планировщик задач?
Планировщик задач является критически важным компонентом системы для эффективного выполнения работы. Он позволяет нам выполнять большое количество задач с использованием ограниченных ресурсов. Он также помогает полностью использовать ресурсы системы, обеспечивает пользователям бесперебойное выполнение операций и так далее. Ниже приведены некоторые примеры использования планирования задач:
-
Узел на базе одной ОС: Он имеет много процессов или задач, которые конкурируют за ограниченные вычислительные ресурсы узла. Поэтому мы могли бы использовать локальный планировщик задач ОС, который эффективно распределяет ресурсы между задачами. Он использует многоуровневые очереди для выбора задач и их выполнения на определенном процессоре.
-
Облачные вычислительные сервисы: В облачных системах есть много распределенных ресурсов и множество задач от различных арендаторов, поэтому существует острая необходимость в планировщике задач для эффективного использования облачных ресурсов и удовлетворения требований арендаторов. Локального планировщика задач ОС недостаточно для этой цели, так как задачи исчисляются миллиардами, источник задач не единственный, а ресурсы для управления не находятся на одном компьютере. Здесь необходимо использовать распределенное решение.
-
Крупные распределенные системы: В таких системах множество задач выполняется в фоновом режиме в ответ на один запрос пользователя. Учитывая, что у популярных систем, таких как Facebook, WhatsApp или Instagram, миллионы или миллиарды пользователей, такие системы требуют планировщика задач для обработки миллиардов задач. Facebook планирует свои задачи в ответ на миллиарды параллельных асинхронных запросов своих пользователей с помощью Async.
Примечание: Async — это собственный распределенный планировщик задач Facebook, который планирует все его задачи. Некоторые задачи более чувствительны к времени, например, задачи, которые должны выполняться для уведомления пользователей о начале прямой трансляции события. Нет смысла, если пользователи получат уведомление о прямом эфире после его завершения. Некоторые задачи могут быть отложены, например, задачи, которые предлагают пользователям друзей. Async планирует задачи на основе соответствующих приоритетов.
Распределенное планирование задач
Процесс принятия решения и распределения ресурсов для задач в своевременной манере называется планированием задач. Визуальная разница между планировщиком задач на уровне ОС и планировщиком задач на уровне датацентра показана на следующей иллюстрации:
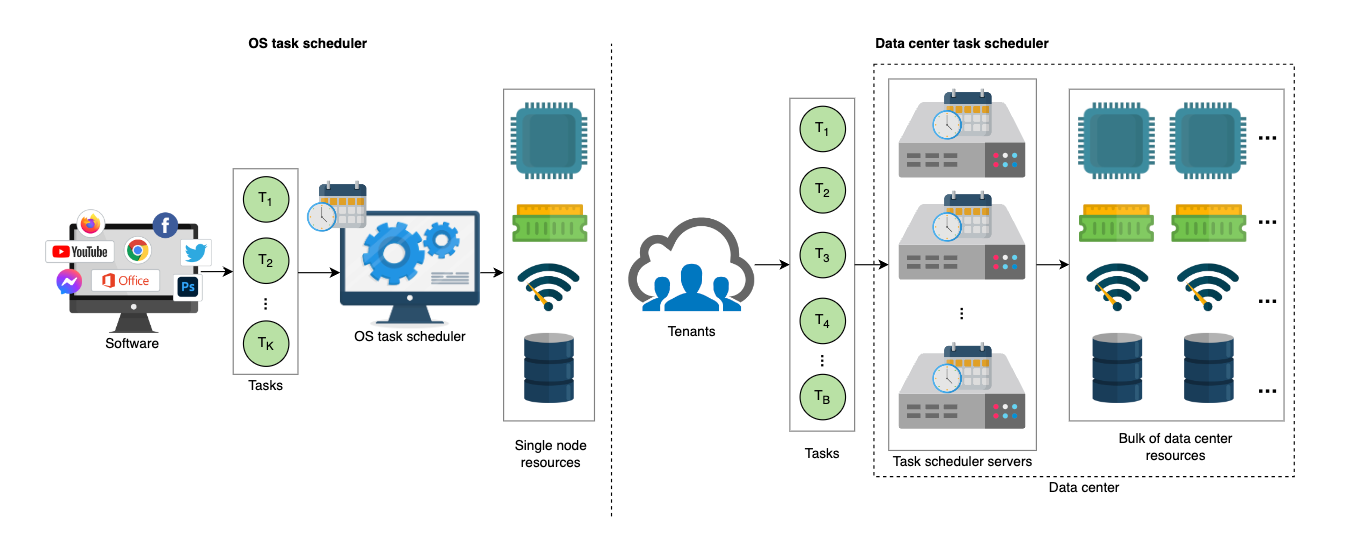
Планировщик задач ОС планирует локальные задачи или процессы узла на вычислительных ресурсах этого узла. В то же время планировщик задач датацентра планирует миллиарды задач, поступающих от множества арендаторов, которые используют ресурсы датацентра.
Наша цель — разработать планировщик задач, аналогичный планировщику задач на уровне датацентра, где учитываются следующие моменты:
- Задачи будут поступать из множества различных источников, арендаторов и подсистем.
- Многие ресурсы будут распределены в датацентре (или, возможно, по нескольким датацентрам).
Эти два требования делают задачу планирования задач сложной. Мы разработаем распределенный планировщик задач, который сможет справиться со всеми этими задачами, делая его масштабируемым, надежным и устойчивым к отказам.
Как мы будем проектировать систему планирования задач?
Мы разделили проектирование планировщика задач на четыре урока:
- Требования: В этом уроке мы определим функциональные и нефункциональные требования к системе планирования задач.
- Проектирование: Этот урок рассмотрит системный дизайн нашего планировщика задач и исследует компоненты системы и схему базы данных.
- Учет проектных особенностей: В этом уроке мы рассмотрим некоторые проектные факторы, такие как приоритизация задач, оптимизация ресурсов и т. д.
- Оценка: Мы оценим наш дизайн планировщика задач на основе наших требований.
Давайте начнем с понимания требований к системе планирования задач.
Requirements of a Distributed Task Scheduler's Design
Функциональные требования
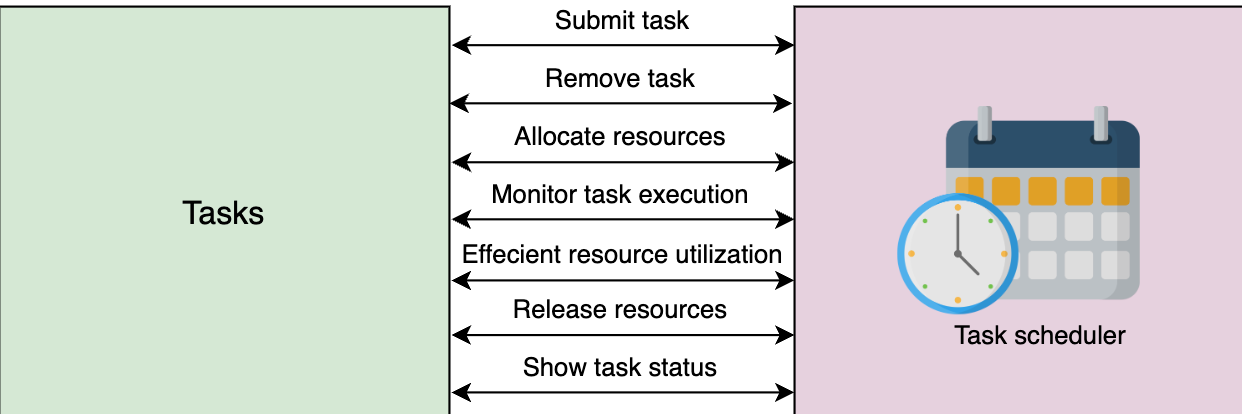
Функциональные требования к распределенному планировщику задач включают:
- Отправка задач: Система должна позволять пользователям отправлять свои задачи для выполнения.
- Распределение ресурсов: Система должна уметь выделять необходимые ресурсы для каждой задачи.
- Удаление задач: Система должна позволять пользователям отменять отправленные задачи.
- Мониторинг выполнения задач: Выполнение задач должно тщательно контролироваться, а в случае сбоя задачи должны быть переназначены.
- Эффективное использование ресурсов: Ресурсы (CPU и память) должны использоваться эффективно с точки зрения времени, стоимости и справедливости. Эффективность означает, что мы не должны тратить ресурсы впустую. Например, если мы выделяем тяжелый ресурс для легкой задачи, которая могла бы быть легко выполнена на дешевом ресурсе, это означает, что мы неэффективно используем ресурсы. Справедливость означает способность всех арендаторов получать ресурсы с одинаково вероятным распределением в определенном классе затрат.
- Освобождение ресурсов: После успешного выполнения задачи система должна освободить ресурсы, назначенные для выполнения задачи.
- Отображение статуса задачи: Система должна показывать пользователям текущий статус задачи.
Нефункциональные требования
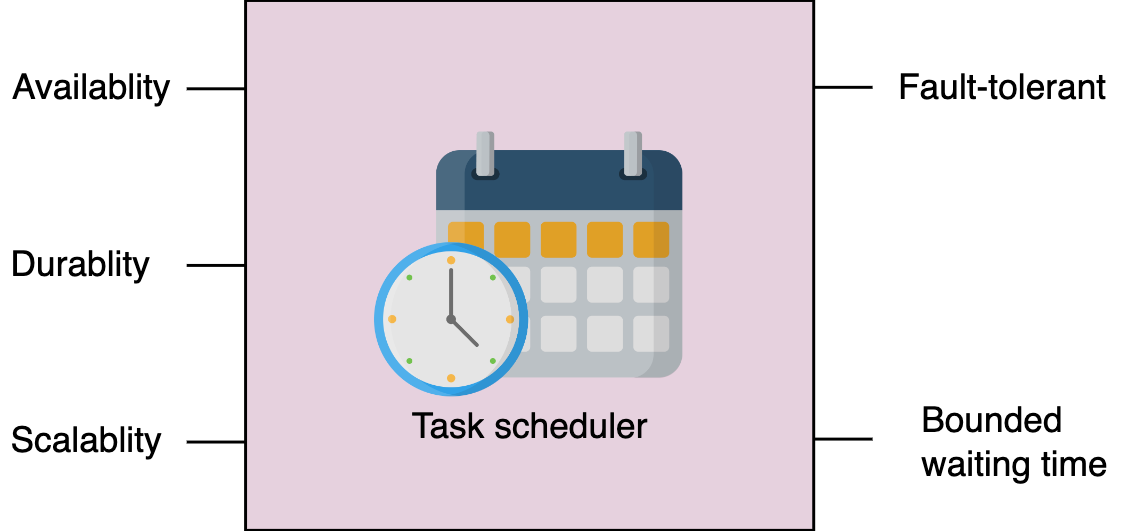
Нефункциональные требования к распределенному планировщику задач включают:
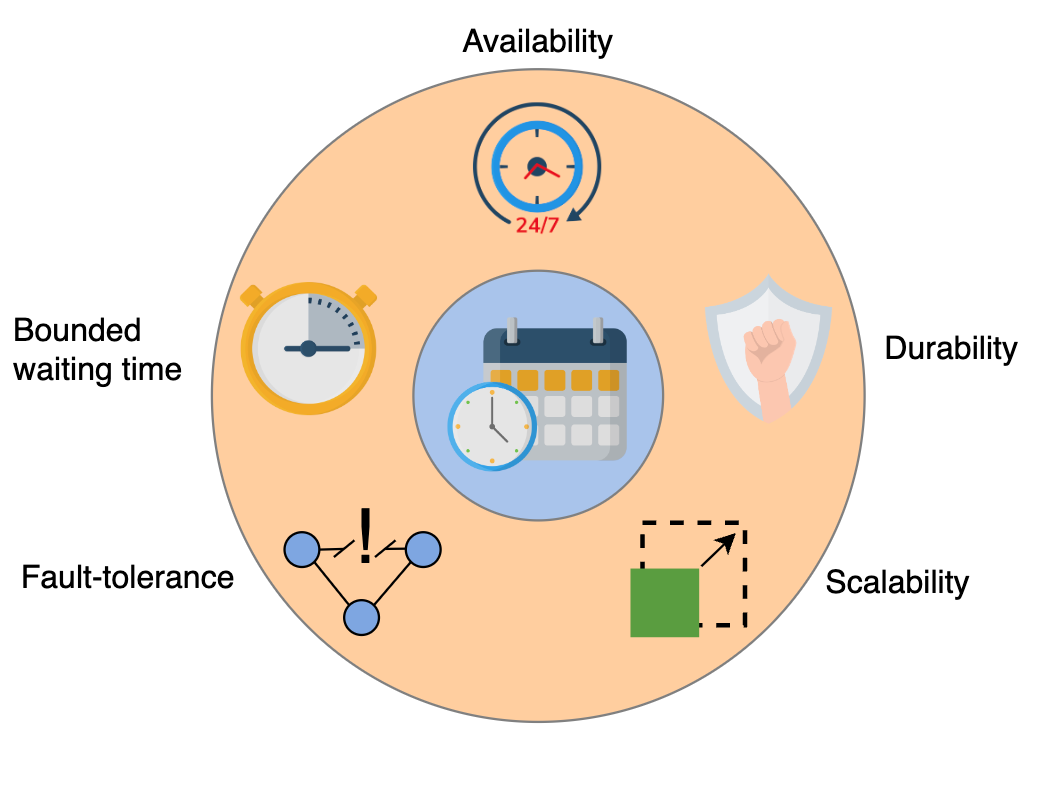
- Доступность: Система должна быть высокодоступной для планирования и выполнения задач.
- Надежность: Задачи, полученные системой, должны быть надежными и не должны теряться.
- Масштабируемость: Система должна быть способна планировать и выполнять все большее количество задач с каждым днем.
- Устойчивость к сбоям: Система должна быть устойчивой к сбоям, обеспечивая непрерывность обслуживания несмотря на неисправности в одном или нескольких компонентах.
- Ограниченное время ожидания: Это время, которое задача должна ждать перед началом выполнения. Мы не должны выполнять задачи намного позже ожидаемого времени. Пользователи не должны ожидать выполнения задачи бесконечно долго. Если время ожидания для пользователей превышает определенный порог, они должны быть уведомлены.
Основные компоненты, которые мы будем использовать
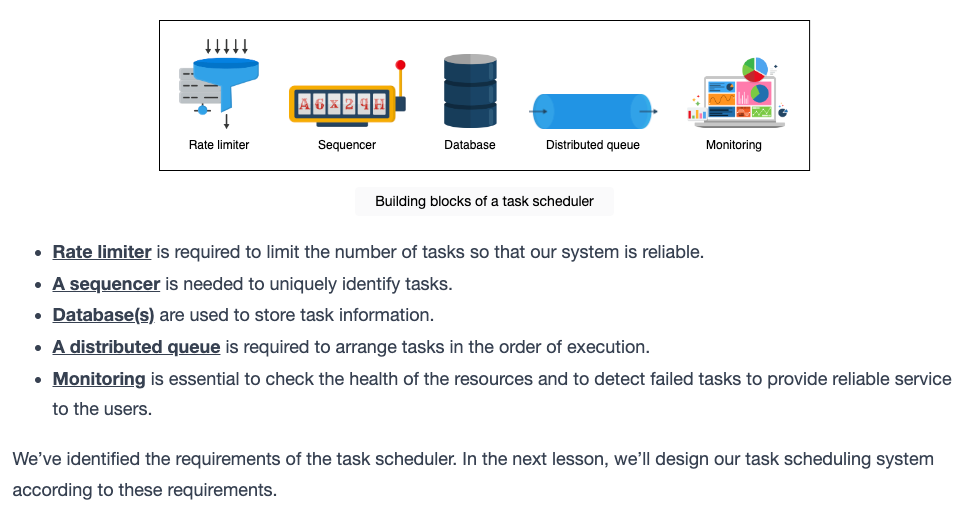
Мы будем использовать следующие строительные блоки в дизайне нашей системы планирования задач:
Design of a Distributed Task Scheduler
Компоненты
Мы можем рассматривать планирование на разных уровнях. Нас могут попросить спроектировать планирование, которое выполняется внутри организации для запуска задач на их собственном кластере машин. В этом случае им необходимо найти достаточные ресурсы и решить, какую задачу выполнять первой.
С другой стороны, нас могут попросить спроектировать планирование, которое использует облачный провайдер для выполнения задач от нескольких клиентов. Облачным провайдерам нужно решить, какую задачу выполнять первой и каких клиентов обслуживать в первую очередь, чтобы обеспечить надлежащую изоляцию между различными арендаторами.
Таким образом, основные компоненты нашей системы:
- Клиенты: Они инициируют выполнение задач.
- Ресурсы: На этих компонентах выполняются задачи.
- Планировщик: Планировщик выполняет процессы между клиентами и ресурсами и решает, какая задача должна получить ресурсы первой.
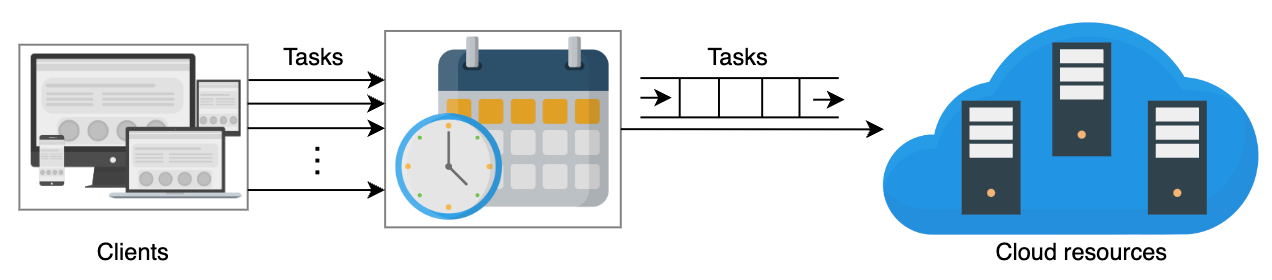
Как показано на иллюстрации выше, необходимо ставить входящие задачи в очередь по следующим причинам:
- В данный момент может не быть достаточно доступных ресурсов.
- Существуют зависимости между задачами, и некоторые задачи должны ждать других.
- Нам нужно отвязать клиентов от выполнения задач, чтобы они могли передать работу нашей системе. Наша система затем ставит их в очередь на выполнение.
Давайте спроектируем систему планирования задач, которая должна быть способна планировать любую задачу. Часто многие задачи относительно короткие — от секунд до минут. Для задач, которые требуют больше времени на выполнение, может понадобиться возможность периодической проверки контрольных сумм и восстановления на уровне приложения для восстановления после возможных сбоев.
Предположим, что некоторый одиночный сервер в нашем флоте может удовлетворить вычислительные потребности каждой задачи. Для задач, требующих нескольких серверов, приложение должно разбивать их на более мелкие задачи для нашей системы или использовать долгосрочное приобретение ресурсов у менеджера кластера.
Дизайн
Когда задача поступает на планирование, она должна содержать следующую информацию:
Требования к ресурсам:
Требования включают количество необходимых ядер процессора (CPU), сколько оперативной памяти (RAM) требуется для выполнения задачи, сколько дискового пространства нужно, какой должна быть скорость доступа к диску (операции ввода/вывода в секунду, или IOPS), и сколько TCP-портов необходимо для выполнения задачи и так далее. Однако клиентам сложно количественно определить эти требования. Для решения этой проблемы у нас есть различные уровни ресурсов, такие как базовый, обычный и премиум. Клиент может указать требование в терминах этих уровней.
Зависимость:
Задачи можно разделить на два типа: зависимые и независимые.
- Зависимые задачи требуют выполнения одной или нескольких дополнительных задач для их полного завершения. Эти задачи должны выполняться последовательно. Для зависимой задачи клиент должен предоставить список задач, от которых зависит данная задача.
- Независимые задачи не зависят от выполнения других задач. Независимые задачи могут выполняться параллельно. Нам необходимо знать, является ли задача зависимой или независимой. Информация о зависимости помогает выполнять как зависимые задачи по порядку, так и независимые задачи параллельно для эффективного использования ресурсов.
Дизайн планировщика задач показан на следующей иллюстрации:
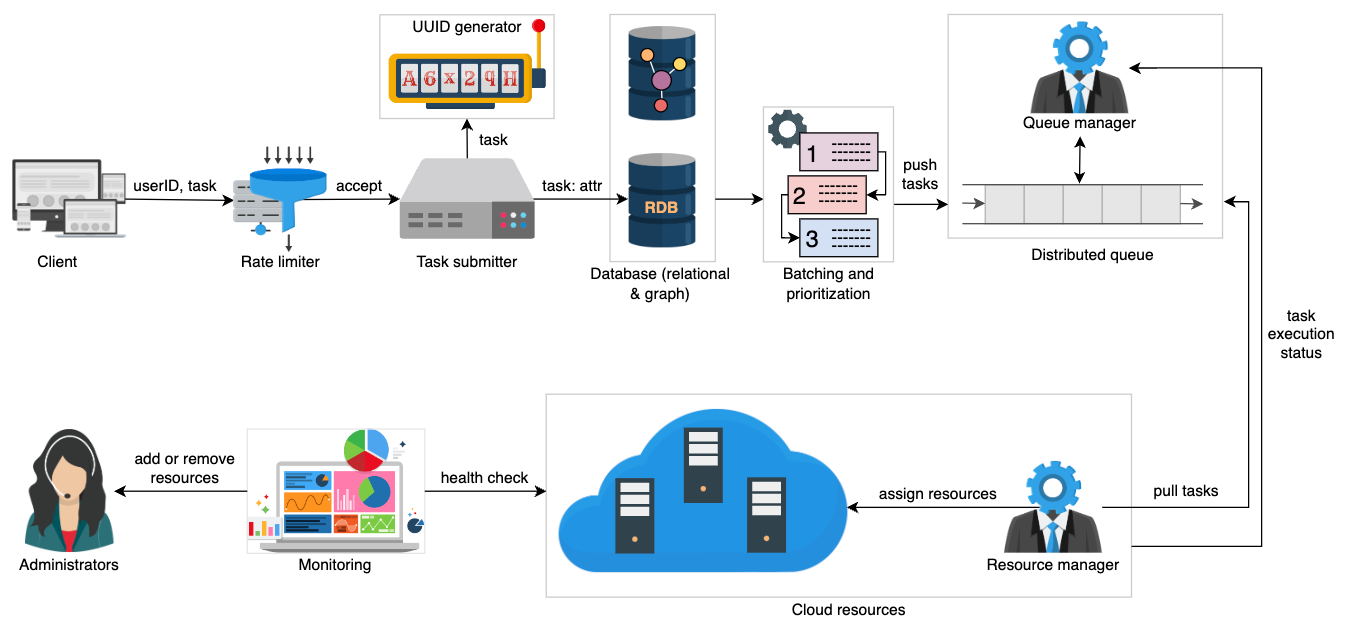
Основные компоненты системы:
- Клиенты: Клиенты облачных провайдеров — это физические лица или организации, от малого до крупного бизнеса, которые хотят выполнить свои задачи.
- Ограничитель скорости (Rate limiter): Доступные ресурсы для клиента зависят от стоимости, которую он платит. Важно ограничить количество задач для надежности нашего сервиса. Например, X количество задач в час допускается к системе. Остальные получат сообщение типа «Лимит превышен» вместо того, чтобы принять задачу и ответить с задержкой. Ограничитель скорости ограничивает количество задач, которые клиент может запланировать в зависимости от его подписки. Если лимит превышен, клиенту возвращается сообщение об ошибке, что лимит превышен.
- Отправитель задач (Task submitter): Отправитель задач принимает задачу, если она успешно проходит через ограничитель скорости. Отправителей задач не один, а есть кластер узлов, которые принимают увеличивающееся количество задач.
- Генератор уникальных идентификаторов (Unique ID generator): Присваивает уникальные идентификаторы новым задачам.
- База данных: Все принятые отправителем задач задачи хранятся в распределенной базе данных. Для каждой задачи у нас есть несколько атрибутов, и все атрибуты, кроме одного, хранятся в реляционной базе данных.
- Реляционная база данных (RDB): Реляционная база данных хранит идентификаторы задач, идентификаторы пользователей, требуемые ресурсы, лимиты выполнения, общее количество попыток, сделанных клиентом, допустимую задержку и так далее, как показано в следующей таблице.
Схема базы данных
| Название столбца | Тип данных | Описание |
|---|---|---|
| TaskID | Integer | Уникально идентифицирует каждую задачу. |
| UserID | Integer | Это ID владельца задачи. |
| SchedulingType | VarChar | Это может быть одноразовое, ежедневное, еженедельное, ежемесячное или ежегодное задание. |
| TotalAttempts | Integer | Это максимальное количество попыток в случае сбоя выполнения задачи. |
| ResourceRequirements | VarChar | Клиенты должны указать тип предлагаемых категорий ресурсов, таких как Basic, Regular, Premium. Указанная категория ресурсов сохраняется в виде строки в RDB. |
| ExecutionCap | Time | Это максимальное время, выделенное для выполнения задачи (время начинается с момента выделения ресурса для задачи). |
| Status | VarChar | Это может быть "ожидание", "в процессе", "завершено" или "неудача". |
| DelayTolerance | Time | Это указывает, сколько задержки мы можем выдержать до начала выполнения задачи. |
| ScriptPath | VarChar | Путь к сценарию, который нужно выполнить. Скрипт — это файл, размещенный в файловой системе. Файл должен быть доступен для выполнения, как мы монтируем Google Drive в Google Colaboratory, а затем выполняем наши кодовые файлы там. |
Примечание: Если мы используем гео-реплицируемые хранилища данных, мы можем запускать несколько экземпляров нашей системы планирования задач в разных центрах обработки данных для достижения еще большего масштаба и более высокого уровня использования ресурсов.
Группировка и приоритизация:
После того, как мы сохранили задачи в RDB, задачи группируются в партии. Приоритизация основана на атрибутах задач, таких как допустимая задержка или задачи с коротким лимитом выполнения и так далее. Лучшие K приоритетных задач отправляются в распределенную очередь, где K ограничивает количество элементов, которые мы можем отправить в очередь. Значение K зависит от множества факторов, таких как доступные в данный момент ресурсы, приоритет клиента или задачи, а также уровень подписки.
Why do we store tasks in a database? Why should we not push the tasks directly to the queue?
Details
The queue does not hold data permanently. We pay a cost for the queue service we use. So, we just push those tasks that are ready for execution shortly to the queue. The tasks that are successfully executed need to be removed from the queue. Moreover, there are different scheduling types. A task could be scheduled once, daily, weekly, monthly, or annually. Therefore, we have to save the task somewhere in our storage.
Дополнительные компоненты:
- Распределенная очередь (Distributed queue): Состоит из очереди и менеджера очереди. Менеджер очереди добавляет, обновляет или удаляет задачи в очереди. Он отслеживает типы используемых очередей. Он также отвечает за удержание задачи в очереди до успешного выполнения. В случае сбоя выполнения задачи она снова становится видимой в очереди. Менеджер очереди знает, какую очередь запускать в пиковое время и какую — в непиковое.
- Менеджер ресурсов (Resource manager): Знает, какие ресурсы свободны. Он извлекает задачи из распределенной очереди и назначает им ресурсы. Менеджер ресурсов отслеживает выполнение каждой задачи и отправляет их статусы обратно менеджеру очереди. Если задача превышает обещанное или требуемое использование ресурсов, задача будет завершена, и статус отправляется отправителю задач, который уведомит клиента об ошибке.
- Служба мониторинга (Monitoring service): Отвечает за проверку состояния менеджера ресурсов и ресурсов. Если какой-то ресурс выходит из строя, он уведомляет администраторов о необходимости ремонта или добавления новых ресурсов, если это необходимо. Если ресурсы не используются, он уведомляет администраторов о необходимости их удаления или отключения питания. Здесь представлено подробное обсуждение дизайна служб мониторинга.
Task submitter
Как мы видели выше, каждый компонент, который мы используем в проектировании распределенного планировщика задач, является распределенным, а значит, масштабируемым и доступным. Однако, отправитель задач (task submitter) может стать единой точкой отказа. Чтобы справиться с этим, мы используем кластер узлов. Каждый узел должен принимать задачи, отправлять задачи на уникальный генератор идентификаторов для присвоения ID, а затем сохранять задачу вместе с ID задачи в распределенной базе данных.
Для управления кластером используется менеджер кластера (cluster manager), которому каждый узел отправляет heartbeat, что указывает на то, что узел работает корректно. Каждый узел обновляет менеджера кластера о принятых задачах. Менеджер кластера ведет список задач и идентификаторов узлов, которые приняли эти задачи. В случае, если узел не может выполнить задачу, менеджер кластера передает эту задачу другому узлу в кластере. Сам менеджер кластера также реплицируется.
Выше мы разработали систему планирования задач. В следующем уроке мы обсудим проектные соображения для нашего планировщика задач.
Design Considerations of a Distributed Task Scheduler
Queueing
Распределенная очередь (distributed queue) является основным строительным блоком, используемым планировщиком задач (scheduler). Самый простой подход к планированию — помещать задачи в очередь в порядке их поступления (first-come, first-served). Если в кластере (cloud) есть 10,000 узлов (ресурсов), планировщик задач быстро извлекает задачи из очереди и распределяет их по узлам. Однако, если все ресурсы в данный момент заняты, задачи будут вынуждены ждать в очереди, и небольшие задачи могут ждать дольше.
Этот механизм планирования может повлиять на надежность системы, доступность системы и приоритетность задач. Могут возникнуть ситуации, когда требуется срочное выполнение задачи — например, задача, уведомляющая пользователя о том, что его аккаунт был доступен с нераспознанного устройства. Поэтому мы не можем полагаться только на принцип first-come, first-served для планирования задач. Вместо этого мы классифицируем задачи и устанавливаем соответствующие приоритеты. У нас есть три категории задач:
- Задачи, которые нельзя откладывать.
- Задачи, которые можно отложить.
- Задачи, которые нужно выполнять периодически (например, каждые 5 минут, каждый час или каждый день).
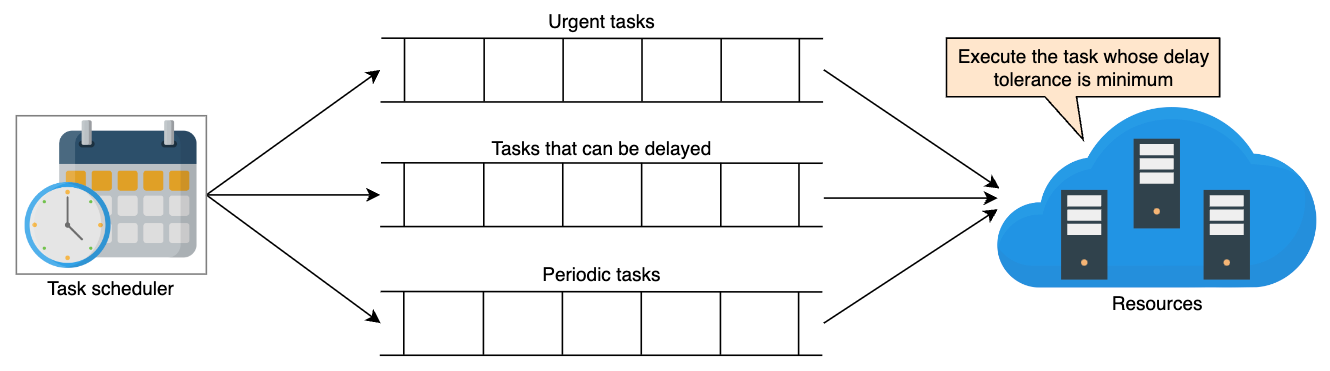
Наша система гарантирует, что задачи в не срочных очередях не останутся без выполнения. Как только лимит задержки выполнения задачи почти достигнут, она перемещается в очередь срочных задач, чтобы получить обслуживание. Позже в этом уроке мы рассмотрим, как планировщик задач реализует приоритеты.
Давайте рассмотрим некоторые параметры, которые помогают планировщику эффективно использовать ресурсы и предоставлять надежное обслуживание пользователям.
Execution cap
Некоторые задачи требуют много времени для выполнения и занимают ресурс, блокируя выполнение других задач. Предел выполнения (execution cap) — важный параметр, который следует учитывать при планировании задач. Если полностью выделить ресурс для одной задачи и ждать завершения её выполнения, некоторые задачи могут никогда не завершиться из-за ошибки в скрипте задачи, которая не позволяет ей завершить выполнение. Мы позволяем клиентам устанавливать предел выполнения для их задач. После указанного времени мы должны остановить выполнение задачи, освободить ресурс и выделить его следующей задаче в очереди. Если выполнение задачи остановлено из-за достижения предела выполнения, наша система уведомляет соответствующих клиентов о таких случаях. Клиент должен предпринять соответствующие меры для решения таких ситуаций.
Если клиенты не устанавливают предел выполнения, планировщик использует своё значение по умолчанию на максимальное допустимое время для завершения задачи. Допустим, задача действительно занимает больше времени, например, при обучении модели машинного обучения. В этом случае планировщик может несколько раз приостановить и возобновить задачу, чтобы учесть другие задачи. Было бы несправедливо, если бы короткая задача ожидала два дня, чтобы использовать ресурс на две секунды.
Провайдеры облачных услуг не могут позволить задаче выполняться неограниченное время для базового (бесплатного) аккаунта, так как использование их ресурсов требует определенных затрат для провайдеров. Чтобы справиться с такими случаями, клиенты уведомляются о максимальных лимитах использования, чтобы они могли учесть длительное выполнение задач. Например, клиенты могут спроектировать свою задачу таким образом, чтобы она сохраняла состояние через определенные промежутки времени и загружала его при необходимости для возобновления прогресса в случае, если ресурсы были отобраны у клиента из-за лимита использования.
What if a long task is 90% executed, but before it completes, the machine that was executing this task fails?
Details
The task scheduler will re-execute the task on some other machine. Tasks need to be either idempotent, which is discussed later in the lesson, or they should be able to restore their state from a previous checkpoint. Once the state is saved, we can resume that task’s execution on any other machine. This makes our system fault tolerant and saves our resources.
Prioritization
Есть задачи, которые требуют срочного выполнения. Например, в социальной сети, такой как Facebook, пользователи могут пометить себя как в безопасности во время чрезвычайной ситуации, такой как землетрясение. Задачи, выполняющие эту функцию, должны выполняться своевременно, иначе эта функция будет бесполезной для пользователей Facebook. Отправка уведомления по электронной почте клиентам о списании средств с их аккаунта — ещё один пример задач, требующих срочного выполнения.
Для приоритезации задач планировщик задач поддерживает параметр задержки (delay tolerance) для каждой задачи и выполняет задачу близко к её допустимой задержке. Задержка — это максимальное время, на которое выполнение задачи может быть отложено. Задача с наименьшим временем задержки выполняется первой. Используя параметр задержки, мы можем откладывать задачи с более длительным временем задержки, чтобы освободить место для срочных задач в периоды пиковой нагрузки.
How do we determine the value of delay tolerance?
Details
Since there are different categories of tasks in various applications, the application owners or clients can set or automate the values themselves, depending upon the task category. For example, in a social media application like Facebook, we can generate a newsfeed, suggest friends, allow users to mark themselves safe after a disaster, send notifications about a live stream event, and many more. Out of the listed tasks, the priority tasks should be to mark a person safe during an earthquake and send notifications about live stream events. Clients can tighten the delay tolerance values of these tasks down to milliseconds or a few seconds while tasks like suggesting friends can be delayed for days.
The task scheduling system itself can set the delay tolerance value depending on the task category and its severity.
There are different costs for different priorities (there are usually higher costs for high-priority tasks, for example) so that customers can carefully categorize their tasks.
Resource capacity optimization
Могут возникнуть моменты, когда ресурсы близки к порогу перегрузки (например, более 80% использования). Это называется пиковым временем (peak time). Те же ресурсы могут быть не загружены в периоды низкой нагрузки (off-peak times). Поэтому мы должны подумать о лучшем использовании ресурсов в периоды низкой нагрузки и о том, как сохранить доступность ресурсов в периоды пиковых нагрузок.
Есть задачи, которые не требуют срочного выполнения. Например, в социальной сети, такой как Facebook, предложение друзей — это не срочная задача. Мы можем создать отдельную очередь для таких задач и выполнять их в периоды низкой нагрузки. Если у нас постоянно больше работы, чем доступных ресурсов, у нас может быть проблема с пропускной способностью, и для её решения следует подключить дополнительные ресурсы. Облачный провайдер должен иметь целевое соотношение ресурсов и спроса. Когда спрос начинает расти, соотношение будет уменьшаться. Если соотношение начинает изменяться со временем, провайдер может решить задействовать больше или меньше ресурсов.
Task idempotency
Если задача выполнена успешно, но по какой-то причине машина не смогла отправить подтверждение, планировщик назначит задачу снова. Задача будет выполнена снова, и мы получим неверный результат, что означает, что задача не была идемпотентной (non-idempotent). Пример неидемпотентности показан в следующей иллюстрации:
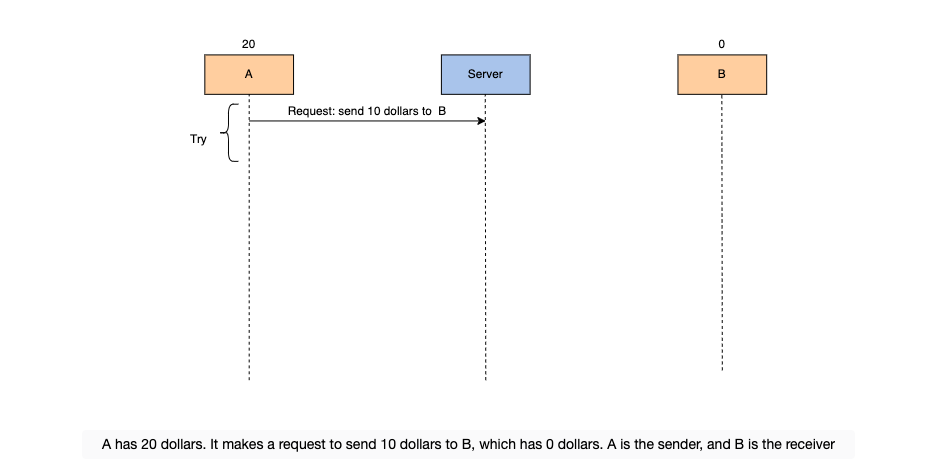
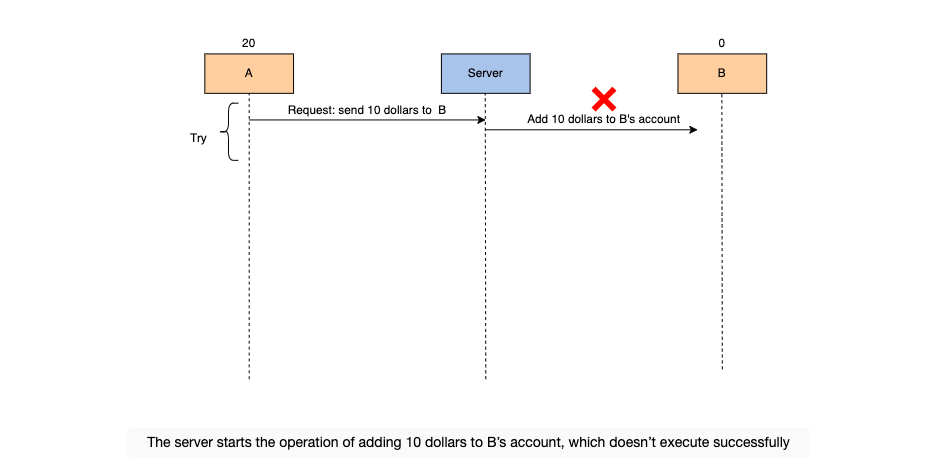
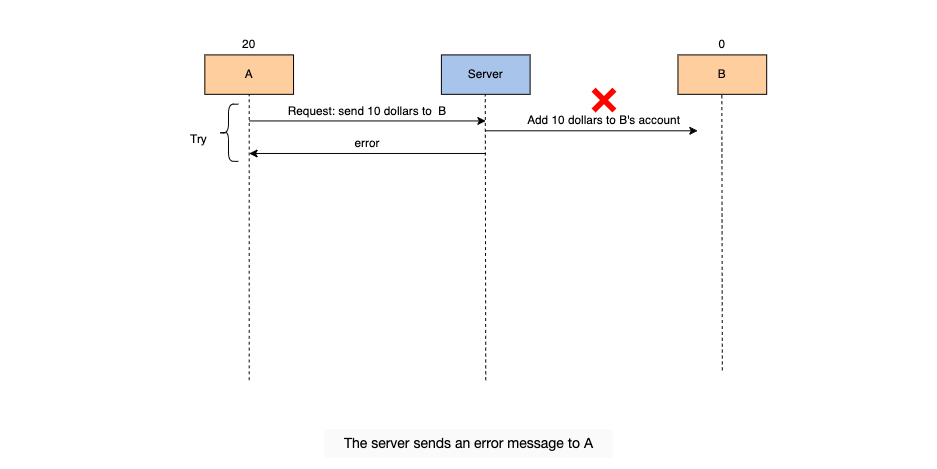
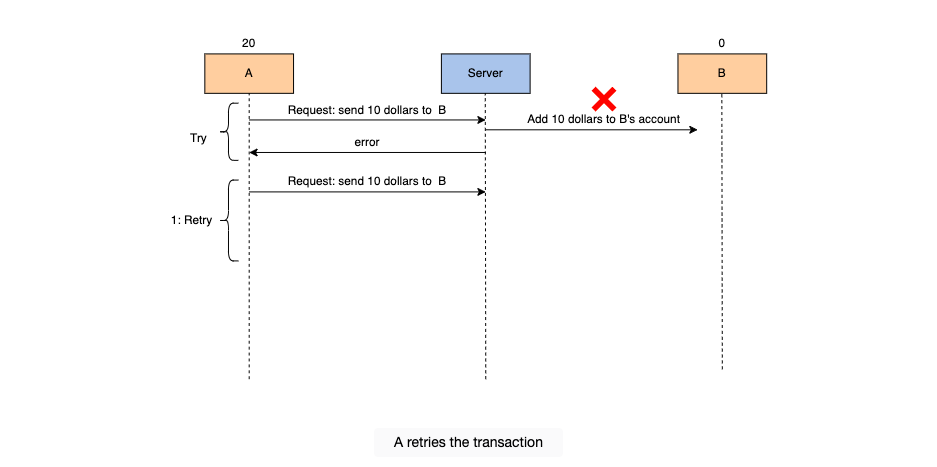
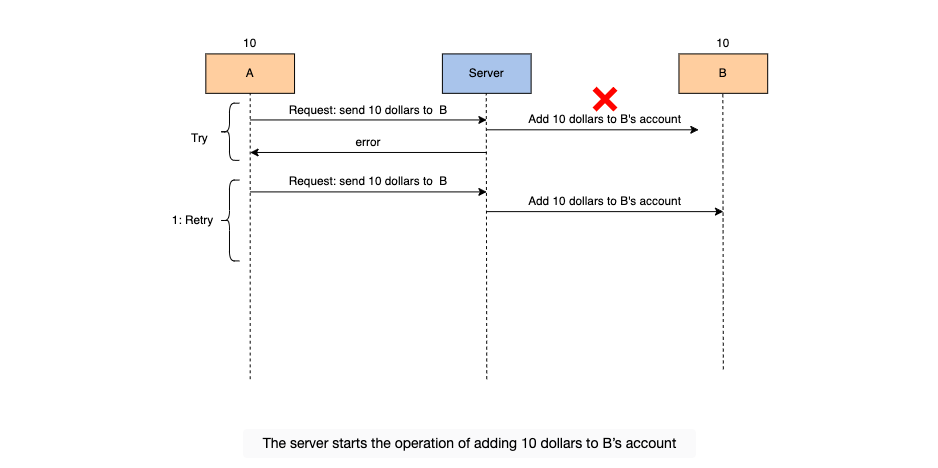
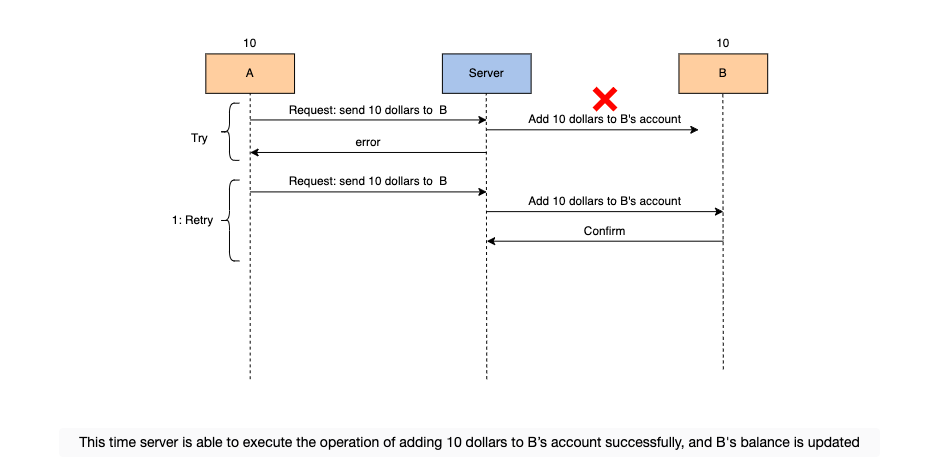
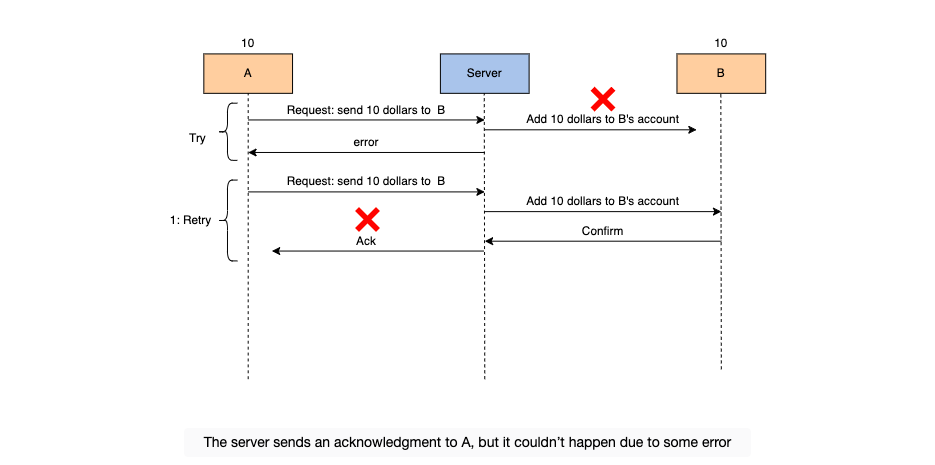
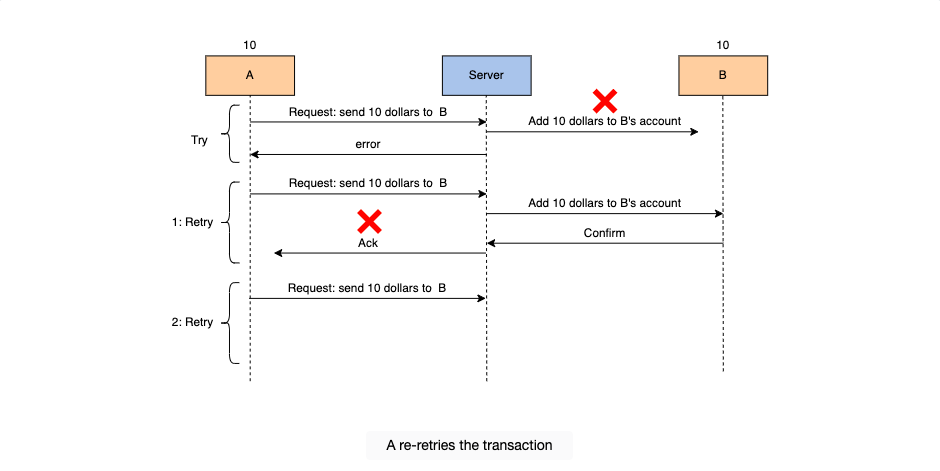
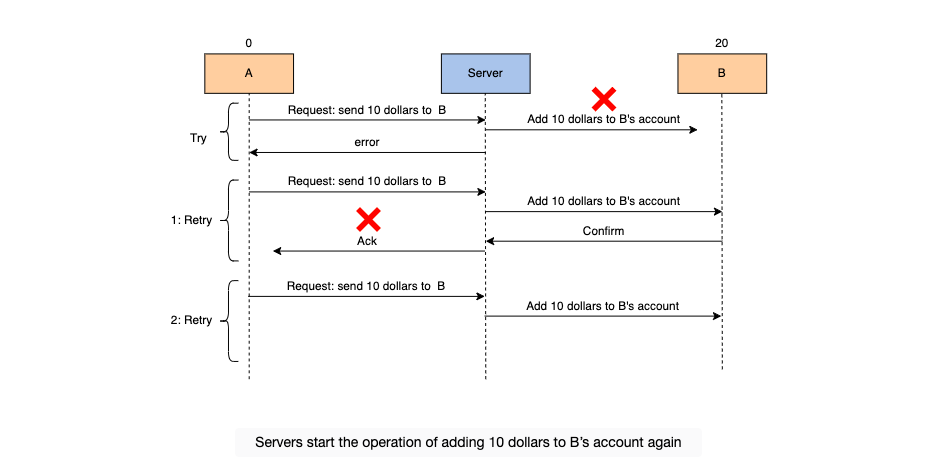
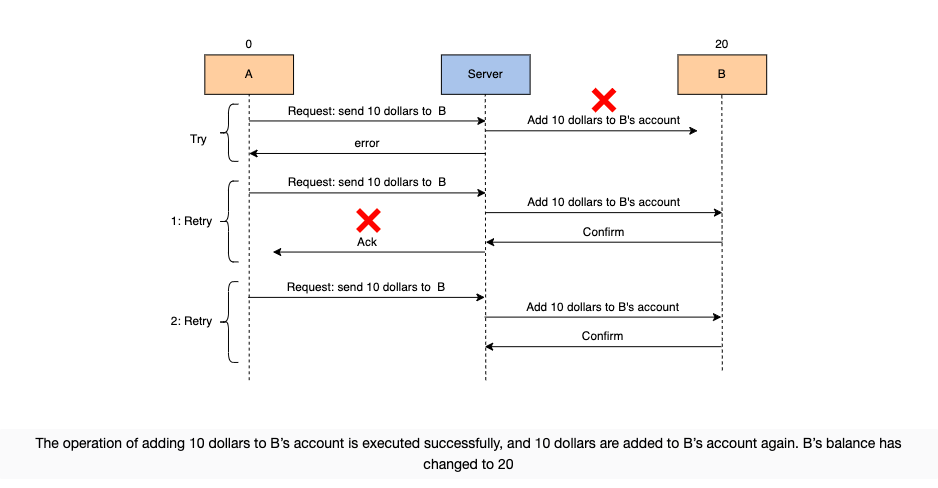
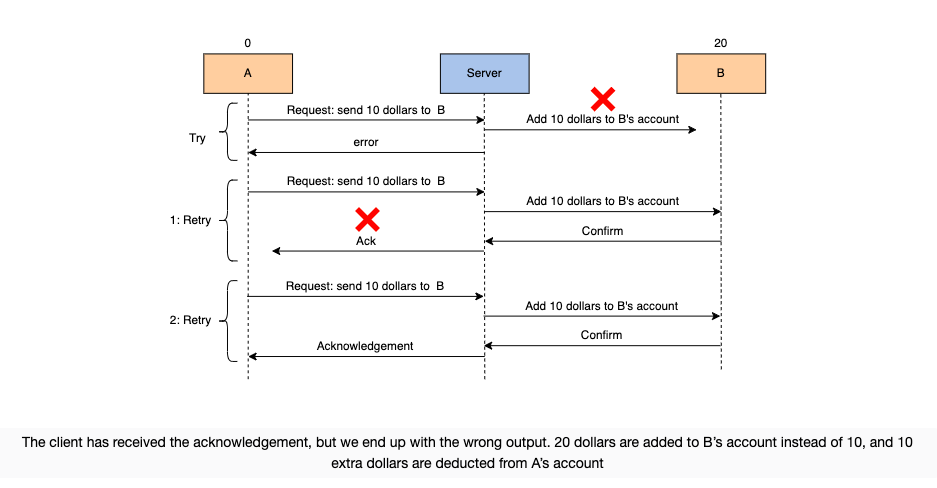
Мы не хотим, чтобы окончательный результат изменился при повторном выполнении задачи. Это критично в финансовых приложениях при переводе денег. Требуется, чтобы задачи были идемпотентными. Идемпотентная задача даёт один и тот же результат, независимо от того, сколько раз мы её выполняем. Выполнение идемпотентной задачи показано на следующей иллюстрации:
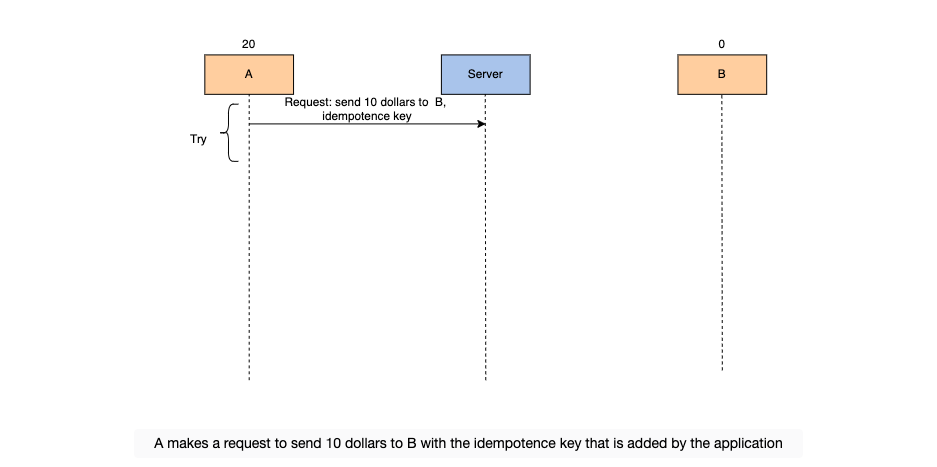
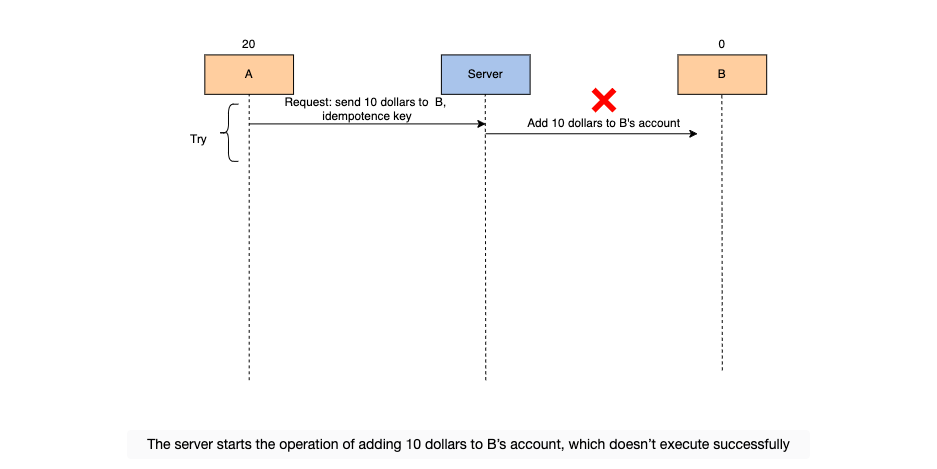
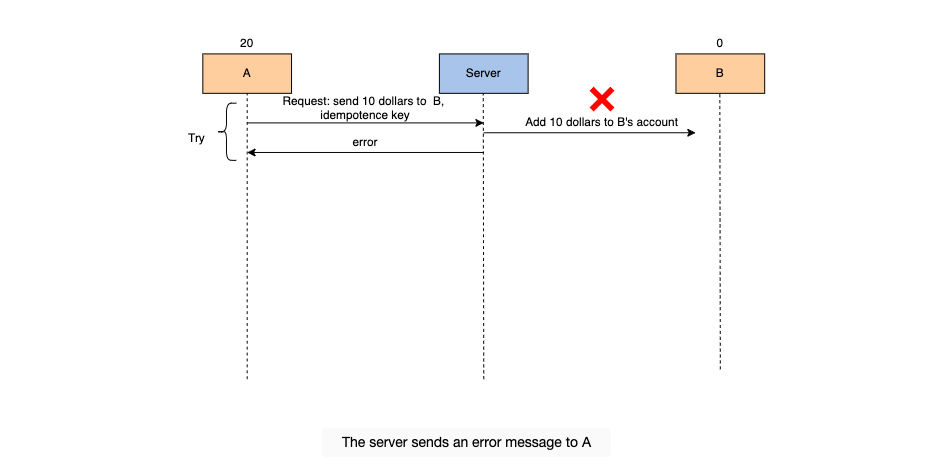
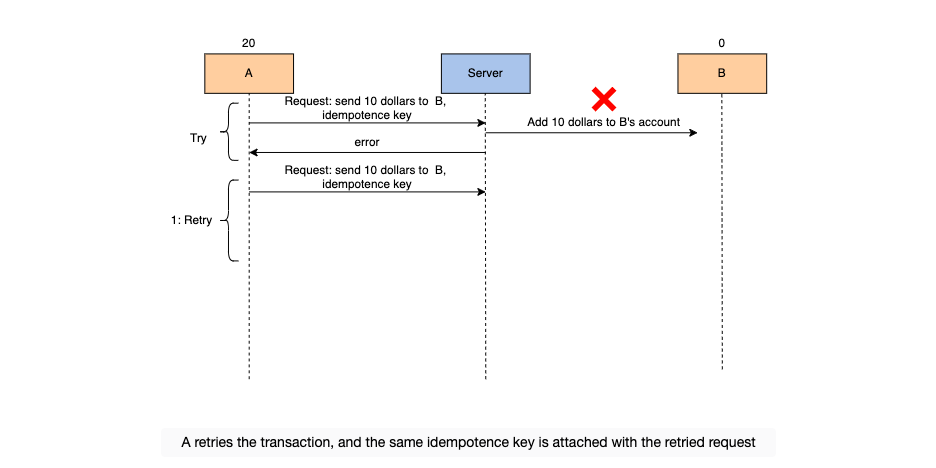
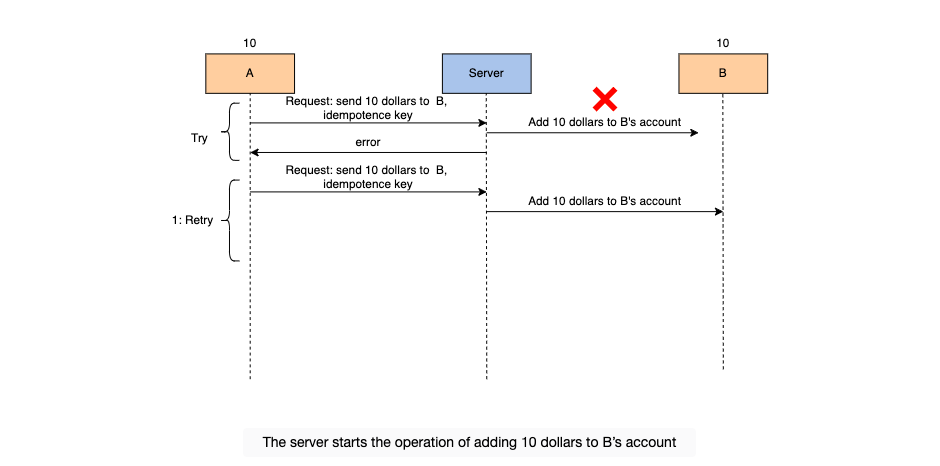
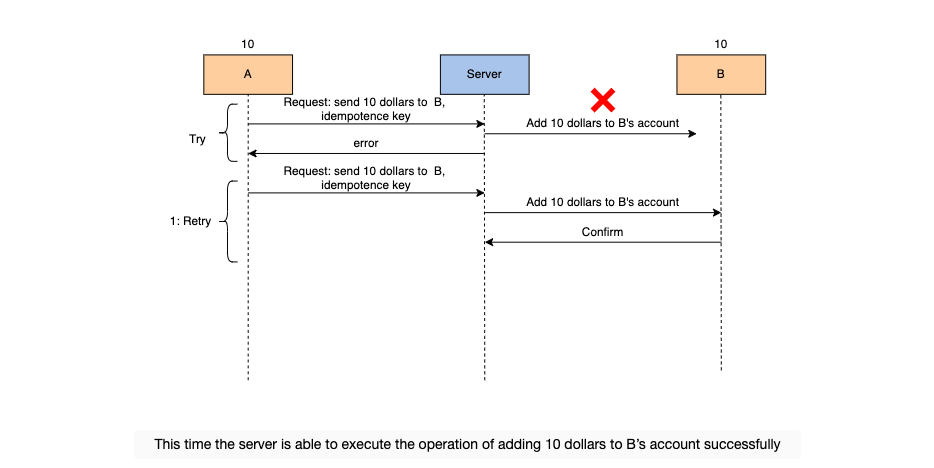
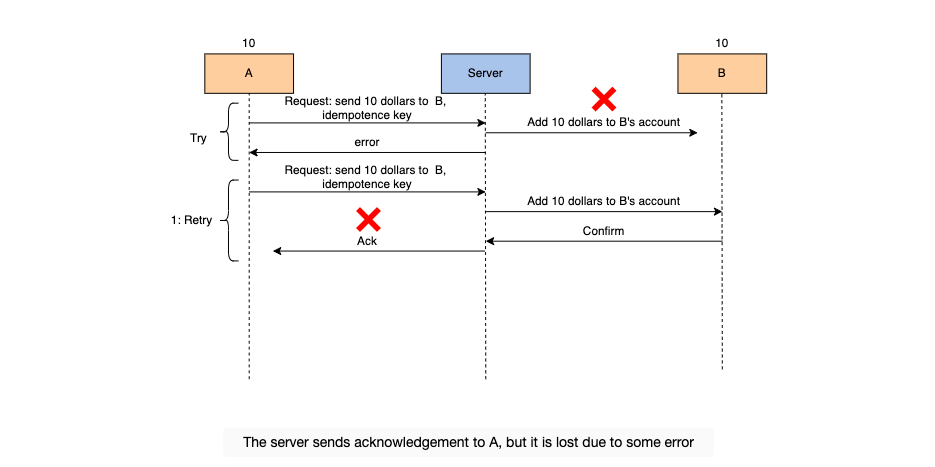
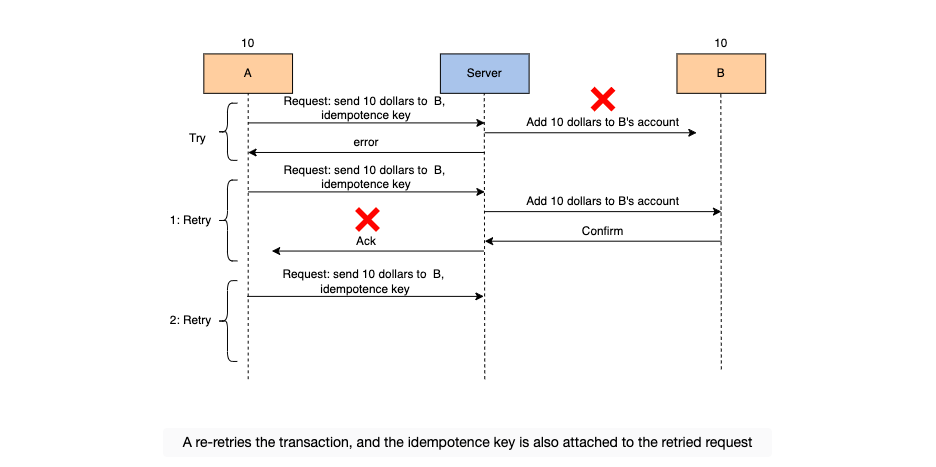
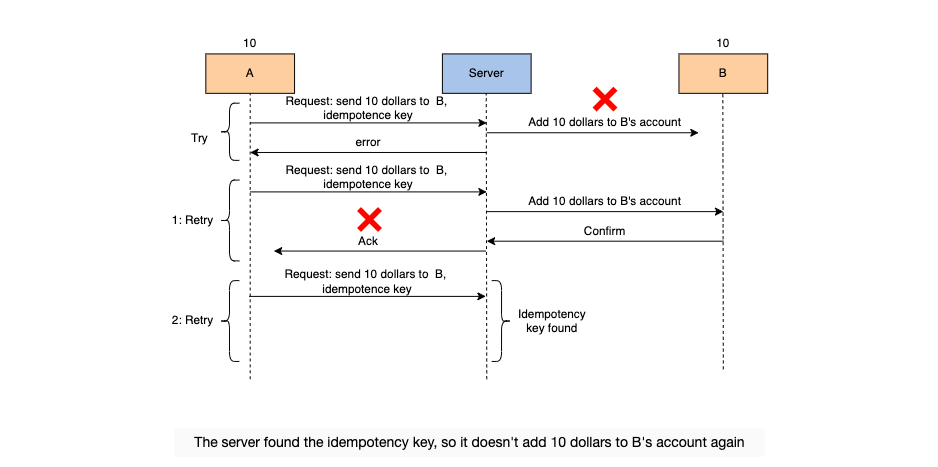
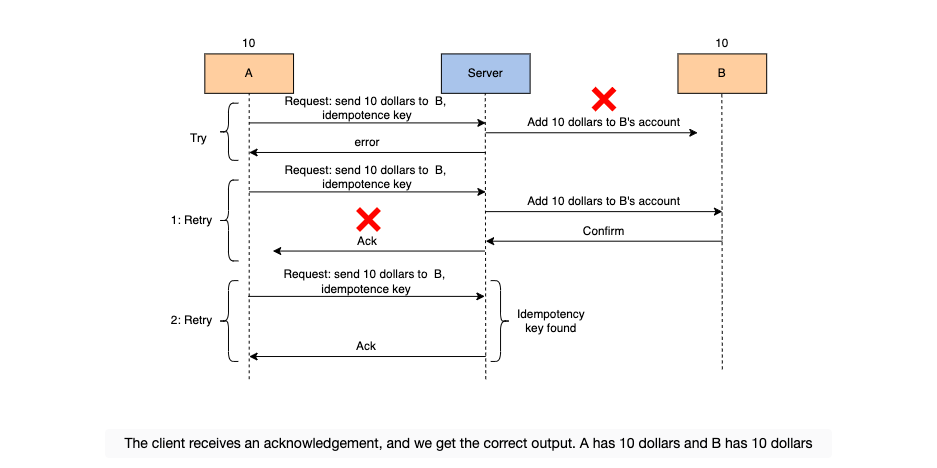
Сделаем задачу загрузки видео в базу данных идемпотентной операцией. Мы не хотим, чтобы видео было дублировано в базе данных, если загрузчик не получил подтверждение. Идемпотентность гарантирует, что видео не будет дублировано. Это свойство добавляется разработчиками на этапе реализации, где они идентифицируют видео по какому-либо признаку (например, имени) и перезаписывают старое. Таким образом, независимо от того, сколько раз кто-то загружает видео, конечный результат будет одинаковым. Идемпотентность позволяет нам просто повторно выполнить неудачную задачу.
How should we handle task execution that can never be completed because of an infinite loop in the payload of that task?
Details
We need to mark and kill such tasks. So, for this purpose, we can set time limits. If it takes more than the specified execution cap value, we can kill the task. But it’s challenging to differentiate between a buggy task and a long task. We can handle it at the application level where the clients take care of the long tasks by saving the state at different times. Clients can also resume from that state if the task scheduler kills that task, assuming that the task contains an infinite loop.
Schedule and execute untrusted tasks
Прежде чем продолжить, давайте зададимся вопросом: что такое недоверенные задачи (untrusted tasks) и как их следует управлять?
Недоверенные задачи — это задачи, в которых есть вероятность наличия вредоносных инструкций в скрипте задачи, которые могут повлиять на выполнение других задач. Подверженными воздействию могут оказаться задачи других арендаторов (tenants). Недоверенные задачи также могут нанести вред операционной системе или ресурсу, на котором они выполняются.
Программы могут содержать скрытые ошибки и иметь злонамеренные намерения. При использовании планировщиков задач нужно быть осторожным, чтобы одна задача не повлияла негативно на другие. Если мы предоставляем инфраструктуру как услугу (Infrastructure as a Service, IaaS), безопасность является важным компонентом. Это связано с тем, что арендаторам становится легче наносить вред задачам друг друга, выполняя вредоносный код в общем окружении. Выполнение вредоносного кода также может нанести ущерб нашей инфраструктуре. Поэтому необходимо учитывать следующие соображения:
- Использование соответствующей аутентификации и авторизации ресурсов.
- Рассмотрение песочниц (sandboxing) с использованием контейнеров Docker или виртуальных машин.
- Использование изоляции производительности между задачами путем мониторинга использования ресурсов задачами и ограничения (или завершения) задач, которые ведут себя некорректно.
What happens when the same task fails multiple times?
Details
We can use a dead-letter queue facility to isolate repeatedly failing tasks.
Evaluation of a Distributed Task Scheduler's Design
Availability
Первым компонентом в нашем проекте был ограничитель скорости (rate limiter), который соответствующим образом реплицируется и обеспечивает доступность. Отправка задач осуществляется несколькими узлами. Если узел, который отправляет задачу, выходит из строя, другие узлы занимают его место. Очередь, в которую мы помещаем задачу, также распределена по своей природе, что обеспечивает доступность. У нас всегда есть доступные ресурсы, так как мы постоянно мониторим необходимость добавления или удаления ресурсов. Каждый компонент в проекте распределен, что делает всю систему доступной.
Durability
Мы храним задачи в постоянной (persistent) распределенной базе данных и помещаем задачи в очередь незадолго до времени их выполнения. Как только задача отправлена, она находится в базе данных до момента её выполнения.
Scalability
Наш планировщик задач обеспечивает масштабируемость, так как отправка задач распределена в нашем проекте. Мы можем добавлять больше узлов в кластер для отправки увеличивающегося числа задач. Задачи затем сохраняются в распределенной реляционной базе данных (RDB), которая также масштабируема. Задачи из RDB затем отправляются в распределенную очередь (distributed queue), которая может масштабироваться с увеличением количества задач. Мы можем добавлять больше очередей для разных типов задач. Мы также можем добавлять больше ресурсов в зависимости от соотношения ресурсов и спроса.
Fault tolerance
Задача не удаляется из очереди при первой отправке на выполнение. Если выполнение не удается, мы повторяем попытку максимальное количество раз. Если задача содержит бесконечный цикл, мы останавливаем выполнение задачи через заданное время и уведомляем пользователя.
Bounded waiting time
Мы не позволяем пользователям ждать бесконечно. У нас есть ограничение на максимальное время ожидания. Если лимит достигнут и мы по каким-то причинам не можем запланировать выполнение задачи, мы уведомляем пользователей и просим их попробовать снова.
Conclusion
Мы обсудили разницу между планировщиком задач на уровне операционной системы (OS-level) и планировщиком задач на уровне дата-центра (data center-level). Мы объяснили, что планирование задач на уровне дата-центра требует распределенного решения из-за наличия множества арендаторов и распределенных ресурсов. Мы узнали, что очередь является основным строительным блоком планировщика задач. Мы также использовали распределенные очереди, которые могут масштабироваться с увеличением числа задач для эффективного использования увеличивающегося числа ресурсов.
Этот урок помог нам оценить проблемы, связанные с очередью FIFO. Было отмечено, что основная задача планировщика задач заключается в установлении приоритетов задач, для чего мы использовали параметр допустимой задержки (delay tolerance). Мы обсудили, как планировщик задач определяет значение допустимой задержки и использовали различные распределенные базы данных для хранения данных о задачах. Мы гарантировали, что зависимые задачи выполняются в порядке, запуская их согласно DAG, хранящемуся в графовой базе данных (graph database). В зависимости от количества задач (или спроса) мы добавляли или удаляли ресурсы для оптимизации пропускной способности. В конце мы использовали службу мониторинга, которая уведомляет администраторов в случае необходимости добавления или удаления ресурсов.