Distributed Monitoring
Monitoring
Современная экономика зависит от непрерывной работы IT-инфраструктуры. Такая инфраструктура включает в себя аппаратное обеспечение, распределенные сервисы и сетевые ресурсы. Эти компоненты взаимосвязаны, что делает поддержание бесперебойной работы и отсутствие downtime (простои) приложений сложной задачей.
Введение в мониторинг распределенных систем
Когда наша инфраструктура распределена по нескольким локациям и включает множество серверов, сложно понять, что происходит на уровне аппаратного обеспечения или приложений. Компоненты могут сталкиваться с отказами, превышением latency (задержка), перегрузками или недоступностью оборудования, нехваткой ресурсов в контейнерах и многими другими проблемами. В такой инфраструктуре работают множество сервисов, и любой из них может выйти из строя.
Важность мониторинга
Когда один из сервисов выходит из строя, это может вызвать сбои других сервисов, в результате чего приложение становится недоступным для пользователей. Если мы не узнаем, что пошло не так на раннем этапе, устранение проблемы вручную может занять много времени и усилий. Более того, для крупных сервисов необходимо гарантировать, что наши услуги работают в рамках согласованных SLA (соглашения об уровне обслуживания). Важно улавливать ключевые тенденции и сигналы надвигающихся сбоев как ранние предупреждения, чтобы можно было своевременно устранить любые проблемы.
Преимущества мониторинга
Monitoring помогает анализировать сложную инфраструктуру, где постоянно что-то выходит из строя. Мониторинг распределенных систем включает сбор, интерпретацию и отображение данных о взаимодействиях между процессами, которые выполняются одновременно. Это помогает в debugging (отладка), тестировании, оценке производительности и обеспечивает общий обзор множества сервисов.
Как мы будем проектировать систему распределенного мониторинга?
Мы разделили проектирование системы распределенного мониторинга на следующие главы и уроки:
-
Распределенный мониторинг
- Введение в распределенный мониторинг: Узнайте, почему мониторинг в распределенной системе имеет решающее значение, насколько дорого обходится downtime, и какие виды мониторинга существуют.
- Предварительные требования к системе мониторинга: Изучите несколько важных концепций, касающихся метрик и alerting (оповещения) в системе мониторинга.
-
Мониторинг серверных ошибок
- Проектирование системы мониторинга: Определите требования и общую концепцию системы мониторинга.
- Детальное проектирование системы мониторинга: Погрузитесь в детали проектирования системы мониторинга и изучите задействованные компоненты.
- Визуализация данных в системе мониторинга: Узнайте уникальные способы визуализации огромного объема данных мониторинга.
-
Мониторинг клиентских ошибок
- Фокус на клиентских ошибках: Познакомьтесь с клиентскими ошибками и узнайте, почему важно их мониторить.
- Проектирование системы мониторинга клиентских ошибок: Узнайте, как спроектировать систему, которая будет мониторить клиентские ошибки.
В следующем уроке мы рассмотрим, почему мониторинг важен в распределенной системе на примере. Мы также обсудим стоимость downtime из-за сбоев и различные типы мониторинга.
Introduction to Distributed Monitoring
Необходимость мониторинга
Рассмотрим, как сбой одной службы может повлиять на бесперебойную работу связанных систем. Чтобы избежать каскадных отказов, мониторинг может сыграть важную роль, предоставляя ранние предупреждения или помогая найти коренную причину неисправностей.
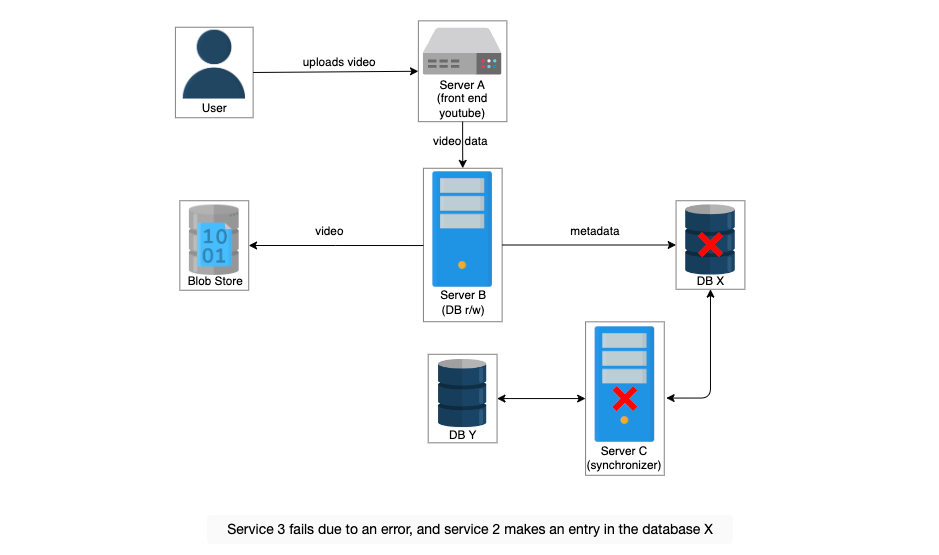
Рассмотрим сценарий, в котором пользователь загружает видео под названием "intro-to-system-design" на YouTube. Служба UI на сервере A получает информацию о видео и передает данные службе 2 на сервере B. Служба 2 делает запись в базе данных и сохраняет видео в хранилище блобов. Другая служба, 3, на сервере C управляет репликацией и синхронизацией баз данных X и Y.
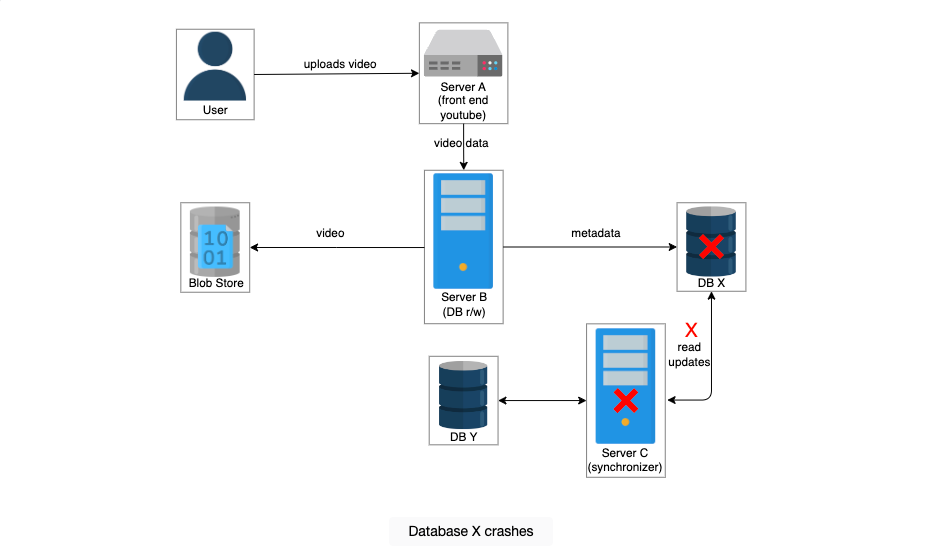
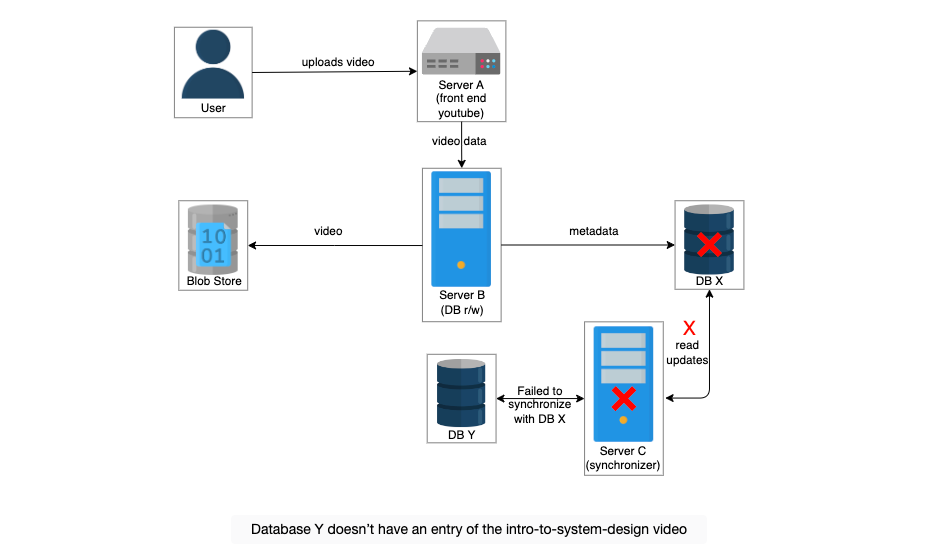
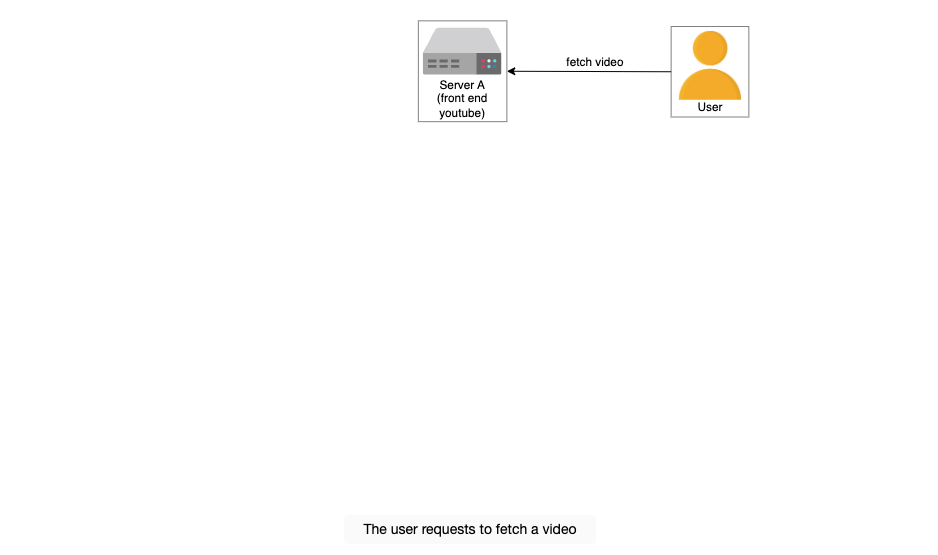
В этом сценарии служба 3 выходит из строя из-за какой-то ошибки, и служба 2 делает запись в базе данных X. База данных X выходит из строя, и запрос на получение видео перенаправляется в базу данных Y. Пользователь пытается воспроизвести видео "intro-to-system-design", но получает сообщение об ошибке "Видео не найдено…"
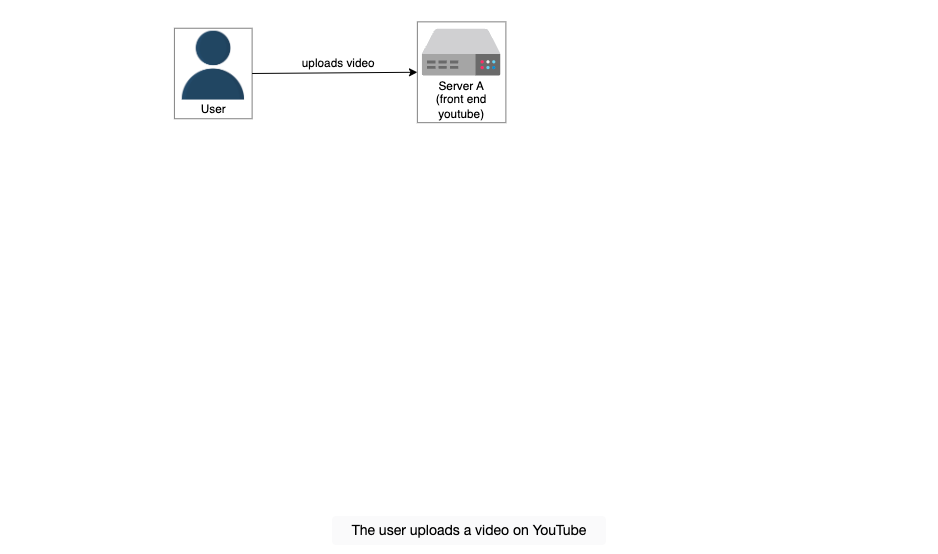
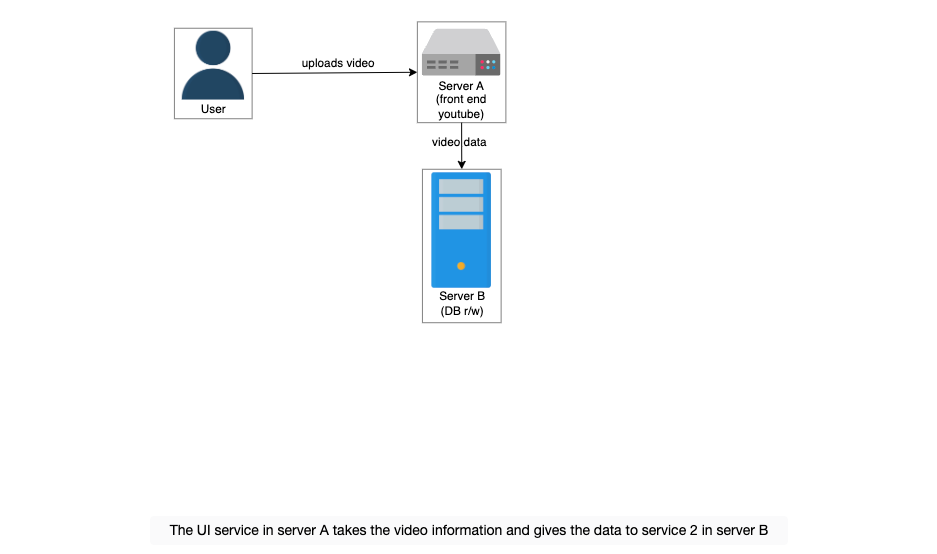
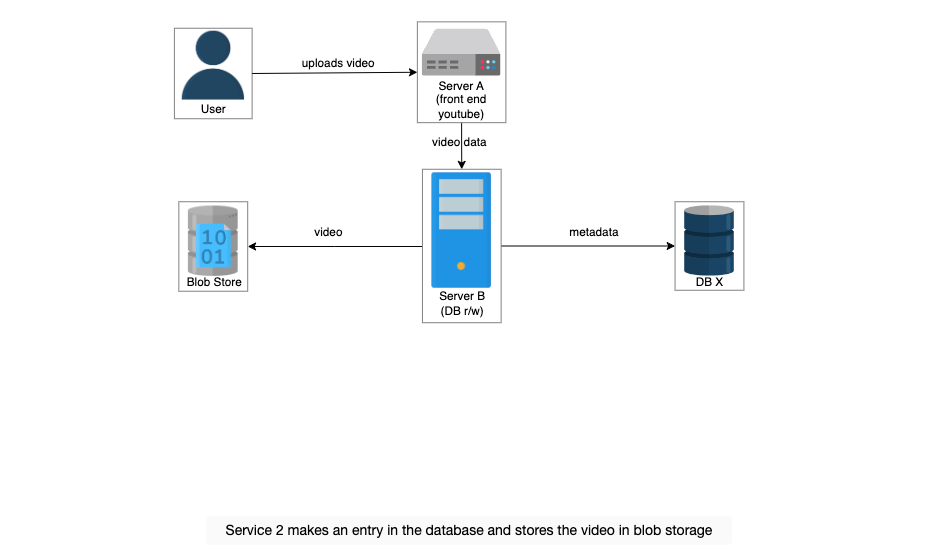
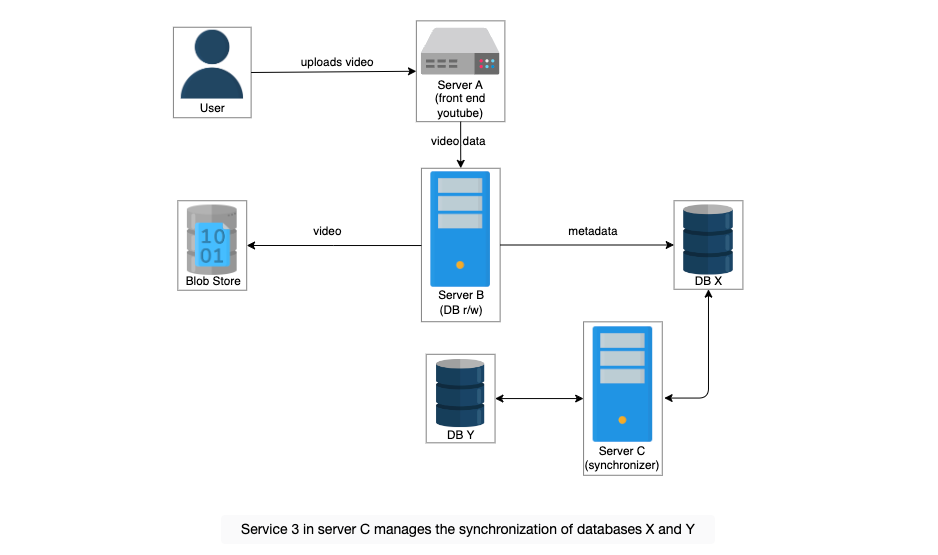
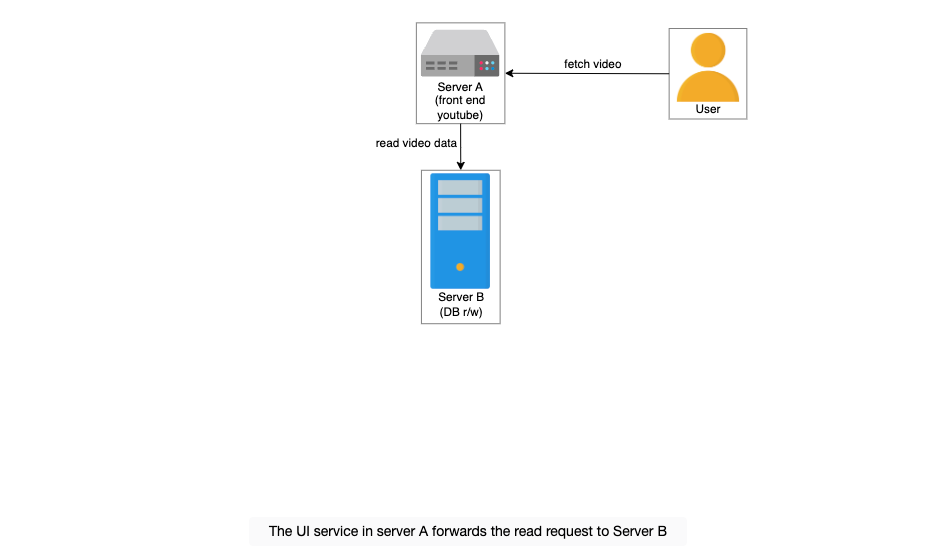
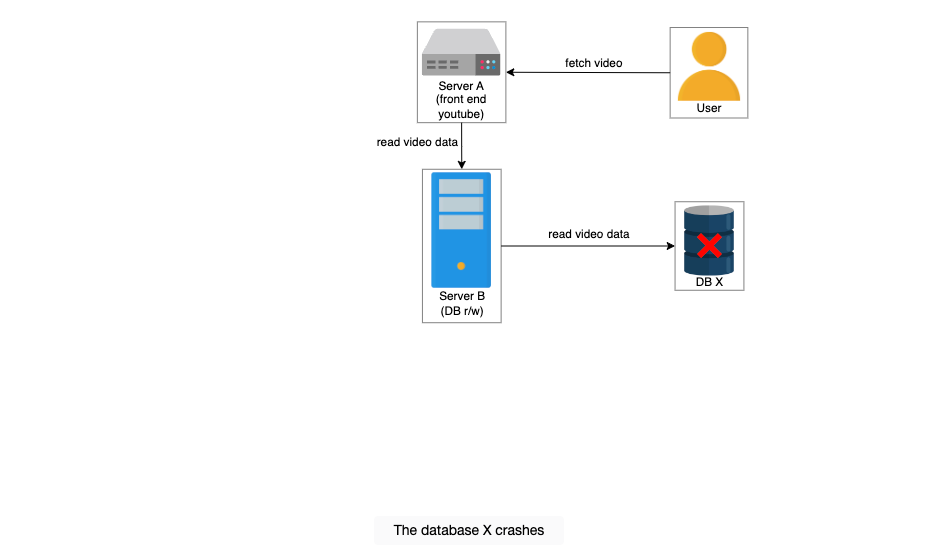
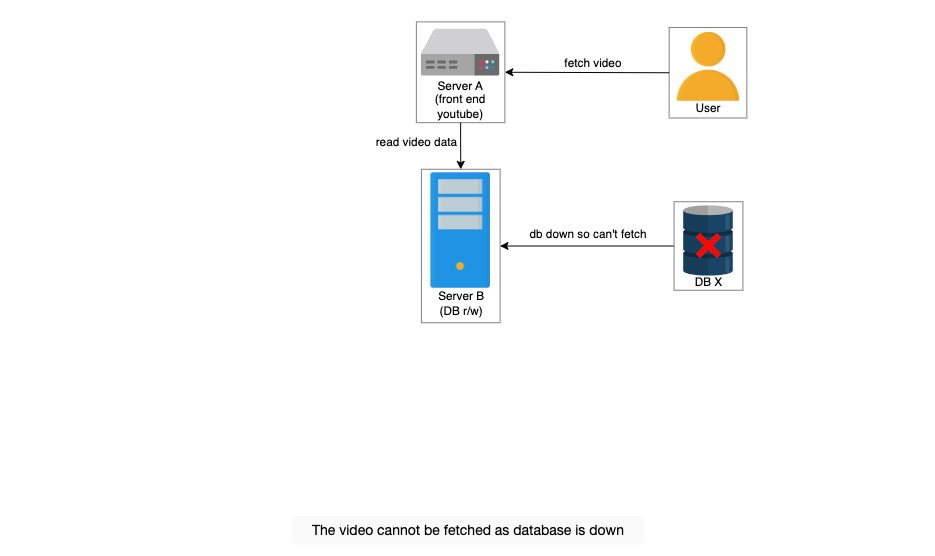
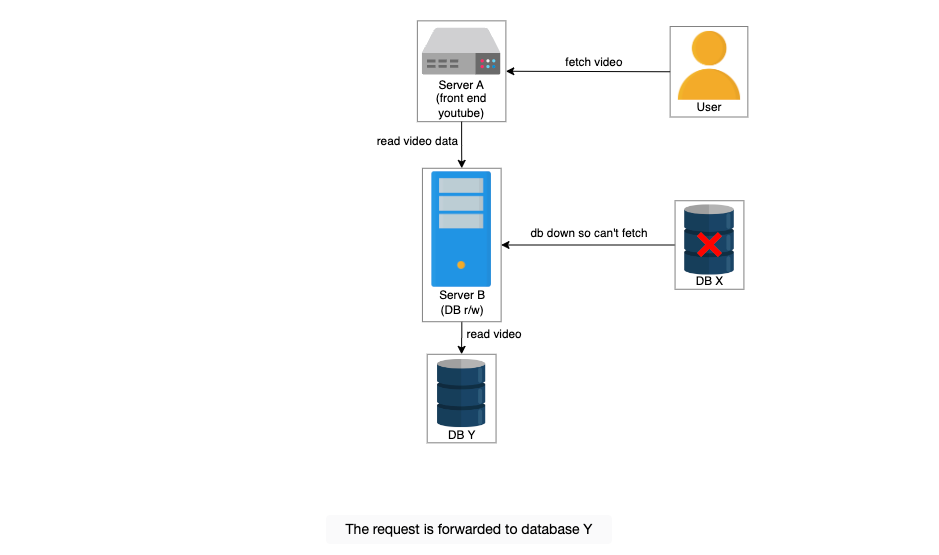
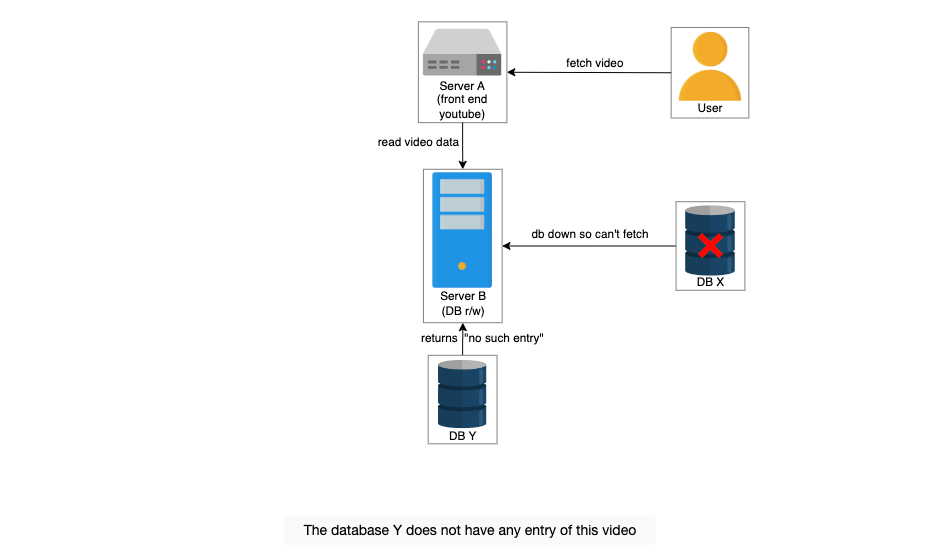
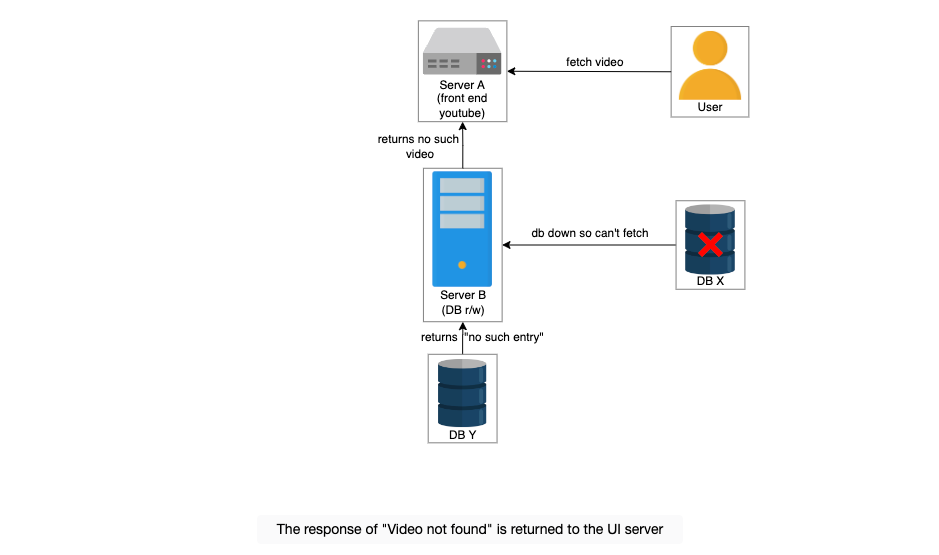
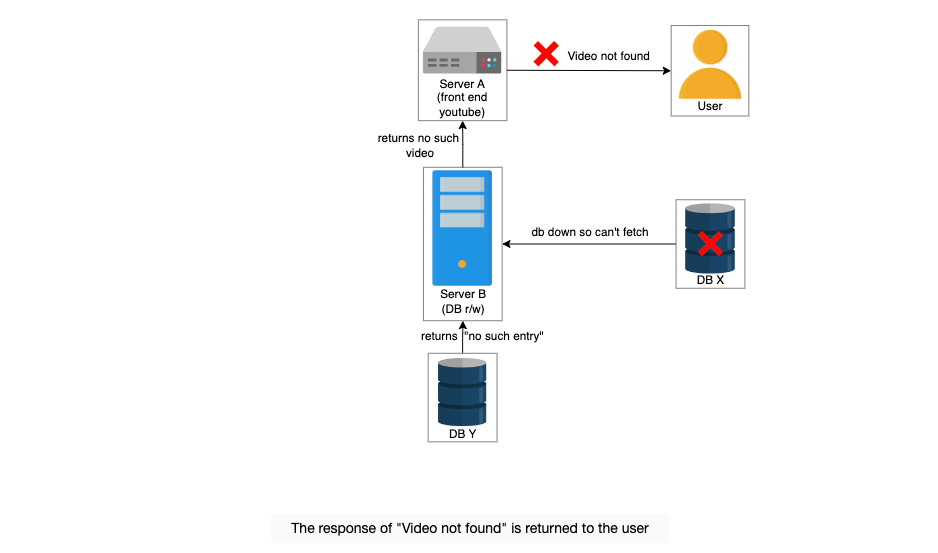
Приведенный выше пример относительно прост. В реальности сталкиваются с более сложными проблемами, поскольку у нас есть множество дата-центров по всему миру, и каждый из них содержит миллионы серверов. Из-за уменьшающегося соотношения количества администраторов к количеству серверов часто становится невозможным вручную находить проблемы. Наличие системы мониторинга снижает операционные расходы и способствует автоматизированному способу обнаружения сбоев.
Стоимость простоя
Существуют отказоустойчивые системы, которые скрывают большинство сбоев от конечных пользователей, но важно выявлять сбои до того, как они перерастут в более серьезную проблему. Непланируемый сбой в работе служб может быть дорогостоящим. Например, в октябре 2021 года приложения Meta не работали почти девять часов, что привело к потерям около 13 миллионов долларов в час. Такие потери подчеркивают возможные последствия сбоев.
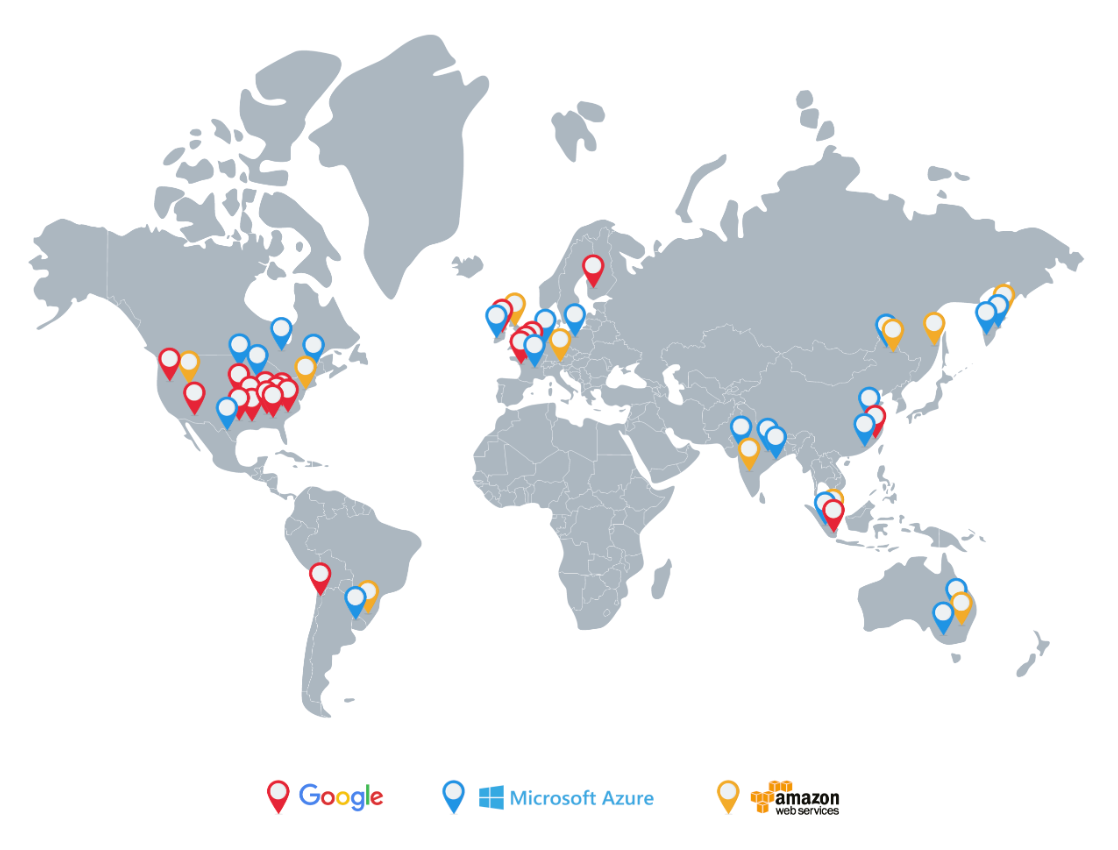
IT-инфраструктура широко распространена по всему миру. На иллюстрации ниже представлен обзор распределенных дата-центров крупных облачных провайдеров по всему миру на 2021 год. Дата-центры соединены через частные или общественные сети. Мониторинг серверов в географически разнесенных дата-центрах является необходимым.
По данным Amazon, 7 декабря 2021 года, "В 7:30 утра по тихоокеанскому времени автоматизированная операция по увеличению емкости одной из служб AWS, размещенной в основной сети AWS, вызвала неожиданное поведение у большого числа клиентов внутри внутренней сети. Это привело к резкому увеличению активности подключений, которое перегрузило сетевые устройства между внутренней сетью и основной сетью AWS, что привело к задержкам в связи между этими сетями. Эти задержки увеличили время отклика и ошибки для служб, общающихся между этими сетями, что привело к еще большему количеству попыток подключения и повторных попыток. Это привело к постоянной перегрузке и проблемам с производительностью на устройствах, соединяющих две сети." По оценкам, простой Amazon обошелся компании в $66,240 за минуту.
Types of monitoring
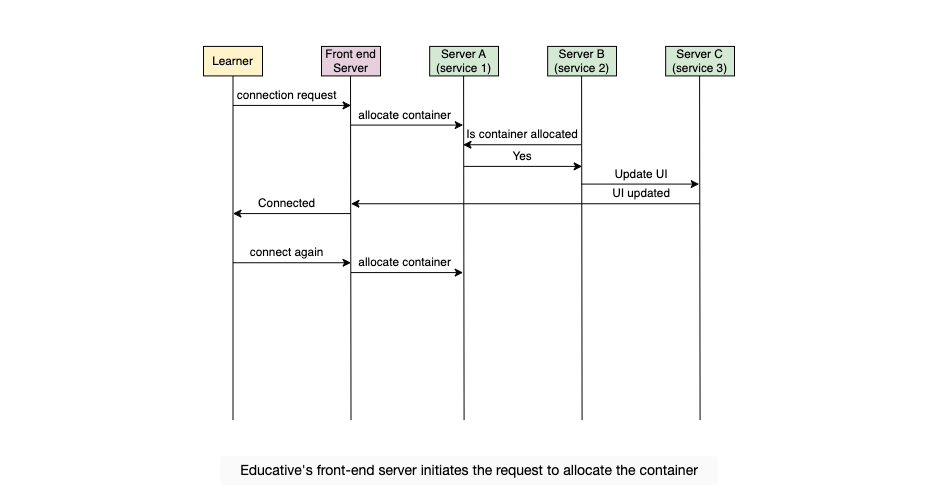
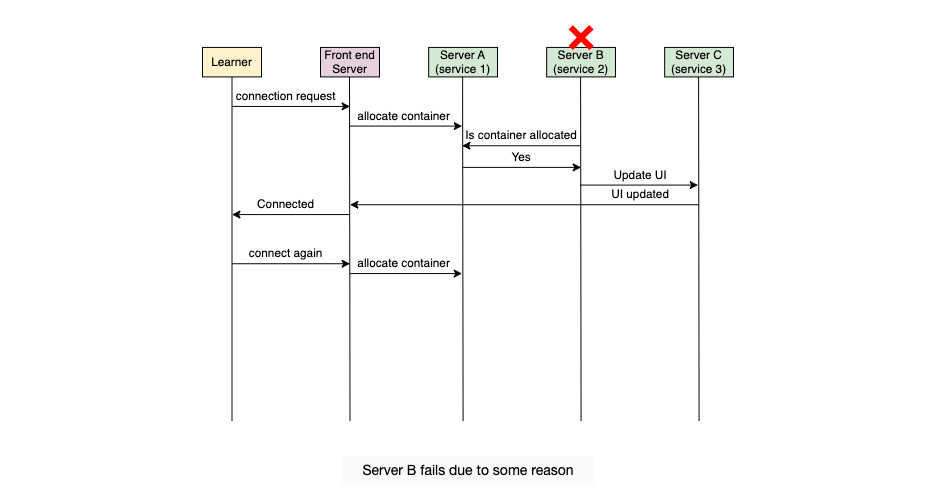
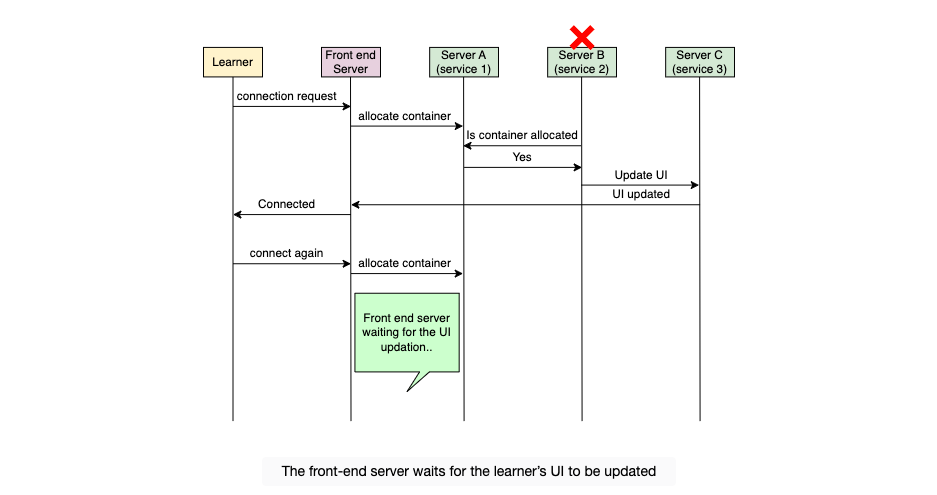
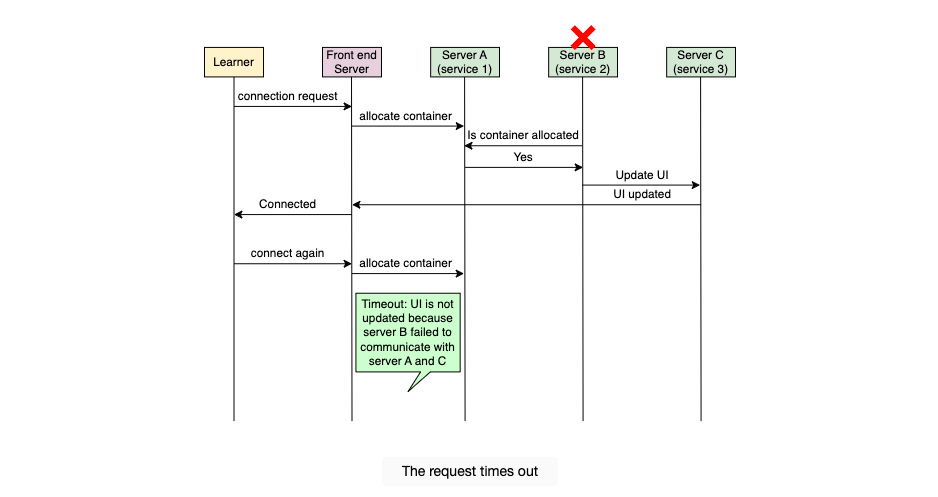
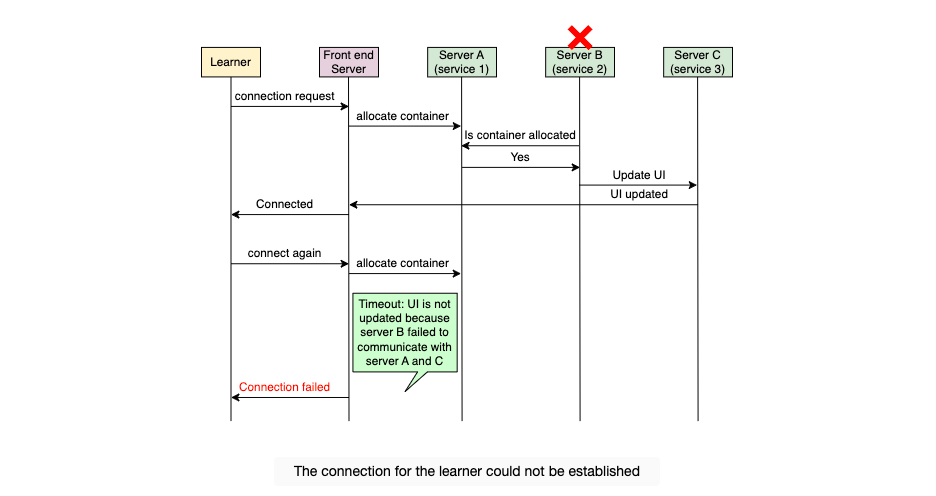
Рассмотрим пример, чтобы понять, какие типы ошибок нам нужно отслеживать. На платформе Educative всякий раз, когда учащийся подключается к исполняемой среде, ему назначается контейнер. Предположим, что служба 1 на сервере A отвечает за выделение контейнера всякий раз, когда учащийся подключается. Другая служба, 2 на сервере B, получает эту информацию и сообщает службе, отвечающей за пользовательский интерфейс (UI). Служба UI, работающая на сервере C, обновляет интерфейс для учащегося. Допустим, что служба 2 выходит из строя из-за какой-то ошибки, и учащийся видит сообщение об ошибке «Cannot connect…» («Не удается подключиться...»).
Как разработчики Educative узнают о том, что учащийся сталкивается с этой ошибкой?
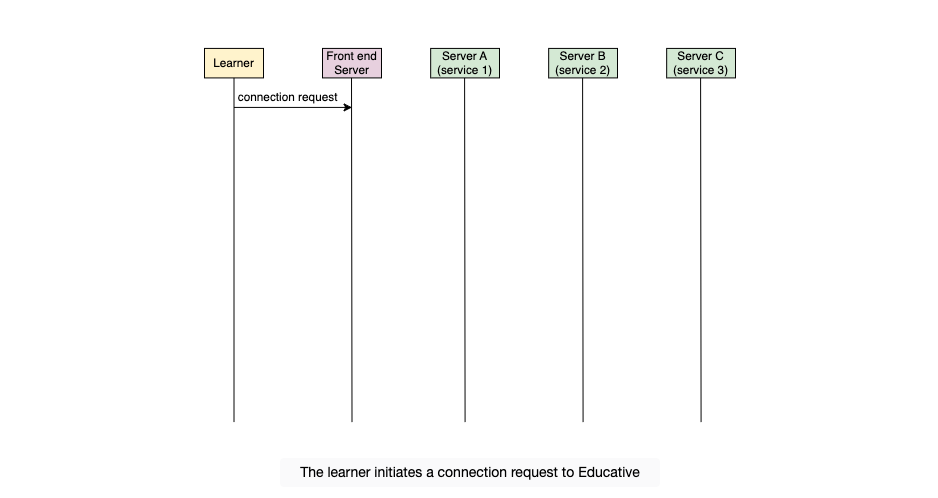
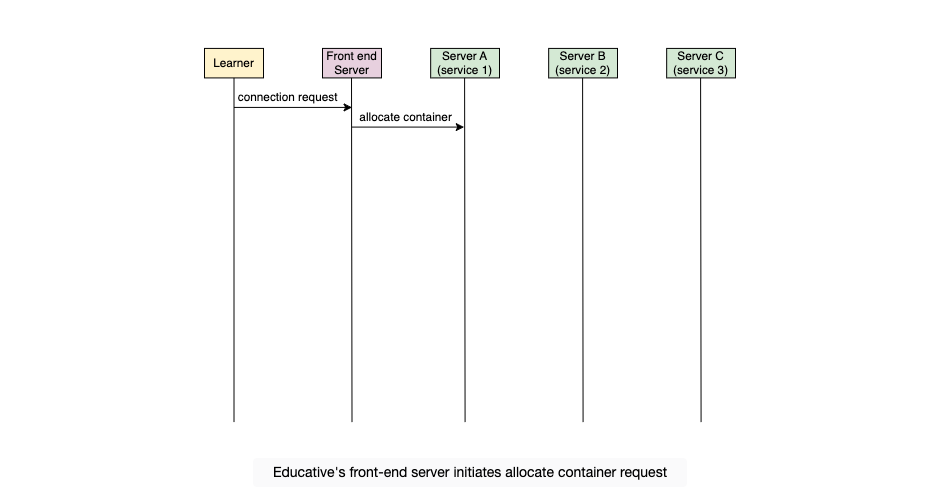
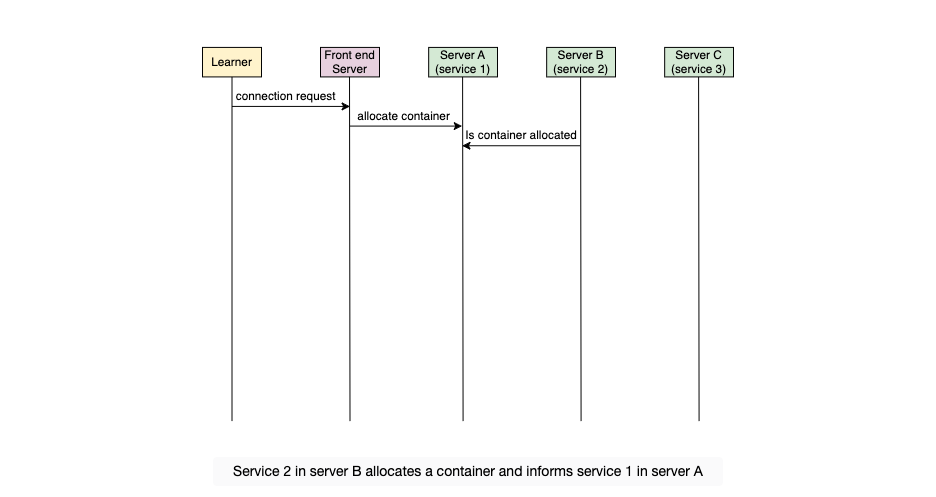
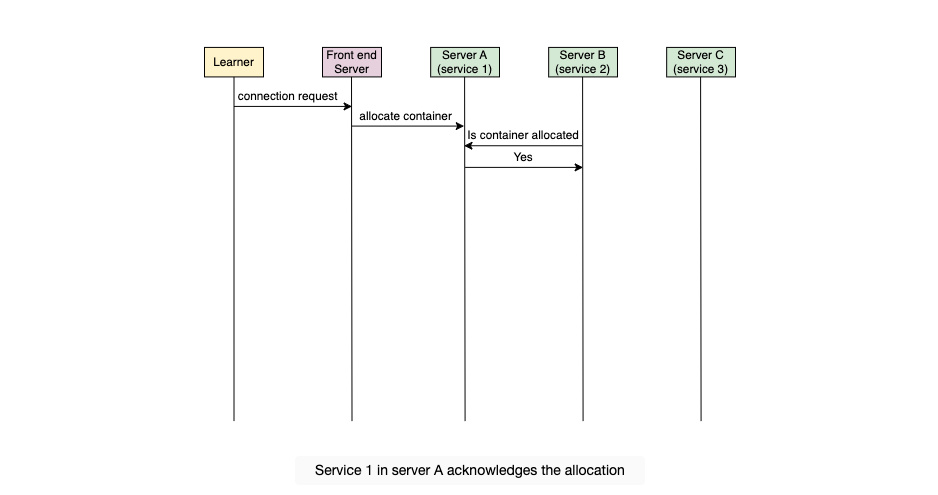
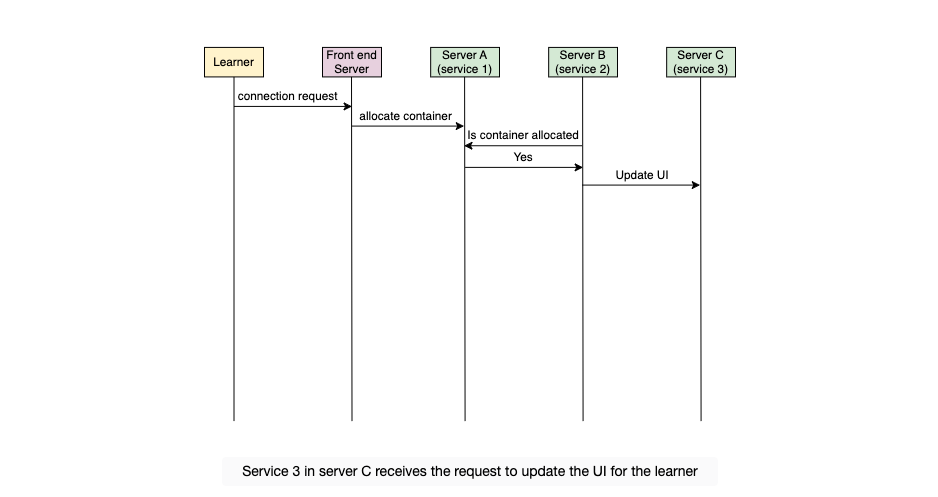
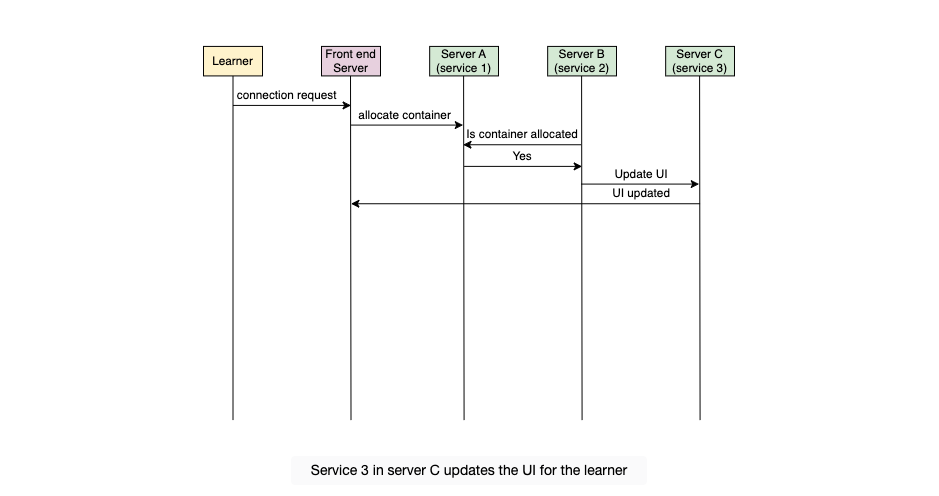
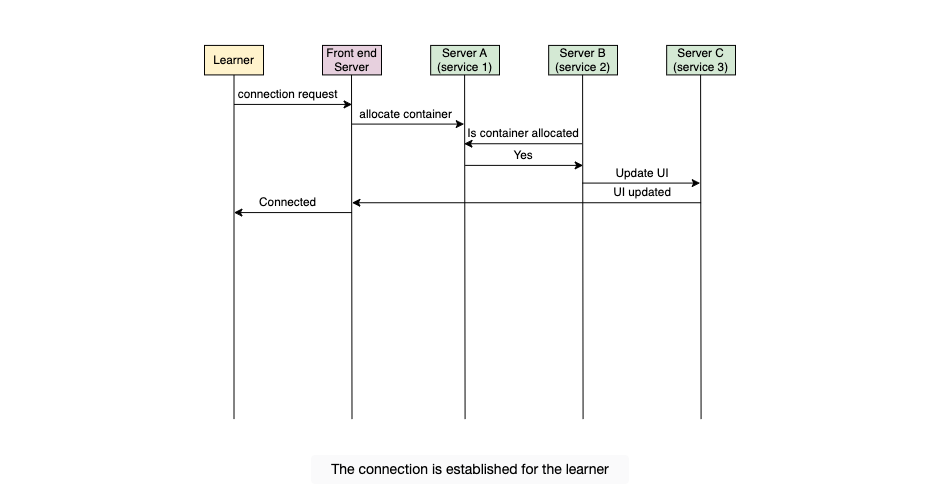
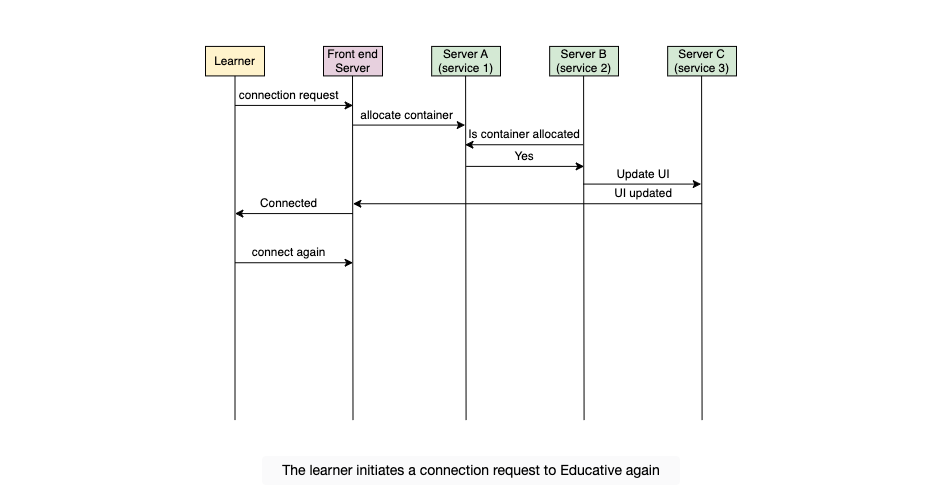
Теперь представьте, что учащийся отправляет запрос, и он никогда не достигает серверов Educative. Как Educative узнает, что у учащегося возникла проблема?
С учетом приведенных выше примеров мы можем разделить наше внимание на мониторинг двух широких категорий ошибок:
1. Ошибки на стороне сервера:
Это ошибки, которые обычно видны службам мониторинга, так как они происходят на серверах. Такие ошибки отображаются в виде 5xx-кодов в HTTP-ответах.
2. Ошибки на стороне клиента:
Это ошибки, корень которых находится на стороне клиента. Такие ошибки отображаются в виде 4xx-кодов в HTTP-ответах. Некоторые клиентские ошибки остаются невидимыми для службы, когда запросы от клиента не достигают сервера.
Мы рассмотрим, как спроектировать систему мониторинга для обработки обоих сценариев в следующих главах: Мониторинг серверных ошибок и Мониторинг клиентских ошибок. Мы хотим, чтобы наши системы мониторинга анализировали наши глобально распределенные сервисы, что позволит лучше понимать компоненты системы и оперативно обнаруживать и устранять неисправности.
Prerequisites of a Monitoring System - Предпосылки системы мониторинга
Мониторинг: метрики и оповещения
Хорошая система мониторинга должна чётко определять, что измерять и в каких единицах (метрики). Также система мониторинга должна устанавливать пороговые значения для всех метрик и иметь возможность информировать соответствующих заинтересованных лиц (оповещения), когда значения выходят за пределы допустимых диапазонов. Знание состояния нашей инфраструктуры и систем обеспечивает стабильность сервиса. Команда поддержки может реагировать на проблемы быстрее и увереннее, если у неё есть доступ к информации о состоянии и производительности развертываний. Системы мониторинга, которые собирают измерения, отображают данные и отправляют предупреждения, когда что-то кажется неправильным, полезны для команды поддержки.
Чтобы лучше понять метрики, оповещения и их связь с мониторингом, мы рассмотрим их значение, потенциальные преимущества и данные, которые мы можем отслеживать.
Вопрос для оценки понимания
What are the conventional approaches to handle failures in IT infrastructure?
Details
The two conventional approaches to handling IT infrastructure failures are the reactive and proactive approaches.
In the reactive approach, corrective action is taken after the failure occurs. In this approach, even if DevOps takes quick action to find the cause of the error and promptly handle the failures, it causes downtime. As a result, there will be system downtime in the reactive approach, which is generally undesirable for continuously running applications.
In a proactive approach, proactive actions are taken before failure occurs. Therefore, it prevents downtimes and associated losses. The proactive approach works on predicting system failures to take corrective action to avoid the failure. This approach offers better reliability by preventing downtime.
In modern services, completely avoiding problems is not possible. Something is always failing inside huge data centers and network deployments. The goal is to find the impending problems early on and design systems in such a way that service faults are invisible to the end users.
Метрики
Метрики объективно определяют, что мы должны измерять и какие единицы будут подходящими. Значения метрик дают представление о состоянии системы в любой момент времени. Например, способность веб-сервера обрабатывать определенное количество трафика в секунду или его способность присоединяться к пулу веб-серверов — это примеры данных высокого уровня, связанных с конкретной задачей или активностью компонента. Другим примером может быть измерение производительности сети с точки зрения пропускной способности (мегабиты в секунду) и задержки (время кругового путешествия). Нам необходимо собирать значения метрик с минимальной потерей производительности. Для этого можно использовать такие показатели, как задержка, воспринимаемая пользователем, или количество вычислительных ресурсов, необходимых для измерений.
Значения, отслеживающие количество физических ресурсов, используемых нашей операционной системой, могут быть хорошей отправной точкой. Если у нас есть система мониторинга, нам не нужно выполнять много дополнительной работы, чтобы получить данные о нагрузке на процессор, статистике ЦП, такой как количество попаданий и промахов в кэш, использовании ОЗУ операционной системой и процессами, ошибках страницы, объеме дискового пространства, задержках чтения и записи на диск, использовании пространства подкачки и так далее. Метрики, предоставляемые многими веб-серверами, серверами баз данных и другим программным обеспечением, помогают нам определить, всё ли работает гладко.
Примечание: Подключитесь к следующему терминалу, чтобы увидеть информацию об использовании ЦП процессами, которые в настоящее время активны на виртуальной машине.
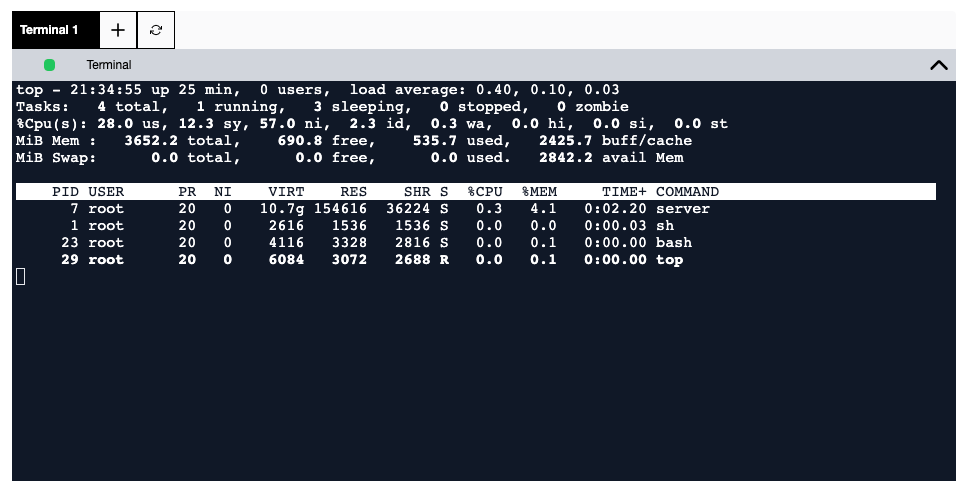
Мы используем команду top для просмотра процессов в Linux. Запуск этой команды открывает интерактивное представление работающей системы, содержащее сводку состояния системы и список процессов или потоков. В представлении по умолчанию отображается следующее:
-
В верхней части экрана можно увидеть, как долго машина была включена, сколько пользователей вошло в систему и среднюю нагрузку на машину за последние несколько минут.
-
На следующей строке отображается состояние (запущено, в режиме ожидания или остановлено) задач, выполняемых на машине.
-
Далее приведены значения потребления ЦП.
-
В конце представлена информация о физической памяти: сколько памяти свободно, используется, буферизовано или доступно.
Теперь давайте выполним следующие шаги, чтобы увидеть изменение использования ЦП:
- Выйдите из программы, введя
qв терминале. - Запустите команду
nohup ./script.sh &>/dev/null &. Этот скрипт содержит бесконечный цикл, и выполнение команды запустит скрипт в фоновом режиме. - Запустите команду
top, чтобы наблюдать за увеличением использования ЦП.
Сбор метрик
Метрики должны быть логически централизованы для глобального мониторинга и уведомлений. Сбор метрик является важнейшим аспектом системы мониторинга. Метрики могут быть как отправлены, так и запрашиваться системой мониторинга в зависимости от предпочтений пользователя.
Здесь мы сталкиваемся с фундаментальной проблемой дизайна: использовать ли подход push или pull? Должен ли сервер проактивно отправлять значения метрик, или он должен просто предоставить конечную точку (endpoint) и ожидать запроса?
В стратегии pull каждый отслеживаемый сервер просто хранит метрики в памяти и передает их на предоставленный конечный пункт. Этот конечный пункт позволяет приложению мониторинга самостоятельно запрашивать метрики. Серверы, которые отправляют слишком много данных или делают это слишком часто, не могут перегрузить систему мониторинга, поскольку система мониторинга будет запрашивать данные в соответствии с собственным расписанием.
Однако в других ситуациях может быть выгодно использовать подход push, например, когда брандмауэр предотвращает прямой доступ системы мониторинга к серверу. Система мониторинга имеет возможность настроить глобальную конфигурацию, определяющую данные, которые следует собирать, и интервалы, с которыми серверы и коммутаторы должны отправлять данные.
Терминология push и pull может сбивать с толку. Когда мы обсуждаем стратегии push или pull, мы рассматриваем их с точки зрения системы мониторинга. То есть либо система будет запрашивать значения метрик у приложений, либо метрики будут отправляться в систему мониторинга. Чтобы избежать путаницы, мы будем придерживаться точки зрения системы мониторинга.
Примечание: В модели pull система мониторинга запрашивает данные у распределенных сборщиков данных, которые собираются локально. Это означает, что поток данных происходит только по запросу системы мониторинга. В модели push распределенные сборщики периодически отправляют собранные данные в систему мониторинга.
Logging is the act of keeping records of events in a software system. How does it help in monitoring?
Details
In logging, the application servers log the information into the file. The information can be CPU usage, application-related information, and other relevant properties that we deem necessary to backtrace or debug a file when a problem is encountered. We can populate our metrics based on the values logged in the logs.
Logs and metrics both help in monitoring a service. But this isn’t always true since processing the log information takes time. In real time, we need to act swiftly for early detection of issues. So, logging is also one of the inputs of metrics. Logging is just a mechanism to collect information, and the monitoring system can use it for collecting necessary information.
Logging can also help to temporarily keep the data on a server to absorb any momentary data spikes or to decouple data generation and monitoring systems.
Примечание: Иногда мы используем слово «метрики», когда на самом деле следует использовать «значения метрик». Однако, исходя из контекста, можно понять, о чем именно идет речь.
Сохранение данных
Определение способа хранения метрик с серверов, которые находятся под мониторингом, является важной задачей. Для небольшого объема данных может быть достаточно централизованного репозитория метрик в памяти. Однако для большого дата-центра с миллионами объектов для мониторинга потребуется огромное количество данных для хранения, и в этом случае может помочь использование базы данных временных рядов.
Базы данных временных рядов помогают поддерживать долговечность данных, что является важным фактором. Без исторического представления событий система мониторинга не будет очень полезной. Образцы данных со значениями и временными метками хранятся в хронологической последовательности, так что вся временная шкала метрики может быть представлена в виде временного ряда.
Метрики приложений
Нам может потребоваться добавить код или API для экспонирования метрик, которые нас интересуют, для других компонентов, особенно для наших собственных приложений. Мы встраиваем код логирования или мониторинга в наши приложения, называемый инструментированием кода (code instrumentation), чтобы собирать интересующую нас информацию.
Рассмотрение метрик в целом может пролить свет на то, как работают наши системы и насколько они здоровы. Системы мониторинга используют эти данные для создания полного обзора нашего окружения, автоматизации ответов на изменения, такие как ввод в эксплуатацию дополнительных экземпляров EC2, если увеличивается трафик приложений, и для предупреждения людей в случае необходимости. Метрики — это измерения системы, которые позволяют анализировать исторические тенденции, корреляции и изменения в производительности, потреблении ресурсов или частоте ошибок.
Алертинг
Алертинг — это часть системы мониторинга, которая реагирует на изменения значений метрик и предпринимает действия. В определении алерта есть два компонента: условие или порог на основе метрик и действие, которое необходимо выполнить, когда значения выходят за пределы допустимого диапазона.