The Distributed Messaging Queue
Что такое очередь сообщений?
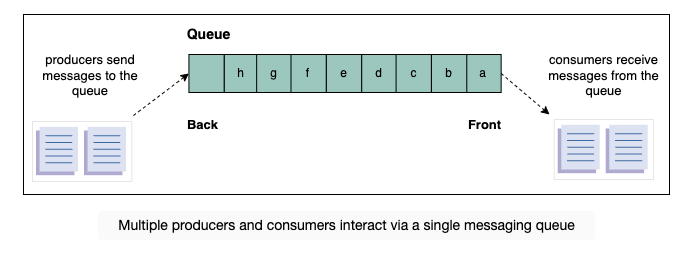
Очередь сообщений — это промежуточный компонент между взаимодействующими сущностями, известными как producers (производители) и consumers (потребители).
- Производитель создает сообщения и помещает их в очередь.
- Потребитель извлекает сообщения из очереди и обрабатывает их.
Взаимодействие с очередью сообщений может происходить одновременно для нескольких производителей и потребителей.
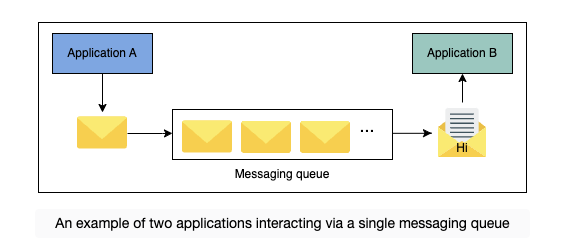
Пример взаимодействия через очередь сообщений
Следующая иллюстрация демонстрирует взаимодействие двух приложений через одну очередь сообщений:
Мотивация
Очередь сообщений обладает рядом преимуществ и имеет множество применений.
Повышенная производительность
Очередь сообщений обеспечивает асинхронное взаимодействие между двумя сущностями, такими как producers (производители) и consumers (потребители), устраняя их разницу в скорости.
- Производитель может отправлять сообщения в очередь без ожидания потребителей.
- Потребитель обрабатывает сообщения по мере их поступления в очередь.
Очереди часто используются для выделения более медленных операций из критического пути, что помогает уменьшить задержку, воспринимаемую клиентом. Например, вместо того чтобы ждать выполнения длительной задачи, процесс-производитель отправляет сообщение, которое помещается в очередь, если запросов несколько, и продолжает свои операции. Потребитель может уведомить о результате обработки, успешном или неудачном, используя другую очередь.
Повышенная надежность
Разделение взаимодействующих сущностей через очередь сообщений делает систему более устойчивой к сбоям. Например, производитель или потребитель могут выйти из строя независимо друг от друга, не влияя на других, и могут быть перезапущены позже. Кроме того, репликация очереди сообщений на нескольких серверах обеспечивает доступность системы, если один или несколько серверов выйдут из строя.
Гранулярная масштабируемость
Асинхронное взаимодействие делает систему более масштабируемой. Например, многие процессы могут взаимодействовать через очередь сообщений. При увеличении числа запросов мы можем распределить нагрузку между несколькими потребителями. Это дает приложению полный контроль над тем, сколько процессов производителей или потребителей запускать в зависимости от текущих потребностей.
Легкая декомпозиция
Очередь сообщений декомпозирует зависимости между различными сущностями в системе. Взаимодействующие сущности общаются через сообщения и не знают о внутреннем механизме работы друг друга.
Ограничение скорости
Очереди сообщений также помогают смягчить всплески нагрузки и предотвратить перегрузку сервисов, выполняя простую форму ограничения скорости и помогая избежать потери входящих запросов.
Приоритетная очередь
Множественные очереди можно использовать для реализации различных приоритетов — например, одна очередь для каждого уровня приоритета, где большее количество ресурсов будет выделяться очереди с более высоким приоритетом.
Примеры использования очереди сообщений
Очередь сообщений имеет много вариантов использования как в односерверной, так и в распределенной среде. Например, она может использоваться для межпроцессного взаимодействия в одной операционной системе. Она также обеспечивает связь между процессами в распределенной среде. Некоторые примеры использования очереди сообщений:
-
Отправка множества писем: Электронные письма используются для различных целей, таких как обмен информацией, проверка аккаунта, сброс пароля, маркетинговые кампании и многое другое. Все эти письма не требуют немедленной обработки и, следовательно, не нарушают основную функциональность системы. Очередь сообщений может помочь координировать большое количество писем между различными отправителями и получателями.
-
Постобработка данных: Многие мультимедийные приложения нуждаются в обработке контента для различных типов устройств, например для мобильных телефонов и смарт-телевизоров. Часто приложения загружают контент в хранилище и используют очередь сообщений для постобработки контента в автономном режиме. Это существенно снижает задержку, воспринимаемую клиентом, и позволяет планировать выполнение оффлайн-работы в подходящее время, например, поздно ночью, когда вычислительные мощности менее загружены.
-
Рекомендательные системы: Некоторые платформы используют рекомендательные системы для предоставления пользователю предпочтительного контента или информации. Рекомендательная система берет исторические данные пользователя, обрабатывает их и предсказывает релевантный контент или информацию. Поскольку это трудоемкая задача, очередь сообщений может быть внедрена между рекомендательной системой и процессами, запрашивающими данные, чтобы увеличить производительность.
Как спроектировать распределенную очередь сообщений?
Проектирование распределенной очереди сообщений разделено на следующие пять уроков:
-
Требования: Здесь мы фокусируемся на функциональных и нефункциональных требованиях к проектированию распределенной очереди сообщений. В этом уроке мы также обсуждаем односерверную очередь сообщений и ее недостатки.
-
Соображения по дизайну: В этом уроке рассматриваются важные факторы, которые могут повлиять на проектирование распределенной очереди сообщений, например, порядок размещения сообщений в очереди, их извлечение, видимость сообщений в очереди и параллельность обработки входящих сообщений.
-
Проектирование: В этом уроке мы детально обсуждаем проектирование распределенной очереди сообщений. Мы также описываем процесс репликации очередей и взаимодействие между различными компонентами, участвующими в дизайне.
-
Оценка: В этом уроке мы оцениваем проектирование распределенной очереди сообщений на основе функциональных и нефункциональных требований.
-
Тестирование: В конце главы мы оцениваем понимание проектирования распределенной очереди сообщений с помощью теста.
Давайте начнем с понимания требований к проектированию распределенной очереди сообщений.
Requirements of a Distributed Messaging Queue’s Design
В распределенной очереди сообщений данные хранятся на нескольких машинах. Наша цель — спроектировать распределенную очередь сообщений, которая будет соответствовать следующим функциональным и нефункциональным требованиям.
Функциональные требования
Перечисленные ниже действия должны быть доступны клиенту:
-
Создание очереди: Клиент должен иметь возможность создавать очередь и задавать такие параметры, как имя очереди, размер очереди и максимальный размер сообщения.
-
Отправка сообщения: Производители должны иметь возможность отправлять сообщения в соответствующую очередь.
-
Получение сообщения: Потребители должны иметь возможность получать сообщения из своих очередей.
-
Удаление сообщения: Потребители должны иметь возможность удалять сообщение из очереди после успешной обработки.
-
Удаление очереди: Клиенты должны иметь возможность удалять конкретную очередь.
Нефункциональные требования
Дизайн распределенной очереди сообщений должен соответствовать следующим нефункциональным требованиям:
-
Надежность: Данные, полученные системой, должны быть надежными и не должны теряться. Производители и потребители могут выходить из строя независимо друг от друга, и очередь с надежным хранением данных является критически важной для работы всей системы, поскольку другие сущности зависят от очереди.
-
Масштабируемость: Система должна быть масштабируемой и способной справляться с увеличивающейся нагрузкой, количеством очередей, производителей, потребителей и сообщений. Аналогично, при снижении нагрузки система должна уметь автоматически сокращать использованные ресурсы.
-
Доступность: Система должна быть высокодоступной для приема и отправки сообщений. Она должна продолжать работу даже после сбоя одного или нескольких компонентов.
-
Производительность: Система должна обеспечивать высокую пропускную способность и низкую задержку.
Односерверная очередь сообщений
Прежде чем приступить к проектированию распределенной очереди сообщений, напомним, как очереди используются в пределах одного сервера, где процессы производителя и потребителя также находятся на одном узле. Производитель или потребитель могут получить доступ к односерверной очереди, используя механизм блокировки для предотвращения несогласованности данных. Очередь рассматривается как критическая секция, к которой в один момент времени может иметь доступ только одна сущность — либо производитель, либо потребитель.
Однако несколько факторов ограничивают использование односерверной очереди сообщений в современных распределенных системах:
- Она становится недоступной для взаимодействующих процессов (производителей и потребителей) в случае аппаратных или сетевых сбоев.
- Производительность сильно страдает из-за увеличивающегося количества блокировок.
- Она не является ни масштабируемой, ни надежной.
Can we extend the design of a single-server messaging queue to a distributed messaging queue?
Details
A single-server messaging queue has the following drawbacks:
-
High latency: As in the case of a single-server messaging queue, a producer or consumer acquires a lock to access the queue. Therefore, this mechanism becomes a bottleneck when many processes try to access the queue. This increases the latency of the service.
-
Low availability: Due to the lack of replication of the messaging queue, the producer and consumer process might be unable to access the queue in events of failure. This reduces the system’s availability and reliability.
-
Lack of durability: Due to the absence of replication, the data in the queue might be lost in the event of a system failure.
-
Scalability: A single-server messaging queue can handle a limited number of messages, producers, and consumers. Therefore, it is not scalable.
To extend the design of a single-server messaging queue to a distributed messaging queue, we need to make extensive efforts to eliminate the drawbacks outlined above.
Building blocks we will use
The design of a distributed messaging queue utilizes the following building blocks:
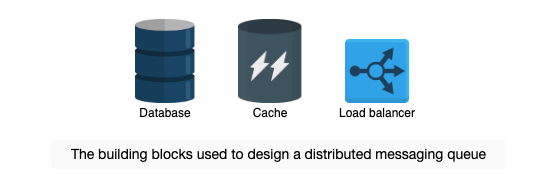
Database(s) will be required to store the metadata of queues and users.
Caches are important to keep frequently accessed data, whether it be data pertaining to users or queues metadata.
Load balancers are used to direct incoming requests to servers where the metadata is stored.
In our discussion on messaging queues, we focused on their functional and non-functional requirements. Before moving on to the process of designing a distributed messaging queue, it’s essential for us to discuss some key considerations and challenges that may affect the design.
Considerations of a Distributed Messaging Queue’s Design
Факторы, влияющие на проектирование
Прежде чем приступить к проектированию распределенной очереди сообщений, давайте обсудим несколько ключевых факторов, которые могут существенно повлиять на дизайн. Эти факторы включают порядок сообщений, влияние упорядочивания на производительность и управление конкурентным доступом к очереди. Рассмотрим каждый из этих факторов подробнее.
Упорядочивание сообщений
Очередь сообщений используется для получения сообщений от производителей. Эти сообщения обрабатываются потребителями с различной скоростью. Некоторые операции критически важны и требуют строгого соблюдения порядка выполнения задач, определяемого сообщениями в очереди.
Например, при общении с другом через мессенджер сообщения должны доставляться в правильном порядке, иначе такое общение может вызвать путаницу. С другой стороны, электронные письма, получаемые пользователем от разных отправителей, могут не требовать строгого порядка. Таким образом, в некоторых случаях строгий порядок поступающих сообщений в очереди является необходимым, в то время как во многих других случаях допускается определенная степень нарушения порядка.
Категории упорядочивания сообщений
Рассмотрим две основные категории упорядочивания сообщений в очереди:
- Best-effort упорядочивание
- Строгое упорядочивание
В очереди порядок сообщений неявно связан с поступающими сообщениями. После помещения сообщений в очередь их обработка и выполнение следуют тому же порядку.
Упорядочивание сообщений при параллельной работе
Для нескольких производителей, отправляющих сообщения в одну и ту же очередь, порядок не будет четко определен, пока производители не укажут информацию о порядке — например, метки времени или номера последовательности. Без такой информации очередь помещает сообщения в том порядке, в котором они поступили в сервис.
Для нескольких потребителей, извлекающих сообщения из одной и той же очереди, упорядочивание также может стать сложной задачей. Хотя очередь может передавать сообщения одно за другим в том порядке, в котором они были вставлены, два потребителя, почти одновременно обрабатывающие два сообщения, могут нуждаться в механизме упорядочивания, специфичном для приложения. Очередь может помочь, присваивая сообщениям информацию о порядке, например, номера последовательности или метки времени, при их выдаче из очереди.
Best-effort упорядочивание
С подходом Best-effort упорядочивания система помещает сообщения в указанную очередь в том порядке, в котором они были получены.
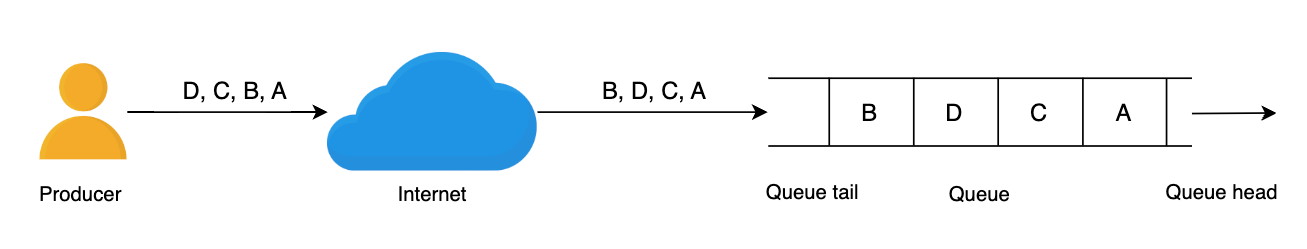
Например, как показано на следующем рисунке, производитель отправляет четыре сообщения: A, B, C и D в указанном порядке. Однако из-за сетевой задержки или другой проблемы сообщение B было получено после сообщения D. Следовательно, порядок сообщений на стороне получения будет A, C, D и B. Таким образом, в этом подходе сообщения помещаются в очередь в том порядке, в котором они были получены, а не в том порядке, в котором они были сгенерированы на стороне клиента.
Факторы, влияющие на проектирование
Прежде чем приступить к проектированию распределенной очереди сообщений, давайте обсудим несколько ключевых факторов, которые могут существенно повлиять на дизайн. Эти факторы включают порядок сообщений, влияние упорядочивания на производительность и управление конкурентным доступом к очереди. Рассмотрим каждый из этих факторов подробнее.
Who’ll be responsible for providing the sequence numbers?
Details
The system provides essential libraries or APIs to the client to give sequence numbers to the messages produced at the client side.
Строгое упорядочивание
Техника строгого упорядочивания обеспечивает более точное сохранение порядка сообщений. В этом подходе сообщения размещаются в очереди в том порядке, в котором они были сгенерированы.
Идентификация порядка сообщений
Перед тем как разместить сообщения в очереди в правильной последовательности, необходимо внедрить механизм для определения порядка, в котором сообщения были сгенерированы на стороне клиента. Для этого часто используется уникальный идентификатор или метка времени.
Три подхода к упорядочиванию входящих сообщений
-
Монотонно возрастающие номера: Один из способов упорядочивания входящих сообщений — присвоение им монотонно возрастающих номеров на стороне сервера. Например, первому сообщению система присваивает номер 1, второму — номер 2, и так далее.
Недостатки:
- Во-первых, при поступлении большого количества запросов эта система может стать узким местом и повлиять на производительность, так как сообщения вынуждены ждать своей очереди для получения ID.
- Во-вторых, этот подход не решает проблему, когда сообщение, сгенерированное раньше, поступает на сервер позже. Это означает, что такой метод не гарантирует правильного порядка для сообщений, сгенерированных на стороне клиента.
-
Сортировка на основе причинности на стороне сервера: Учитывая недостатки монотонно возрастающих номеров, можно использовать подход сортировки на основе причинности. В этом подходе сообщения сортируются на основе метки времени, присвоенной на стороне клиента, и помещаются в очередь соответственно.
Недостаток:
- Основной недостаток этого подхода заключается в том, что для нескольких клиентских сессий сервис не может определить порядок сообщений в терминах глобального времени (например, времени на стенных часах).
-
Использование меток времени на основе синхронизированных часов: Чтобы решить проблемы, возникающие в двух предыдущих подходах, можно использовать метод присвоения меток времени на основе синхронизированных часов. В этом подходе метка времени (ID), присвоенная каждому сообщению через синхронизированные часы, уникальна и соответствует правильной последовательности создания сообщений.
- Мы можем добавить уникальный идентификатор процесса к метке времени, чтобы сделать общий идентификатор сообщения уникальным и предотвратить ситуацию, когда две параллельные сессии запрашивают метку времени одновременно.
- Кроме того, этот подход позволяет серверу легко определить задержанные сообщения на основе метки времени и дождаться их получения.
Как мы обсуждали в разделе о блоке создания последовательностей, мы можем использовать номера последовательностей, которые выполняют двойную функцию: как номера последовательностей, так и глобально синхронизированные метки времени. Этот подход позволяет нашему сервису глобально упорядочивать сообщения даже среди разных клиентских сессий.
Вывод
Самый подходящий механизм для присвоения уникальных ID или меток времени входящим сообщениям среди трех описанных выше подходов — это использование синхронизированных часов.
Сортировка
После получения сообщений на стороне сервера их необходимо отсортировать по меткам времени. Для этого используется подходящий алгоритм онлайн-сортировки.
Suppose that a message sent earlier arrives late due to a network delay. What would be the proper approach to handle such a situation?
Details
The simple solution in such cases is to reorder the queue. Two scenarios can arise from this. First, reordering puts the messages in the correct order. Second, we’ve already handed out newer messages to the consumers.
If an old message comes when we’ve already handed out a newer message, we put it in a special queue, and the client handles that situation. The client may later decide whether to consume the message if the message does not affect the intended operation or discard it if it’s not needed.
Влияние на производительность
Очередь сообщений изначально проектируется для операций типа first-in, first-out (FIFO), что подразумевает, что первое сообщение, поступившее в очередь, должно быть выдано первым. Однако поддержание строгого порядка в распределенных системах является сложной задачей. Даже если сообщение A было сгенерировано раньше сообщения B, нет уверенности, что сообщение A будет обработано раньше сообщения B.
Мониторинг и упорядочивание
Использование монотонно возрастающих идентификаторов сообщений или идентификаторов, несущих причинно-следственные связи, обеспечивает высокую пропускную способность при размещении сообщений в очереди. Тем не менее, необходимость онлайн-сортировки для строгого соблюдения порядка требует времени, прежде чем сообщения будут готовы для извлечения. Чтобы минимизировать задержку, вызванную онлайн-сортировкой, используется подход с временным окном.
Последовательность при выдаче сообщений
Для обеспечения строгого порядка на стороне потребителя требуется сериализация всех запросов, чтобы выдавать сообщения по одному. Если строгая последовательность не является обязательной, это позволяет достичь более высокой пропускной способности и снизить задержку на стороне потребителя.
Ограничения производительности
Из-за вышеупомянутых причин многие решения для распределенных очередей сообщений либо не гарантируют строгого порядка, либо ограничивают пропускную способность. Как было показано ранее, очереди вынуждены выполнять множество дополнительных проверок и операций координации для поддержания порядка, что снижает общую производительность.
Управление параллелизмом
Правильное управление параллельным доступом к очереди является важным аспектом проектирования.
Параллелизм может возникать на следующих этапах:
- Когда несколько сообщений поступают одновременно.
- Когда несколько потребителей одновременно запрашивают сообщение.
Решения для управления параллелизмом
-
Механизм блокировок: Первое решение — использовать механизм блокировок. Когда процесс или поток запрашивает сообщение, он должен захватить блокировку для размещения или извлечения сообщений из очереди. Однако, как обсуждалось ранее, этот подход имеет несколько недостатков — он не масштабируем и не обеспечивает высокой производительности.
-
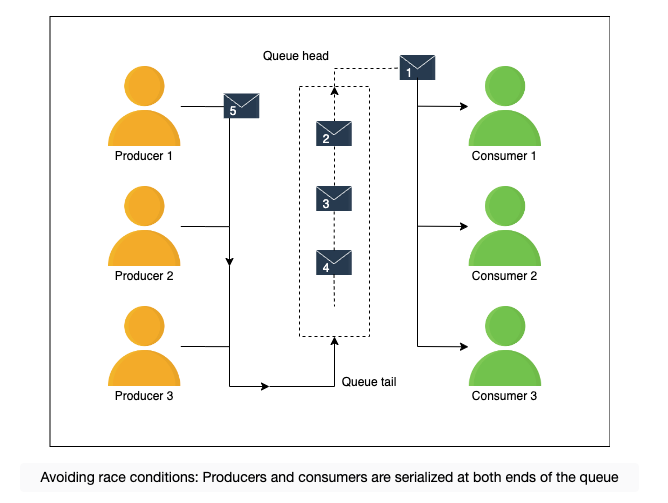
Сериализация запросов: Другое решение — сериализация запросов с использованием буфера системы на обоих концах очереди, чтобы входящие сообщения размещались в определенном порядке, а процессы-потребители также получали сообщения в последовательности их поступления. Под сериализацией запросов подразумевается, что запросы (как на вставку данных, так и на их извлечение), поступающие на сервер, будут помещаться в очередь ОС, и один поток приложения будет размещать их в очереди без использования блокировок. Это возможно обеспечить решение без блокировок, обеспечивающее высокую пропускную способность. Этот подход позволяет избежать состояния гонки.
Использование нескольких очередей
Приложения могут использовать несколько очередей с выделенными производителями и потребителями, чтобы контролировать затраты на упорядочивание в каждой очереди, хотя это и усложняет логику приложения.
- Why is the order of messages important, and how do we enforce that order?
- How does ordering affect performance? How do we handle concurrency while accessing a queue?
Design of a Distributed Messaging Queue: Part 1
Распределенная очередь сообщений
В отличие от односерверной очереди сообщений, распределенная очередь сообщений размещается на нескольких серверах. Распределенная очередь сообщений имеет свои собственные вызовы, но при правильном проектировании устраняет недостатки односерверной очереди сообщений.
В следующих разделах мы сосредоточимся на проблемах масштабируемости, доступности и надежности при проектировании распределенной очереди сообщений, познакомившись с более отказоустойчивой архитектурой очереди сообщений.
Высокоуровневый дизайн
Прежде чем углубляться в дизайн, примем следующие допущения, чтобы сделать обсуждение более простым и понятным. В дальнейшем материале мы обсудим, как эти допущения позволяют устранить проблемы, присущие односерверному решению для очереди сообщений.
-
Репликация данных очереди:
- Данные очереди реплицируются с использованием системы primary-secondary или системы, похожей на quorum внутри кластера (подробнее о репликации данных см. в соответствующем уроке).
- Если очередь становится слишком длинной для хранения на одном сервере, наша служба может использовать разделение данных (Data Partitioning). Для этого можно использовать схему, похожую на консистентное хеширование, или хранилище типа key-value, где ключом могут быть номера последовательности сообщений. В этом случае каждый шард соответствующим образом реплицируется (подробности см. в уроке о разделении данных).
-
Автоматическое масштабирование ресурсов:
- Мы также предполагаем, что наша система может автоматически расширять и сокращать ресурсы в зависимости от потребностей для оптимального использования ресурсов.
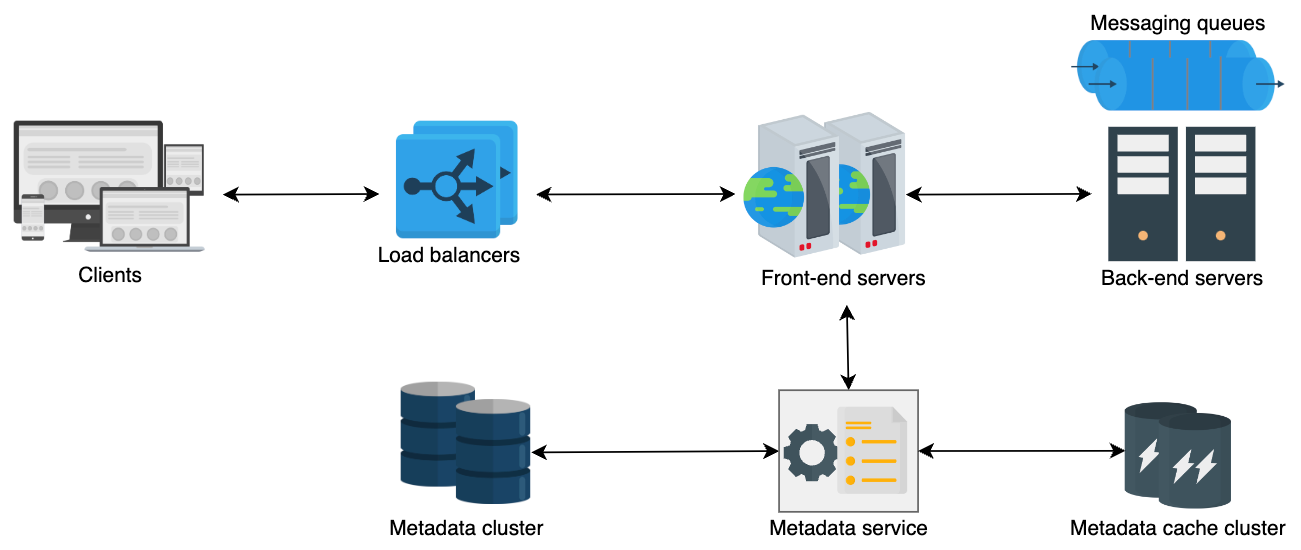
Следующая иллюстрация демонстрирует высокоуровневый дизайн распределенной очереди сообщений, состоящей из нескольких компонентов.
Основные компоненты нашего дизайна
Ниже подробно описаны основные компоненты нашего дизайна распределенной очереди сообщений.
Балансировщик нагрузки
Балансировщик нагрузки принимает запросы от производителей и потребителей, которые затем перенаправляются на один из серверов фронт-энда. Этот слой состоит из множества балансировщиков нагрузки, что позволяет обрабатывать запросы с минимальной задержкой и обеспечивать высокую доступность.
Фронт-энд сервис
Фронт-энд сервис включает в себя бессостоячные машины, распределенные по дата-центрам. Фронт-энд выполняет следующие функции:
-
Валидация запросов:
- Проверяет корректность запроса и наличие всей необходимой информации.
-
Аутентификация и авторизация:
- Проверяет, является ли запрашивающий пользователь действительным и авторизован ли он на использование этих сервисов.
-
Кэширование:
- В кэше фронт-энда хранится метаданные, связанные с часто используемыми очередями. Также здесь кэшируются данные пользователя, что сокращает время обработки запросов на аутентификацию и авторизацию.
-
Маршрутизация запросов:
- Фронт-энд также отвечает за вызов двух других сервисов — бэк-энда и хранилища метаданных. Разграничение вызовов этих сервисов является одной из задач фронт-энда.
-
Исключение дублирующих запросов:
- Фронт-энд отслеживает информацию, связанную со всеми запросами, и предотвращает повторное добавление одинаковых запросов в очередь. Определение дубликатов может заключаться в поиске ключа хеша в хранилище. Если что-то найдено в хранилище, это означает дубликат, и сообщение может быть отклонено.
-
Сбор данных об использовании:
- Сбор данных в реальном времени, которые могут использоваться для целей аудита.
Сервис метаданных
Сервис метаданных отвечает за хранение, извлечение и обновление метаданных очередей в хранилище метаданных и кэше. Когда очередь создается или удаляется, хранилище метаданных и кэш обновляются соответствующим образом. Сервис метаданных работает как промежуточный слой между серверами фронт-энда и уровнем данных. Поскольку метаданные очередей хранятся в кэше, фронт-энд сервера сначала проверяют кэш на наличие соответствующей информации, связанной с получением запроса. Если происходит промах кэша, информация извлекается из хранилища метаданных, и кэш обновляется.
Организация кластеров кэша метаданных
Существует два подхода к организации кластеров кэша метаданных:
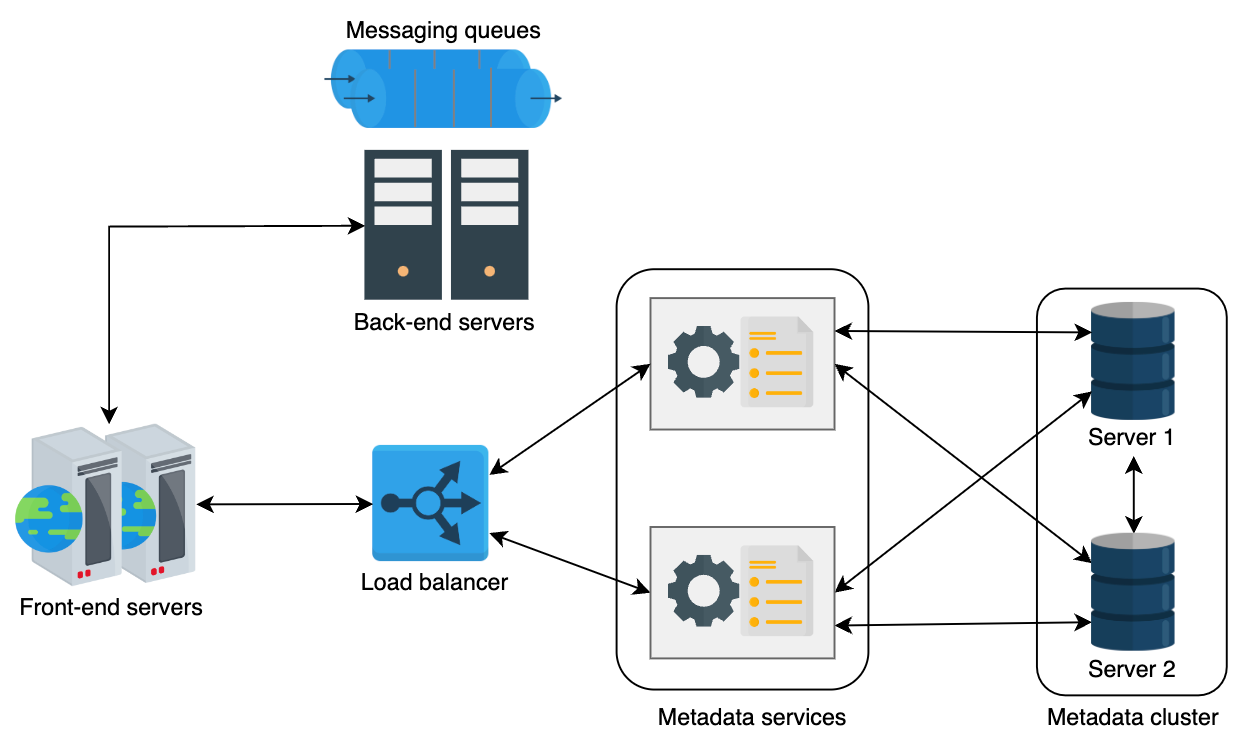
- Маленький объем метаданных:
- Если объем метаданных, которые нужно хранить, мал и может уместиться на одной машине, то эти данные реплицируются на каждом сервере кластера. В этом случае запрос может быть обслужен любым случайным сервером. В этом подходе можно также использовать балансировщик нагрузки между серверами фронт-энда и сервисами метаданных.
- Управление большими объемами метаданных
Если объем метаданных слишком велик для хранения на одной машине, можно использовать один из следующих подходов:
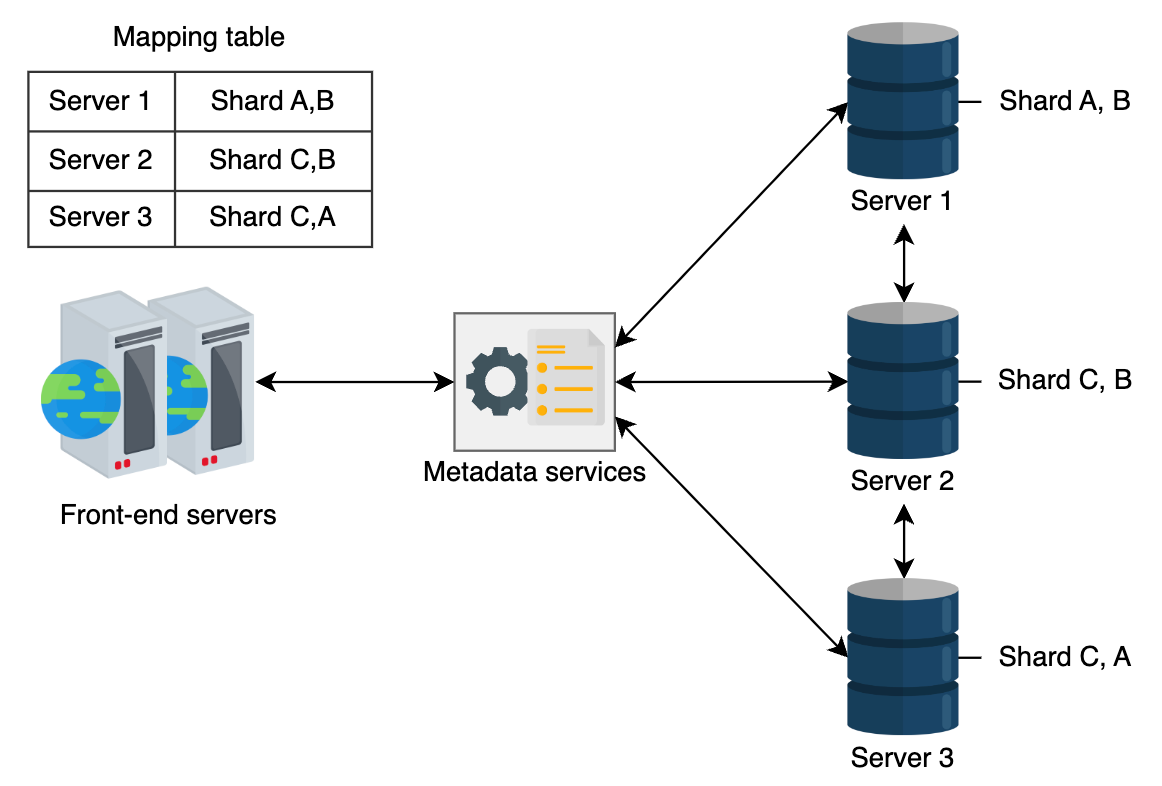
Первый подход: Шардирование
-
Шардирование: Данные делятся на различные шарды, что позволяет распределить их по разным хостам в кластере. Шардирование можно выполнить на основе ключа разделения или техник хеширования, как это обсуждалось в уроке по разделению данных в базе данных.
-
Хранение шардов: Каждый шард хранится на отдельном хосте в кластере. Для повышения доступности каждый шард также реплицируется на других хостах.
-
Маппинг шардов: В этом подходе сервер фронт-энда имеет таблицу соответствия между шардами и хостами, на которых они хранятся. Таким образом, сервер фронт-энда отвечает за перенаправление запросов на соответствующий хост, где хранятся данные.
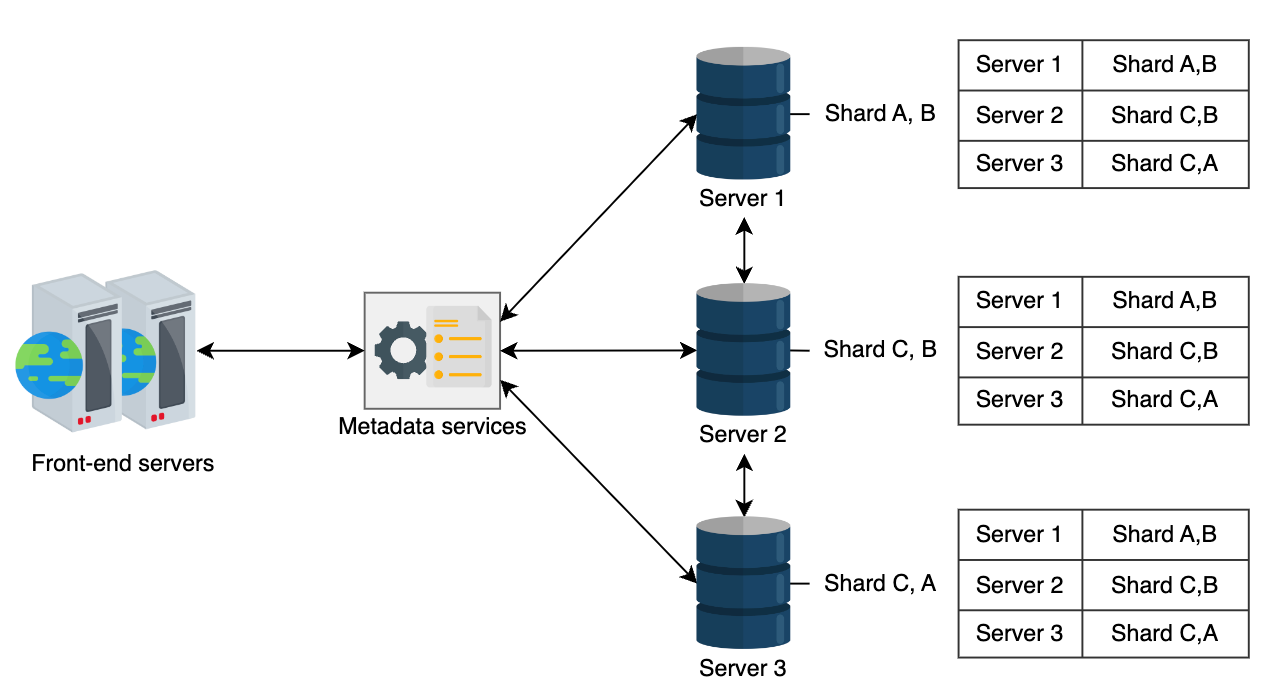
Второй подход: Децентрализованное хранение таблицы маппинга
-
Децентрализованное хранение: Этот подход аналогичен первому, однако таблица маппинга в этом случае хранится на каждом хосте, а не только на серверах фронт-энда. Благодаря этому любой случайный хост может принять запрос и перенаправить его на хост, где находятся данные.
-
Подходит для приложений с интенсивным чтением: Этот метод особенно полезен для приложений, в которых операции чтения преобладают над операциями записи.
Обзор обсужденного дизайна
В нашем обсуждении распределенных очередей сообщений мы сосредоточились на высокоуровневом дизайне этой системы. Кроме того, мы рассмотрели каждый компонент в высокоуровневом дизайне, включая:
- Сервера фронт-энда и их роль в обеспечении бесперебойной работы.
- Балансировщики нагрузки.
- Сервисы метаданных.
- Кластеры метаданных и их организацию.
Важной частью дизайна является организация серверов на уровне бэк-энда для операций создания и удаления очередей, а также других операций, связанных с доставкой и извлечением сообщений. Следующий урок сосредоточен на организации серверов бэк-энда и управлении очередями, наряду с другими важными операциями, связанными с обработкой сообщений.
Design of a Distributed Messaging Queue: Part 2
Бэк-энд сервис
Бэк-энд сервис — это центральная часть архитектуры, где выполняются основные операции. Когда фронт-энд получает сообщение, он обращается к сервису метаданных, чтобы определить, на какой хост нужно отправить сообщение. Затем сообщение пересылается на соответствующий хост и реплицируется на другие хосты для обеспечения высокой доступности. Репликация сообщений в кластере на разных хостах может выполняться с использованием одной из двух моделей:
- Модель первичный-вторичный (Primary-secondary)
- Кластер независимых хостов
Прежде чем углубляться в детали этих моделей, давайте обсудим два типа менеджеров кластера, отвечающих за управление очередями: внутренний и внешний менеджеры кластера. Различия между этими двумя менеджерами представлены в следующей таблице.
Внутренний и внешний менеджеры кластера
| Внутренний менеджер кластера | Внешний менеджер кластера |
|---|---|
| Управляет распределением очередей внутри кластера. | Управляет распределением очередей между кластерами. |
| Имеет информацию о каждом узле внутри кластера. | Знает о каждом кластере, но не о каждом хосте внутри кластера. |
| Слушает "heartbeat" от каждого узла. | Мониторит состояние каждого независимого кластера. |
| Управляет сбоями хостов, добавлением и удалением экземпляров из кластера. | Управляет и использует кластеры. |
| Разделяет очередь на несколько частей, каждая из которых получает основной сервер. | Может разделять очередь между несколькими кластерами, чтобы сообщения для одной очереди равномерно распределялись между несколькими кластерами. |
Модель первичный-вторичный (Primary-secondary)
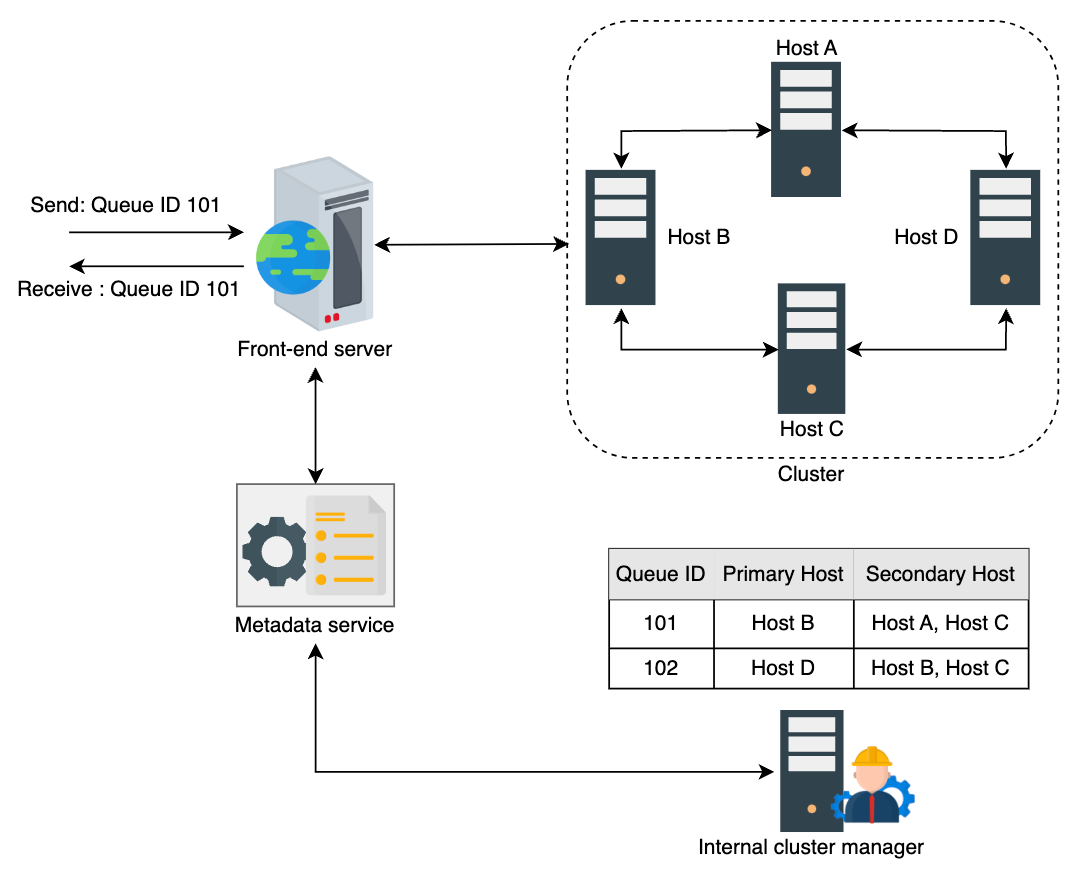
В модели Primary-secondary каждый узел считается основным хостом для определенного набора очередей. Основной хост отвечает за получение запросов для определенной очереди и полностью отвечает за репликацию данных. Запрос поступает на фронт-энд, который, в свою очередь, взаимодействует с сервисом метаданных для определения основного хоста для обработки запроса.
Пример
Допустим, у нас есть две очереди с идентификаторами 101 и 102, размещенные на четырех различных хостах A, B, C и D. В этом примере хост B является основным для очереди 101, а вторичные хосты, на которых реплицируется очередь 101, — это A и C. Когда фронт-энд получает запросы на сообщения, он определяет основной сервер с помощью внутреннего менеджера кластера через сервис метаданных. Сообщение извлекается из основного экземпляра, который также отвечает за удаление оригинального сообщения после его использования и всех его реплик.
Как показано на следующей иллюстрации, внутренний менеджер кластера — это компонент, который отвечает за сопоставление между основным хостом, вторичными хостами и очередями. Кроме того, он также помогает в выборе основного хоста. Поэтому этот компонент должен быть надежным, масштабируемым и производительным.
Кластер независимых хостов
В подходе с кластером независимых хостов у нас есть несколько кластеров, состоящих из нескольких независимых хостов, распределенных по различным дата-центрам. Когда фронт-энд получает сообщение, он определяет соответствующий кластер с помощью сервиса метаданных и внешнего менеджера кластера. Затем сообщение перенаправляется на случайный хост в кластере, который реплицирует сообщение на другие хосты, где хранится очередь.
Основные этапы процесса:
-
Определение кластера:
- Фронт-энд, получив сообщение, обращается к внешнему менеджеру кластера через сервис метаданных, чтобы определить, в каком кластере должна быть обработана данная очередь.
-
Перенаправление сообщения:
- После определения кластера сообщение перенаправляется на случайный хост в этом кластере.
-
Репликация сообщения:
- Получивший сообщение хост отвечает за репликацию этого сообщения на другие хосты в кластере, где хранится очередь. Это повышает доступность и отказоустойчивость системы.
Преимущества подхода
- Гибкость: Такой подход позволяет распределять нагрузку между несколькими кластерами и хостами, улучшая масштабируемость системы.
- Высокая доступность: Репликация сообщений между несколькими хостами внутри кластера обеспечивает высокую доступность данных, даже в случае сбоя одного из хостов.
Этот подход особенно полезен в распределенных системах, где требуется поддерживать высокую доступность и масштабируемость, а также управлять большими объемами данных, распределенными по различным географическим регионам.
How does a random host within a cluster replicate data—that is, messages—in the queues on other hosts within the same cluster?
Details
Each host consists of mapping between the queues and the hosts within a cluster, making the replication easier.
Assume that we have a cluster, say Y, having hosts A, B, and C. This cluster has two queues with IDs 101 and 103 stored on different hosts, as shown in the following table. This table is stored on each host within the cluster Y. When a random host receives a message, say host C, for a queue having ID 103, host C replicates this message on the other hosts where the queue 103 is stored, i.e., Node A and Node B.
Обработка запросов на получение сообщений
Тот же процесс применяется и к запросам на получение сообщений от потребителей. Как и в первом подходе, случайно выбранный хост несет ответственность за доставку сообщения и его очистку после успешной обработки.
Внешний менеджер кластера
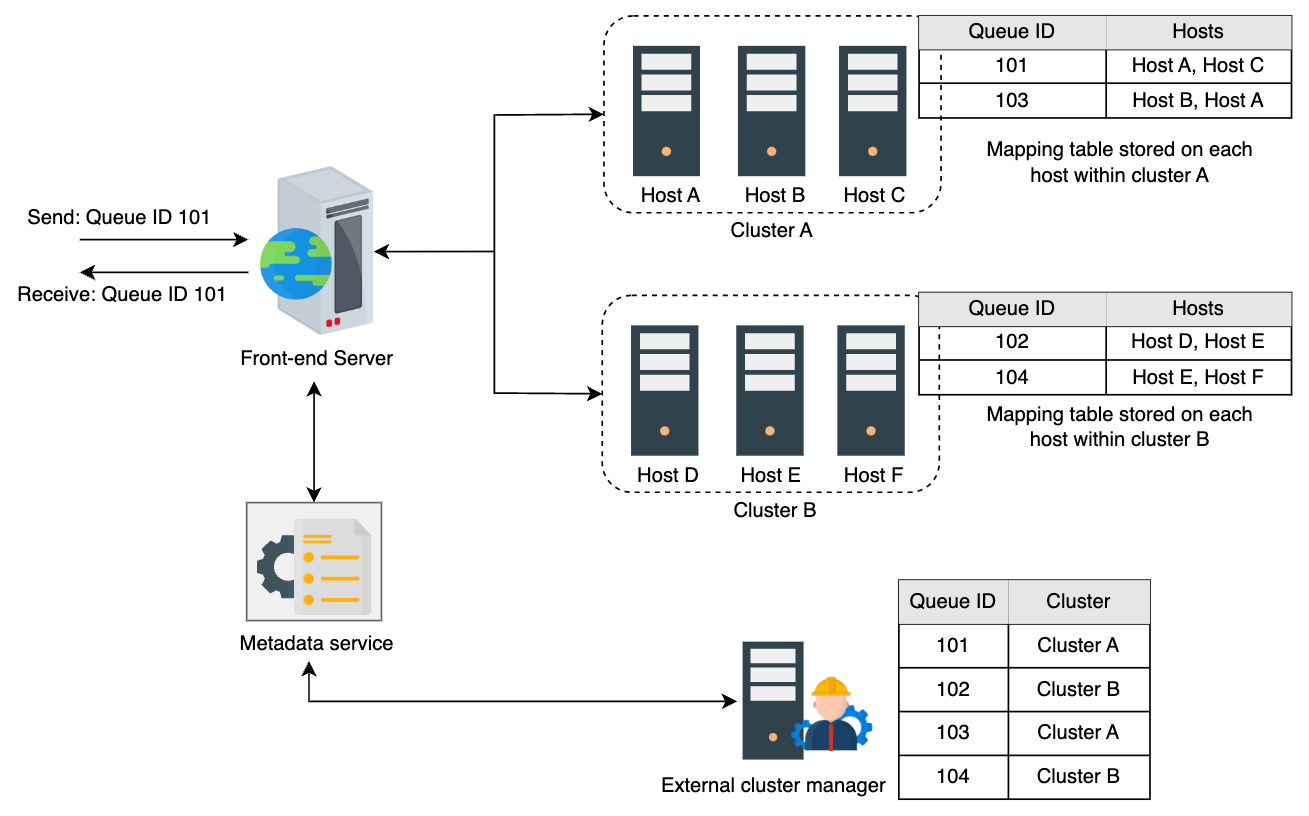
В этом подходе вводится еще один компонент — внешний менеджер кластера, который отвечает за поддержание сопоставления между очередями и кластерами, как показано на следующей схеме. Внешний менеджер кластера также отвечает за управление очередями и назначение кластеров для конкретной очереди.
Иллюстрация кластера независимых хостов
На следующей схеме показаны два кластера — A и B, каждый из которых состоит из нескольких узлов. Внешний менеджер кластера содержит таблицу соответствия между очередями и их кластерами. Когда фронт-энд получает запрос на очередь, он определяет соответствующий кластер для очереди и перенаправляет запрос в кластер, где находится очередь. Узлы внутри этого кластера отвечают за хранение и отправку сообщений.
What kind of anomalies can arise while replicating messages on other hosts?
Details
There are two ways to replicate messages in a queue residing on multiple hosts.
- Synchronous replication
- Asynchronous replication In synchronous replication, the primary host is responsible for replicating the message in all the relevant queues on other hosts. After acknowledgment from secondary hosts, the primary host then notifies the client regarding the reception of messages. In this approach, messages remain consistent in all queues replicas; however, it costs extra delay in communication and causes partial to no availability while an election is in progress to promote a secondary as a primary.
In asynchronous replication, once the primary host receives the messages, it acknowledges the client, and in the next step, it starts replicating the message in other hosts. This approach comes with other problems such as replication lag and consistency issues.
Based on the needs of an application, we can pick one or the other.
Evaluation of a Distributed Messaging Queue’s Design
Анализ соответствия дизайна требованиям
Мы завершили процесс проектирования распределенной очереди сообщений. Теперь давайте проанализируем, насколько наш дизайн соответствует функциональным и нефункциональным требованиям распределенной очереди сообщений.
Функциональные требования
-
Создание и удаление очереди:
- Когда фронт-энд получает запрос на создание очереди, она создается с учетом всех необходимых деталей, предоставленных клиентом, после прохождения важных проверок. Менеджер кластера назначает серверы для новой очереди и обновляет информацию в хранилищах метаданных и кэшах через сервис метаданных.
- Аналогично, очередь удаляется, когда клиент больше не нуждается в ней. Ответственный менеджер кластера освобождает пространство, занимаемое очередью, и, соответственно, удаляет данные из всех хранилищ метаданных и кэшей.
-
Отправка и получение сообщений:
- Производители могут отправлять сообщения в определенные очереди после их создания. На бэк-энде входящие сообщения сортируются по меткам времени для сохранения их порядка и помещаются в очередь.
- Потребители могут извлекать сообщения из указанной очереди. Когда сообщение поступает от производителя для определенной очереди, фронт-энд определяет основной хост или кластер (в зависимости от модели репликации), где находится очередь, и перенаправляет запрос на соответствующий узел для размещения в очереди.
-
Удаление сообщения:
- Первый вариант — не удалять сообщение после его обработки. В этом случае потребитель должен отслеживать, что было обработано. Для этого необходимо сохранять порядок сообщений в очереди и отслеживать каждое сообщение в ней. Сообщение может быть удалено после истечения срока хранения.
- Второй вариант — сделать сообщение невидимым на определенное время с помощью атрибута, например,
visibility_timeout, после чего оно будет удалено потребителем через вызов API. - В обоих случаях сообщение удаляется только потребителем. Это обеспечивает высокую надежность, если потребитель не смог обработать сообщение из-за сбоя, и позволяет повторно получить сообщение при восстановлении работы.
How do we handle messages that can’t be processed—here meaning consumed—after maximum processing attempts by the consumer?
Details
A special type of queue, called a dead-letter queue, can be provided to handle messages that aren’t consumed after the maximum number of processing attempts have been made by the consumer. This type of queue is also used for keeping messages that can’t be processed successfully due to the following factors:
- The messages intended for a queue that doesn’t exist anymore.
- The queue length limit is exceeded, although this would rarely occur with our current design.
- The message expires due to per-message time to live (TTL). A dead-letter queue is also important for determining the cause of failure and for identifying faults in the system.
Нефункциональные требования
-
Надежность:
- Для достижения надежности метаданные очередей реплицируются на разных узлах. Аналогично, при получении сообщения оно реплицируется в очередях, которые находятся на разных узлах. Таким образом, при сбое одного узла другие узлы могут использоваться для доставки или получения сообщений.
-
Масштабируемость:
- Наши компоненты, такие как сервера фронт-энда, сервера метаданных, кэши, кластеры бэк-энда и другие, масштабируются по горизонтали. Мы можем добавлять или уменьшать их емкость в соответствии с нашими потребностями. Масштабируемость можно разделить на два измерения:
- Увеличение количества сообщений: При достижении определенного предела сообщений, например, 80%, указанная очередь расширяется. Аналогично, очередь сокращается, когда количество сообщений падает ниже определенного порога.
- Увеличение количества очередей: С ростом количества очередей увеличивается потребность в дополнительных серверах, за что отвечает менеджер кластера. Новые узлы вводятся в эксплуатацию, чтобы обеспечить изоляцию производительности между различными очередями.
- Наши компоненты, такие как сервера фронт-энда, сервера метаданных, кэши, кластеры бэк-энда и другие, масштабируются по горизонтали. Мы можем добавлять или уменьшать их емкость в соответствии с нашими потребностями. Масштабируемость можно разделить на два измерения:
-
Доступность:
- Наши компоненты данных — метаданные и сами сообщения — правильно реплицируются внутри или за пределами дата-центра, а балансировщик нагрузки распределяет трафик мимо вышедших из строя узлов. Эти механизмы обеспечивают доступность системы при сбоях.
-
Производительность:
- Для повышения производительности мы используем кэши, репликацию данных и разделение данных, что сокращает время чтения и записи данных. Также стратегия
best effortдля упорядочивания сообщений используется для увеличения пропускной способности и снижения задержки, когда это необходимо. В случае строгого упорядочивания мы предлагаем сортировку на основе временного окна для потенциального снижения задержки.
- Для повышения производительности мы используем кэши, репликацию данных и разделение данных, что сокращает время чтения и записи данных. Также стратегия
What happens when the visibility timeout of a specific message expires and the consumer is still busy processing the message?
Details
The message becomes visible, and another worker can receive the message, thereby duplicating the processing. To avoid such a situation, we ensure that the application sets a safe threshold for visibility timeout.
Заключение
Мы рассмотрели множество тонкостей при проектировании очереди FIFO в распределенной среде. Выяснилось, что существует компромисс между строгим упорядочиванием сообщений и достижимыми показателями пропускной способности и задержки. Ослабление требований к порядку дает нам более высокую пропускную способность и меньшую задержку. Требование строгого упорядочивания вынуждает систему выполнять дополнительные операции для обеспечения упорядочивания по времени или причинно-следственной связи. Мы используем разные хранилища данных с соответствующей репликацией и разделением для масштабирования данных. Этот процесс проектирования подчеркивает, что концепция очереди producer-consumer, которая легко реализуется в однопользовательской системе, становится намного сложнее в распределенной среде.
Describe how a distributed messaging queue would be used in an online multiplayer game to manage real-time player actions (movement, attacks, etc.). What are the crucial requirements for this scenario?
Details
Distributed messaging queues play a crucial role in enabling real-time gameplay for online multiplayer games by handling player actions like movement and attacks. They work by collecting these actions as messages, buffering them, and then distributing these messages to the relevant game servers or clients. These servers or clients then process the messages, often in a first-in, first-out (FIFO) manner, to update the game state accordingly.
For such a system to be effective in an online gaming context, it must meet several crucial requirements. These include low latency to ensure real-time responsiveness, potentially relaxed ordering to accommodate the fast-paced nature of games, high availability to support continuous gameplay, and the ability to handle bursts of messages during peak usage times to maintain performance. Additionally, reliability is key to ensure that all player actions are accurately captured and processed without loss.
In the context of online multiplayer games, messaging queues help by decoupling system components for improved resilience, synchronizing data across gaming servers for consistency, and maintaining order to ensure that actions occur in the correct sequence.