The Rate Limiter
Что такое ограничитель скорости (Rate Limiter)?
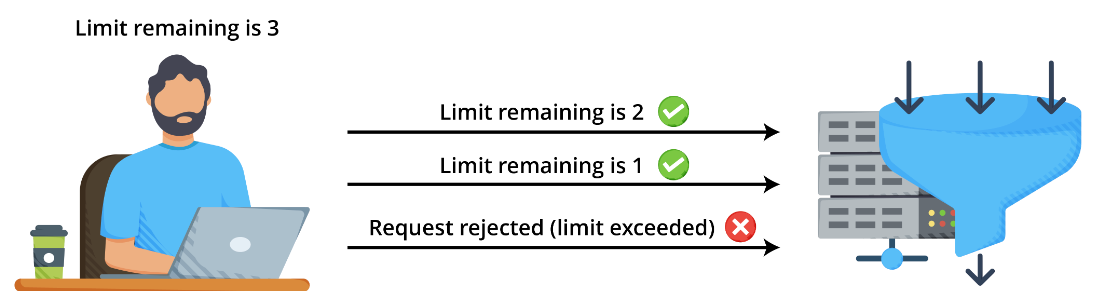
Ограничитель скорости — это механизм, который ограничивает количество запросов, которые сервис может обработать за определенный промежуток времени. Он блокирует запросы, превышающие заранее установленный лимит. Например, если клиент использует API сервиса, настроенного на 500 запросов в минуту, ограничитель скорости будет блокировать дальнейшие запросы от этого клиента, если количество его запросов превысит этот лимит.
Зачем нужен ограничитель скорости?
Ограничитель скорости используется как защитный слой для сервисов, чтобы предотвратить их чрезмерное использование, как преднамеренное, так и случайное. Он также защищает сервисы от вредоносных действий, нацеленных на прикладной уровень, таких как атаки типа отказ в обслуживании (DoS) и попытки взлома паролей методом перебора.
Ниже приведены сценарии, в которых ограничители скорости могут быть использованы для повышения надежности сервиса:
Предотвращение истощения ресурсов
Некоторые инциденты отказа в обслуживании вызваны ошибками в программном обеспечении или конфигурациях системы, что приводит к истощению ресурсов. Такие атаки называются дружественным огнем (friendly-fire) отказа в обслуживании. Одним из распространенных случаев использования ограничителей скорости является предотвращение истощения ресурсов, вызванного такими атаками, будь то преднамеренные или случайные.
Управление политиками и квотами
Ограничители скорости также необходимы для обеспечения справедливого и разумного использования ресурсов, когда они делятся между многими пользователями. Политика здесь относится к применению ограничений на время или количество выделенных ресурсов (квота).
Контроль потока данных
Ограничители скорости могут быть использованы в системах, где требуется обработка большого объема данных. Они контролируют поток данных, чтобы равномерно распределить нагрузку между различными машинами, избегая перегрузки одной машины.
Избежание избыточных расходов
Ограничение скорости также может быть использовано для контроля за расходами на операции. Например, организации могут использовать ограничение скорости, чтобы предотвратить неконтролируемые эксперименты и избежать крупных счетов. Некоторые облачные сервисы также применяют этот концепт, предлагая бесплатные услуги с определенными лимитами, которые могут быть увеличены за дополнительную плату.
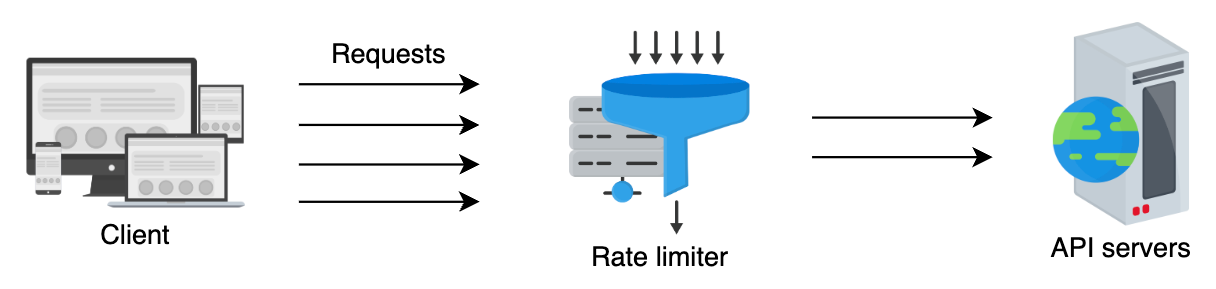
Как спроектировать ограничитель скорости?
В следующих уроках мы рассмотрим следующее:
Требования
Здесь мы обсудим функциональные и нефункциональные требования к ограничителю скорости. Также будут рассмотрены типы управления скоростью и места, где ограничитель скорости может быть установлен для эффективного выполнения своих функций.
Высокоуровневый дизайн
В этом разделе мы рассмотрим высокоуровневый дизайн, чтобы дать общее представление о работе ограничителя скорости.
Детализированный дизайн
В этом разделе мы обсудим детализированный дизайн ограничителя скорости и объясним различные компоненты, участвующие в его реализации.
Алгоритмы ограничителя скорости
В этом уроке мы рассмотрим различные алгоритмы, которые играют важную роль в работе ограничителя скорости.
Викторина
Чтобы оценить ваше понимание работы ограничителей скорости, в конце главы мы предлагаем викторину.
Requirements of a Rate Limiter’s Design
Требования
В этом уроке мы сосредоточимся на проектировании ограничителя скорости с учетом следующих функциональных и нефункциональных требований.
Функциональные требования
-
Ограничение числа запросов:
- Ограничить количество запросов, которые клиент может отправить к API в течение временного окна.
-
Конфигурируемость лимитов:
- Сделать лимит запросов в окне конфигурируемым.
-
Уведомление клиента:
- Убедиться, что клиент получает сообщение (ошибку или уведомление), когда определенный порог превышен на одном или нескольких серверах.
Нефункциональные требования
-
Доступность:
- Ограничитель скорости должен быть высокодоступным, так как он защищает нашу систему.
-
Низкая задержка:
- Поскольку все запросы к API проходят через ограничитель скорости, он должен работать с минимальной задержкой, чтобы не ухудшать пользовательский опыт.
-
Масштабируемость:
- Дизайн должен быть высокомасштабируемым и способен ограничивать растущее количество запросов от клиентов со временем.
Типы ограничения скорости (throttling)
Ограничитель скорости может выполнять три типа ограничения:
-
Жесткое ограничение (Hard throttling):
- Жесткое ограничение устанавливает жесткий лимит на количество запросов к API. Если запрос превышает этот лимит, он отклоняется.
-
Мягкое ограничение (Soft throttling):
- При мягком ограничении количество запросов может превышать установленный лимит на определенный процент. Например, если лимит в системе составляет 500 запросов в минуту с допустимым превышением на 5%, клиент может отправлять до 525 запросов в минуту.
-
Эластичное или динамическое ограничение (Elastic or dynamic throttling):
- При этом ограничении количество запросов может превышать установленный лимит, если в системе доступны дополнительные ресурсы. Однако нет конкретно определенного верхнего предела. Например, если система позволяет 500 запросов в минуту, она может разрешить отправку большего количества запросов при наличии свободных ресурсов.
Ограничение ресурсов на уровне системы
Операционные системы Linux предоставляют функцию ядра, известную как cgroups (control groups), которая ограничивает, учитывает и изолирует ресурсы — процессорное время, системную память, дисковое хранилище, I/O и сетевую пропускную способность — для группы процессов. Используя cgroups, системный администратор может контролировать, ограничивать доступ к определенным ресурсам и динамически перенастраивать cgroups на работающей системе.
Преимущества использования cgroups
-
Ограничение ресурсов:
- Эта функция позволяет наложить ограничение на группы, не позволяя им превышать настроенный лимит памяти и кэш файловой системы.
-
Приоритизация:
- Некоторым группам можно предоставить приоритетное использование большей доли процессорных циклов или дискового I/O.
-
Учет:
- Эта функция используется для измерения использования ресурсов группой, что также может быть использовано для целей биллинга.
-
Контроль:
- Системный администратор может управлять группами процессов, их контрольными точками и перезапуском с помощью этой функции.
Размещение ограничителя скорости
Существует три разных способа размещения ограничителя скорости:
-
На стороне клиента:
- Размещение ограничителя на стороне клиента проще, но этот подход небезопасен, так как ограничитель легко может быть изменен злоумышленником. Кроме того, конфигурация на стороне клиента в этом случае также затруднена.
-
На стороне сервера:
- Как показано на следующем рисунке, ограничитель скорости размещается на стороне сервера. В этом подходе сервер получает запрос, который проходит через ограничитель скорости, расположенный на сервере.
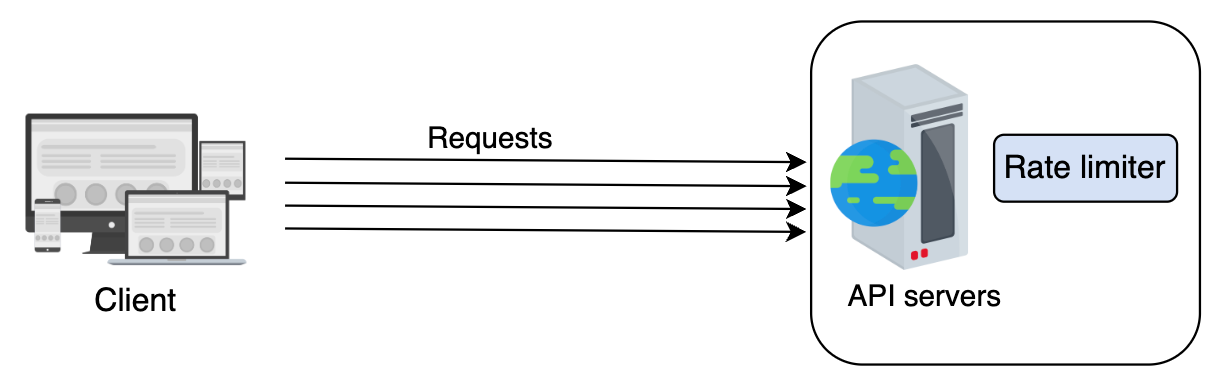
- Как показано на следующем рисунке, ограничитель скорости размещается на стороне сервера. В этом подходе сервер получает запрос, который проходит через ограничитель скорости, расположенный на сервере.
-
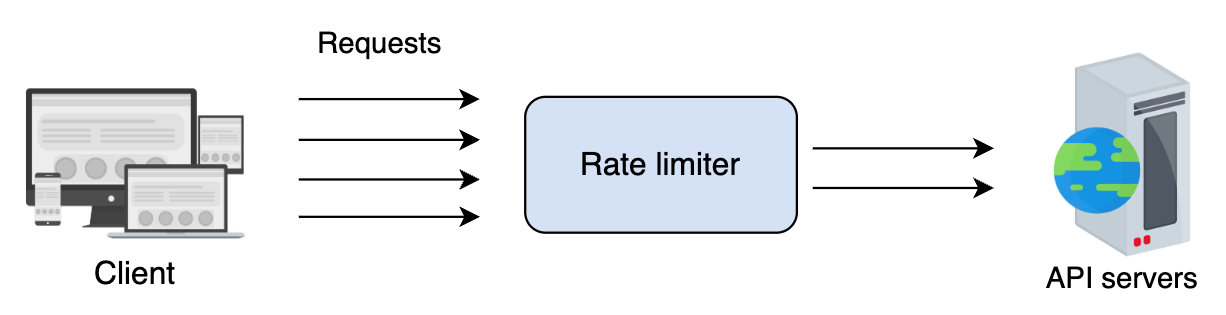
В качестве промежуточного слоя (middleware):
- В этой стратегии ограничитель скорости выступает в роли промежуточного слоя, который ограничивает запросы к серверам API, как показано на следующем рисунке.
Размещение ограничителя скорости зависит от множества факторов и является субъективным решением, основанным на стеке технологий организации, инженерных ресурсах, приоритетах, планах, целях и т.д.
Примечание: Многие современные сервисы используют API для предоставления своей функциональности клиентам. API-эндпоинты могут быть удобным местом для ограничения скорости входящего трафика клиентов, так как весь трафик проходит через них.
Две модели реализации ограничителя скорости
Один ограничитель скорости может оказаться недостаточным для обработки огромного трафика и поддержки миллионов пользователей. Поэтому лучшим вариантом является использование нескольких ограничителей скорости в виде кластера независимых узлов. Поскольку будет множество ограничителей скорости с соответствующими счетчиками (или их лимитами), существует два способа использования баз данных для хранения, извлечения и обновления счетчиков вместе с информацией о пользователях.
1. Ограничитель скорости с централизованной базой данных
В этом подходе ограничители скорости взаимодействуют с централизованной базой данных, предпочтительно Redis или Cassandra. Преимущество этой модели заключается в том, что счетчики хранятся в централизованной базе данных, поэтому клиент не может превысить установленный лимит. Однако у этого подхода есть несколько недостатков. Он вызывает увеличение задержки, если огромное количество запросов поступает в централизованную базу данных. Еще одна серьезная проблема — возможность возникновения условий гонки при высококонкурентных запросах (или связанных с ними блокировках).
2. Ограничитель скорости с распределенной базой данных
Другой подход заключается в использовании независимого кластера узлов, где состояние ограничения скорости хранится в распределенной базе данных. В этом подходе каждый узел должен отслеживать лимит скорости. Проблема заключается в том, что клиент может временно превысить лимит скорости, отправляя запросы на разные узлы (ограничители скорости), пока состояние собирается со всех узлов. Чтобы обеспечить соблюдение лимита, необходимо настроить "липкие" сессии (sticky sessions) в балансировщике нагрузки, чтобы каждый потребитель отправлялся на один конкретный узел. Однако этот подход недостаточно отказоустойчив и может вызвать проблемы с масштабированием, когда узлы перегружены.
Дополнительные аспекты
Помимо двух вышеуказанных концепций, существует еще одна проблема — использовать ли глобальный счетчик, общий для всех входящих запросов, или индивидуальные счетчики для каждого пользователя. Например, алгоритм "ведро с токенами" (token bucket) можно реализовать двумя способами. В первом методе все запросы могут использовать общее количество токенов в одном ведре, а во втором методе каждому пользователю назначаются отдельные ведра. Выбор между общими или отдельными счетчиками (или ведрами) зависит от конкретного случая использования и правил ограничения скорости.
Can a load balancer be used as a rate limiter?
Details
Load balancers play a critical role in preventing an application server from being overwhelmed by an excessive number of requests. They achieve this by either declining requests based on predefined limits or directing them to a queue for deferred processing. It’s essential to emphasize that load balancers treat all incoming requests impartially, without recognizing the diverse complexities and processing durations associated with different operations. For instance, certain operations within a web service may be rapid, while others may be more time-intensive. When there is a need to control the number of requests for specific operations, a more effective approach is to implement this control at the application server level using a rate limiter. The rate limiter excels at understanding the intricacies of individual operations and can selectively impose limitations as required.
Assume a scenario in which a client intends to send requests for a particular service using two virtual machines (VMs), where one is using a VPN to a different region. Suppose that the throttling identifier works based on user credentials. Therefore, the user ID would be the same for both sessions. Moreover, let’s assume that requests from different VMs can hit different data centers. How would the throttling work to prevent the user from exceeding the rate limit in this scenario?
Details
Load balancers play a critical role in preventing an application server from being overwhelmed by an excessive number of requests. They achieve this by either declining requests based on predefined limits or directing them to a queue for deferred processing. It’s essential to emphasize that load balancers treat all incoming requests impartially, without recognizing the diverse complexities and processing durations associated with different operations. For instance, certain operations within a web service may be rapid, while others may be more time-intensive. When there is a need to control the number of requests for specific operations, a more effective approach is to implement this control at the application server level using a rate limiter. The rate limiter excels at understanding the intricacies of individual operations and can selectively impose limitations as required.
Building blocks we will use
The design of the rate limiter utilizes the following building blocks that we discussed in the initial chapters.
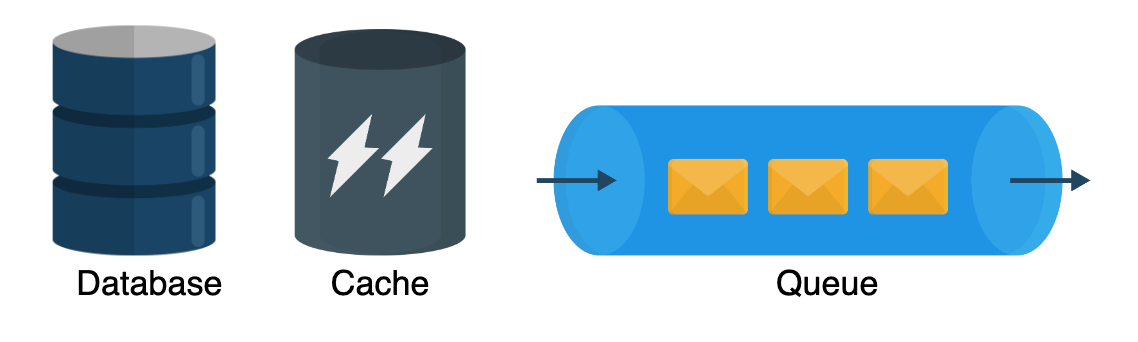
- Databases are used to store rules defined by a service provider and metadata of users using the service.
- Caches are used to cache the rules and users’ data for frequent access.
- Queues are essential for holding the incoming requests that are allowed by the rate limiter.
Design of a Rate Limiter
Высокоуровневый дизайн
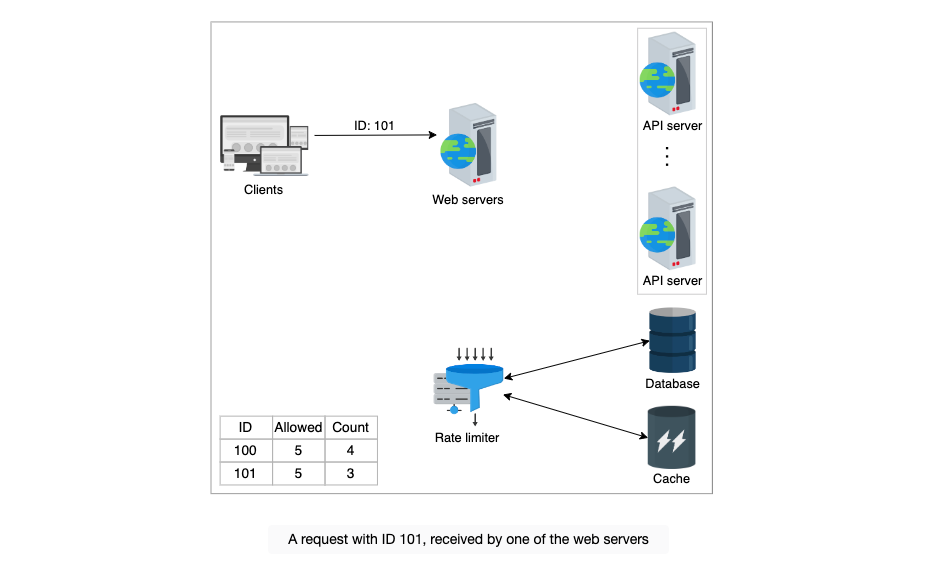
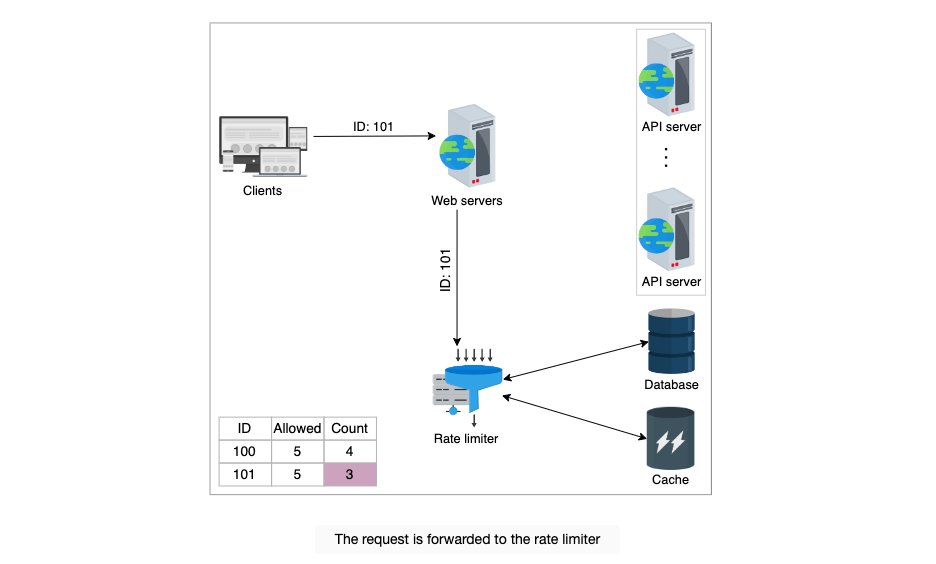
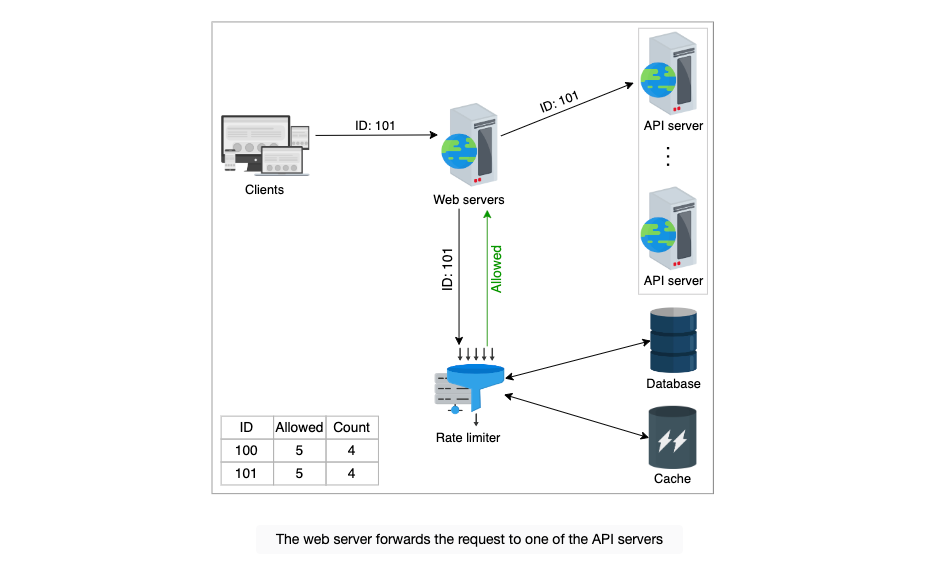
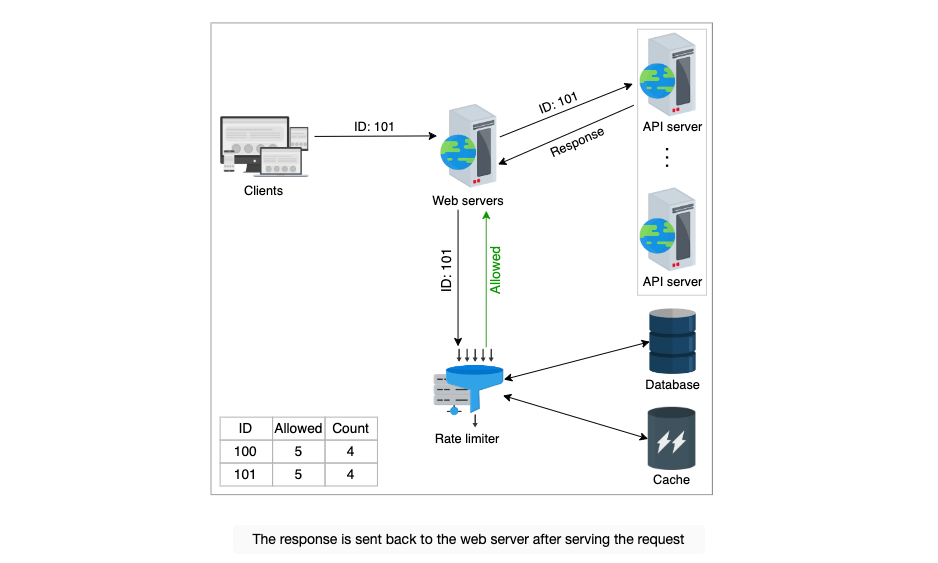
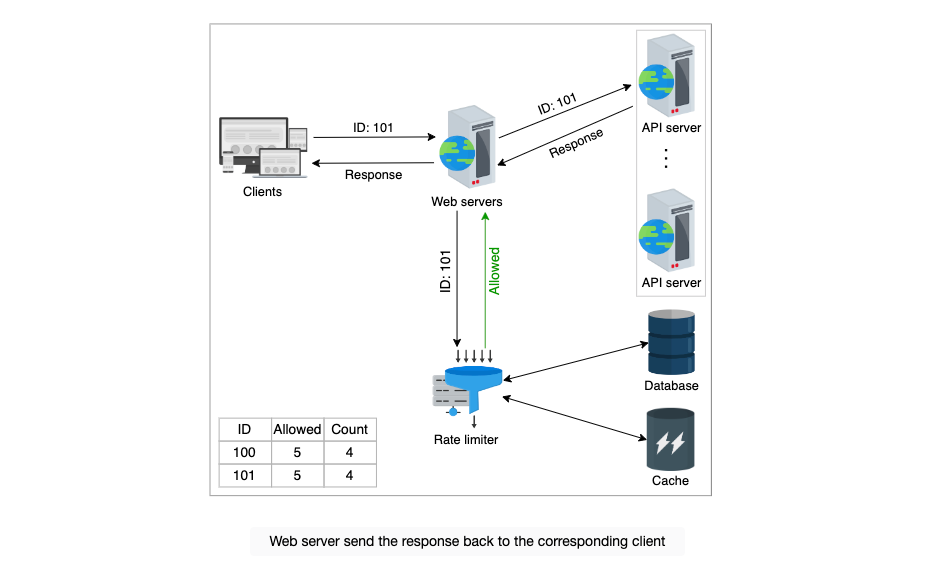
Ограничитель скорости можно развернуть как отдельный сервис, который будет взаимодействовать с веб-сервером, как показано на рисунке ниже. Когда запрос поступает, ограничитель скорости определяет, следует ли его перенаправить на сервер или нет. Ограничитель скорости содержит набор правил, которые должен соблюдать каждый входящий запрос. Эти правила определяют лимит на количество операций. Давайте рассмотрим одно из правил ограничения скорости от Lyft, которая открыла исходный код своего компонента ограничения скорости.
domain: messaging
descriptors:
   -key: message_type
    value: marketing
    rate_limit:
               unit: day
               request_per_unit: 5
В приведенном выше правиле ограничения скорости параметр unit установлен на day, а request_per_unit установлен на 5. Эти параметры определяют, что система может разрешить пять маркетинговых сообщений в день.
Детализированный дизайн
Высокоуровневый дизайн, описанный выше, не отвечает на следующие вопросы:
- Где хранятся правила?
- Как обрабатываются запросы, которые превышают лимит скорости?
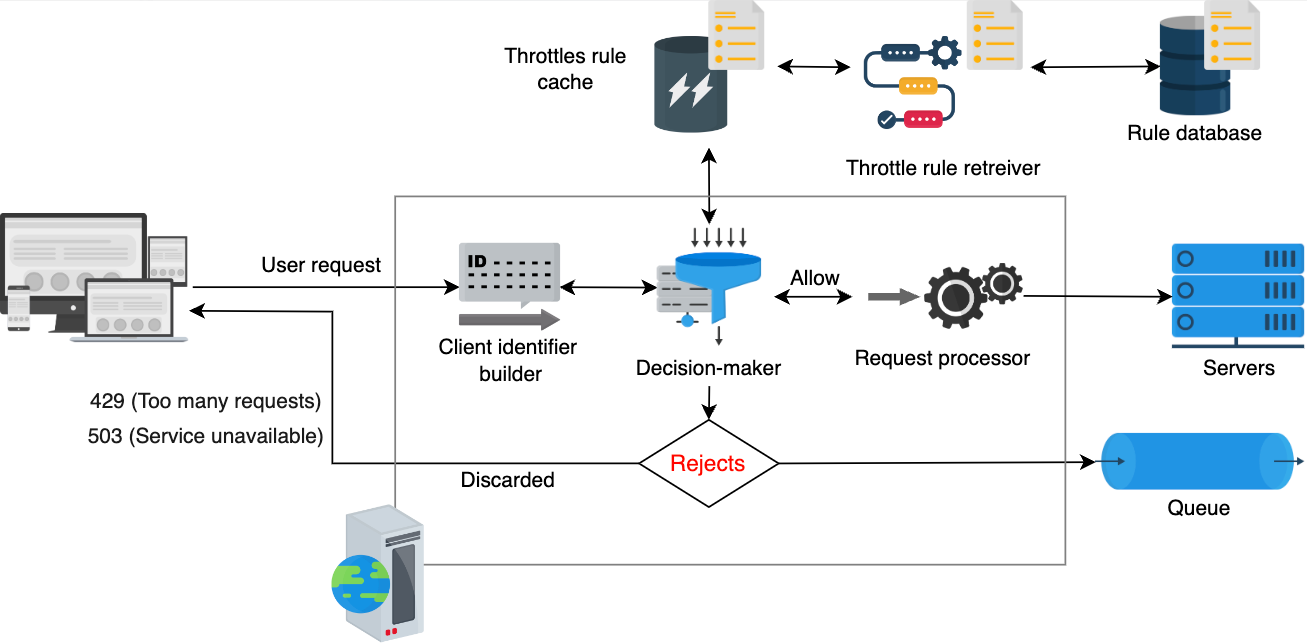
В этом разделе мы сначала расширим высокоуровневую архитектуру, добавив несколько других важных компонентов. Также мы подробно объясним каждый компонент, как показано на следующем рисунке.
Компоненты детализированного дизайна ограничителя скорости
-
База данных правил (Rule database):
- Это база данных, содержащая правила, определенные владельцем сервиса. Каждое правило указывает количество запросов, разрешенных для конкретного клиента в единицу времени.
-
Извлекатель правил (Rules retriever):
- Это фоновый процесс, который периодически проверяет наличие изменений в правилах базы данных. Кэш правил обновляется, если в существующие правила были внесены изменения.
-
Кэш правил ограничения скорости (Throttle rules cache):
- Кэш содержит правила, извлеченные из базы данных правил. Кэш позволяет ограничителю скорости быстрее обрабатывать запросы по сравнению с постоянным хранилищем, что повышает производительность системы. Когда ограничитель скорости получает запрос по идентификатору (ключу), он проверяет этот идентификатор по правилам в кэше.
-
Принятие решений (Decision-maker):
- Этот компонент отвечает за принятие решений на основе правил, хранящихся в кэше. Компонент работает на основе одного из алгоритмов ограничения скорости, которые будут рассмотрены в следующем уроке.
-
Построитель идентификатора клиента (Client identifier builder):
- Этот компонент генерирует уникальный идентификатор для запроса, полученного от клиента. Это может быть удаленный IP-адрес, идентификатор пользователя или комбинация нескольких других атрибутов, из-за чего невозможно использовать простой последовательный номер. Этот идентификатор используется в качестве ключа для хранения данных пользователя в key-value базе данных. Этот ключ передается компоненту принятия решений для дальнейших действий.
Обработка запросов при превышении лимита
В случае превышения установленного лимита API возвращает HTTP-код ответа 429 Too Many Requests, и применяется одна из следующих стратегий:
- Отклонить запрос и вернуть клиенту конкретный ответ, например "слишком много запросов" или "сервис недоступен".
- Если некоторые запросы ограничены из-за перегрузки системы, их можно поставить в очередь для обработки позже.
Обработка запросов
Когда поступает запрос, построитель идентификатора клиента идентифицирует запрос и перенаправляет его компоненту принятия решений. Компонент принятия решений определяет, какие услуги требуются для запроса, затем проверяет кэш на предмет количества разрешенных запросов, а также правил, предоставленных владельцем сервиса. Если запрос не превышает лимит, он перенаправляется на процессор запросов, который отвечает за его обработку.
Компонент принятия решений действует на основе алгоритмов ограничения скорости. Ограничение может быть жестким, мягким или эластичным. В случае мягкого или эластичного ограничения запросы могут превышать установленный лимит. Эти запросы либо обрабатываются, либо помещаются в очередь и обрабатываются позже, по мере доступности ресурсов. Если используется жесткое ограничение, запросы отклоняются, и клиенту возвращается ошибка.
In the event of a failure, a rate limiter is unable to perform the task of throttling. In these scenarios, should the request be accepted or rejected?
Details
In the event of a failure where a rate limiter is unable to perform its task of throttling, the request should be accepted. This approach ensures that the system remains available and fault-tolerant, maintaining service access even when specific components fail. It’s important because there are usually multiple layers of rate limiting and load balancing within a system’s architecture that can manage the load to some extent. However, it’s critical for the engineering team to quickly address the failure of the rate limiter to ensure system stability and performance are not compromised in the long term.
Условие гонки
В ситуации с высококонкурентными паттернами запросов возможно возникновение условия гонки. Это происходит, когда используется подход "get-then-set", при котором текущий счетчик извлекается, инкрементируется и затем записывается обратно в базу данных. При использовании этого подхода могут пройти дополнительные запросы, которые сделают инкрементированный счетчик недействительным. Это позволяет клиенту отправлять очень высокую частоту запросов, обходя механизмы ограничения скорости. Чтобы избежать этой проблемы, можно использовать механизм блокировки, при котором один процесс может обновлять счетчик в определенное время, пока остальные ждут освобождения блокировки. Однако этот подход может вызвать потенциальное узкое место, что значительно снижает производительность и плохо масштабируется.
Другой метод, который можно использовать, — это подход "set-then-get", при котором значение инкрементируется очень эффективно, избегая использования блокировок. Этот подход работает, если существует минимальный уровень конкуренции. Однако можно использовать и другие методы, при которых квота разделяется на несколько частей и распределяется между ними нагрузка, или использовать шардинг счетчиков для масштабирования подхода.
Примечание: Мы можем использовать шардинг счетчиков для ограничения скорости при высокой конкуренции запросов. Увеличивая количество шардов, мы уменьшаем конкуренцию при записи. Однако, поскольку необходимо собирать данные из всех шардов, чтение может замедлиться.
Ограничитель скорости не должен находиться на критическом пути клиента
Рассмотрим реальный сценарий, при котором миллионы запросов попадают на фронтальные серверы. Каждый запрос извлекает, обновляет и записывает счетчик в соответствующий кэш. После всех этих операций запрос отправляется на обслуживание. Этот подход может вызвать задержку при большом количестве запросов. Чтобы избежать многочисленных вычислений на критическом пути клиента, следует разделить работу на офлайн и онлайн части.
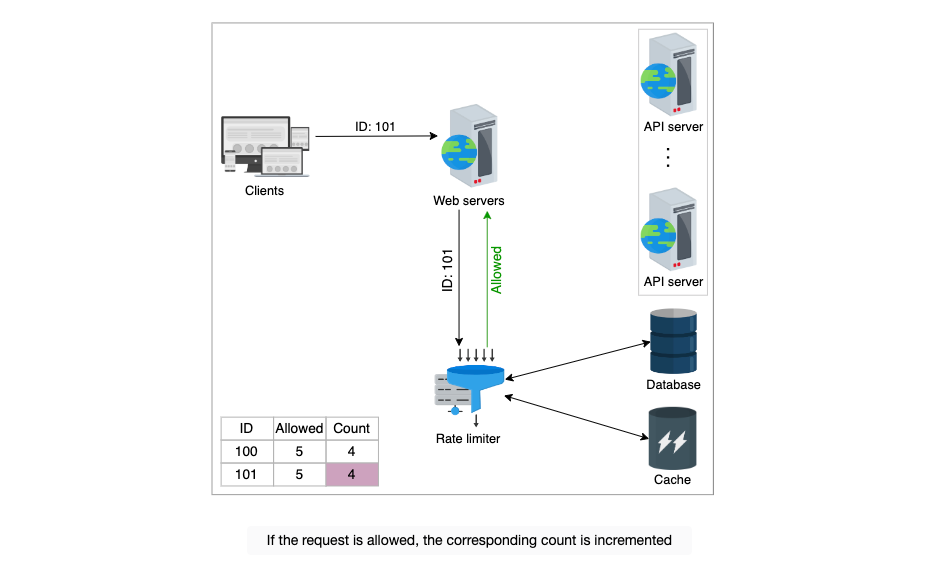
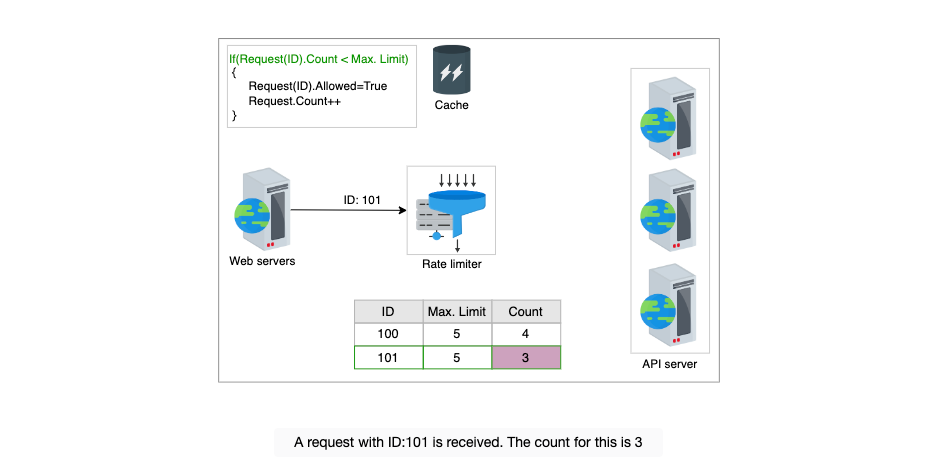
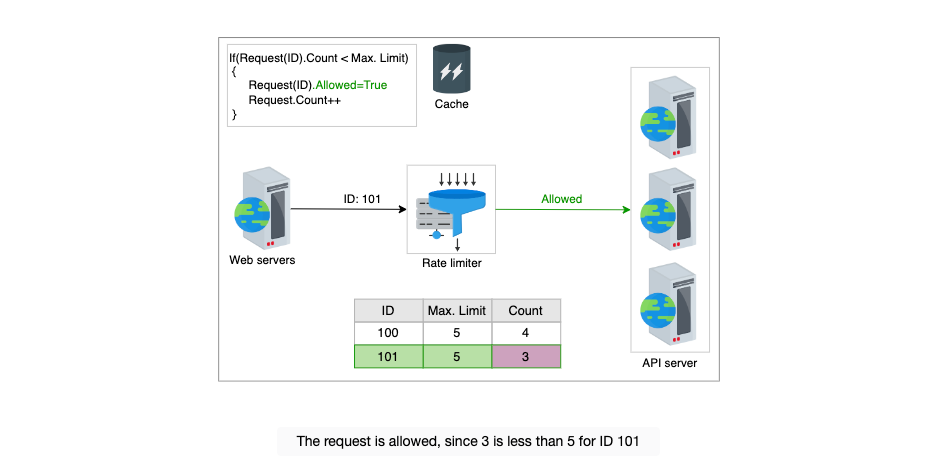
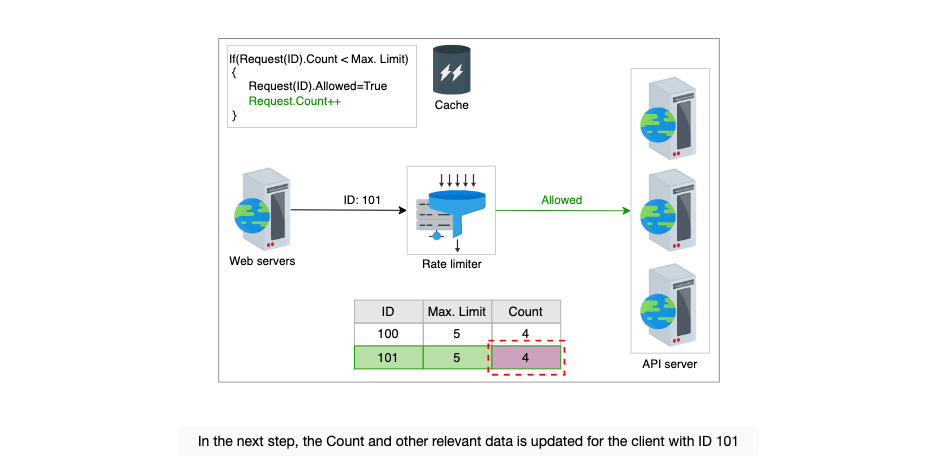
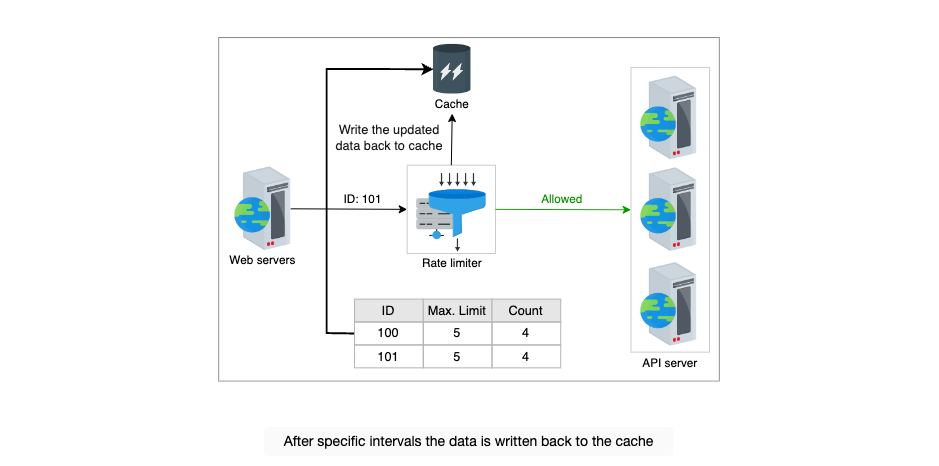
Изначально, когда запрос клиента получен, система просто проверяет соответствующий счетчик. Если он меньше максимального лимита, система разрешает выполнение запроса клиента. На втором этапе система обновляет соответствующий счетчик и кэш офлайн. Для нескольких запросов это не окажет влияния на производительность, но для миллионов запросов этот подход значительно увеличит производительность.
Пример подхода с онлайн и офлайн обновлением
Рассмотрим пример. Когда запрос поступает, его ID передается ограничителю скорости, который проверяет условие if(request(ID).Count <= Max.Limit путем извлечения данных из кэша. Для простоты предположим, что один из запросов имеет ID 101, то есть request(ID) = 101. В следующей таблице показано количество запросов, сделанных каждым клиентом, и максимальное количество запросов за единицу времени, которое может сделать клиент.
| Request ID | Maximum Limit | Count |
|---|---|---|
| 100 | 5 | 4 |
| 101 | 5 | 3 |
Если условие истинно, ограничитель скорости сначала отправит на фронтальный сервер сигнал "Allowed". Соответствующий счетчик и другая важная информация будут обновлены офлайн на следующих шагах. Ограничитель скорости записывает обновленные данные в кэш. Такой подход снижает задержку и устраняет конкуренцию, которую могли бы вызвать входящие запросы.
Примечание: Мы видели форму ограничения скорости в TCP, где получатель может ограничивать отправителя, указывая размер окна (outstanding data), которое получатель готов принять. Отправитель отправляет минимальное значение либо окна перегрузки, либо указанного окна. Многие регуляторы сетевого трафика используют аналогичные механизмы для предоставления преференциального обслуживания различным потокам трафика.
Заключение
В этом уроке мы обсудили проектирование ограничителя скорости в распределенных системах. Проанализируем нефункциональные требования, которые мы упоминали в предыдущем уроке.
Доступность
Если один ограничитель скорости выйдет из строя, будут доступны несколько других ограничителей скорости для обработки входящих запросов. Таким образом, устраняется единая точка отказа.
Низкая задержка
Наша система извлекает и обновляет данные каждого входящего запроса из кэша, а не из базы данных. Сначала входящие запросы перенаправляются, если они не превышают лимит скорости, а затем кэш и база данных обновляются.
Масштабируемость
Количество ограничителей скорости можно увеличивать или уменьшать в зависимости от числа входящих запросов в пределах установленного лимита.
Таким образом, наша система обеспечивает высокую доступность, низкую задержку и масштабируемость в соответствии с вышеизложенным.
Rate Limiter Algorithms
Задачи ограничителя скорости выполняются с помощью высокоэффективных алгоритмов, каждый из которых имеет свои преимущества и недостатки. Выбор алгоритма или их комбинации зависит от конкретных требований. В этом уроке мы рассмотрим несколько популярных алгоритмов.
Алгоритм "Ведро с токенами" (Token Bucket)
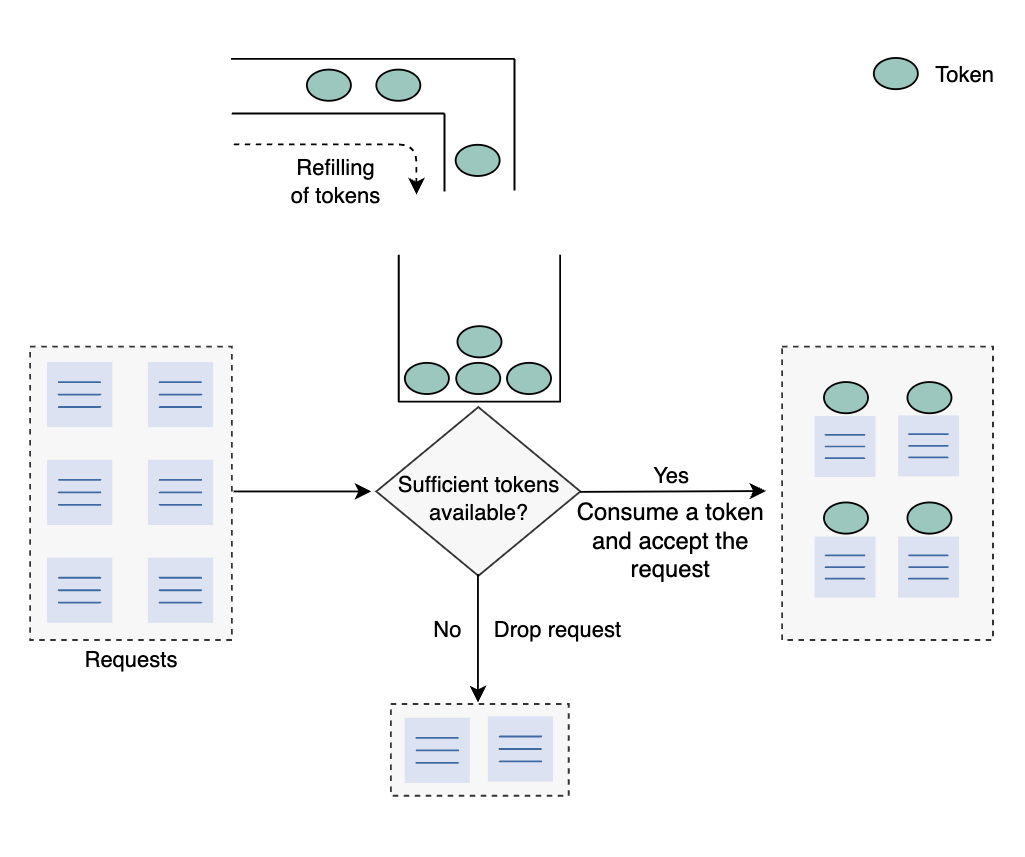
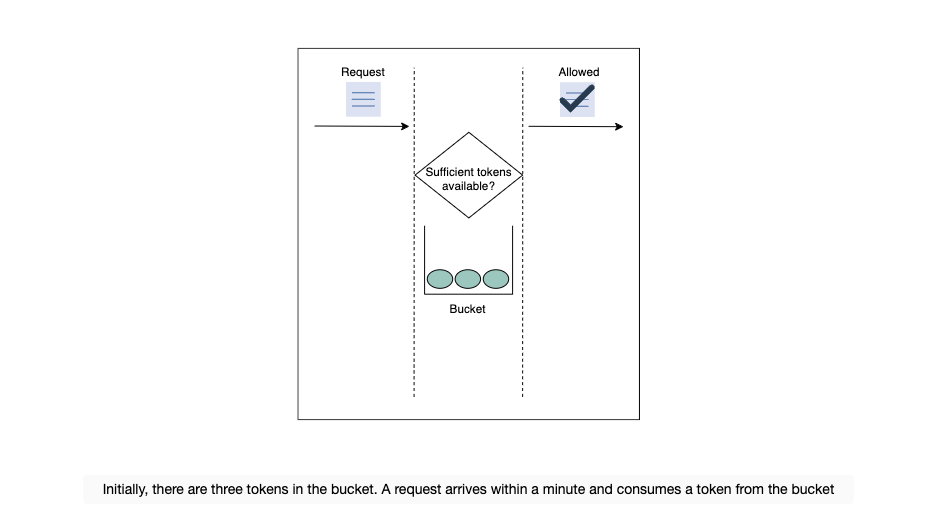
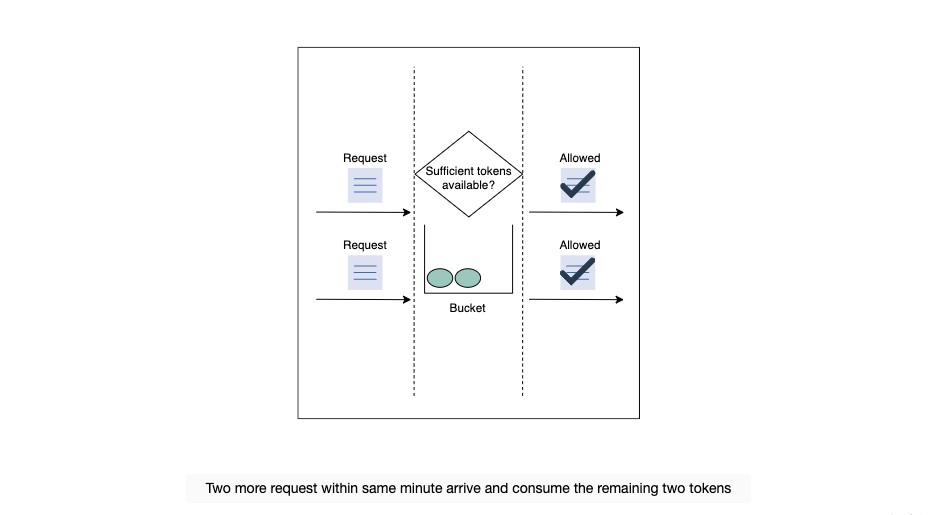
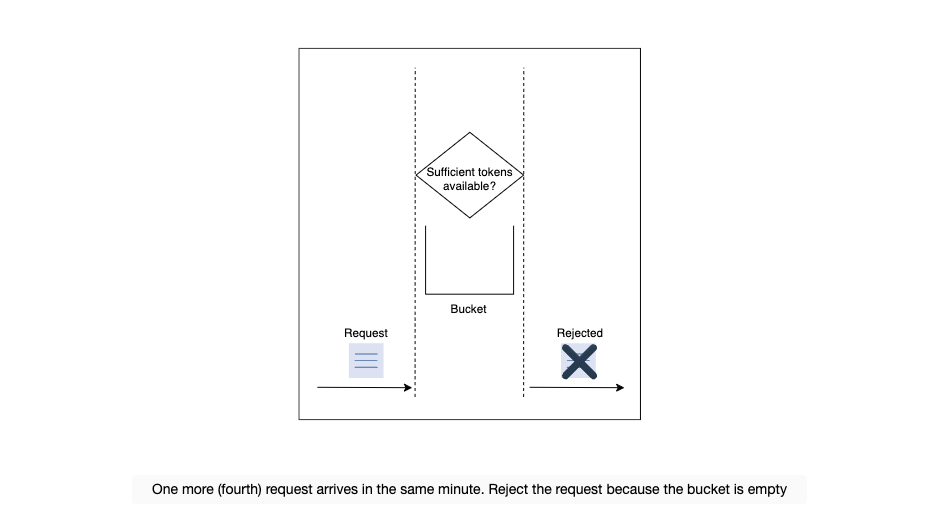
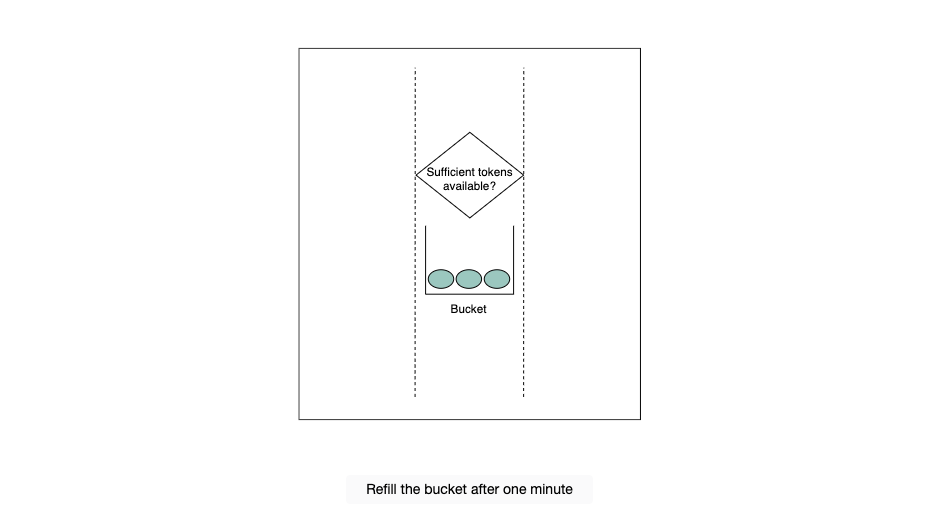
Этот алгоритм использует аналогию ведра с предопределенной емкостью токенов. Ведро периодически заполняется токенами с постоянной скоростью. Токен можно рассматривать как пакет определенного размера. Алгоритм проверяет наличие токена в ведре каждый раз, когда поступает запрос. Для дальнейшей обработки запроса в ведре должен быть хотя бы один токен.
Основные параметры:
- Емкость ведра (C): Максимальное количество токенов, которое может находиться в ведре.
- Лимит скорости (R): Количество запросов, которое мы хотим ограничить за единицу времени.
- Скорость заполнения (1/R): Интервал времени, через который добавляется новый токен в ведро.
- Количество запросов (N): Этот параметр отслеживает количество входящих запросов и сравнивает их с емкостью ведра.
Преимущества:
- Позволяет возникать всплескам трафика, пока в ведре достаточно токенов.
- Эффективен по использованию памяти.
Недостатки:
- Определение оптимального значения параметров может быть сложной задачей.
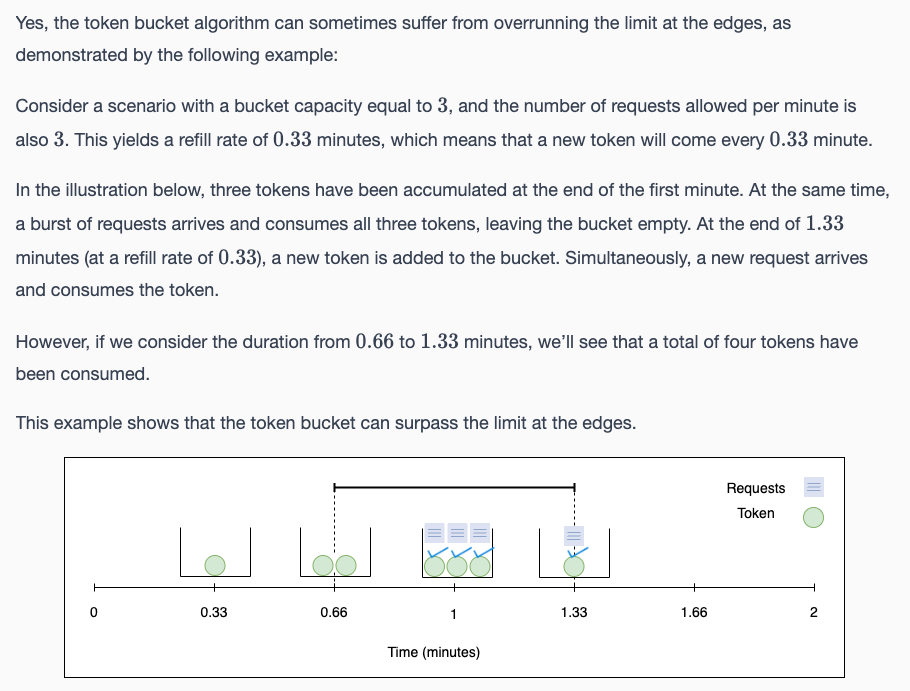
Apart from permitting bursts, can the token bucket algorithm surpass the limit at the edges?
Details
Алгоритм "Протекающее ведро" (Leaking Bucket)
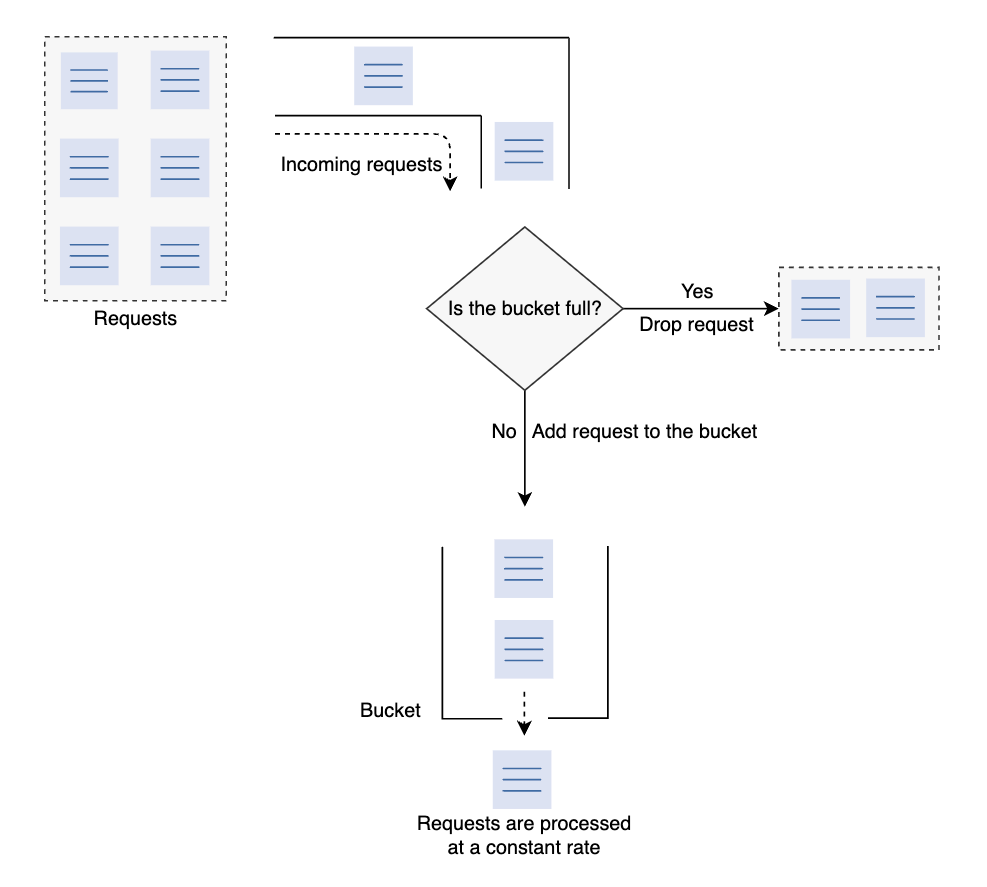
Алгоритм "Протекающее ведро" является модификацией алгоритма "Ведро с токенами". Вместо использования токенов, этот алгоритм использует ведро для хранения входящих запросов и обрабатывает их с постоянной скоростью в порядке FIFO (first-in-first-out).
Основные параметры:
- Емкость ведра (C): Определяет максимальную емкость ведра. Алгоритм будет отклонять входящие запросы, если ведро достигло своей максимальной емкости.
- Скорость притока (R_in): Показатель скорости поступления запросов.
- Скорость оттока (R_out): Определяет количество запросов, обрабатываемых за единицу времени.
Преимущества:
- Предотвращает всплески запросов за счет постоянной скорости оттока.
- Эффективен по использованию памяти.
Недостатки:
- Всплеск запросов может заполнить ведро, и если они не будут обработаны вовремя, недавние запросы могут быть отклонены.
Алгоритм "Фиксированное окно" (Fixed Window Counter)
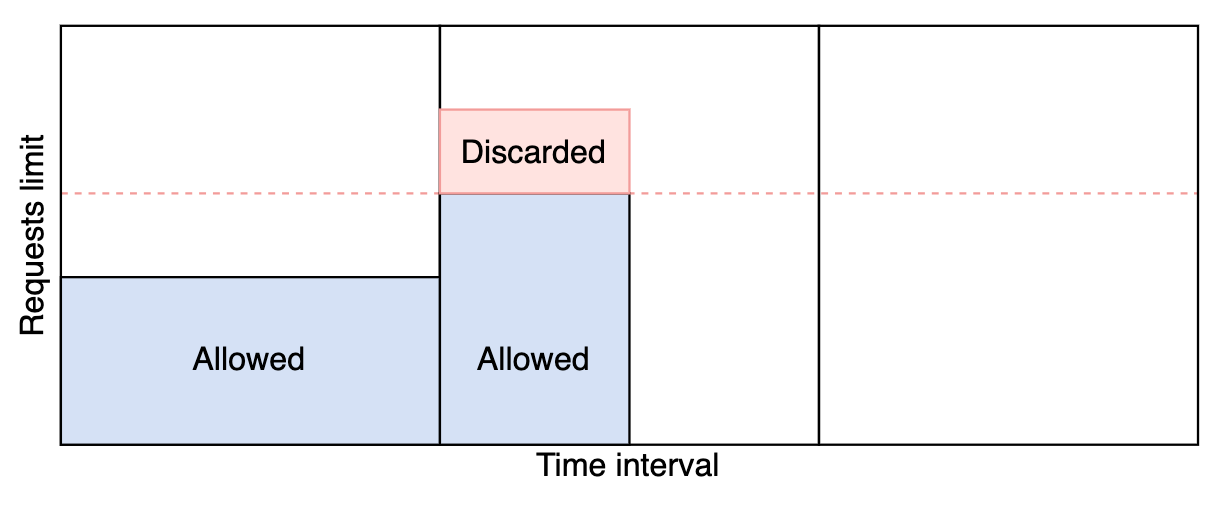
Этот алгоритм делит время на фиксированные интервалы, называемые окнами, и присваивает счетчик каждому окну. Когда определенное окно получает запрос, счетчик увеличивается на единицу. Как только счетчик достигает своего лимита, новые запросы отклоняются в этом окне.
Основные параметры:
- Размер окна (W): Определяет размер временного окна.
- Лимит скорости (R): Показывает количество запросов, разрешенных за временное окно.
- Количество запросов (N): Этот параметр показывает количество входящих запросов за окно.
Преимущества:
- Эффективен по использованию памяти.
- В отличие от алгоритмов типа "Ведро с токенами", этот алгоритм обслуживает новые запросы, даже если лимит превышен.
Недостатки:
- Постоянные всплески трафика в начале или в конце окна могут привести к снижению производительности.
Алгоритм "Скользящее окно с логом" (Sliding Window Log)
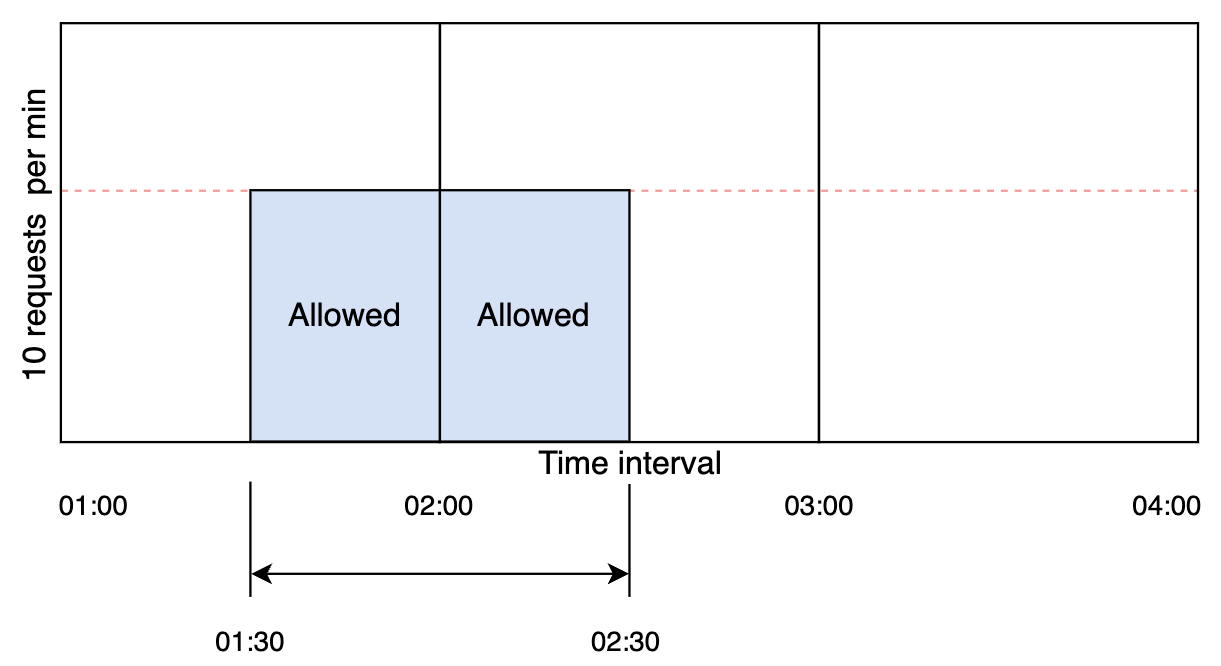
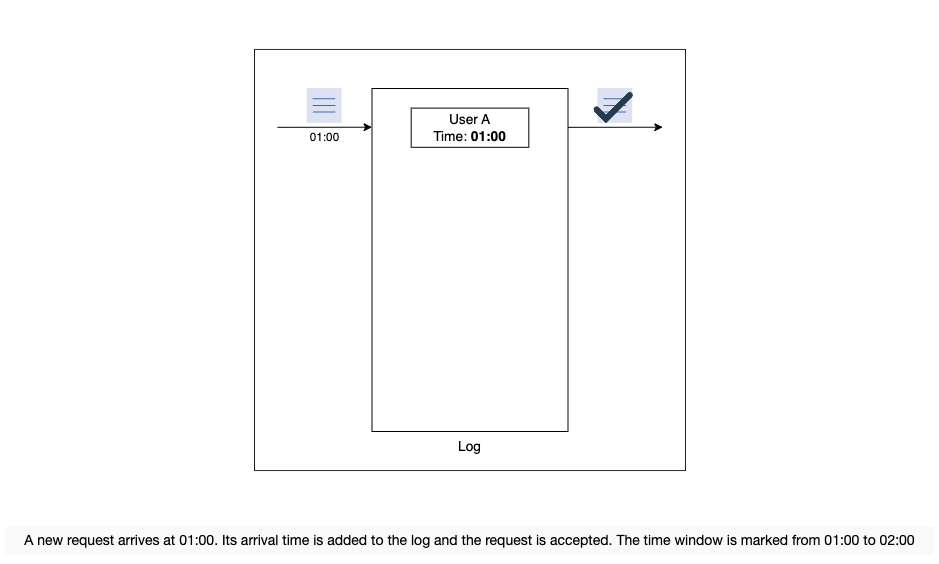
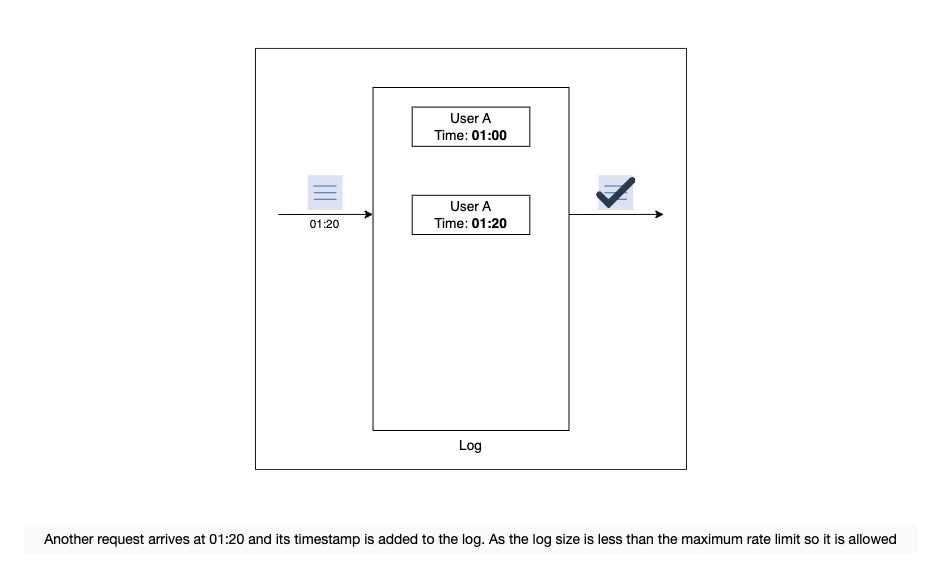
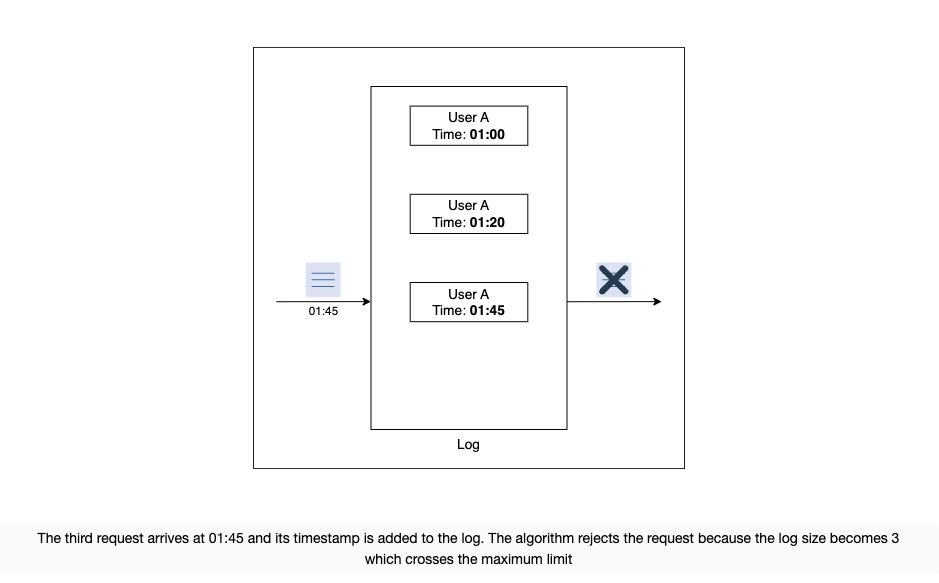
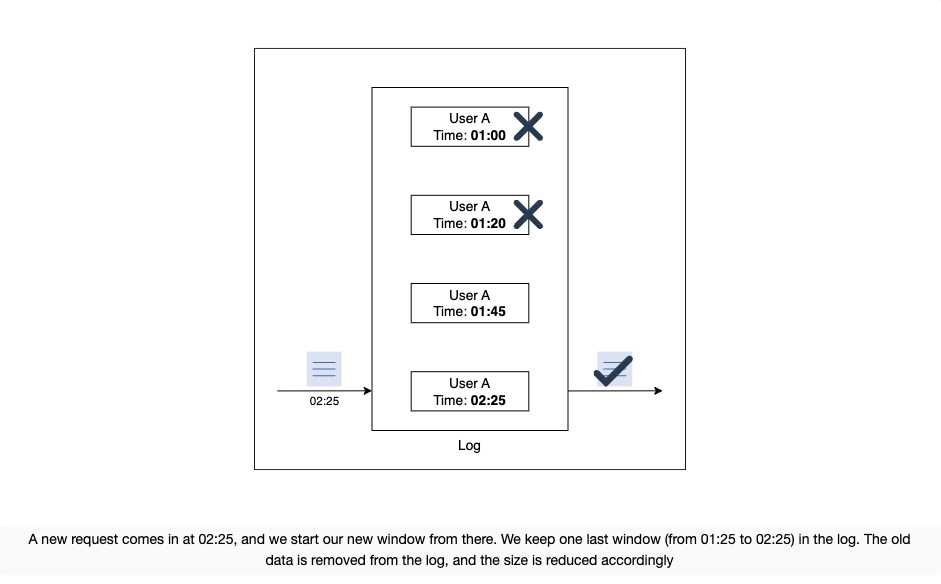
Отслеживает каждый входящий запрос. Время прихода запроса сохраняется в хэш-карте, известной как лог. Логи сортируются по временным меткам запросов. Запросы разрешаются в зависимости от размера лога и времени прихода.
Основные параметры:
- Размер лога (L): Определяет количество запросов, разрешенных в определенный промежуток времени.
- Время прихода (T): Отслеживает временные метки входящих запросов и определяет их количество.
- Временной диапазон (T_r): Определяет временные рамки для обработки запросов.
Преимущества:
- Алгоритм не страдает от проблем на границах окон, как фиксированное окно.
Недостатки:
- Требует дополнительной памяти для хранения временных меток входящих запросов.
Алгоритм "Скользящее окно со счетчиком" (Sliding Window Counter)
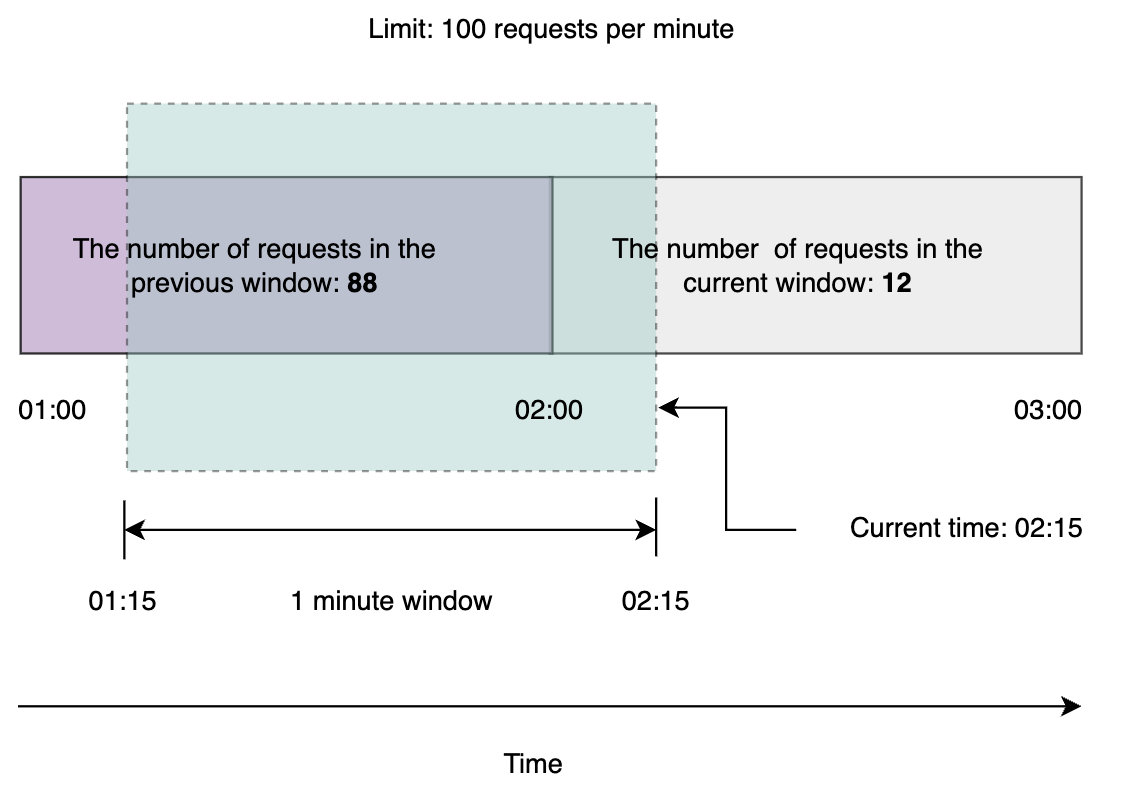
Этот алгоритм сочетает в себе фиксированное окно и скользящее окно с логом, чтобы сделать поток запросов более плавным. Алгоритм учитывает запросы из предыдущего окна и текущего окна, а также их пересечение.
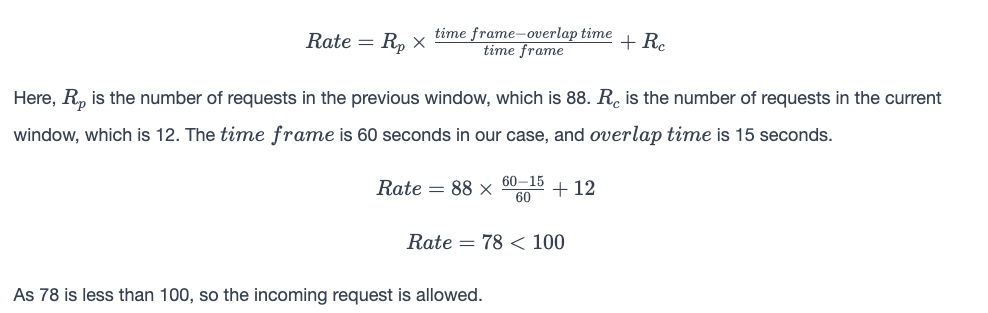 Основные параметры:
- Лимит скорости (R): Определяет максимальное количество запросов за окно.
- Размер окна (W): Представляет размер временного окна.
- Количество запросов в предыдущем окне (R_p): Определяет общее количество запросов в предыдущем временном окне.
- Количество запросов в текущем окне (R_c): Представляет количество запросов, полученных в текущем окне.
- Время пересечения (O_t): Показывает время пересечения скользящего окна с текущим окном.
- Преимущества:
- Алгоритм эффективен по использованию памяти.
- Сглаживает всплески запросов и обрабатывает их на основе предыдущих окон.
Недостатки:
- Предполагает, что количество запросов в предыдущем окне равномерно распределено, что может не всегда быть возможным.
Сравнение алгоритмов ограничения скорости
Два основных фактора, которые общие для всех алгоритмов ограничения скорости:
- Память: Относится к количеству состояний, которые требуются алгоритму для нормальной работы.
- Всплеск трафика: Относится к увеличению трафика за единицу времени, превышающего установленный лимит.
| Алгоритм | Эффективность использования памяти | Позволяет всплеск трафика? |
|---|---|---|
| Ведро с токенами | Да | Да, позволяет всплеск трафика |
| Протекающее ведро | Да | Нет |
| Фиксированное окно | Да | Да, на границе временного окна |
| Скользящее окно с логом | Нет, требует дополнительной памяти | Нет |
| Скользящее окно со счетчиком | Да, но требует больше памяти | Сглаживает всплески |
Примечание: Блокировка не всегда плоха при применении вышеуказанных алгоритмов. Если конкуренция за блокировку невелика, получение блокировки занимает мало времени. При высокой конкуренции за блокировку требуется тщательный анализ для управления ситуацией, возможно, с помощью шардинга данных и использования нескольких более мелких блокировок.