The Distributed Search
Зачем нам нужна поисковая система?
Сегодня мы видим поисковую строку на почти каждом веб-сайте. Мы используем эту строку поиска для нахождения релевантного контента среди огромного количества доступного контента на сайте. Поисковая строка позволяет быстро найти то, что мы ищем. Например, на сайте Educative представлено множество курсов. Если бы не было функции поиска, пользователям пришлось бы прокручивать множество страниц и читать названия каждого курса, чтобы найти нужный.
Давайте рассмотрим еще один пример. На YouTube загружены миллиарды видео. Представьте, если бы YouTube не предоставлял нам поисковую строку. Как бы мы нашли конкретное видео среди миллионов видео, размещенных на YouTube за годы? На поиск нужного видео путем навигации через все доступные видео ушли бы месяцы. Пользователи столкнулись бы с огромными трудностями при поиске нужного контента, просто прокручивая страницы.
Поисковые системы — еще более яркий пример. В интернете существует миллиарды веб-сайтов. Каждый сайт имеет множество веб-страниц, и на каждой из них представлено множество контента. При таком объеме информации интернет был бы практически бесполезен без поисковых систем, а пользователи затерялись бы в море нерелевантных данных. Поисковые системы по сути являются фильтрами для огромного объема доступных данных. Они позволяют пользователям быстро получать интересующую их информацию без необходимости просеивать слишком много ненужных веб-страниц.
За каждой поисковой строкой стоит поисковая система.
Что такое поисковая система?
Поисковая система — это система, которая получает текстовый ввод, поисковый запрос от пользователя, и возвращает релевантный контент за несколько секунд или меньше. Основные компоненты поисковой системы:
- Краулер (crawler), который извлекает контент и создает документы.
- Индексатор (indexer), который создает поисковый индекс.
- Поисковик (searcher), который отвечает на поисковые запросы, выполняя поиск в индексе, созданном индексатором.
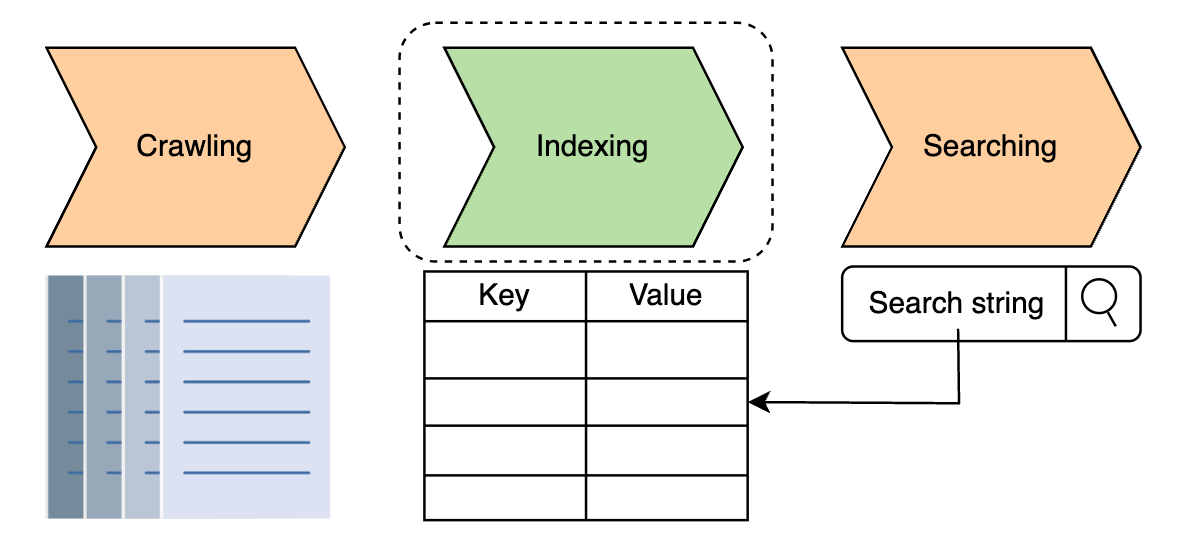
Три фазы поисковой системы
Примечание: У нас есть отдельная глава, посвященная объяснению компонента краулера. В этой главе мы сосредоточимся на индексировании.
Как мы спроектируем распределенную поисковую систему?
Мы разделили проектирование распределенной поисковой системы на пять уроков:
-
Требования: В этом уроке мы перечисляем функциональные и нефункциональные требования к распределенной поисковой системе. Мы также оцениваем ресурсы нашей системы, такие как серверы, хранилище и пропускная способность, необходимые для обслуживания определенного числа запросов.
-
Индексирование: Этот урок дает нам базовые знания о процессе индексирования с помощью примера. После обсуждения индексирования мы также рассмотрим централизованную архитектуру распределенных поисковых систем.
-
Начальный дизайн: Этот урок состоит из высокоуровневого дизайна нашей системы, её API и деталей процесса индексирования и поиска.
-
Окончательный дизайн: В этом уроке мы оцениваем наш предыдущий дизайн и улучшаем его, чтобы сделать более масштабируемым.
-
Оценка: В этом уроке объясняется, как спроектированная нами распределенная поисковая система выполняет свои требования.
Давайте начнем с понимания требований к проектированию распределенной поисковой системы.
Requirements of a Distributed Search System's Design
Требования
Давайте разберемся в функциональных и нефункциональных требованиях к распределенной поисковой системе.
Функциональные требования
Основное функциональное требование к распределенной поисковой системе:
- Поиск: Пользователи должны получать релевантный контент на основе своих поисковых запросов.
Нефункциональные требования
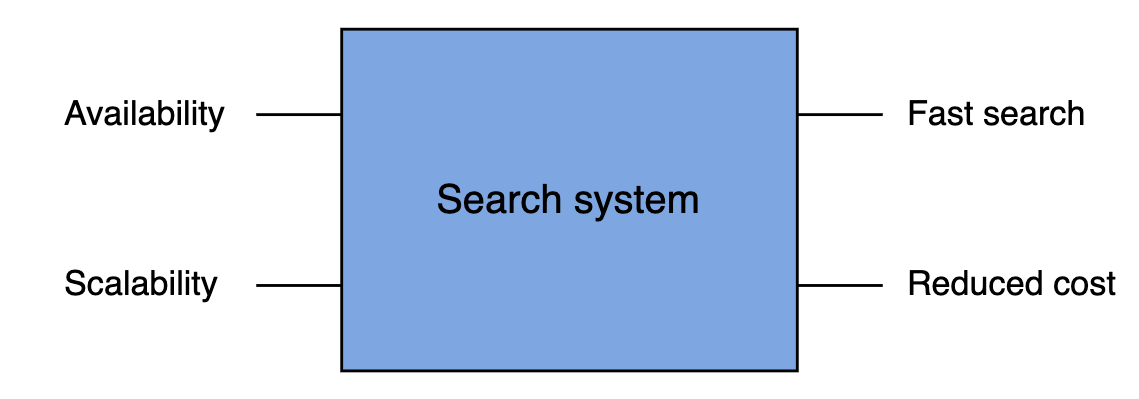
Вот основные нефункциональные требования к распределенной поисковой системе:
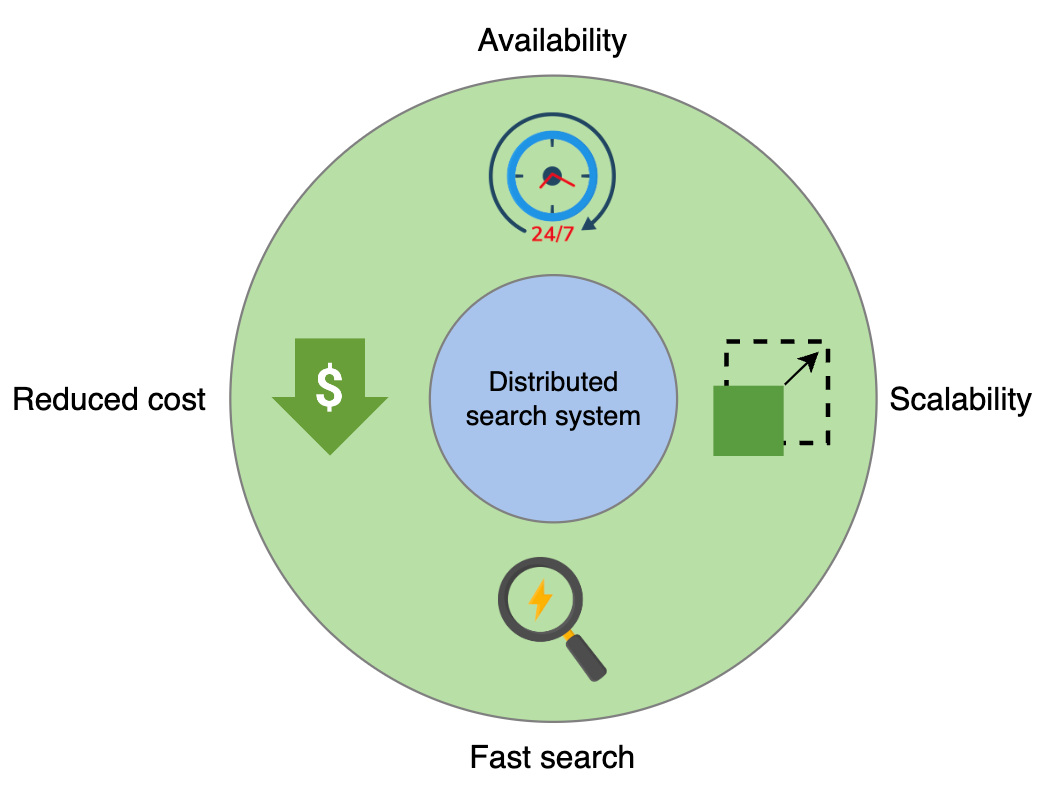
- Доступность: Система должна быть высокодоступной для пользователей.
- Масштабируемость: Система должна иметь возможность масштабироваться с увеличением объема данных. Иными словами, она должна быть способна индексировать большое количество данных.
- Быстрый поиск по большим данным: Пользователь должен получать результаты поиска быстро, независимо от объема контента, который они ищут.
- Снижение затрат: Общая стоимость создания поисковой системы должна быть минимальной.
Оценка ресурсов
Давайте оценим общее количество серверов, объем хранилища и пропускную способность, необходимые для распределенной поисковой системы. Мы будем рассчитывать эти числа, используя пример поиска на YouTube.
Оценка количества серверов
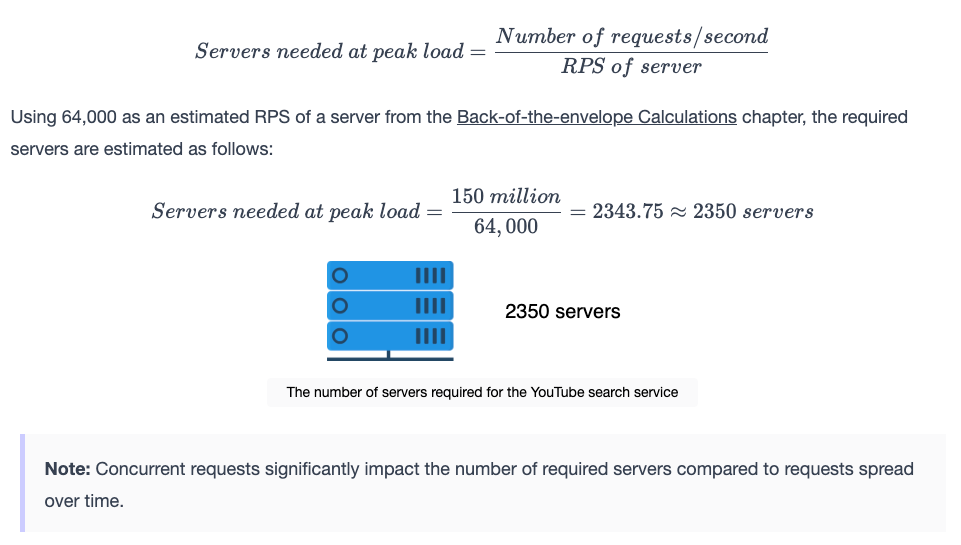
Чтобы оценить количество серверов, нам нужно знать количество активных пользователей YouTube, использующих функцию поиска ежедневно. Предположим, у нас есть 150 миллионов активных пользователей YouTube, которые используют функцию поиска. Исходя из нашего предположения о том, что количество активных пользователей может служить прокси для числа запросов в секунду, чтобы определить количество серверов для пиковых нагрузок, мы получаем 150 миллионов запросов в секунду. Затем мы используем следующую формулу для расчета количества серверов:
Оценка хранилища
Метаданные каждого видео хранятся в отдельном JSON-документе. Каждый документ уникально идентифицируется по ID видео. Эти метаданные включают заголовок видео, его описание, название канала и транскрипт. Предположим следующие значения для оценки объема хранилища, необходимого для индексации одного видео:
- Размер одного JSON-документа: 200 КБ.
- Количество уникальных терминов или ключей, извлеченных из одного JSON-документа: 1000.
- Объем места, необходимого для добавления одного термина в индексную таблицу: 100 байт.
Для расчета объема хранилища, необходимого для индексации одного видео, используется следующая формула:
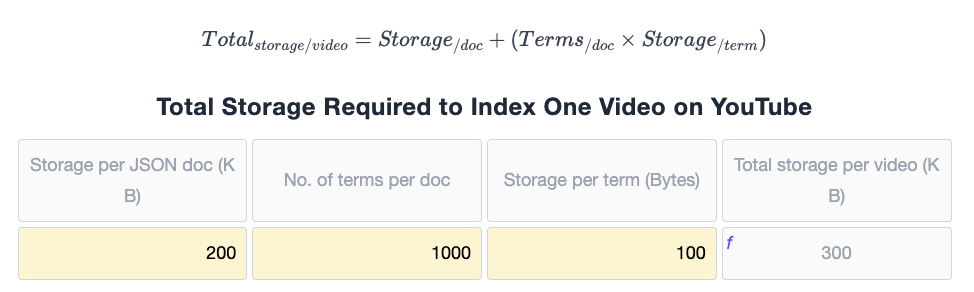 В таблице выше мы рассчитали объем хранилища, необходимый для индексации одного видео. Мы уже видели, что общий объем хранилища на одно видео составляет 300 КБ. Предположим, что среднее количество видео, загружаемых на YouTube ежедневно, составляет 6000. Давайте рассчитаем общий объем хранилища, необходимый для индексации видео, загруженных за один день. Для расчета объема хранилища, необходимого для индексации видео, загруженных на YouTube за один день, используется следующая формула:
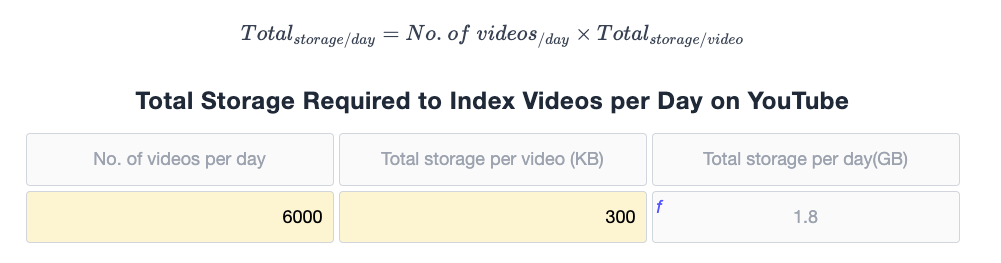
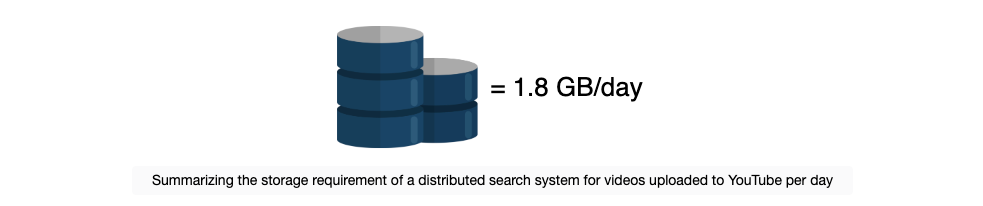
Общий объем хранилища, необходимый для индексации 6000 видео, загружаемых ежедневно на YouTube, составляет 1,8 ГБ. Эта потребность в хранилище является приблизительной оценкой для YouTube. Потребность в хранилище увеличится, если мы предоставим распределенную поисковую систему в качестве услуги для нескольких арендаторов.
Оценка пропускной способности
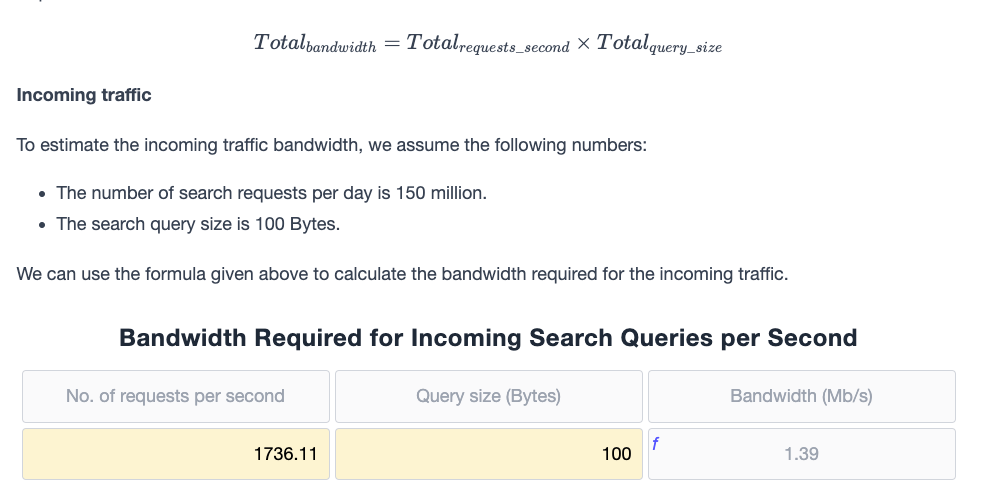
Данные передаются между пользователем и сервером при каждом поисковом запросе. Мы оцениваем необходимую пропускную способность для входящего трафика на сервер и исходящего трафика с сервера. Вот формула для расчета требуемой пропускной способности:
Исходящий трафик
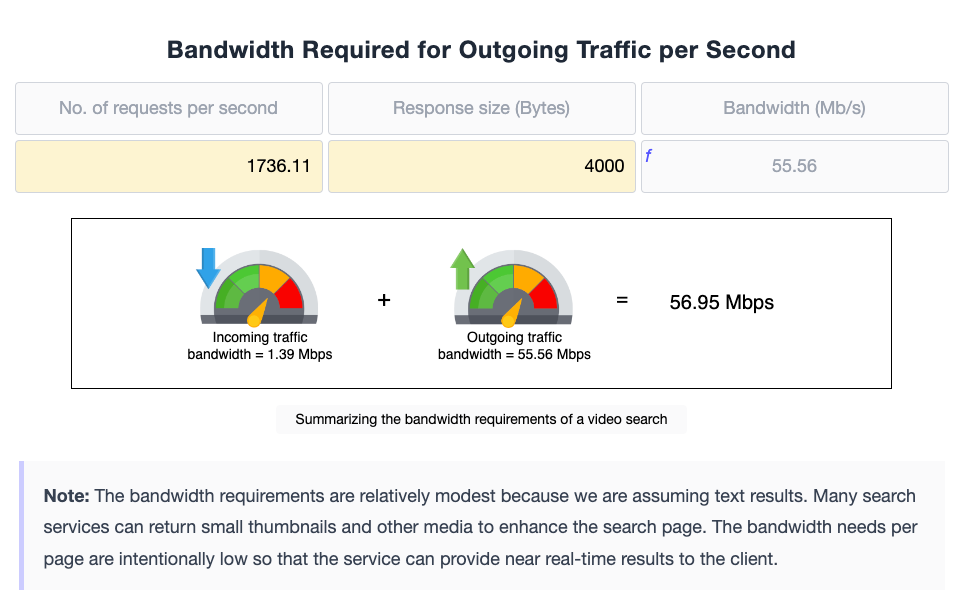
Исходящий трафик — это ответ, который сервер возвращает пользователю на поисковый запрос. Предположим, что количество предложенных видео для одного поискового запроса составляет 80, и размер одного предложения равен 50 байтам. Эти предложения включают упорядоченный список идентификаторов видео.
Для оценки пропускной способности исходящего трафика мы примем следующие значения:
- Количество поисковых запросов в день: 150 миллионов.
- Размер ответа: 4,000 байт.
Мы можем использовать ту же формулу для расчета требуемой пропускной способности для исходящего трафика.
Indexing in a Distributed Search
Сначала мы опишем, что такое индексирование, а затем перейдём к распределению индексов на множество узлов.
Индексирование
Индексирование — это организация и манипуляция данными, которые выполняются для облегчения быстрого и точного поиска информации.
Создание поискового индекса
Самый простой способ создать поисковый индекс — присвоить каждому документу уникальный идентификатор и сохранить его в таблице базы данных, как показано в следующей таблице. Первый столбец таблицы — это идентификатор текста, а второй столбец содержит текст каждого документа.
| ID | Содержимое документа |
|---|---|
| 1 | Elasticsearch — это распределённый аналитический движок, основанный на REST API. |
| 2 | Elasticsearch — это поисковый движок, основанный на библиотеке Lucene. |
| 3 | Elasticsearch — это распределённый поисковый и аналитический движок, построенный на Apache Lucene. |
Размер таблицы, представленной выше, будет зависеть от количества документов и их размера. Таблица выше — это просто пример, и содержимое каждого документа состоит всего из одного или двух предложений. В реальной практике содержимое каждого документа в таблице может быть значительно больше. Это сделает нашу таблицу довольно большой. Выполнение поискового запроса на уровне индекса документа, показанного выше, не является быстрым процессом. При каждом поисковом запросе нам нужно будет просмотреть все документы и подсчитать количество вхождений поисковой строки в каждом документе.
Примечание: Для нечеткого поиска также нужно будет выполнять различные запросы на сопоставление шаблонов. Многие строки в документах могут каким-то образом совпадать с искомой строкой. Сначала нужно найти уникальные строки-кандидаты, просматривая все документы. Затем нужно выделить наиболее приблизительно совпадающую строку из этих строк. Также нужно найти количество вхождений наиболее совпадающей строки в каждом документе. Это означает, что каждый поисковый запрос займет много времени.
Время отклика на поисковый запрос зависит от нескольких факторов:
- Стратегия организации данных в базе данных.
- Размер данных.
- Скорость обработки и оперативная память машины, которая используется для построения индекса и обработки поискового запроса.
Запуск поисковых запросов по миллиардам документов, которые индексируются на уровне документа, будет медленным процессом, который может занять много минут или даже часов. Давайте рассмотрим другой метод организации данных и обработки, который помогает сократить время поиска.
Инвертированный индекс
Инвертированный индекс — это структура данных, подобная хэш-таблице, которая использует матрицу "документ-термин". Вместо хранения полного документа, он разбивает документы на отдельные слова. После этого матрица "документ-термин" определяет уникальные слова и отбрасывает часто встречающиеся слова, такие как «to», «they», «the», «is» и т.д. Часто встречающиеся слова называются терминами. Матрица "документ-термин" поддерживает индекс на уровне терминов через это определение уникальных слов и удаление ненужных терминов.
Для каждого термина индекс вычисляет следующую информацию:
- Список документов, в которых появился термин.
- Частота появления термина в каждом документе.
- Позиция термина в каждом документе.
| Термин | Сопоставление |
|---|---|
| elasticsearch | ([1, 2, 3], [1, 1, 1], [[1], [1], [1]]) |
| distributed | ([1, 3], [1, 1], [[4], [4]]) |
| restful | ([1], [1], [[5]]) |
| search | ([1, 2, 3], [1, 1, 1], [[6], [4], [5]]) |
| analytics | ([1, 3], [1, 1], [[8], [7]]) |
| engine | ([1, 2, 3], [1, 1, 1], [[9], [5], [8]]) |
| heart | ([1], [1], [[12]]) |
| elastic | ([1], [1], [[15]]) |
| stack | ([1], [1], [[16]]) |
| lucene | ([2, 3], [1, 1], [[9], [12]]) |
| library | ([2], [1], [[10]]) |
| Apache | ([3], [1], [[11]]) |
В таблице выше колонка «Термин» содержит все уникальные термины, извлеченные из всех документов. Каждая запись в колонке «Сопоставление» состоит из трех списков:
- Список документов, в которых появился термин.
- Список, который подсчитывает количество вхождений термина в каждом документе.
- Двумерный список, который указывает на позицию термина в каждом документе. Термин может появляться несколько раз в одном документе, поэтому используется двумерный список.
Примечание: Вместо списков, сопоставления могут быть в форме кортежей — таких как doc, freq и loc.
Инвертированный индекс — один из самых популярных механизмов индексации, используемых при поиске документов. Он позволяет эффективно реализовывать булевы и расширенные булевы поисковые алгоритмы, а также алгоритмы близости, релевантности и многие другие.
Преимущества использования инвертированного индекса
- Инвертированный индекс облегчает полнотекстовый поиск.
- Инвертированный индекс сокращает время подсчета вхождений слова в каждом документе на этапе выполнения, так как у нас уже есть сопоставления для каждого термина.
Недостатки использования инвертированного индекса
- Есть накладные расходы на хранение инвертированного индекса вместе с самими документами. Однако это уменьшает время поиска.
- Стоимость обслуживания (обработка) при добавлении, обновлении или удалении документа. Для добавления документа нужно извлечь термины из документа. Затем для каждого извлеченного термина нужно либо добавить новую строку в инвертированный индекс, либо обновить существующую, если этот термин уже имеет запись в инвертированном индексе. Аналогично, при удалении документа требуется обработка для поиска записей в инвертированном индексе для терминов удаленного документа и обновление инвертированного индекса соответственно.
Поиск в инвертированном индексе
Рассмотрим систему, у которой есть следующие сопоставления при поиске слов «search engine»:
| Термин | Сопоставление |
|---|---|
| search | ([1, 2, 3], [1, 1, 1], [[6], [4], [5]]) |
| engine | ([1, 2, 3], [1, 1, 1], [[9], [5], [8]]) |
Оба этих слова найдены в документах 1, 2 и 3. Оба слова появляются по одному разу в каждом документе.
Слово «search» находится на позиции 6 в документе 1, на позиции 4 в документе 2 и на позиции 5 в документе 3.
Слово «engine» находится на позиции 9 в документе 1, на позиции 5 в документе 2 и на позиции 8 в документе 3.
Один термин может появляться в миллионах документов. Таким образом, список документов, возвращаемый против поискового запроса, может быть очень длинным.
Would this technique work when too many documents are found against a single term?
Details
It probably wouldn’t work to return all the documents that are found. Instead, we should sort them based on the relevance to the search query. The top results should be returned to the user, instead of returning all the documents.
Факторы проектирования индекса
Вот некоторые факторы, которые нужно учитывать при проектировании индекса:
- Размер индекса: Сколько компьютерной памяти и оперативной памяти требуется для хранения индекса. Мы храним индекс в оперативной памяти для поддержки низкой задержки поиска.
- Скорость поиска: Насколько быстро мы можем найти слово в инвертированном индексе.
- Обслуживание индекса: Насколько эффективно можно обновить индекс при добавлении или удалении документа.
- Отказоустойчивость: Насколько критично, чтобы служба оставалась надежной. Здесь следует учитывать такие вопросы, как устранение повреждения индекса, поддержка изоляции неверных данных, работа с неисправным оборудованием, разбиение на разделы и репликация.
- Устойчивость: Насколько устойчива система к попыткам манипулирования ею, например, с использованием схем SEO, поскольку мы возвращаем только несколько релевантных результатов по поисковому запросу.
В свете перечисленных выше факторов проектирования давайте рассмотрим некоторые проблемы, связанные с построением индекса в централизованной системе.
Индексация в централизованной системе
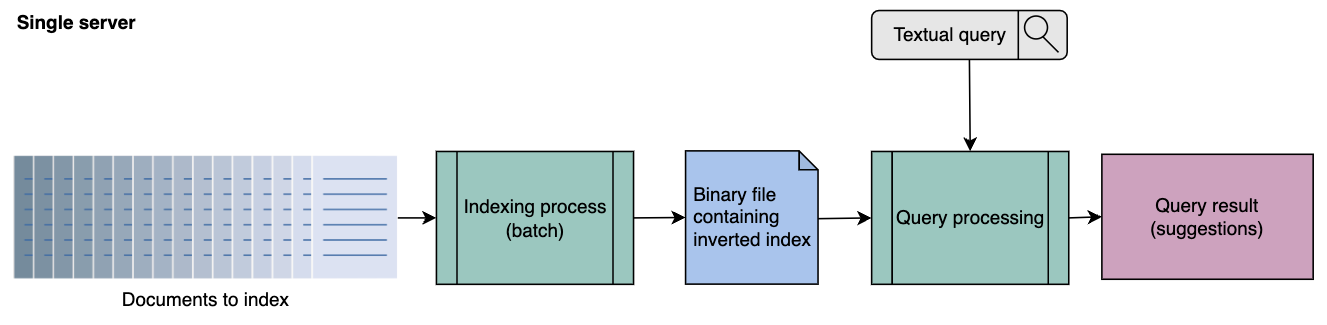
В централизованной поисковой системе все компоненты поисковой системы работают на одном узле, который обладает высокой вычислительной мощностью. Архитектура централизованной поисковой системы показана на следующей иллюстрации:
Индексационный процесс принимает документы в качестве входных данных и преобразует их в инвертированный индекс, который хранится в виде бинарного файла. Процесс обработки запросов или поиска интерпретирует бинарный файл, содержащий инвертированный индекс. Он также вычисляет пересечение инвертированных списков для данного запроса, чтобы вернуть результаты поиска по запросу. Это проблемы, которые возникают с архитектурой централизованной поисковой системы:
- Единая точка отказа (SPOF)
- Перегрузка сервера
- Большой размер индекса
Единая точка отказа (SPOF): Централизованная система представляет собой единую точку отказа. Если она выйдет из строя, никакая поисковая операция не может быть выполнена.
Перегрузка сервера: Если множество пользователей выполняют запросы, и запросы сложные, это создает нагрузку на сервер (узел).
Большой размер индекса: Размер инвертированного индекса увеличивается с количеством документов, что создает нагрузку на ресурсы одного сервера. Чем больше вычислительная система, тем выше стоимость и сложность ее управления.
Примечание: В распределенной системе используются недорогие вычислительные системы, что более экономично в целом.
Инвертированный индекс должен быть загружен в оперативную память при добавлении документа или выполнении поискового запроса. Значительная часть инвертированного индекса должна помещаться в оперативную память машины для повышения эффективности.
Согласно Google Analytics за 2022 год, существует сотни миллиардов веб-страниц, общий размер которых составляет около 100 петабайт. Если мы создадим поисковую систему для всемирной паутины, размер инвертированного индекса также будет составлять петабайты. Это означает, что нам придется загружать петабайты данных в оперативную память. Это непрактично и неэффективно увеличивать ресурсы одной машины для индексации миллиардов страниц вместо перехода на распределенную систему и использования мощности параллелизации. Запуск поискового запроса на одном большом инвертированном индексе приводит к медленному времени отклика.
Примечание: Искать книгу на полке, где находится сто книг, легче, чем на полке, где миллион книг. Время поиска увеличивается с объемом данных, из которых мы ищем.
Атаки на централизованную индексацию могут иметь более значительное влияние, чем атаки на распределенную систему индексации. Более того, вероятность узких мест (которые могут возникнуть в пропускной способности сервера или оперативной памяти) также ниже в распределенной системе индексации.
В этом уроке мы узнали об индексировании и рассмотрели проблемы индексирования в централизованной системе. В следующем уроке представлено решение для распределенного индексирования.
Design of a Distributed Search
Высокоуровневый дизайн
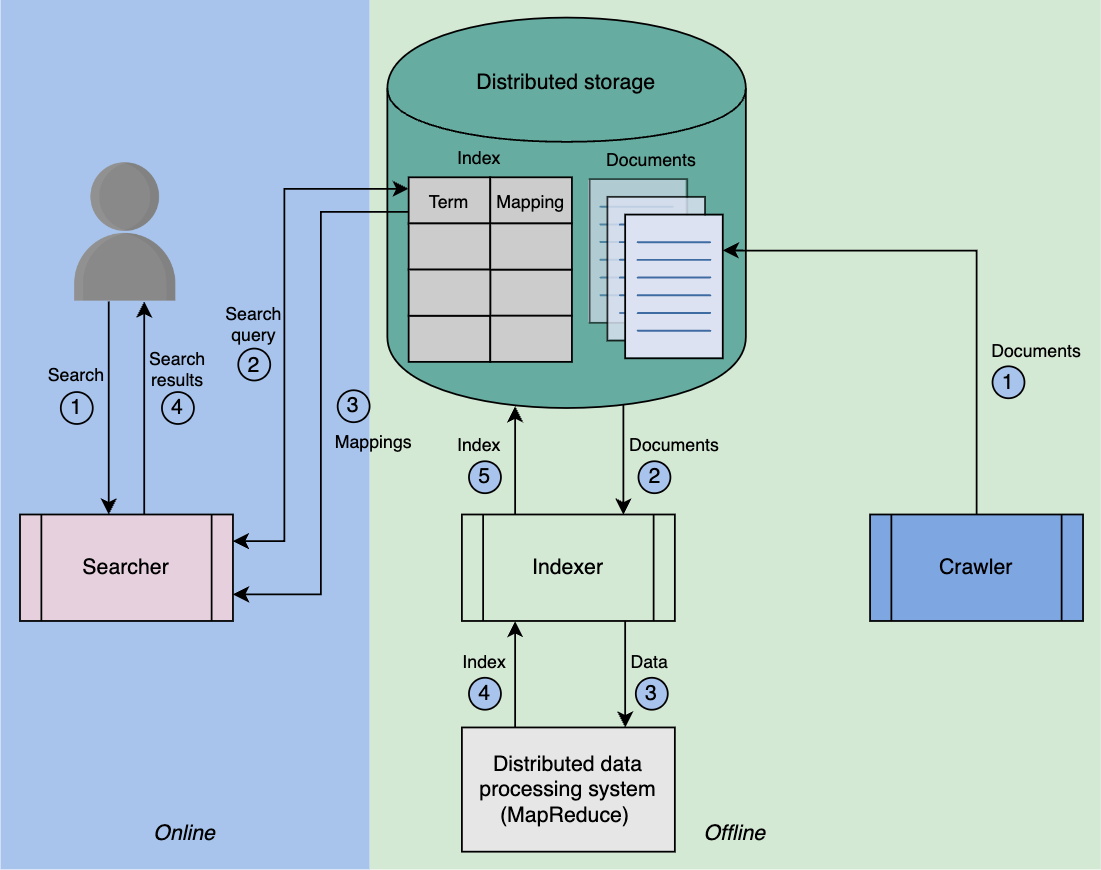
Давайте создадим общую структуру распределенной поисковой системы перед тем, как погрузиться в подробности. Такая система состоит из двух фаз, как показано на иллюстрации ниже. В оффлайн-фазе выполняется сбор данных и индексирование, в которых пользователь не участвует. В онлайн-фазе осуществляется поиск результатов по запросу пользователя.
-
Сбор данных: Краулер собирает контент из заданного ресурса. Например, если мы создаем поисковую систему для YouTube, краулер будет обходить все видео на YouTube и извлекать текстовый контент для каждого видео. Этот контент может включать название видео, его описание, имя канала или даже аннотации видео, чтобы обеспечить умный поиск не только по названию и описанию, но и по содержимому видео. Краулер форматирует извлеченный контент для каждого видео в JSON-документ и сохраняет эти документы в распределенном хранилище.
-
Индексирование: Индексатор извлекает документы из распределенного хранилища и индексирует их, используя MapReduce, который работает на распределенном кластере машин. Индексатор использует распределенную систему обработки данных, такую как MapReduce, для параллельного и распределенного построения индекса. Полученная таблица индексов сохраняется в распределенном хранилище.
-
Распределенное хранилище: Используется для хранения документов и индексов.
-
Поиск: Пользователь вводит поисковую строку, содержащую несколько слов, в поисковую строку.
-
Поисковик: Поисковик разбирает поисковую строку, ищет соответствия в индексе, хранящемся в распределенном хранилище, и возвращает наиболее подходящие результаты пользователю. Поисковик также умно сопоставляет неправильно написанные слова в поисковой строке с ближайшими словами из словаря и ранжирует документы, которые содержат все слова запроса.
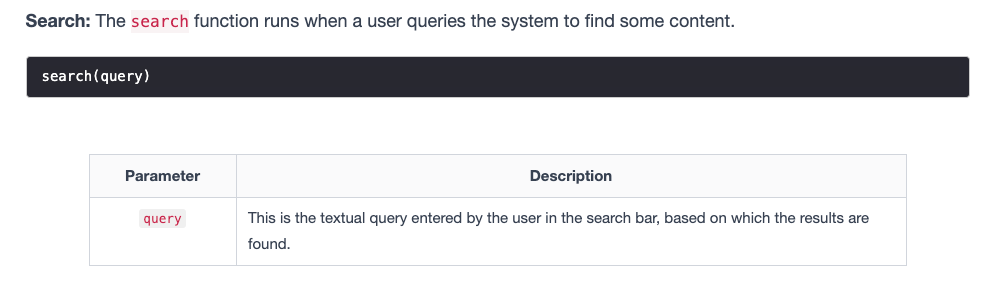
API-дизайн
Поскольку пользователь отправляет запросы только в виде строки, дизайн API довольно прост.
Подробное обсуждение
Поскольку индексатор является основным компонентом поисковой системы, в предыдущем уроке мы обсудили технику индексирования и проблемы, связанные с централизованным индексированием. В этом уроке мы рассмотрим распределенное решение для индексирования и поиска.
Распределенное индексирование и поиск
Рассмотрим, как можно разработать распределенную систему индексирования и поиска. Понимая, что на вход системы индексирования поступают документы, созданные в процессе сбора данных, для построения индекса в распределенной манере мы используем большое количество недорогих машин (узлов) и разделяем или делим документы в зависимости от имеющихся у них ресурсов. Все узлы соединены друг с другом. Группа узлов называется кластером.
Для выполнения распределенного индексирования машины в кластере обычно имеют двухпроцессорные x86 процессоры под управлением Linux, с 2–4 ГБ памяти на каждую машину. Нет необходимости, чтобы все машины имели одинаковые спецификации, хотя они должны быть относительно сопоставимы. MapReduce достаточно умен, чтобы дать больше работы более мощным машинам.
Мы используем множество маломощных узлов для индексирования, чтобы добиться экономии затрат. Этот процесс требует от нас разделения или разбиения входных данных (документов) между этими узлами. Однако необходимо решить ключевой вопрос: как мы будем выполнять это разделение?
Существуют две основные техники, используемые для разбиения данных при распределенном индексировании:
-
Разделение по документам: При разделении по документам все документы, собранные веб-краулером, разбиваются на подмножества документов. Каждый узел затем выполняет индексирование на подмножестве документов, назначенных ему.
-
Разделение по терминам: Словарь всех терминов делится на подмножества, каждое из которых размещается на одном узле. Например, подмножество документов обрабатывается и индексируется узлом, содержащим термин «поиск».
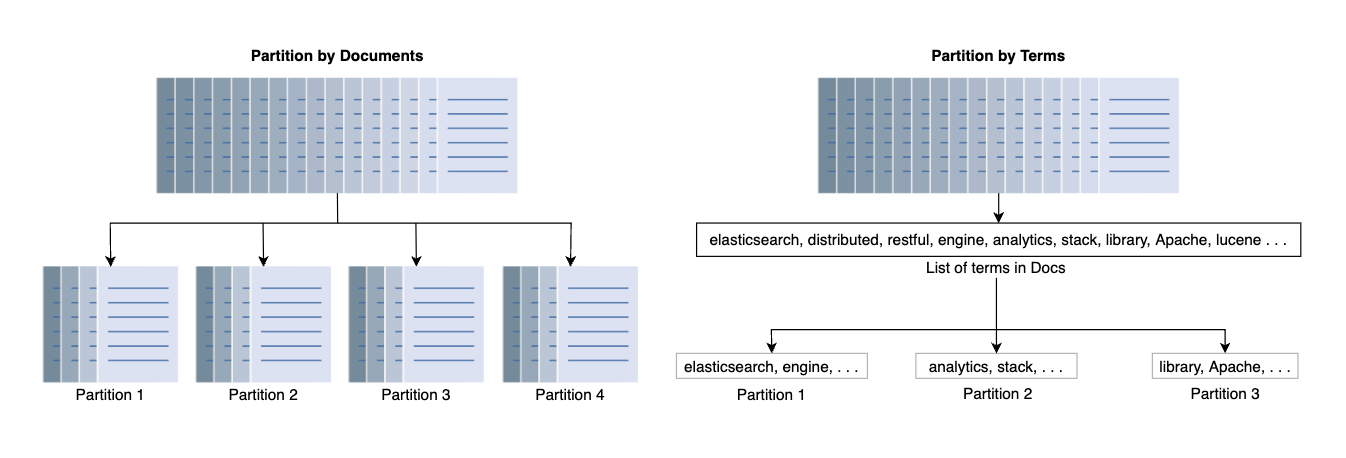
При разделении по терминам поисковый запрос отправляется узлам, соответствующим терминам запроса. Это обеспечивает большую параллельность, так как поток поисковых запросов с различными терминами будет обслуживаться разными узлами. Однако на практике разделение по терминам оказывается сложной задачей. Многословные запросы требуют отправки длинных списков соответствий между группами узлов для слияния, что может быть более затратным, чем выгоды от увеличения параллелизма.
При разделении по документам каждый запрос распределяется по всем узлам, а результаты от этих узлов объединяются перед отображением пользователю. Этот метод разбиения требует меньшей межузловой коммуникации. В нашем дизайне мы используем разбиение по документам.
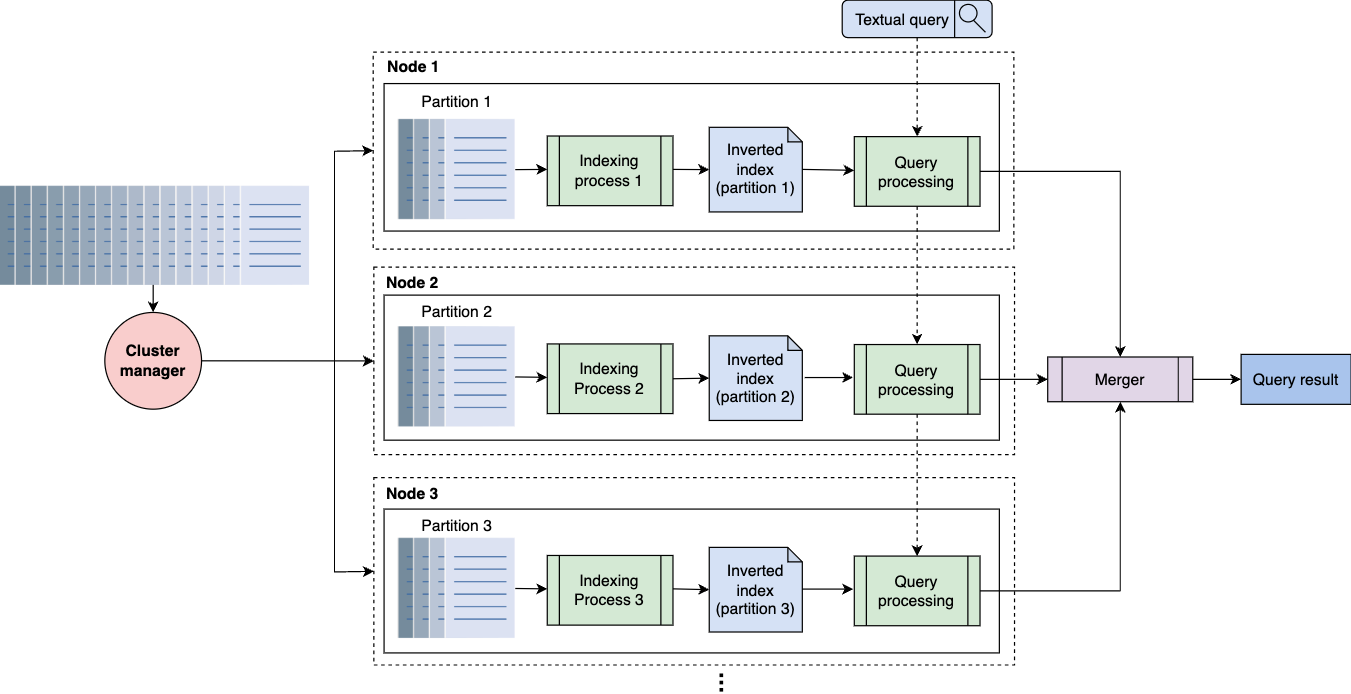
После разбиения по документам рассмотрим распределенный дизайн для построения индекса и выполнения запросов, который показан на иллюстрации ниже. Мы используем кластер, состоящий из нескольких недорогих узлов и менеджера кластера. Менеджер кластера использует модель программирования MapReduce для параллелизации вычисления индекса на каждом разделе. MapReduce может работать с существенно большими наборами данных, которые сложно обрабатывать на одном большом сервере.
Индексирование
- У нас есть набор документов, уже собранных краулером.
- Менеджер кластера разбивает входной набор документов на N частей, где N равно трем на приведенной выше иллюстрации. Размер каждой части определяется менеджером кластера с учетом размера данных, вычислительных возможностей, ограничений по памяти и числа узлов в кластере. Не все узлы могут быть доступны по различным причинам. Менеджер кластера следит за состоянием каждого узла через периодические сигналы heartbeat. Для назначения документа одному из N разделов можно использовать хэш-функцию.
- После разбиения на разделы менеджер кластера запускает алгоритмы индексирования для всех N разделов одновременно на N узлах в кластере. Каждый процесс индексирования производит небольшой инвертированный индекс, который хранится в локальном хранилище узла. Таким образом, мы получаем N небольших инвертированных индексов вместо одного большого инвертированного индекса.
Поиск
- В фазе поиска, когда поступает пользовательский запрос, мы запускаем параллельные поиски по каждому небольшому инвертированному индексу, хранящемуся в локальном хранилище узлов, генерируя N запросов.
- Результатом поиска по каждому небольшому инвертированному индексу является список соответствий против запрашиваемого термина (мы предполагаем, что пользовательский запрос состоит из одного слова/термина). Компонент объединения объединяет эти списки соответствий.
- После объединения списков соответствий компонент объединения сортирует список документов из объединенного списка по частоте термина в каждом документе.
- Отсортированный список документов возвращается пользователю в виде результата поиска. Документы отображаются пользователю в порядке возрастания релевантности.
Примечание: Мы спроектировали поисковую систему, в которой использовали распределенную систему и параллелизовали процесс индексирования и поиска. Это помогло нам справиться с большими объемами данных, работая с меньшими разделами документов. Следует отметить, что как поиск, так и индексирование выполняются на одном и том же узле. Мы называем эту концепцию совместным размещением (colocation).
Предлагаемый дизайн работает, и мы можем масштабировать его по всему миру в различных дата-центрах для удобства всех пользователей. Таким образом, мы можем достичь следующих преимуществ:
- Наш дизайн не будет подвержен единой точке отказа (SPOF).
- Задержка для всех пользователей останется минимальной.
- Поддержка и обновления в отдельных дата-центрах станут возможными.
- Масштабируемость (обслуживание большего количества пользователей в секунду) нашей системы улучшится.
Репликация
Мы создаем реплики узлов индексирования, которые создают инвертированные индексы для назначенных разделов. Мы можем отвечать на запросы из нескольких наборов узлов с репликами. Общая концепция проста. Мы продолжаем использовать ту же архитектуру, что и раньше, но вместо одной группы узлов у нас есть R группы узлов для ответа на пользовательские запросы. R — это число реплик. Количество реплик может увеличиваться или уменьшаться в зависимости от числа запросов, и каждая группа узлов имеет все разделы, необходимые для ответа на каждый запрос.
Каждая группа узлов размещена в разных зонах доступности для повышения производительности и доступности системы в случае отказа дата-центра.
Примечание: Необходим компонент балансировки нагрузки, чтобы распределять запросы между различными группами узлов и повторно пытаться в случае ошибки.
Коэффициент репликации и распределение реплик
Как правило, коэффициент репликации равен трем. Коэффициент репликации, равный трем, означает, что три узла хранят один и тот же раздел и создают индекс. Один из трех узлов становится основным узлом, в то время как остальные два являются репликами. Каждый из этих узлов создает индексы в одном и том же порядке, чтобы прийти к одному и тому же состоянию.
Чтобы проиллюстрировать, давайте разделим данные, набор документов, на четыре раздела. Поскольку коэффициент репликации равен трем, один раздел будет размещен на трех узлах. Мы предположим, что существует две зоны доступности (AZ1 и AZ2). В каждой зоне доступности у нас есть два узла. Каждый узел действует как основной узел только для одного раздела (например, узел 1 в AZ1 является основным узлом для раздела P1). Три копии (розовая, синяя и фиолетовая) для одного раздела делятся между двумя зонами AZ, чтобы две копии находились в одной зоне, а третья копия — в другой зоне. Три цвета представляют три реплики каждого раздела.
Пример:
- Первая реплика, представленная розовым цветом, размещена в узле 2 зоны AZ2.
- Вторая реплика, представленная синим цветом, размещена в узле 1 зоны AZ2.
- Третья реплика, представленная фиолетовым цветом, размещена в узле 2 зоны AZ1.
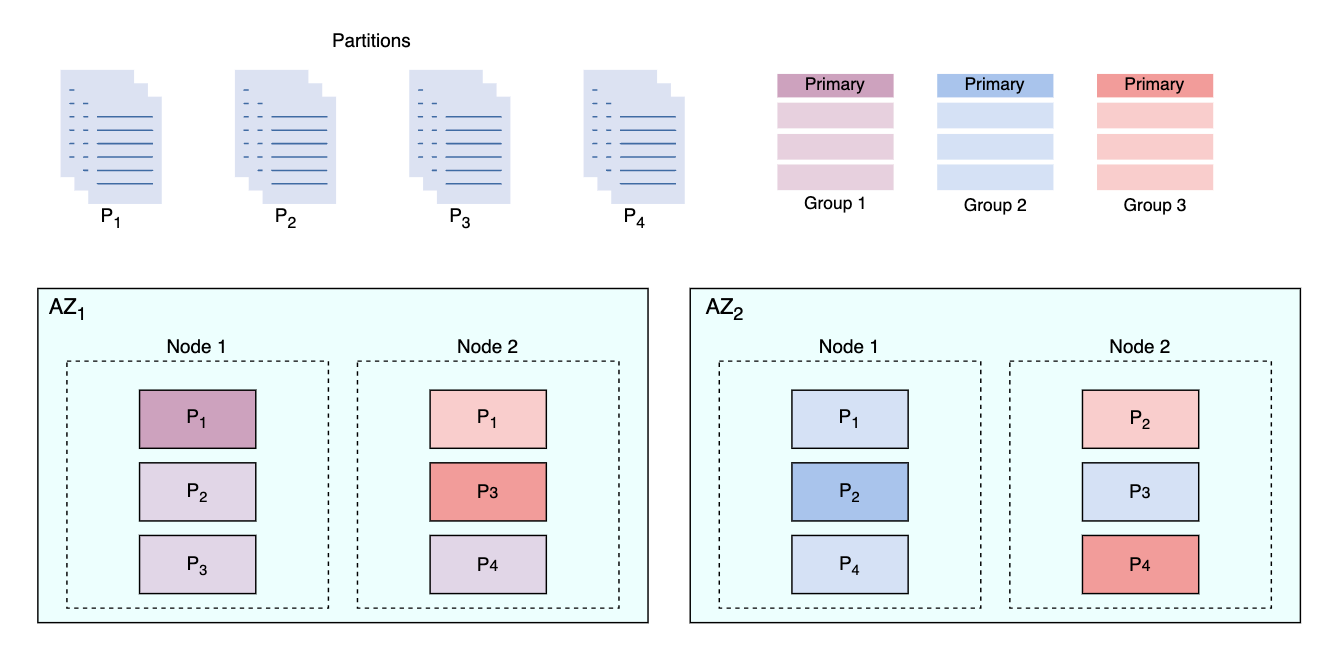
На приведенной выше иллюстрации основная реплика для P1 обозначена темно-фиолетовым цветом, основная реплика для P2 представлена темно-синим цветом, а основные реплики для P3 и P4 обозначены темно-розовым цветом.
Теперь, когда мы завершили репликацию, давайте посмотрим, как выполняются индексирование и поиск в этих репликах.
Индексирование с репликами
На основе диаграммы выше предполагаем, что каждый раздел передается каждой реплике для вычисления индекса. Рассмотрим пример, когда мы хотим проиндексировать раздел P1. Это означает, что один и тот же раздел будет передан всем трем репликам в обеих зонах доступности. Таким образом, каждый узел будет одновременно вычислять индекс и достигать одного и того же состояния.
Преимущество этой стратегии заключается в том, что операция индексирования не пострадает, если основной узел выйдет из строя.
Поиск с репликами
У нас есть три копии каждого раздела индекса. Балансировщик нагрузки выбирает одну из трех копий каждого раздела для выполнения запроса. Увеличенное количество копий улучшает масштабируемость и доступность системы. Теперь система может обрабатывать в три раза больше запросов за то же время.
Резюме
В этом уроке мы узнали, как справляться с большим объемом данных и большим количеством запросов с помощью следующих стратегий:
- Параллельное индексирование и поиск, где оба этих процесса сосредоточены на одном и том же узле.
- Репликация каждого раздела, что означает, что мы также реплицируем процесс индексирования и поиска.
Мы успешно разработали систему, которая масштабируется как с операциями чтения (поиска), так и записи (индексирования), совмещенными на одном узле. Однако этот метод масштабирования влечет за собой некоторые недостатки. Мы рассмотрим эти недостатки и их решения в следующем уроке.
Scaling Search and Indexing
Проблемы предложенного дизайна
Несмотря на то, что предложенный в предыдущем уроке дизайн выглядит разумным, у него есть несколько серьезных недостатков. Рассмотрим их ниже:
-
Совместное размещение индексирования и поиска: Мы создали систему, которая объединяет операции индексирования и поиска на одном узле. Хотя это кажется эффективным использованием ресурсов, у такого подхода есть и свои недостатки. Поиск и индексирование — это ресурсоемкие операции, и они влияют на производительность друг друга. Такой дизайн плохо масштабируется при изменении нагрузки на операции индексирования и поиска. Совместное размещение этих операций на одной машине может привести к дисбалансу и проблемам масштабируемости.
-
Повторное вычисление индекса: Предполагается, что каждая реплика будет вычислять индекс независимо, что приводит к неэффективному использованию ресурсов. Вычисление индекса — это ресурсоемкая задача, состоящая из множества этапов. Поэтому повторное вычисление одного и того же индекса на разных репликах требует мощных машин. Логичнее было бы вычислить индекс один раз и затем реплицировать его в разные зоны доступности.
Из-за этих ключевых причин мы рассмотрим альтернативный подход к распределенному индексированию и поиску.
Решение
Вместо повторного вычисления индекса на каждой реплике, мы будем вычислять инвертированный индекс только на основном узле. Затем мы передаем этот инвертированный индекс (в виде бинарного файла) репликам. Основное преимущество этого подхода заключается в том, что он избегает дублированного использования процессора и памяти для индексирования на репликах.
What are the disadvantages of the above-proposed solution?
Details
Since the inverted index will be transferred to the replicas, this will introduce a transmission latency to copy the inverted index file because the size of the index file can be very large.
When the primary node receives new indexing operations, the inverted index file changes. Each replica needs to fetch the latest version of the file after a certain amount of indexing operations reaches a defined threshold.
Разделение индексирования и поиска
С появлением сетевых технологий и технологий виртуализации облачные вычисления стали успешной технологией. Мы имеем доступ к огромным объемам пропускной способности (до 100 Гбит/с) и масштабируемому распределенному хранилищу. Эти достижения позволяют нам эффективно разделить операции индексирования и поиска без негативных последствий для задержки индексирования. Благодаря этой изоляции индексирование не влияет на масштабируемость поиска и наоборот. Также вместо повторного вычисления индекса на узлах-репликах, что тратит ресурсы, мы можем просто реплицировать файлы индекса.
Мы используем эти технологии для создания нового распределенного поискового и индексирующего движка. В этой системе задействованы три компонента:
- Индексатор: Группа узлов для вычисления индекса.
- Распределенное хранилище: Хранилище для хранения разделов и вычисленных индексов.
- Поисковик: Группа узлов для выполнения поисковых запросов.
Ниже представлена иллюстрация создания и передачи инвертированного индекса между узлом индексирования и узлом поиска:
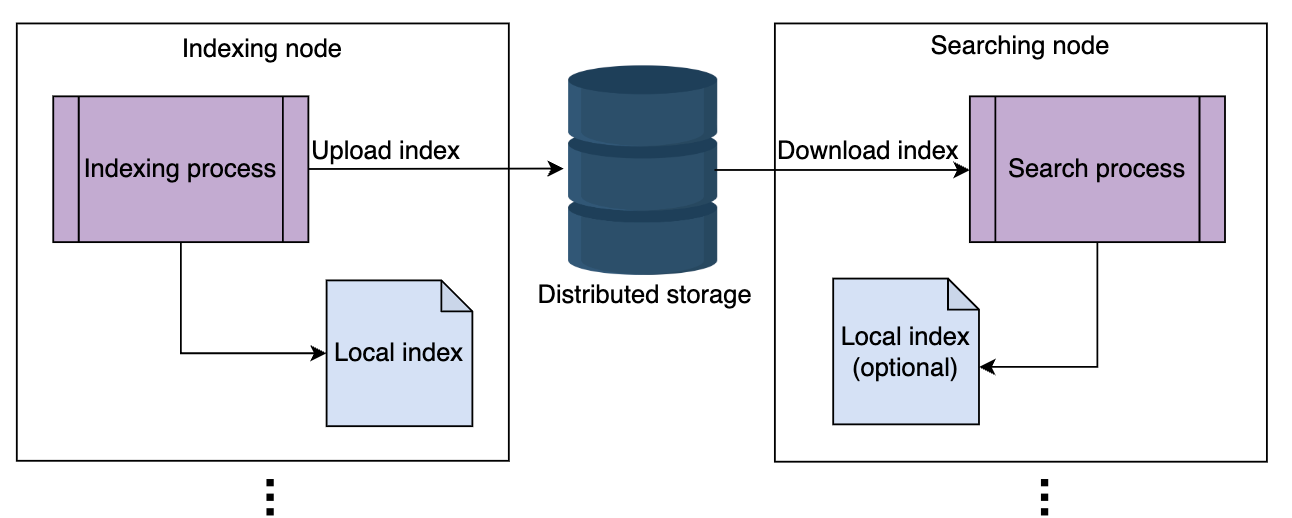
На приведенной выше иллюстрации показан один узел для каждой операции индексирования и поиска. В реальности, для каждой фазы индексирования будет задействовано N узлов, по одному узлу на каждый раздел документов, которые создают инвертированные индексы. Инвертированный индекс хранится в виде бинарных файлов в локальном хранилище узлов. Кэширование этих бинарных файлов улучшит производительность. Эти бинарные файлы также загружаются в распределенное хранилище. В случае аппаратного сбоя добавляется новая машина поисковика или индексатора, и копия данных извлекается из распределенного хранилища.
Когда загрузка завершена, узлы поисковика загружают файлы индекса. В зависимости от пользовательских запросов узлы поисковика поддерживают кэш часто запрашиваемых запросов и обслуживают данные из оперативной памяти. Пользовательский поисковый запрос будет расширен до всех узлов поисковика, которые создадут ответы в соответствии со своими индексами. Узел слияния на передовых серверах объединит все результаты поиска и представит их пользователю.
Процесс индексирования индексирует новые документы по мере их поступления. В то же время узлы поисковика извлекают обновленные индексы для улучшения результатов поиска.
Индексирование
До сих пор мы объясняли разработку высокомасштабируемого и производительного дизайна с использованием недорогих узлов. Однако мы не обсуждали внутреннюю работу узлов индексирования. В этом разделе мы узнаем, как выполняется индексирование с использованием распределенной модели MapReduce и фреймворка параллельной обработки.
Фреймворк MapReduce реализуется с помощью менеджера кластера и набора рабочих узлов, которые делятся на мапперы и редьюсеры. Как следует из названия, MapReduce состоит из двух фаз:
- Фаза отображения (Map)
- Фаза редукции (Reduce)
Кроме того, входные данные для MapReduce — это наборы документов, а выходные данные — это агрегированный инвертированный индекс.
Основные компоненты:
- Менеджер кластера: Менеджер запускает процесс, назначая наборы документов мапперам. Как только мапперы заканчивают свою работу, менеджер кластера назначает вывод мапперов редьюсерам.
- Мапперы: Этот компонент извлекает и фильтрует термины из назначенных ему разделов документов. Эти машины параллельно создают инвертированные индексы, которые служат входными данными для редьюсеров.
- Редьюсеры: Редьюсер объединяет отображения для различных терминов, чтобы создать итоговый индекс.
Менеджер кластера следит за тем, чтобы все рабочие узлы в кластере были эффективно использованы. MapReduce спроектирован так, чтобы работать при частичных сбоях. Если один узел выходит из строя, работа переназначается на другой узел.
Следует отметить, что редьюсеры не могут начать работу, пока работают мапперы. Это означает, что менеджер кластера может использовать один и тот же узел как маппер, так и редьюсер.
На следующих слайдах показана упрощенная схема использования MapReduce для создания инвертированного индекса:
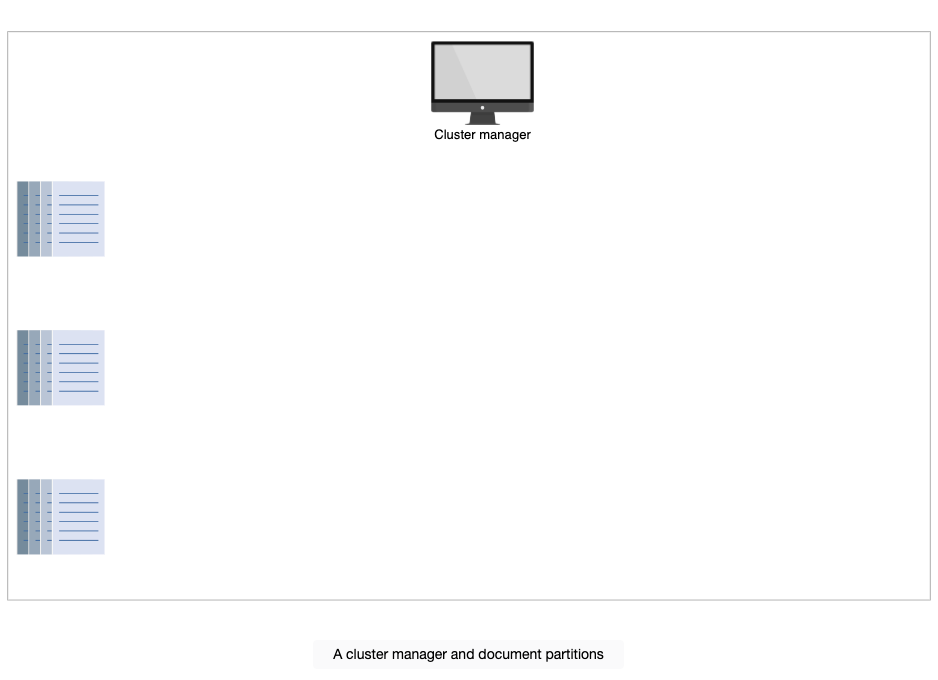
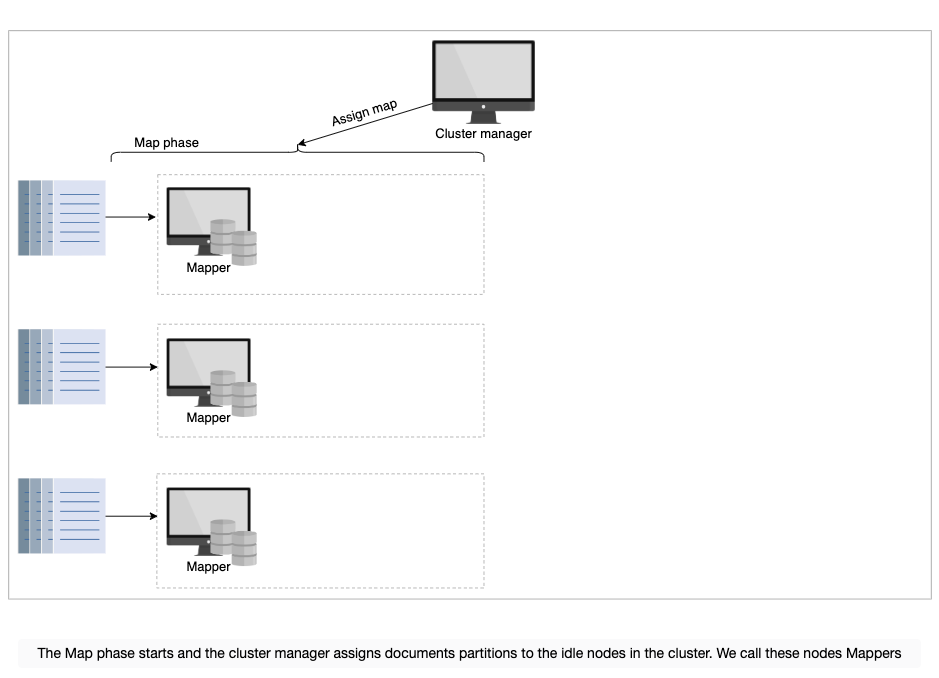
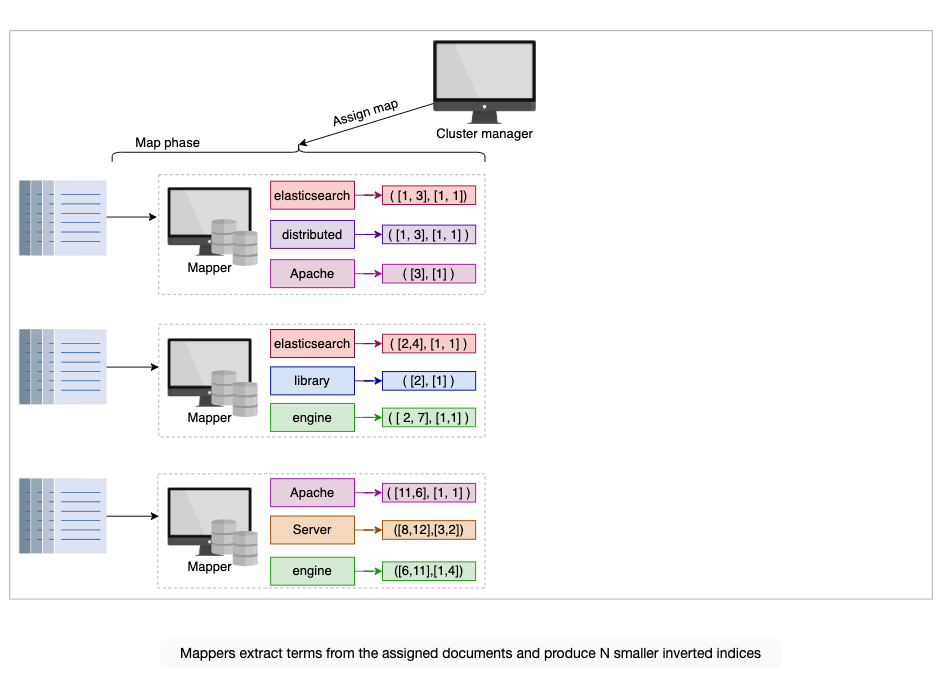
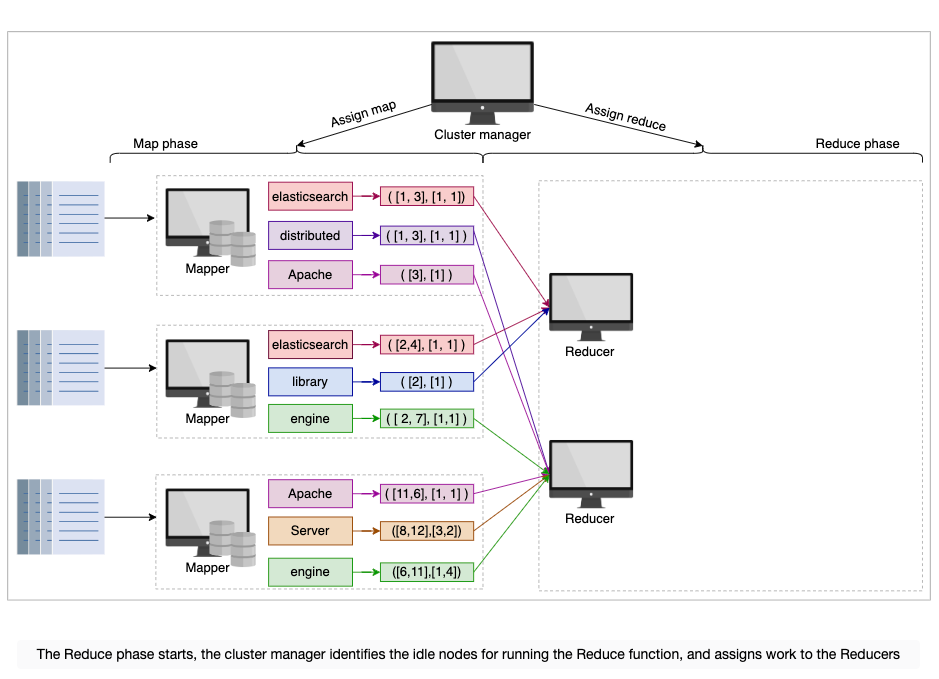
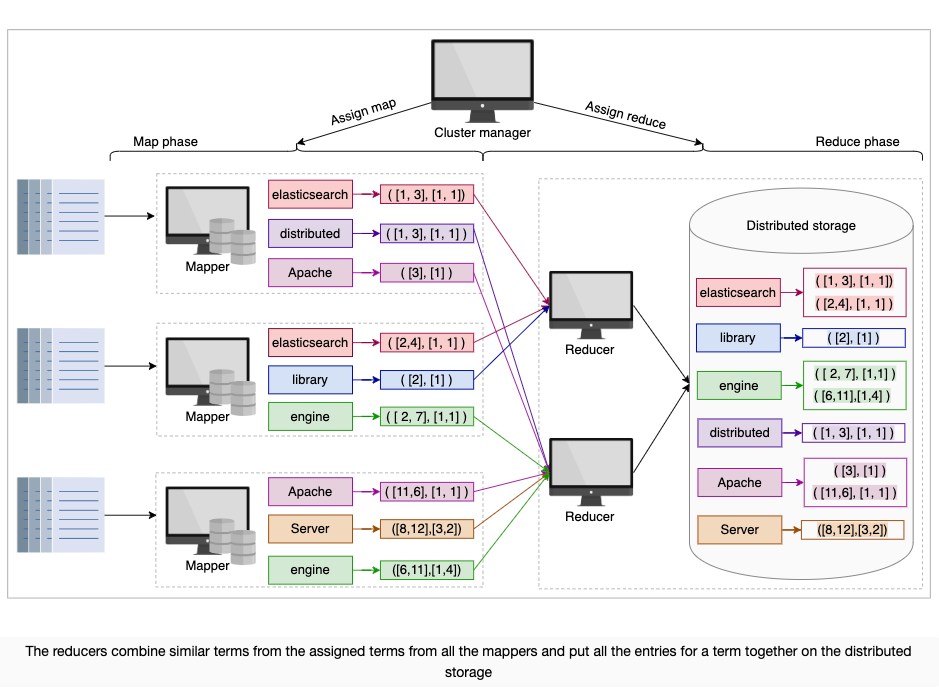
Для простоты на иллюстрации показаны два показателя для каждого термина: список документов, в которых встречается термин, и частота термина в каждом документе (см. раздел "Индексирование" для подробностей).
Примечание: Приведенная выше схема MapReduce — это упрощенная версия того, что происходит на практике. Для управления сложностями реального поискового движка требуется более сложный конвейер MapReduce. Однако основные принципы остаются такими же, как здесь.
Резюме
В этом уроке мы решили две ключевые проблемы масштабируемости (из-за совместного размещения индексирования и поиска) и растраты ресурсов (из-за повторного вычисления индекса) путем использования выделенных узлов для индексирования и поиска. Обе операции полагаются на распределенное хранилище. Кроме того, мы представили упрощенное описание фреймворка MapReduce для параллелизации процесса индексирования.
Evaluation of a Distributed Search's Design
Доступность
Мы использовали распределенное хранилище для хранения следующих элементов:
- Документы, собранные краулером.
- Инвертированные индексы, созданные узлами индексирования.
Данные реплицируются между несколькими регионами в распределенном хранилище, что облегчает развертывание индексирования и поиска в разных регионах. Группы узлов индексирования и поиска просто нужно реплицировать в разных зонах доступности. Таким образом, мы развертываем кластер узлов индексирования и поиска в разных зонах доступности. В случае сбоя в одной зоне, запросы могут быть обработаны другим кластером. Несколько групп узлов индексирования и поиска помогают достичь высокой доступности для этих операций. Более того, в каждом кластере, если узел выходит из строя, его может заменить другой.
Индексирование выполняется в фоновом режиме, вне критического пути пользователя. Нам не нужно синхронно реплицировать операции индексирования. Нет необходимости отвечать на поисковые запросы пользователей с самыми последними данными, только что добавленными в индекс. Поэтому нам не нужно ждать репликации нового индекса, чтобы ответить на поисковые запросы, что обеспечивает доступность поиска для пользователей.
Примечание: Как только мы реплицируем последние данные во все группы узлов индексирования и узлы поиска загружают их, поисковые запросы выполняются на основе последних данных.
Масштабируемость
Разделение данных на части является важным компонентом поисковых систем для масштабирования. Когда мы увеличиваем количество разделов и добавляем больше узлов в кластеры индексирования и поиска, мы можем масштабировать процессы индексирования и выполнения запросов.
Четкое разделение процессов индексирования и поиска помогает масштабировать их независимо и динамично.
You’re a software engineer for a rapidly growing e-commerce site aiming to redefine search with lightning-fast personalized results. Currently, user experience is suffering due to slow search response times, especially during peak loads.
Your task is to:
Identify components of distributed search that can benefit from caching to improve performance.
Identify the potential trade-offs to consider.
To get started, say “hello” to Ed in the widget below, and it will lead the way.
Details
For improving performance in a distributed search system, caching can be significantly beneficial in two main areas:
Query Result Caching: This involves storing the results of frequently requested queries. By doing this, the system can avoid performing the same computations repeatedly for popular queries, which speeds up the response time for these queries.
Partial Index Caching: This strategy caches portions of the index in memory to allow for faster access. It’s particularly useful for parts of the index that are accessed frequently, as it reduces the need to read from disk, which is a slower operation.
The potential trade-offs to consider when implementing caching include:
Resource Consumption: Caches require memory resources, which could be limited. Allocating too much memory to caching can impact other operations that also require memory.
Cache Invalidation: It’s crucial to determine when to invalidate or update cached data to ensure that users are provided with up-to-date information. This process can be complex and needs careful management.
Data Staleness: If the cached data is not updated in a timely manner after the underlying data changes, it can lead to users receiving outdated information. This is particularly critical for dynamic data that changes frequently.
These components and trade-offs are key considerations when designing a distributed search system to improve performance and user experience.
Быстрый поиск по большим данным
Мы использовали множество узлов, каждый из которых выполняет поисковые запросы параллельно на меньших инвертированных индексах. Затем результаты с каждого узла поиска объединяются и возвращаются пользователю.
Снижение затрат
Мы использовали более дешевые машины для вычисления индексов и выполнения поисковых запросов. В случае сбоя одного узла нам не нужно заново вычислять весь индекс. Вместо этого нужно заново проиндексировать только некоторые документы.
Заключение
Поисковая система требуется практически для любого приложения. Мы увидели, что невозможно разработать поисковую систему, которая могла бы работать на одном узле. Мы использовали фреймворк параллельных вычислений и недорогие машины для создания поисковой системы, которая обладает высокой доступностью, масштабируемостью и производительностью.