Help
Таблица переводов
| Величина (бит) | В Битах | В Килобитах (Kb) | В Мегабитах (Mb) | В Гигабитах (Gb) | В Терабитах (Tb) |
|---|---|---|---|---|---|
| 1 бит | 1 | 0,001 Kb | 10^-6 Mb | 10^-9 Gb | 10^-12 Tb |
| 1 Килобит (Kb) | 1_000 бит | 1 | 0,001 Mb | 10^-6 Gb | 10^-9 Tb |
| 1 Мегабит (Mb) | 1_000_000 бит | 1_000 Kb | 1 | 0,001 Gb | 10^-6 Tb |
| 1 Гигабит (Gb) | 10^9 бит | 1_000_000 Kb | 1_000 Mb | 1 | 0,001 Tb |
| 1 Терабит (Tb) | 10^12 бит | 10^9 Kb | 1_000_000 Mb | 1_000 Gb | 1 |
Порядок интервью
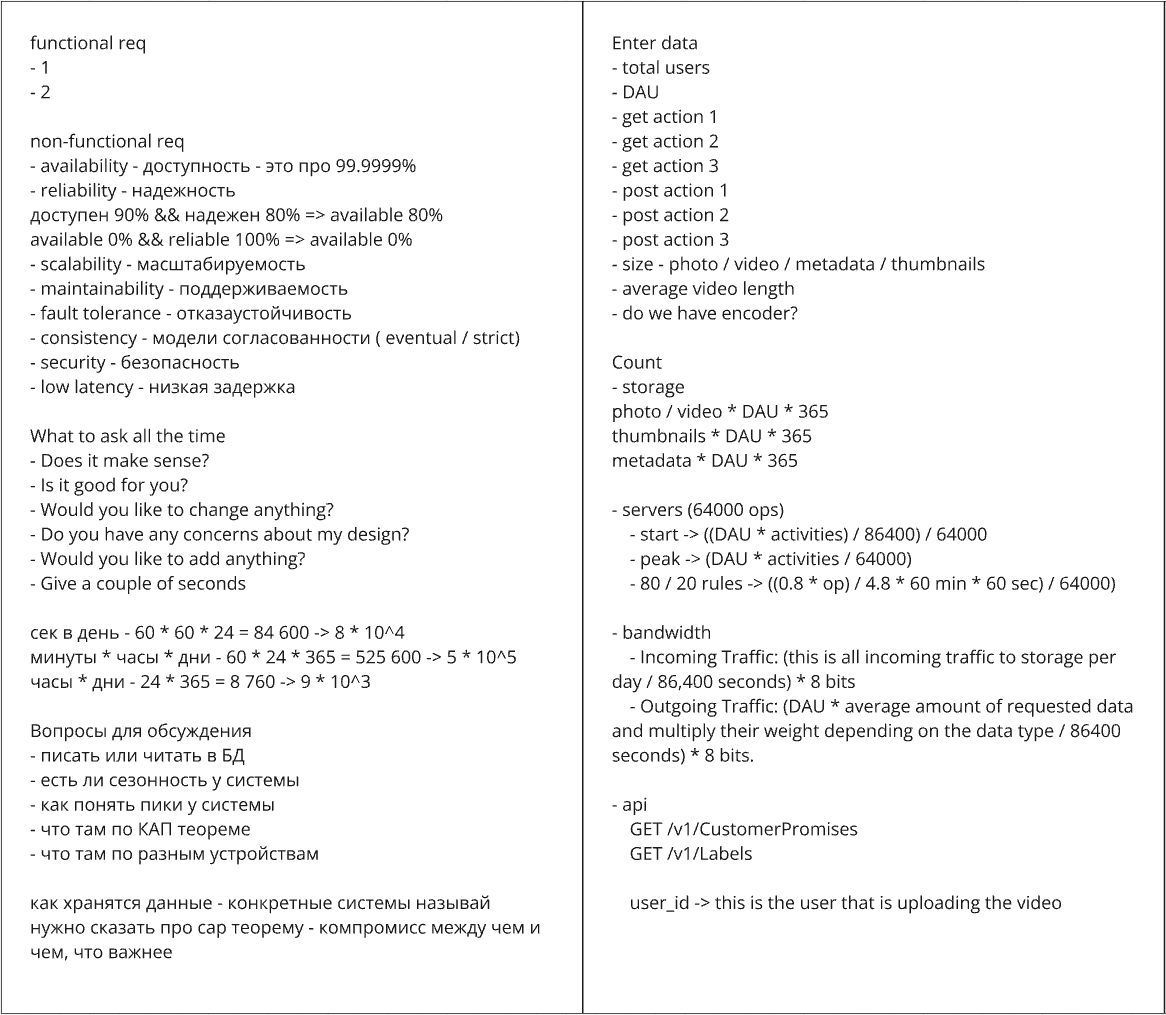
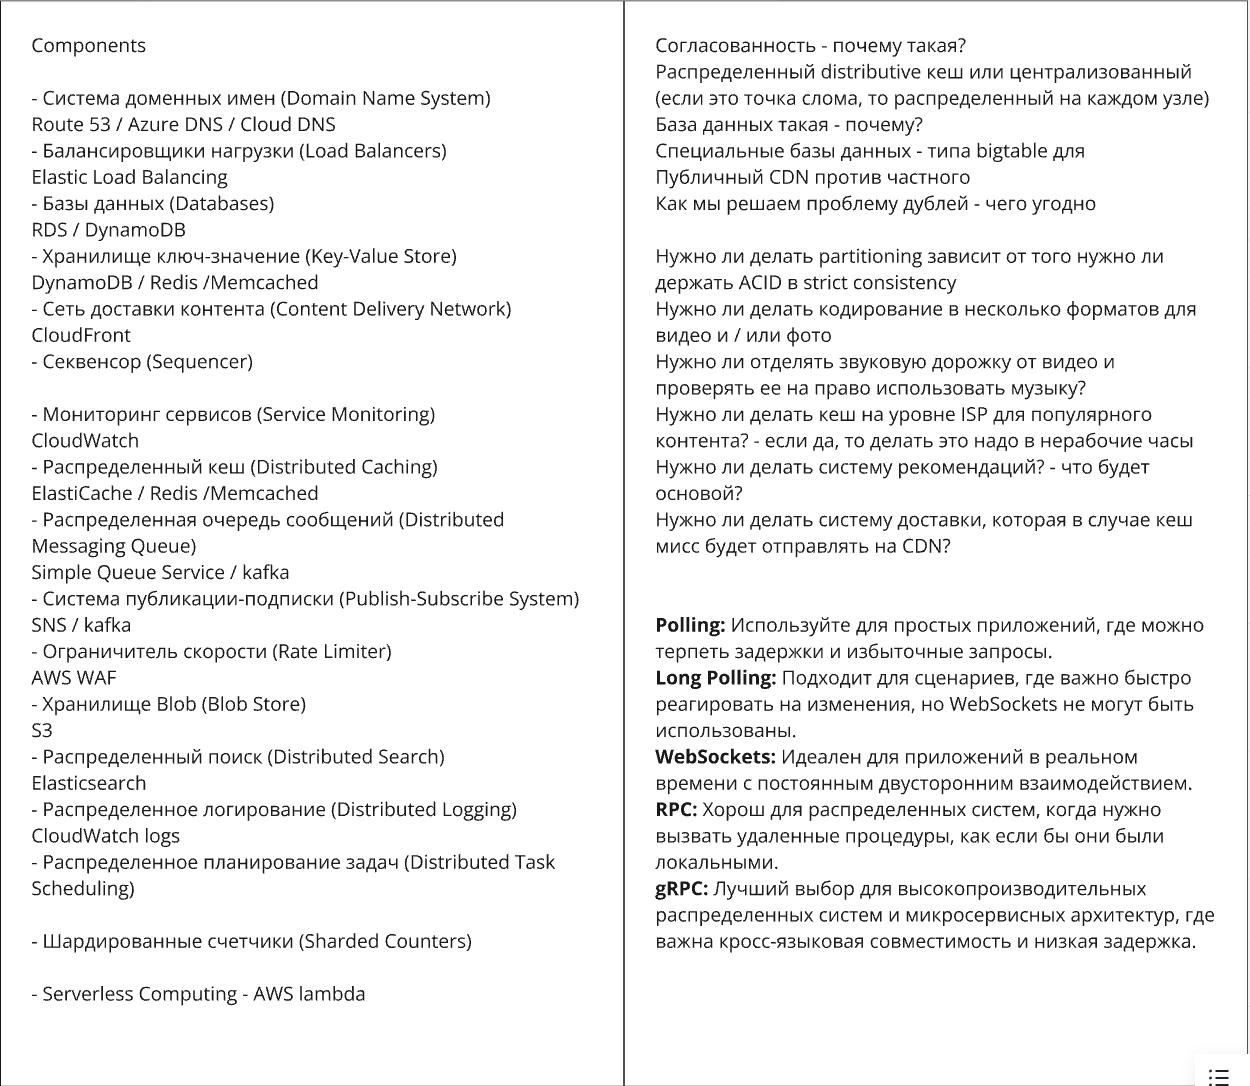
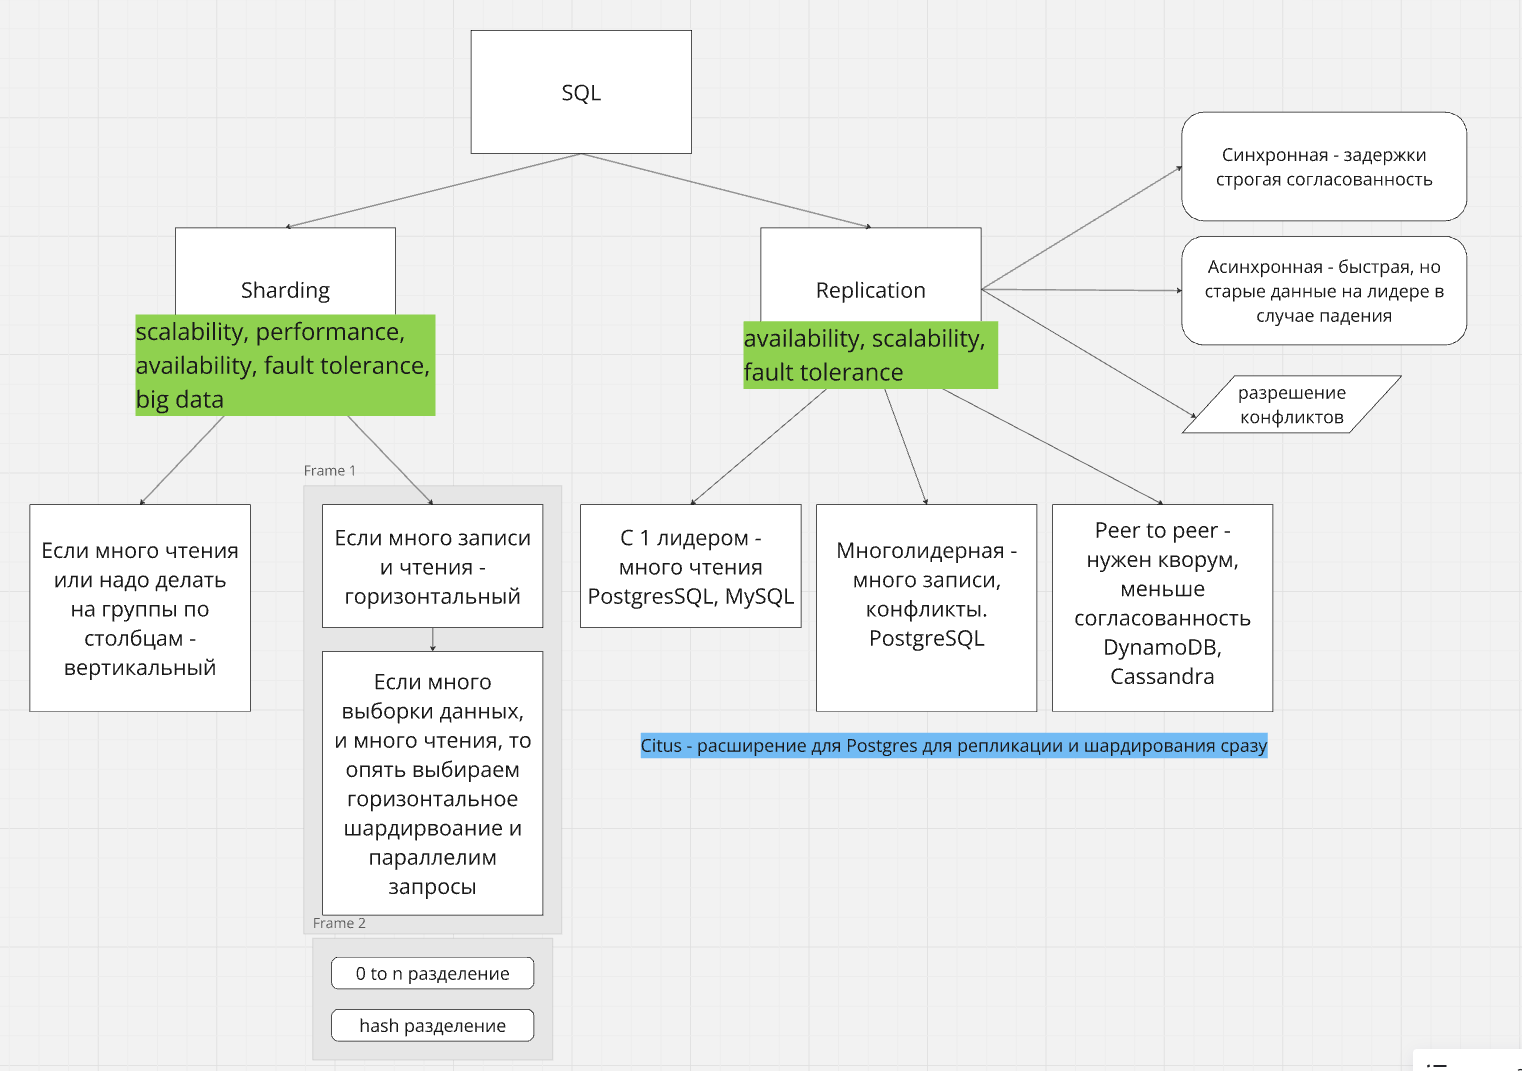
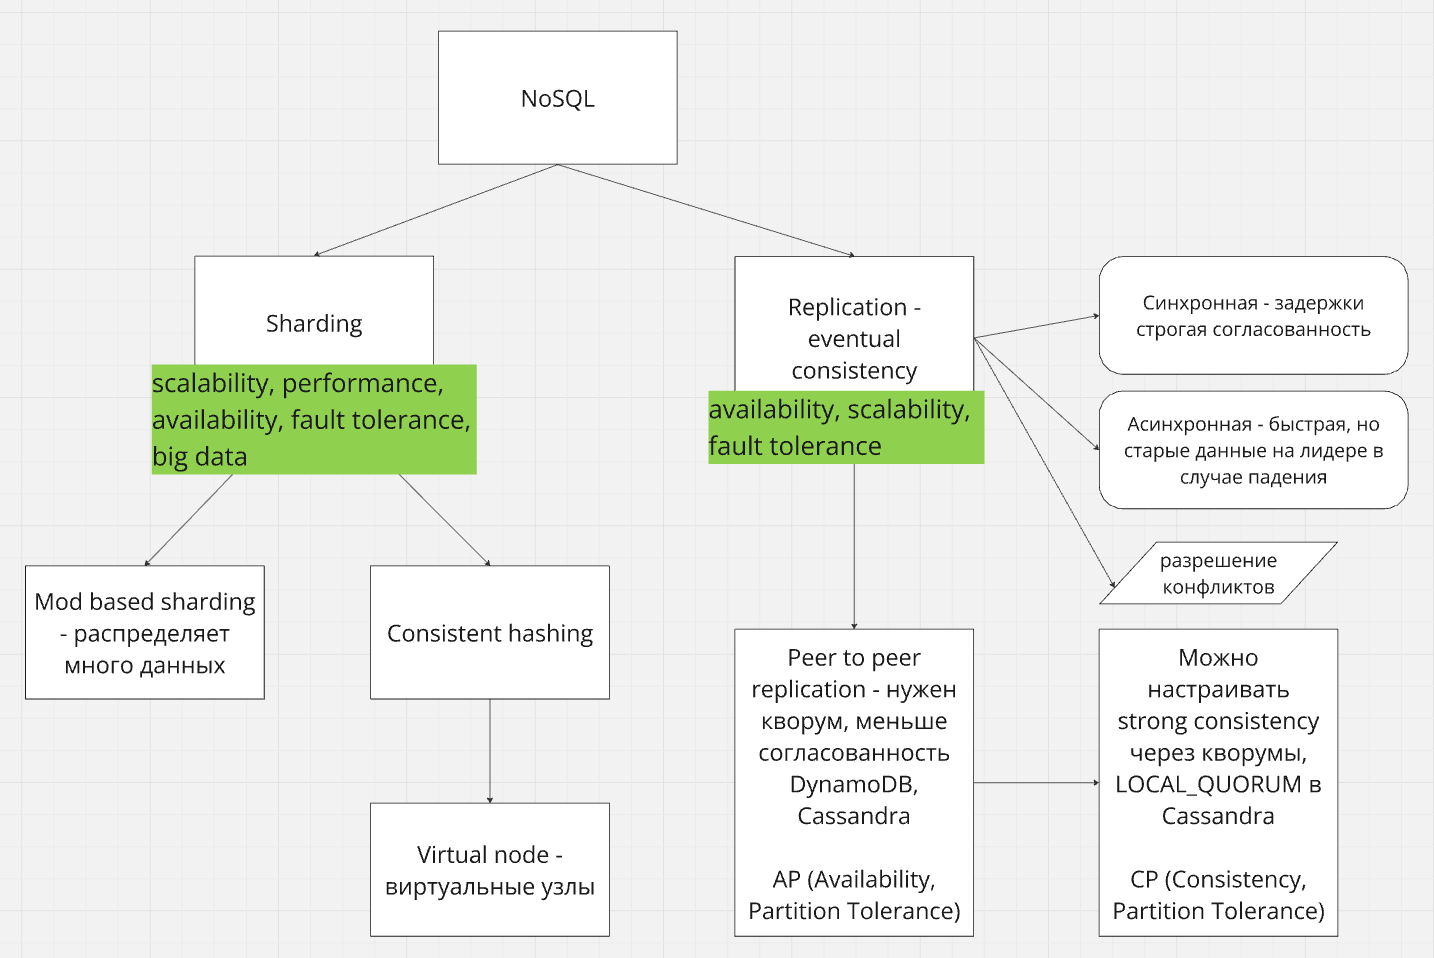
Быстрые схемы для SQL / NoSQL
CAP Theorem
According to the CAP Theorem, a distributed system can only achieve two out of the three properties at the same time, but not all three:
-
Consistency + Availability (CA): If the system is designed to be consistent and available, it must forfeit partition tolerance. This means that in the case of a network partition (a communication breakdown between nodes), the system must either become inconsistent or unavailable.
-
Consistency + Partition Tolerance (CP): In a system that prioritizes consistency and partition tolerance, availability is sacrificed. This means that during a network partition, the system may not be able to respond to some or all requests, thus ensuring data consistency across nodes.
-
Availability + Partition Tolerance (AP): A system that is designed to be available and partition-tolerant must sacrifice consistency. This means that during network partitions, the system will continue to operate but might return outdated or inconsistent data.
Why the CAP Theorem is Important
The CAP Theorem is crucial because it defines the fundamental trade-offs that must be made when designing distributed systems. Understanding these trade-offs allows system architects to make informed decisions based on the specific requirements of their application. For example:
-
In a globally distributed database, achieving high availability and partition tolerance might be critical, even if it means sacrificing some consistency (AP).
-
In financial systems where data consistency is paramount, the system might be designed to tolerate partitions but be less available during such events (CP).
Details
Компромиссы по CAP-теореме
Согласно CAP-теореме, распределенная система может обеспечить только два из трех свойств одновременно, но не все три:
-
Согласованность + Доступность (CA): Если система спроектирована для согласованности и доступности, она должна отказаться от устойчивости к разделению. Это означает, что в случае разделения сети (сбоя связи между узлами) система должна либо стать несогласованной, либо недоступной.
-
Согласованность + Устойчивость к разделению (CP): В системе, ориентированной на согласованность и устойчивость к разделению, жертвуется доступность. Это означает, что во время разделения сети система может не отвечать на некоторые или все запросы, обеспечивая при этом согласованность данных между узлами.
-
Доступность + Устойчивость к разделению (AP): Система, спроектированная для доступности и устойчивости к разделению, жертвует согласованностью. Это означает, что во время разделения сети система продолжит работать, но может возвращать устаревшие или несогласованные данные.
Почему CAP-теорема важна
CAP-теорема важна, потому что она определяет основные компромиссы, которые необходимо учитывать при проектировании распределенных систем. Понимание этих компромиссов позволяет архитекторам систем принимать обоснованные решения на основе конкретных требований их приложения. Например:
-
В глобально распределенной базе данных может быть критически важно обеспечить высокую доступность и устойчивость к разделению, даже если это означает жертвование частью согласованности (AP).
-
В финансовых системах, где согласованность данных имеет первостепенное значение, система может быть спроектирована для устойчивости к разделению, но при этом быть менее доступной во время таких событий (CP).
When to Use SQL vs. NoSQL Databases
Criteria for Choosing Between SQL and NoSQL Databases
| Criterion | SQL (Relational) | NoSQL (Non-Relational) |
|---|---|---|
| Data Structure | Structured data with predefined schema (tables, rows, columns) | Flexible, unstructured, or semi-structured data (JSON, XML) |
| Schema Flexibility | Rigid, requires upfront schema design; changes are complex | Dynamic, schema-less or schema-on-read; easier to change |
| Transaction Support | ACID (Atomicity, Consistency, Isolation, Durability) | BASE (Basically Available, Soft state, Eventually consistent); some NoSQL databases support ACID at a certain level |
| Complex Queries | Supports complex queries, joins, and transactions | Limited support for complex queries and joins |
| Scalability | Vertical scaling (adding more power to a single server) | Horizontal scaling (distributing data across multiple servers) |
| Data Integrity | Strong consistency and integrity due to ACID properties | Eventual consistency; data integrity is less strict |
| Use Cases | Traditional applications, financial systems, ERPs, CRMs | Big data, real-time analytics, content management systems, IoT |
| Examples | MySQL, PostgreSQL, Oracle, SQL Server | MongoDB, Cassandra, Redis, DynamoDB |
| Query Language | SQL (Structured Query Language) | Various, often specific to the database (e.g., MongoDB uses MQL) |
| Data Volume | Generally smaller volumes where relationships between data are important | Large volumes of data, high write throughput |
| Consistency Requirements | Strong consistency, data is consistent immediately after transaction | Eventual consistency, where data will be consistent eventually but not immediately |
| Cost and Maintenance | May require higher costs for hardware due to vertical scaling | Generally more cost-effective for large-scale distributed systems |
| Performance | May be slower with high write/read loads due to ACID compliance | Optimized for high performance and large scale with simpler consistency models |
Key Considerations
-
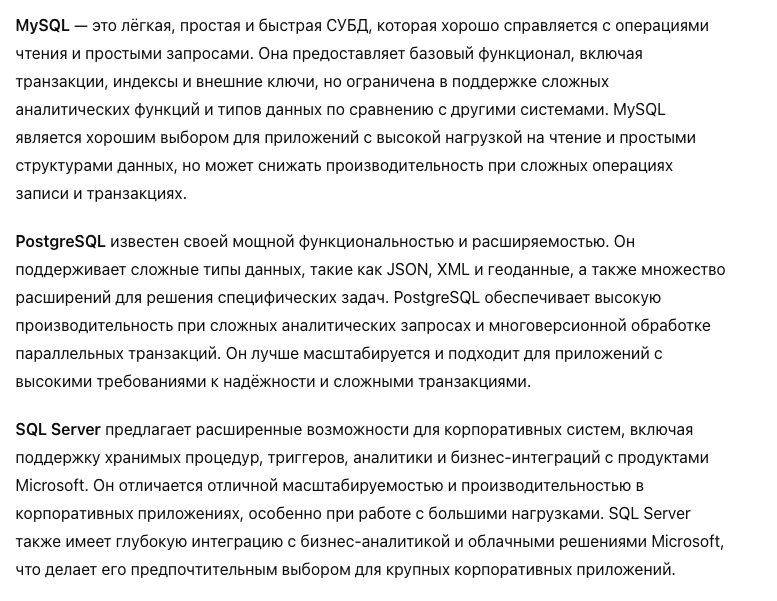
SQL is typically the choice when you need structured data, complex queries, strong consistency, and well-defined relationships between data entities. It is suitable for applications where data integrity and complex transactions are critical, such as in financial systems.
-
NoSQL is preferable when dealing with large volumes of unstructured or semi-structured data, where schema flexibility, horizontal scalability, and high performance for read/write operations are more important than strict consistency and complex queries.
Consistent hashing - NoSQL
To address the issue of scalability and efficient load distribution in a key-value storage system, the concept of consistent hashing with virtual nodes is a highly effective solution. Here's how scalability can be implemented and managed effectively:
1. Problem with Modulus-Based Partitioning
В системе, где данные в формате ключ-значение хранятся на нескольких узлах, обычным методом распределения запросов является вычисление хеша ключа и использование операции деления с остатком (hash(key) % number_of_nodes). Это хорошо работает на начальном этапе, но вызывает проблемы при добавлении или удалении узлов. Когда узел добавляется или удаляется, хеш-вычисление изменяется, что приводит к значительной перенастройке ключей на новые узлы. Это требует миграции данных и может сильно повлиять на производительность системы.
2. Solution: Consistent Hashing
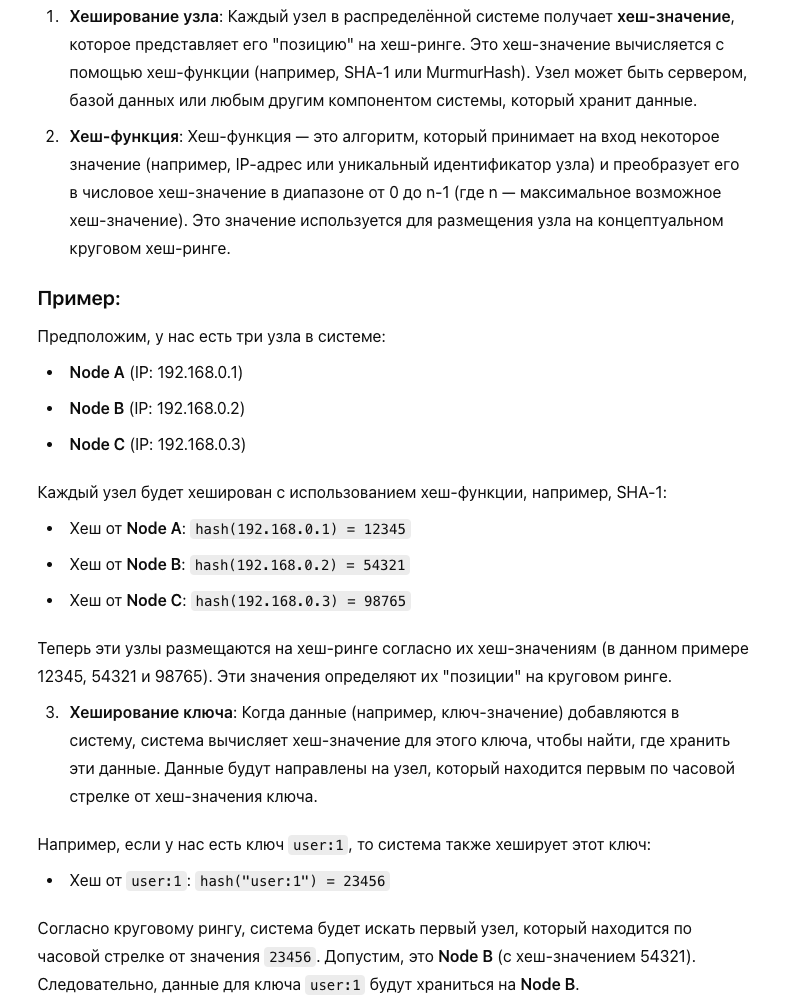
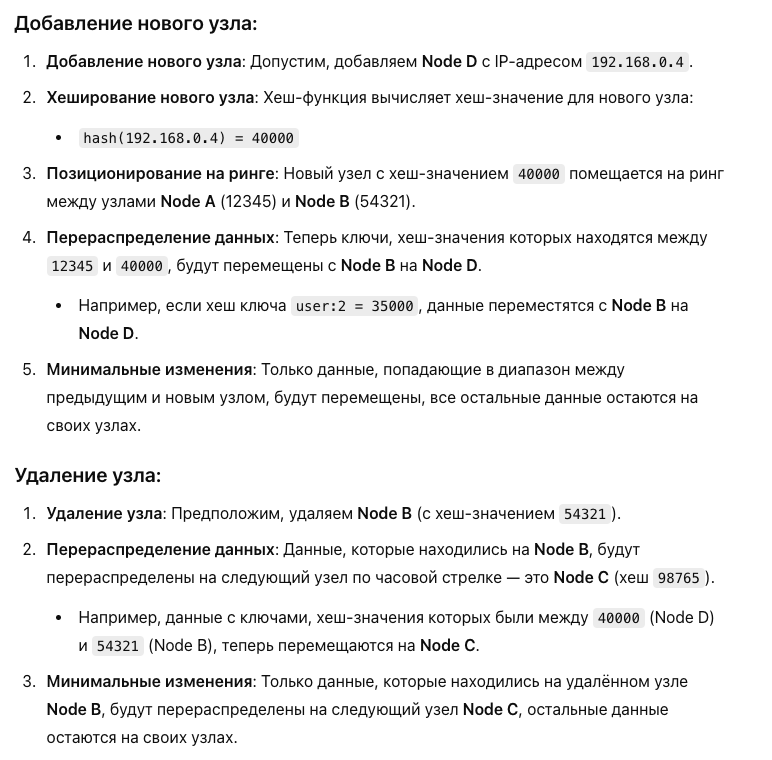
Для решения этой проблемы используется consistent hashing (консистентное хеширование). В этом методе и узлы, и данные размещаются на концептуальном круговом хеш-ринге (с хеш-значениями в диапазоне от 0 до максимального значения n-1). Каждый узел получает позицию на ринге на основе своего хеша, и каждый ключ получает позицию на том же ринге. Запрос направляется на первый узел, найденный при движении по часовой стрелке от хеш-значения ключа.
IP - internet protocol
Преимущества:
- Минимальное перемещение данных: Когда узел присоединяется или уходит, перенастраиваются только те ключи, которые попадают между новым узлом и его предшественником, вместо всей базы данных. Это приводит к небольшой, предсказуемой миграции данных, что снижает накладные расходы.
- Масштабируемость: Добавление или удаление узлов затрагивает только ограниченное количество ключей, что позволяет системе легче масштабироваться.
3. Handling Load Imbalance: Virtual Nodes
Даже с consistent hashing, неравномерное распределение ключей может привести к тому, что некоторые узлы будут обрабатывать значительно больше запросов (образование «горячих точек»). Для решения этой проблемы могут быть введены virtual nodes (виртуальные узлы). Каждому физическому узлу назначается несколько виртуальных узлов на ринге, что позволяет более равномерно распределять ключи между узлами.
Преимущества виртуальных узлов:
- Равномерное распределение нагрузки: Назначение нескольких виртуальных узлов на каждый физический узел снижает риск того, что один узел станет горячей точкой.
- Гибкое масштабирование: Узлам с большей вычислительной мощностью можно назначить больше виртуальных узлов, что позволит им обрабатывать пропорционально большую нагрузку.
- Отказоустойчивость: Если физический узел выходит из строя, виртуальные узлы, за которые он отвечал, могут быть перераспределены среди других физических узлов, обеспечивая устойчивость системы.
4. Replication for High Availability
Для обеспечения высокой доступности данные обычно реплицируются на нескольких узлах. В peer-to-peer replication (одноранговой репликации) каждый элемент данных хранится на нескольких узлах для обеспечения долговечности и доступности. Replication factor (фактор репликации, например, n=3) определяет, сколько узлов будут хранить копии каждой пары ключ-значение.
CAP Theorem:
В распределенных системах CAP theorem (теорема CAP) подчеркивает компромисс между Consistency (консистентность), Availability (доступность) и Partition Tolerance (устойчивость к разделению). В key-value хранилищах, которые отдают приоритет доступности, система может временно допускать неконсистентности во время сетевых разделений, гарантируя, что узлы продолжают обслуживать запросы независимо. Эти несоответствия устраняются позже с помощью таких техник, как версионирование или разрешение конфликтов.
5. Design Summary:
Ключевые решения для масштабируемости включают:
- Consistent Hashing для эффективной и минимальной перераспределения данных при масштабировании.
- Virtual Nodes для обеспечения равномерного распределения нагрузки между узлами.
- Peer-to-Peer Replication для долговечности и высокой доступности.
- CAP Theorem Trade-offs: Система может предпочитать доступность строгой консистентности для поддержания работы во время сетевых разделений.
Интеграция этих методов делает систему масштабируемой и устойчивой к изменениям нагрузки при минимизации операционной сложности и накладных расходов.
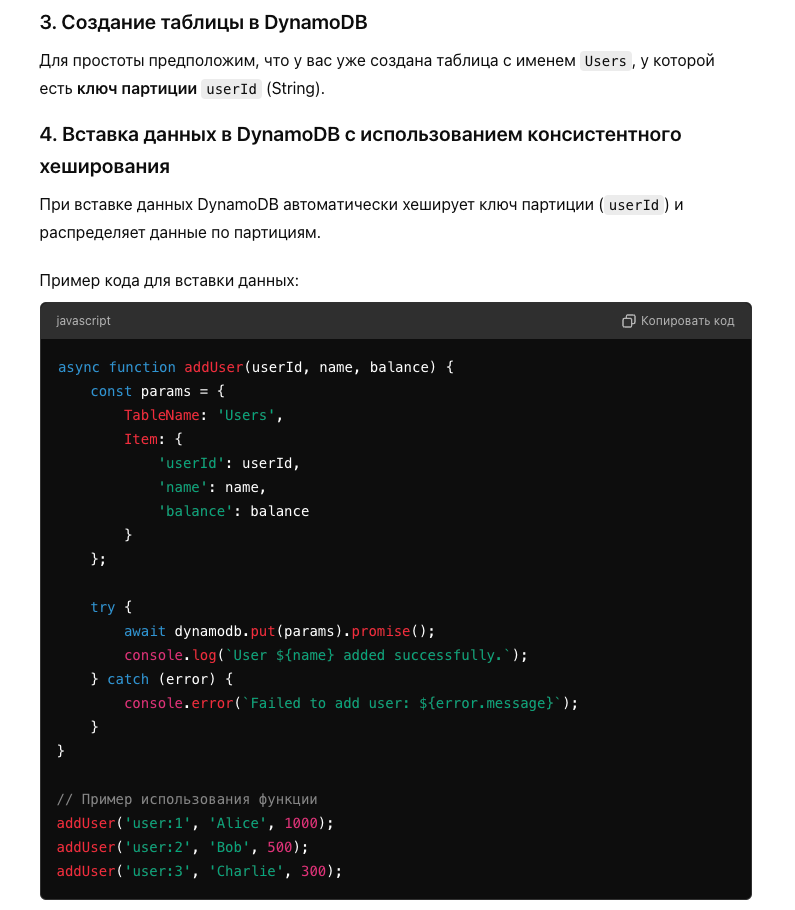
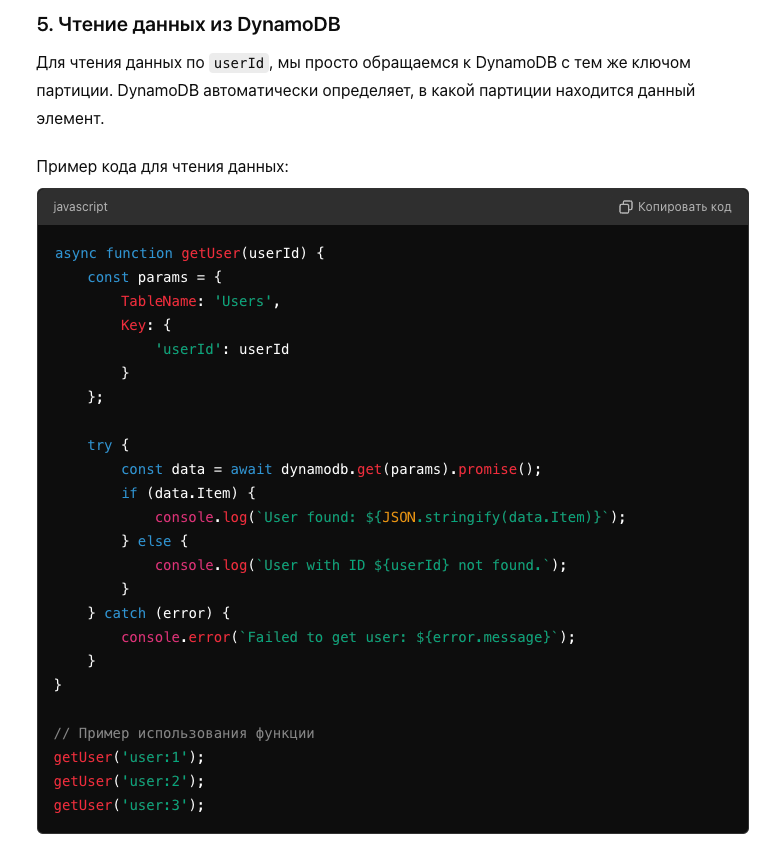
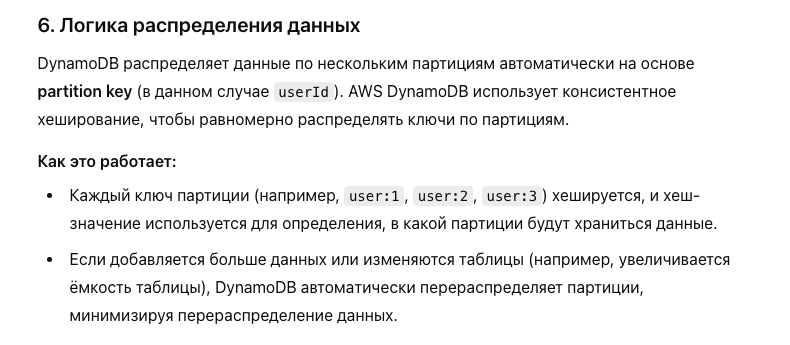
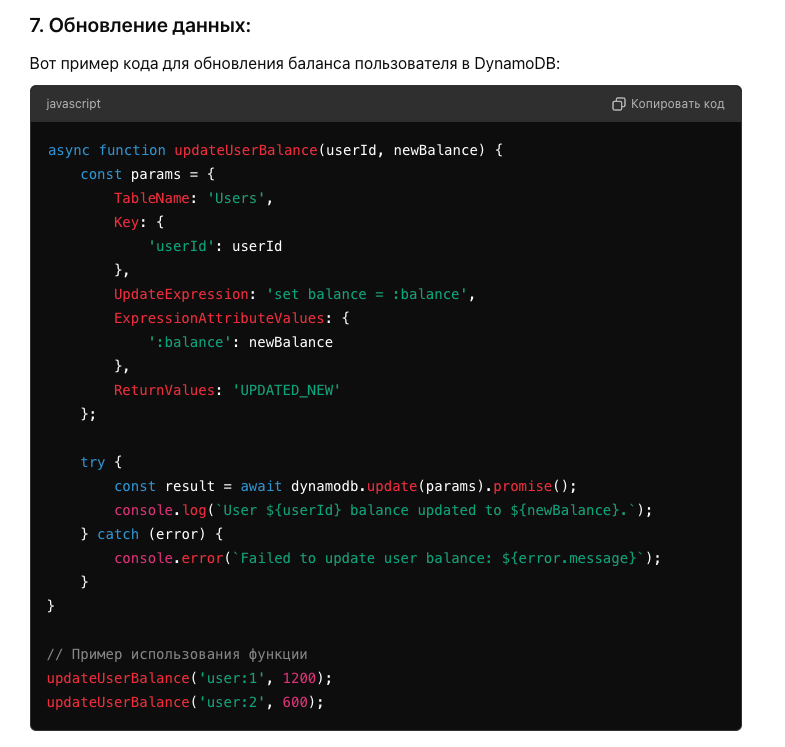
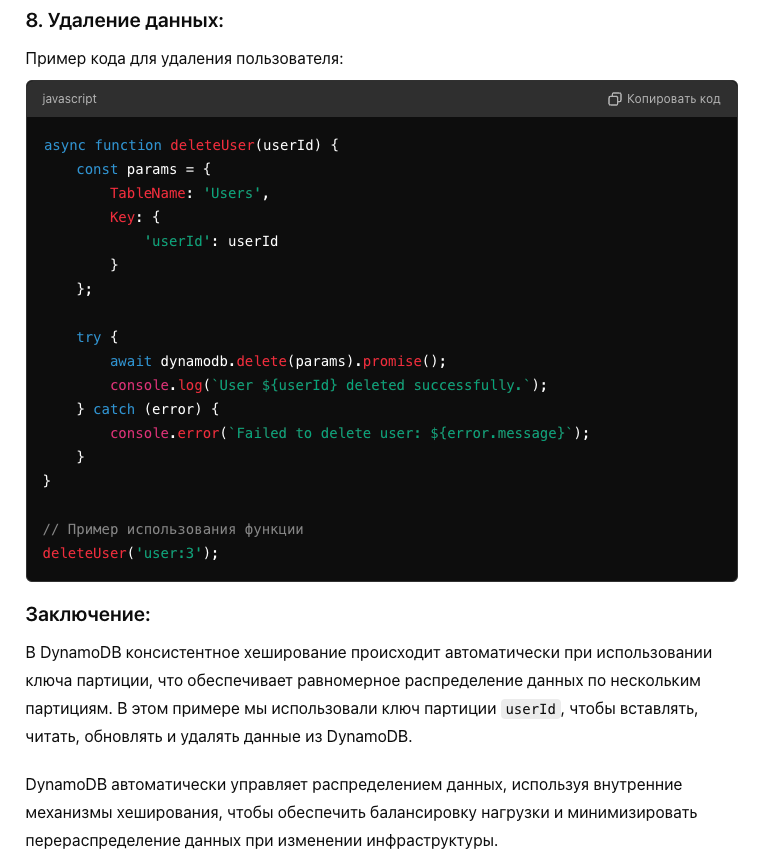
To address the issue of scalability and efficient load distribution in a key-value storage system, the concept of consistent hashing with virtual nodes is a highly effective solution. Here's how scalability can be implemented and managed effectively:
1. Problem with Modulus-Based Partitioning
In a system where key-value data is stored across multiple nodes, a common method to distribute requests is by calculating the hash of the key and using the modulus operation (hash(key) % number_of_nodes). This works well initially but presents problems when nodes are added or removed. When a node is added or removed, the hash calculation changes, causing a significant number of keys to be remapped to new nodes. This requires data migration and can severely impact system performance.
2. Solution: Consistent Hashing
To address this, consistent hashing is employed. In this method, both nodes and data are placed on a conceptual circular hash ring (with hash values ranging from 0 to a maximum n-1 value). Each node is assigned a position on the ring based on its hash, and each key is assigned a position on the same ring. A request is routed to the first node found when moving clockwise from the key's hash value.
Benefits:
- Minimal data movement: When a node joins or leaves, only the keys that fall between the new node and its predecessor need to be remapped, instead of the entire dataset. This results in a small, predictable data migration, reducing overhead.
- Scalability: Adding or removing nodes impacts only a limited number of keys, allowing the system to scale more easily.
3. Handling Load Imbalance: Virtual Nodes
Even with consistent hashing, a non-uniform distribution of keys can result in some nodes handling significantly more requests (hotspots). To solve this, virtual nodes (vnodes) can be introduced. Each physical node is assigned multiple virtual nodes on the ring, allowing for a more balanced distribution of keys across nodes.
Advantages of Virtual Nodes:
- Even load distribution: By assigning multiple virtual nodes per physical node, the risk of one node becoming a hotspot is greatly reduced.
- Flexible scaling: Nodes with higher capacity can be assigned more virtual nodes, allowing them to handle a proportionally larger share of the load.
- Fault tolerance: If a physical node fails, the virtual nodes it was responsible for can be redistributed among other physical nodes, ensuring system resilience.
4. Replication for High Availability
For high availability, data is typically replicated across multiple nodes. In peer-to-peer replication, each data item is stored on multiple nodes to ensure durability and availability. A replication factor (e.g., n=3) determines how many nodes will store copies of each key-value pair.
CAP Theorem:
In distributed systems, the CAP theorem highlights the trade-off between Consistency, Availability, and Partition Tolerance. In key-value stores prioritizing availability, the system may allow temporary inconsistencies during network partitions, ensuring that nodes continue serving requests independently. These inconsistencies are reconciled later through techniques like versioning or conflict resolution.
5. Design Summary:
Key design decisions for scalability include:
- Consistent Hashing for efficient and minimal data redistribution when scaling.
- Virtual Nodes to ensure even load distribution across nodes.
- Peer-to-Peer Replication for durability and high availability.
- CAP Theorem Trade-offs: The system may prefer availability over strict consistency to maintain uptime during network partitions.
Incorporating these techniques makes the system scalable and resilient to load changes while minimizing operational complexity and overhead.
Transactions
Что такое транзакции в базе данных (SQL и NoSQL)?
Транзакция — это набор операций с данными, которые выполняются как единое целое. Транзакции обеспечивают ключевые гарантии согласованности данных в системах хранения, и их выполнение должно удовлетворять ACID-свойствам (Atomicity, Consistency, Isolation, Durability) в традиционных SQL системах или BASE-подходам в NoSQL.
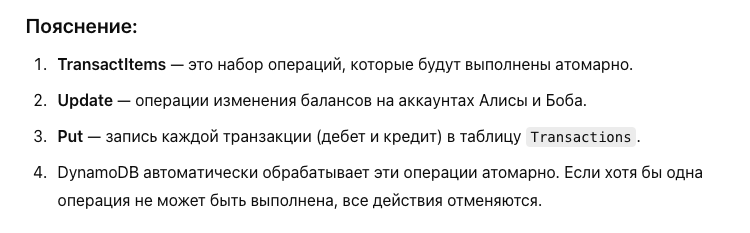
- Атомарность (Atomicity): Все операции внутри транзакции должны быть выполнены полностью, или не выполнены вовсе.
- Согласованность (Consistency): Данные должны оставаться в согласованном состоянии после завершения транзакции.
- Изолированность (Isolation): Параллельные транзакции не должны мешать друг другу.
- Долговечность (Durability): После завершения транзакции её результаты сохраняются, даже в случае сбоя системы.
В NoSQL системах транзакции часто являются ослабленными и поддерживаются не во всех системах. Примеры: MongoDB поддерживает транзакции только в пределах одной коллекции, Cassandra использует концепцию лёгких транзакций, предоставляя "eventual consistency" (финальная согласованность).
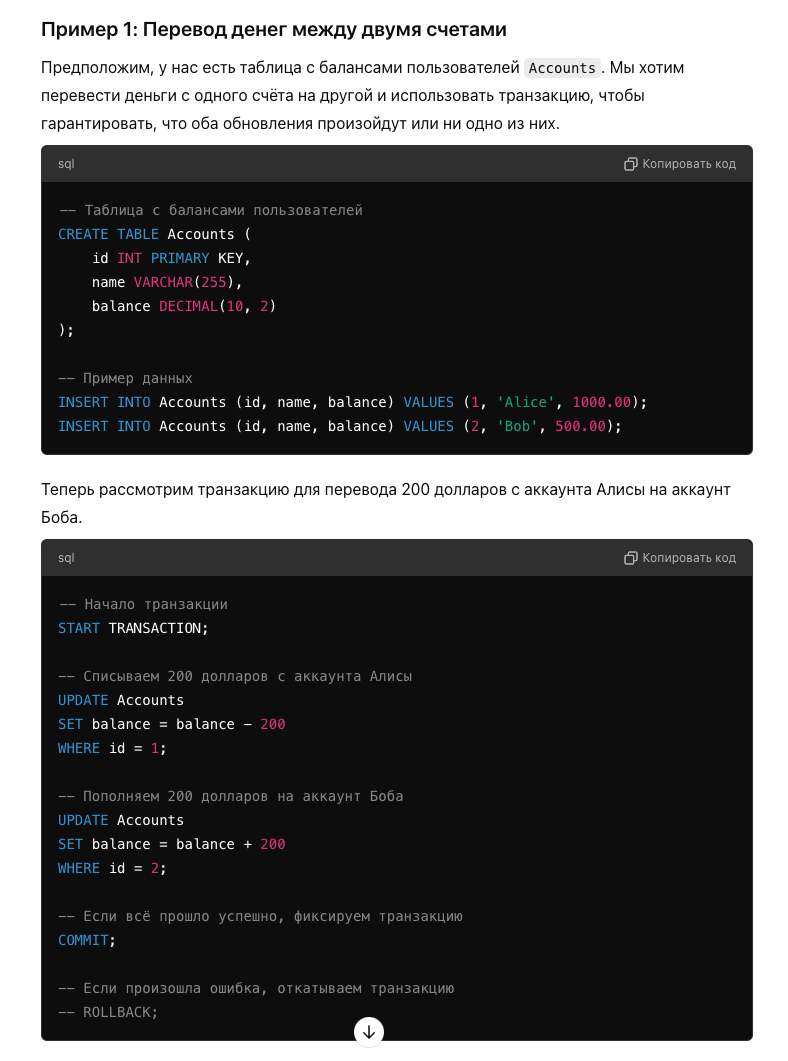
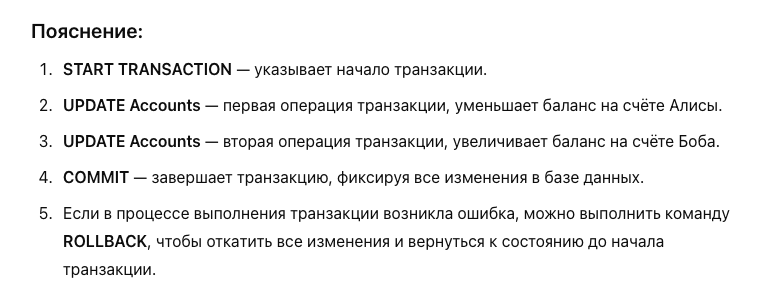
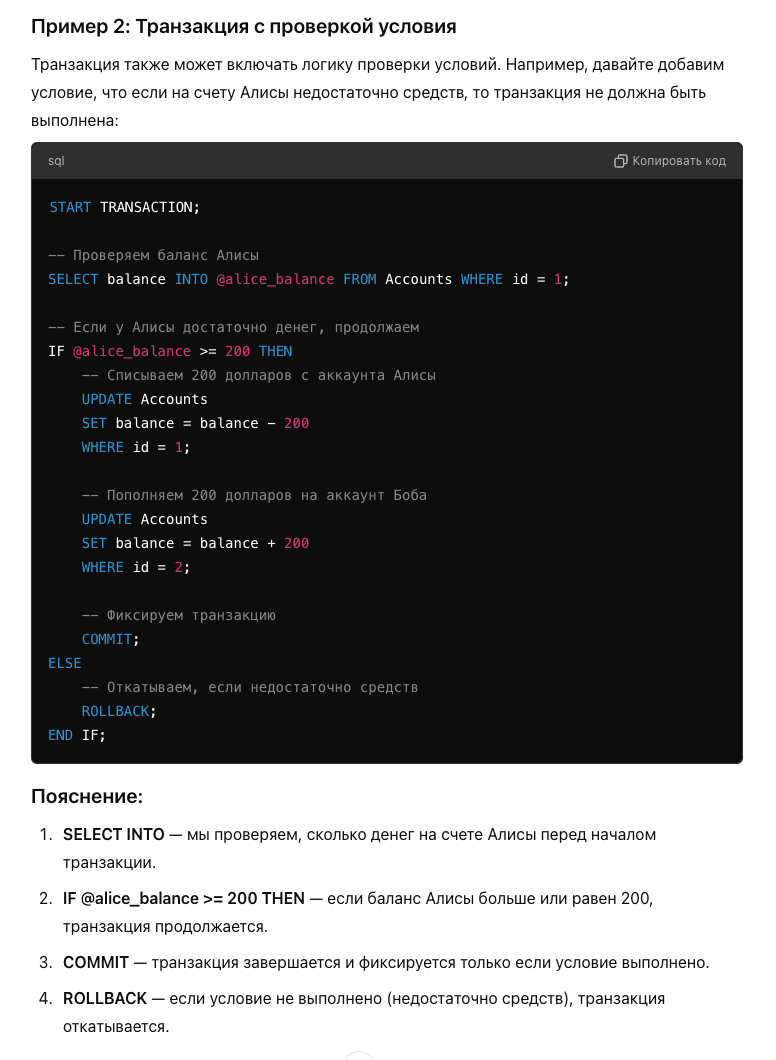
Как работает транзакция?
Транзакции запускаются при выполнении команд записи/чтения данных в базе данных. В традиционных SQL-системах они контролируются механизмом блокировок (например, двухфазная фиксация), в то время как в NoSQL-системах используются альтернативные подходы, такие как механизмы оптимистической блокировки или согласование через распределённые алгоритмы, такие как Paxos или Raft.
Как транзакции масштабируются?
SQL-системы обычно сложно масштабировать горизонтально из-за строгих требований к согласованности и блокировкам. Однако вертикальное масштабирование или шардинг (разделение базы данных на части) может помочь. NoSQL решения часто выбираются за их лучшую масштабируемость, так как они изначально проектировались для работы в распределённых системах. Например, Cassandra использует "leaderless replication" и "quorum-based" консенсус для распределённых транзакций【6†source】.
Почему транзакции важны?
Транзакции критически важны для обеспечения целостности данных в системах, где возможны многопользовательские взаимодействия или параллельные операции. Без них системы могут попадать в несогласованные состояния, что ведёт к потере данных или некорректным результатам обработки.
Из каких компонентов состоит транзакция?
- Начало транзакции (BEGIN): Определение начала транзакции.
- Операции (WRITE/READ): Все изменения данных выполняются внутри транзакции.
- Фиксация (COMMIT): Подтверждение успешного завершения всех операций.
- Откат (ROLLBACK): Откат всех изменений, если хотя бы одна операция не удалась.
Как использовать транзакции?
В SQL базы данных транзакции могут быть инициированы с помощью команд BEGIN TRANSACTION, и завершены через COMMIT или ROLLBACK. В NoSQL системах это зависит от платформы: некоторые поддерживают только транзакции для одной записи (например, DynamoDB), другие поддерживают транзакции с множеством операций (например, MongoDB).
Слабые и сильные стороны транзакций:
Сильные стороны:
- Гарантия целостности и согласованности данных.
- Позволяет реализовать сложные бизнес-логики с атомарными операциями.
- Простота управления данными в SQL-системах с ACID-гарантиями.
Слабые стороны:
- Транзакции могут вызывать проблемы производительности в масштабах, так как блокировки данных приводят к задержкам.
- В NoSQL-системах могут отсутствовать полные транзакции, что затрудняет работу с распределёнными данными.
What are Transactions in SQL and NoSQL Databases?
A transaction is a unit of work in a database that is treated as a single, atomic operation. Transactions ensure that a series of database actions either complete fully or do not happen at all, maintaining data consistency. In SQL databases, they follow ACID properties (Atomicity, Consistency, Isolation, Durability), while NoSQL databases may adhere to the BASE model (Basically Available, Soft state, Eventual consistency).
- Atomicity: All operations in a transaction must be completed entirely, or none at all.
- Consistency: Data must remain in a valid state after the transaction completes.
- Isolation: Transactions should not interfere with each other.
- Durability: Once a transaction is committed, its results must persist even in the event of a system failure.
In NoSQL databases, transactions are often weaker and may not be fully supported across distributed systems. For example, MongoDB supports transactions across multiple documents within a collection, while Cassandra uses lightweight transactions that emphasize eventual consistency.
How Do Transactions Work?
Transactions begin when operations such as data writes or reads are performed. In SQL systems, transactions are controlled using locking mechanisms (like two-phase commit), while NoSQL systems may use optimistic locking or distributed consensus protocols such as Paxos or Raft to handle transaction coordination.
How Do Transactions Scale?
SQL systems typically face challenges scaling horizontally due to strict consistency and locking requirements. Vertical scaling (adding more power to a single machine) or sharding (splitting the database into smaller parts) can be used to help scale SQL databases. In NoSQL systems, scaling is more natural since they are designed for distributed environments. Systems like Cassandra use leaderless replication and quorum-based consensus to manage distributed transactions, allowing them to handle large, distributed datasets more effectively【6†source】.
Why Are Transactions Important?
Transactions are critical for ensuring data integrity, especially in systems where multiple users or processes are interacting with the data concurrently. Without transactions, databases can enter inconsistent states, leading to data corruption or incorrect results.
Components of a Transaction
- Begin (BEGIN TRANSACTION): Marks the start of a transaction.
- Operations (WRITE/READ): All database modifications or reads are performed within the transaction.
- Commit (COMMIT): Confirms that all operations within the transaction are successful.
- Rollback (ROLLBACK): Reverts any changes if an error occurs during the transaction.
How to Use Transactions?
In SQL databases, transactions are initiated with commands like BEGIN TRANSACTION and finalized with either COMMIT (to confirm) or ROLLBACK (to undo). In NoSQL systems, it varies by platform. Some NoSQL databases like DynamoDB support transactions on single items, while others like MongoDB allow multi-document transactions.
Strengths and Weaknesses of Transactions
Strengths:
- Data Integrity: Transactions ensure the integrity and consistency of data.
- Business Logic: Allows for the implementation of complex business logic as atomic operations.
- ACID Guarantees: SQL databases provide robust ACID guarantees, which are ideal for financial or critical systems.
Weaknesses:
- Performance Overhead: Transactions can reduce performance due to locking and contention, especially at scale.
- Limited in NoSQL: Many NoSQL databases do not offer full transaction support across distributed data, making it difficult to maintain consistency in large distributed systems.
ACID
| ACID Principle | Description | Importance |
|---|---|---|
| Atomicity | Ensures that a transaction is treated as a single unit, meaning all operations within the transaction must be completed; if any part fails, the entire transaction fails and the database is left unchanged. | Guarantees that partial transactions do not corrupt the database, ensuring consistency and preventing data loss in case of failures. |
| Consistency | Ensures that a transaction only brings the database from one valid state to another, maintaining database invariants. If any constraint or rule is violated, the transaction is rolled back. | Maintains the integrity of the database by ensuring that all transactions leave the database in a valid state. |
| Isolation | Ensures that transactions occur independently without interference. The intermediate state of a transaction is invisible to other transactions, preventing them from reading data that has not yet been committed. | Prevents concurrent transactions from affecting each other, which is crucial for maintaining data accuracy in multi-user environments. |
| Durability | Ensures that once a transaction has been committed, it will remain in the system even in the event of a system crash or power failure. | Protects against data loss by ensuring that completed transactions are permanently recorded and can survive system failures. |
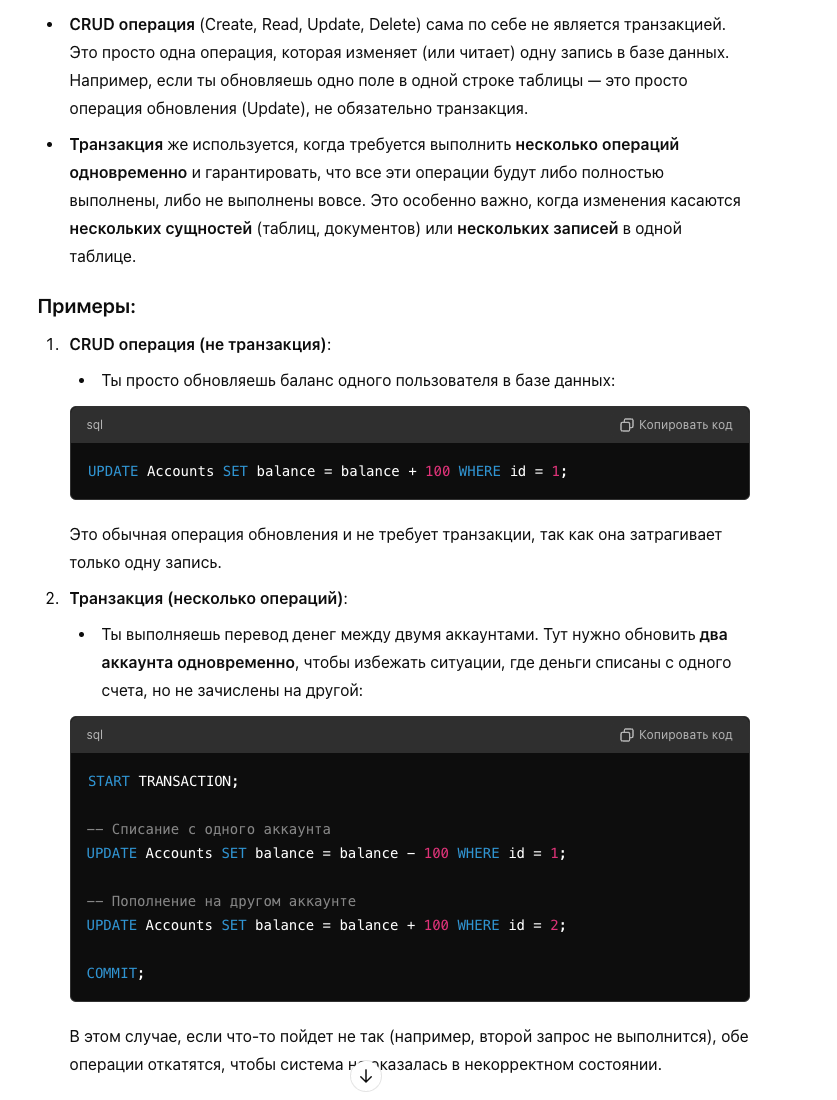
Разница тразакций и CRUD
Как работают транзакции в Amazon RDS (Relational Database Service)
Amazon RDS — это управляемый сервис реляционных баз данных, который поддерживает базы данных, такие как MySQL, PostgreSQL, Oracle и SQL Server. Транзакции в RDS следуют классическим принципам ACID (Атомарность, Согласованность, Изолированность, Долговечность), которые гарантируют целостность данных.
Жизненный цикл транзакции в RDS:
-
Начало транзакции: Транзакция в RDS начинается с команды
BEGIN.- Пример:
BEGIN;
- Пример:
-
Операции (Чтение/Запись): Все SQL-команды (
INSERT,UPDATE,DELETE,SELECT), выполняемые внутри транзакции, выполняются атомарно. То есть, все изменения либо полностью завершаются, либо откатываются при ошибке.- Пример:
INSERT INTO accounts (user_id, balance) VALUES (1, 100);
UPDATE accounts SET balance = balance - 50 WHERE user_id = 1;
- Пример:
-
Механизм блокировок: RDS использует стандартные механизмы блокировки, предоставляемые СУБД, для обеспечения изолированности транзакций. Например, двухфазная фиксация в PostgreSQL или блокировки на уровне строк в MySQL.
- В случае интенсивных операций записи блокировки устанавливаются на строки или таблицы, и параллельные транзакции вынуждены ожидать, пока эти блокировки не будут сняты, чтобы обеспечить изоляцию.
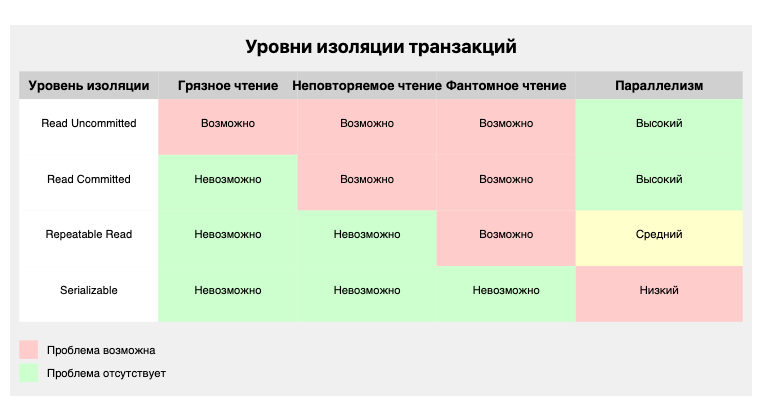
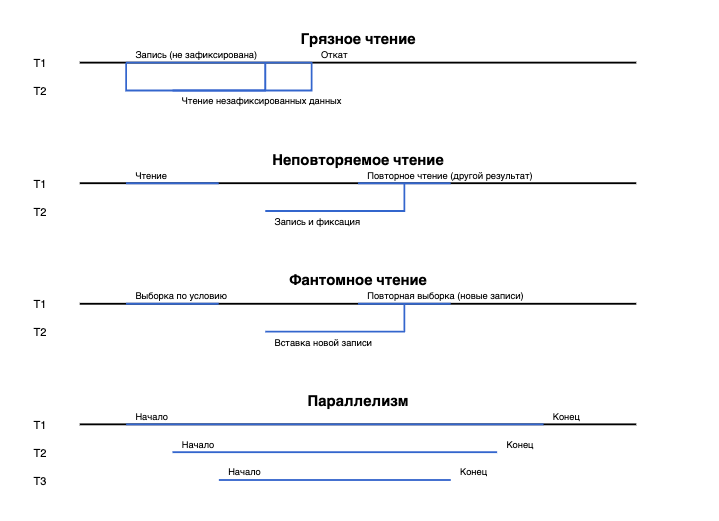
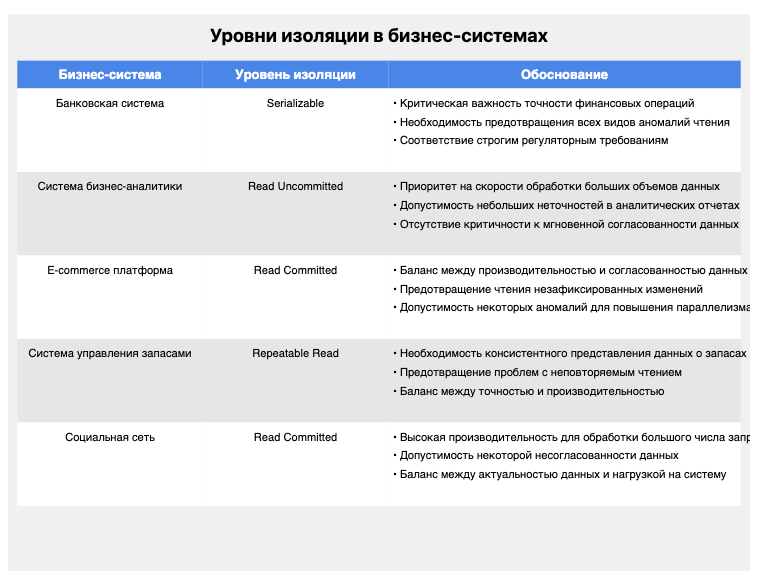
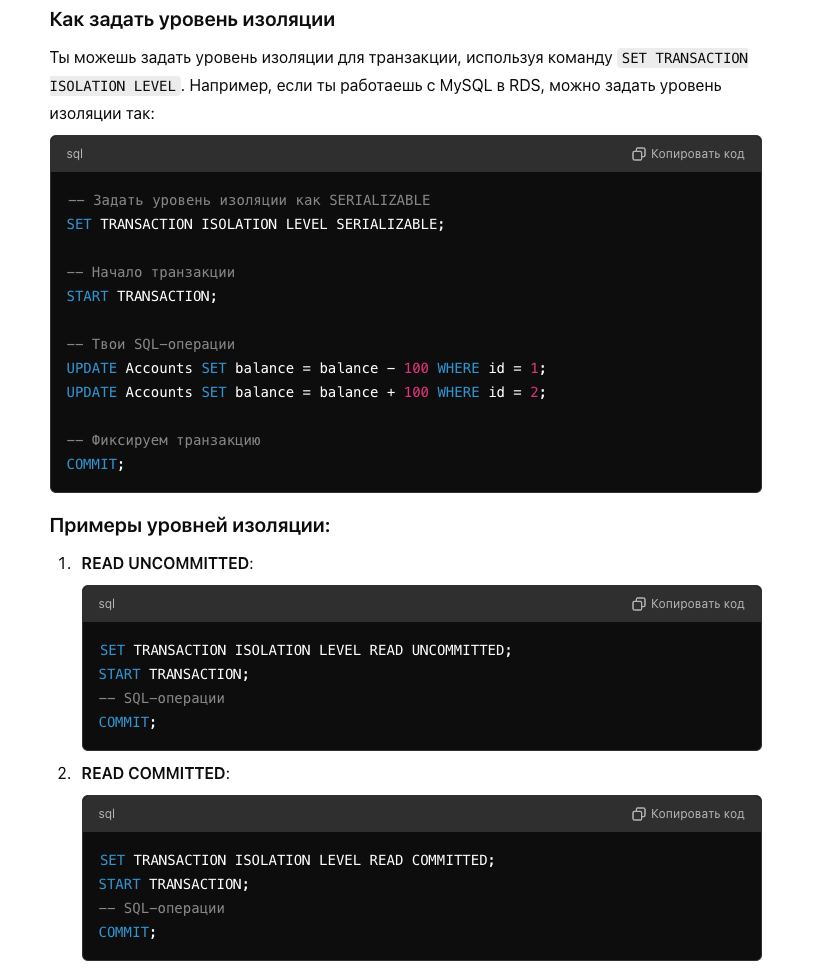
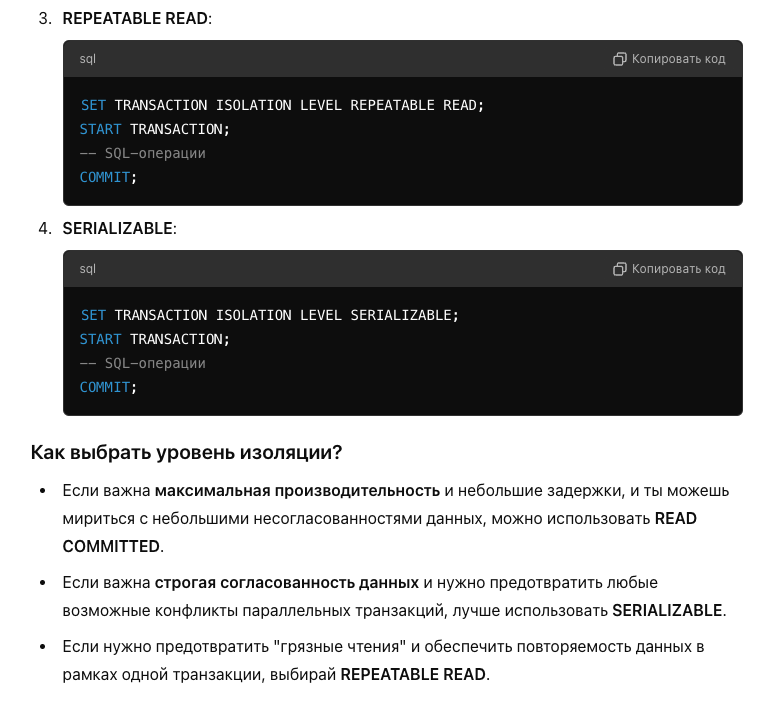
- Уровни изоляции можно настроить (например, Read Committed, Repeatable Read, Serializable), что позволяет управлять параллелизмом.
-
Фиксация или откат: Если все операции завершились успешно, транзакция подтверждается (COMMIT). Если возникает ошибка, все изменения отменяются (ROLLBACK).
- Пример:
COMMIT;    -- Сохранить изменения
ROLLBACK;  -- Откатить изменения
- Пример:
-
Долговечность: После выполнения
COMMIT, изменения гарантированно сохраняются на диске, даже в случае сбоя системы. Долговечность обеспечивается за счет таких функций, как развертывание в нескольких зонах доступности (multi-AZ), где данные синхронно реплицируются для обеспечения отказоустойчивости.
Основные особенности транзакций в RDS:
- Уровни изоляции: RDS поддерживает настройку уровней изоляции в зависимости от используемой базы данных (например, в MySQL и PostgreSQL доступны уровни изоляции
Serializable,Read Committed). - Производительность: Для управления нагрузками RDS может использовать реплики для чтения (для масштабирования операций чтения) и развертывание в нескольких зонах доступности для обеспечения высокой доступности.
Пример транзакции в RDS:
- Пользователь начинает транзакцию с помощью команды
BEGIN. - Выполняются несколько команд SQL, такие как вставка и обновление строк в таблице.
- Система автоматически блокирует необходимые строки для обеспечения изоляции.
- Если все команды успешны, транзакция фиксируется (
COMMIT). - Если произошла ошибка, выполняется откат (
ROLLBACK). - Данные сохраняются на диск, обеспечивая долговечность.
Как работают транзакции в Amazon DynamoDB
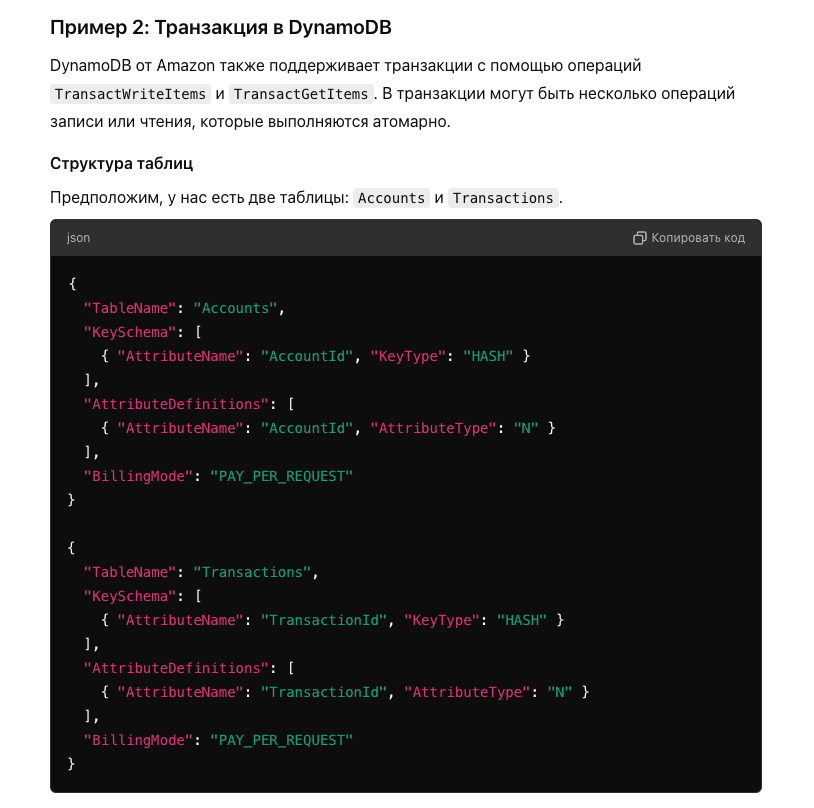
DynamoDB — это полностью управляемая NoSQL база данных с упором на высокую производительность и горизонтальное масштабирование. В DynamoDB транзакции обеспечивают атомарность и согласованность для операций с несколькими элементами и таблицами.
Жизненный цикл транзакции в DynamoDB:
DynamoDB поддерживает два типа транзакций:
- TransactWriteItems — транзакции для операций записи (например,
PUT,UPDATE,DELETE). - TransactGetItems — транзакции для чтения нескольких элементов.
Обе транзакции следуют принципам ACID, обеспечивая атомарность, согласованность, изоляцию и долговечность для нескольких элементов и таблиц.
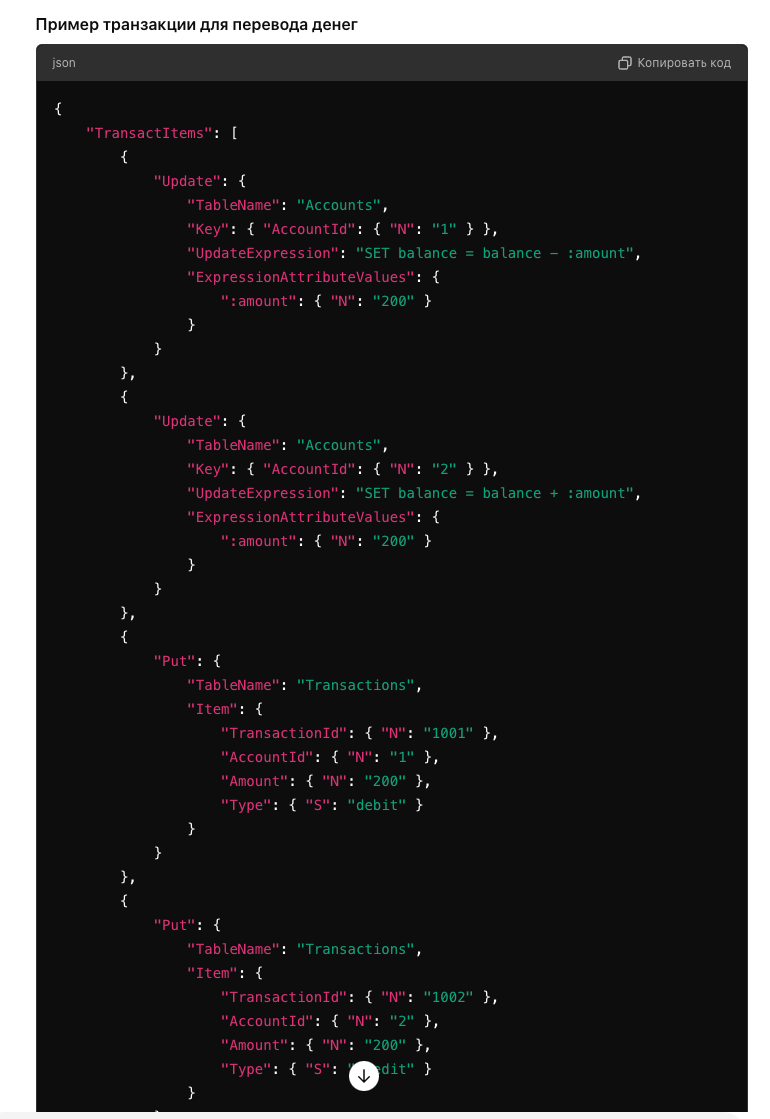
1. TransactWriteItems: Атомарные транзакции записи
Этот тип транзакции позволяет выполнять атомарные операции над несколькими элементами или таблицами. Поддерживается до 25 операций в одной транзакции, и DynamoDB гарантирует, что либо все операции будут успешны, либо вся транзакция будет отменена.
- Шаги:
-
Начинается транзакция с использованием операции
TransactWriteItems, где задается набор операций (например,PutItem,UpdateItem,DeleteItem). -
DynamoDB гарантирует, что все операции выполнятся, или, в случае сбоя одной операции, вся транзакция откатывается.
-
Если транзакция не удается из-за условий или проблем с пропускной способностью, DynamoDB автоматически повторяет операции.
-
Пример транзакции записи:
{
  "TransactItems": [
    {
      "Put": {
        "TableName": "Orders",
        "Item": {
          "OrderId": {"N": "123"},
          "CustomerId": {"N": "456"}
        }
      }
    },
    {
      "Update": {
        "TableName": "Inventory",
        "Key": {"ProductId": {"N": "789"}},
        "UpdateExpression": "SET stock = stock - :decrement",
        "ExpressionAttributeValues": {
          ":decrement": {"N": "1"}
        }
      }
    }
  ]
}
-
2. TransactGetItems: Атомарные транзакции чтения
Этот тип транзакции позволяет читать несколько элементов из одной или нескольких таблиц с гарантией строгой согласованности. DynamoDB гарантирует, что при получении нескольких элементов данные будут возвращены атомарно.
-
Шаги:
- Операция
TransactGetItemsпозволяет задать несколько элементов для чтения из разных таблиц. Если все операции успешны, транзакция фиксируется и возвращает данные. - В случае сбоя любая часть транзакции откатывается, гарантируя, что частичные данные не возвращаются.
- Операция
-
Пример транзакции чтения:
{
  "TransactItems": [
    {
      "Get": {
        "TableName": "Orders",
        "Key": {
          "OrderId": {"N": "123"}
        }
      }
    },
    {
      "Get": {
        "TableName": "Inventory",
        "Key": {
          "ProductId": {"N": "789"}
        }
      }
    }
  ]
}
Основные особенности транзакций в DynamoDB:
- Сильная согласованность: DynamoDB гарантирует выполнение транзакций с сильной согласованностью, даже в распределенных узлах.
- ACID: Транзакции в DynamoDB соответствуют модели ACID, обеспечивая атомарность, согласованность, изоляцию и долговечность.
- Условные выражения: В транзакциях можно использовать условия, что позволяет выполнять операции только при выполнении определенных условий.
- Масштабируемость: DynamoDB спроектирован для горизонтального масштабирования, и транзакции эффективно работают в распределенных системах.
Пример транзакции в DynamoDB:
- Пользователь отправляет запрос транзакции (
TransactWriteItemsилиTransactGetItems). - DynamoDB распределяет транзакцию по разделам и обеспечивает согласованность между ними.
- Если все условия выполнены, транзакция фиксируется.
- В случае сбоя вся транзакция откатывается, и система выполняет повторные попытки.
- DynamoDB автоматически обеспечивает репликацию данных для долговечности и отказоустойчивости.
Сравнение транзакций в RDS и DynamoDB
| Особенность | RDS | DynamoDB |
|---|---|---|
| Модель | SQL (реляционная) | NoSQL (ключ-значение) |
| Соответствие ACID | Полностью ACID | Полностью ACID (с условиями) |
| Уровни изоляции | Настраиваемые (например, Serializable, Read Committed) | Строгая согласованность через разделы |
| Масштабируемость | Трудно масштабировать горизонтально | Спроектирован для горизонтального масштабирования |
| Обработка сбоев | Ручной откат или на уровне приложения | Автоматические повторные попытки и откат |
RDS лучше подходит для традиционных SQL-решений с поддержкой сложных отношений и запросов по множеству таблиц. DynamoDB оптимален для распределённых сред с гибкими схемами и высокой пропускной способностью.
How Transactions Work in Amazon RDS (Relational Database Service)
Amazon RDS is a managed relational database service that supports SQL-based databases like MySQL, PostgreSQL, Oracle, and SQL Server. The transactional behavior in RDS is governed by the SQL engines used, and they adhere to ACID (Atomicity, Consistency, Isolation, Durability) principles.
Transaction Lifecycle in RDS:
-
Begin Transaction: Transactions in RDS follow standard SQL transaction models. A transaction starts with the
BEGINcommand.- Example:
BEGIN;
- Example:
-
Operations (Read/Write): All the SQL commands (like
INSERT,UPDATE,DELETE, andSELECT) executed within a transaction are either completed fully or rolled back if any command fails. Each operation within the transaction is treated atomically.- Example:
INSERT INTO accounts (user_id, balance) VALUES (1, 100);
UPDATE accounts SET balance = balance - 50 WHERE user_id = 1;
- Example:
-
Locking Mechanism: RDS uses standard locking mechanisms of the underlying SQL engines to maintain isolation between transactions. For example, two-phase locking (2PL) in PostgreSQL or InnoDB’s row-level locking in MySQL.
- In write-heavy scenarios, locks are placed on rows or tables, and concurrent transactions must wait for these locks to be released before proceeding, which guarantees isolation.
- Isolation levels can be configured, such as Read Committed, Repeatable Read, or Serializable, controlling how transactions are isolated from each other.
-
Commit or Rollback: When all operations are successfully executed, the transaction is either committed or rolled back (if an error occurs).
- Example:
COMMIT; -- Saves changes
ROLLBACK; -- Reverts all changes made during the transaction
- Example:
-
Durability: Once a
COMMITis issued, changes made by the transaction are written to the disk and guaranteed to persist, even in case of system failure. Durability in RDS is handled through features like multi-AZ deployments, which replicate data synchronously across different Availability Zones to ensure high availability and durability.
Key Features in RDS Transactions:
- Isolation Levels: RDS allows tuning of isolation levels depending on the database engine. For example, MySQL and PostgreSQL support
Serializable,Read Committed, andRepeatable Read. - Performance: RDS manages performance through techniques like read replicas (for read-heavy workloads) and multi-AZ deployments to ensure low-latency failover and high availability during transaction processing.
Example Workflow of an RDS Transaction:
- A user starts a transaction with
BEGIN. - Multiple SQL commands are issued, such as inserting and updating rows in a database.
- The system automatically locks the necessary rows to ensure isolation.
- If all commands succeed, the transaction is committed.
- If any command fails, a
ROLLBACKundoes all the changes. - Data is persisted to disk, ensuring durability.
How Transactions Work in Amazon DynamoDB
DynamoDB is a fully managed NoSQL database with a focus on high performance and horizontal scalability. DynamoDB transactions ensure atomicity and consistency for multi-item and multi-table operations, which makes it suitable for use cases requiring strong consistency across distributed data.
Transaction Lifecycle in DynamoDB:
DynamoDB supports two types of transactions:
- TransactWriteItems: For writing operations (e.g.,
PUT,UPDATE,DELETE). - TransactGetItems: For reading multiple items within a transaction.
Both write and read transactions follow the ACID model in DynamoDB, ensuring atomicity, consistency, isolation, and durability across multiple items and tables.
1. TransactWriteItems: Atomic Write Transactions
This type allows atomic operations across multiple items or tables. It supports up to 25 operations in a single transaction and ensures that either all operations succeed or none of them do.
- Steps:
-
Begin a transaction using the
TransactWriteItemsoperation, specifying the set of operations (e.g.,PutItem,UpdateItem,DeleteItem). -
DynamoDB ensures that either all operations succeed, or if one fails, the entire transaction is rolled back.
-
If the transaction fails due to a conditional check or capacity issues, DynamoDB automatically performs retries for idempotent operations.
-
Example of a transactional write request:
{
  "TransactItems": [
    {
      "Put": {
        "TableName": "Orders",
        "Item": {
          "OrderId": {"N": "123"},
          "CustomerId": {"N": "456"}
        }
      }
    },
    {
      "Update": {
        "TableName": "Inventory",
        "Key": {"ProductId": {"N": "789"}},
        "UpdateExpression": "SET stock = stock - :decrement",
        "ExpressionAttributeValues": {
          ":decrement": {"N": "1"}
        }
      }
    }
  ]
}
-
-
TransactGetItems: Atomic Read Transactions This type allows reading multiple items from one or more tables in a strongly consistent manner. DynamoDB guarantees that if you retrieve multiple items as part of a transaction, the operation reads an atomic snapshot of the data at a particular point in time.
-
Steps:
- The
TransactGetItemsoperation specifies multiple items across tables to retrieve. If all operations succeed, the transaction is committed, returning the values of all requested items. - If any part of the transaction fails (e.g., a capacity issue), the entire read operation is rolled back, ensuring no partial results.
- The
-
Example:
{
  "TransactItems": [
    {
      "Get": {
        "TableName": "Orders",
        "Key": {
          "OrderId": {"N": "123"}
        }
      }
    },
    {
      "Get": {
        "TableName": "Inventory",
        "Key": {
          "ProductId": {"N": "789"}
        }
      }
    }
  ]
}
-
Key Features of DynamoDB Transactions:
- Strong Consistency: DynamoDB ensures that transactions are executed in a strongly consistent manner, even across distributed nodes.
- ACID Compliance: Transactions in DynamoDB are ACID-compliant, ensuring atomicity, consistency, isolation, and durability.
- Conditional Expressions: DynamoDB supports conditions within transactions, allowing operations to proceed only if certain conditions are met.
- Scalability: DynamoDB is designed to scale horizontally, and transactions operate efficiently at scale across distributed partitions.
Example Workflow of a DynamoDB Transaction:
- A transaction request (either
TransactWriteItemsorTransactGetItems) is submitted. - DynamoDB distributes the transaction across partitions and ensures consistency between them.
- If all conditions are met, DynamoDB commits the transaction.
- If any step fails, the entire transaction is rolled back, and retries are attempted.
- DynamoDB automatically handles replication across multiple availability zones to ensure durability and fault tolerance.
Comparison: RDS vs. DynamoDB Transactions
| Feature | RDS | DynamoDB |
|---|---|---|
| Model | SQL (relational) | NoSQL (key-value store) |
| ACID Compliance | Fully ACID | Fully ACID (with conditions) |
| Isolation Levels | Customizable (e.g., Serializable, Read Committed) | Strongly consistent across partitions |
| Transactional Scope | Single or multiple rows in a table | Multiple items or tables |
| Scalability | Challenging to scale horizontally | Designed for horizontal scaling |
| Failure Handling | Manual rollback or application-driven | Automatic retries and rollback |
Both RDS and DynamoDB provide robust transaction handling, but RDS is preferred for traditional SQL-based use cases requiring complex relationships and multi-table joins, whereas DynamoDB excels in distributed environments with flexible schema and high throughput.
Partitioning / Sharding
Why
Data partitioning, or sharding, is essential for several reasons in scaling traditional databases, handling growing data, and managing increased read/write traffic. Here's why partitioning is crucial:
-
Scalability: As data and traffic increase, a single-node database can no longer handle the load effectively. Partitioning enables distributing data across multiple nodes, thus improving system scalability. This allows each node to handle only a portion of the data, reducing the load on individual servers and enabling horizontal scaling.
-
Performance Improvement: Partitioning balances the data and read/write load across multiple servers. This reduces latency and improves throughput by preventing any single node from becoming a bottleneck. When done correctly, it also minimizes hotspots—where one node handles most of the queries—by evenly distributing queries across shards.
-
Availability and Fault Tolerance: By spreading data across multiple nodes, partitioning increases availability. If one node goes down, the system can still function, as the other nodes continue to serve queries for the remaining partitions. This redundancy ensures higher system uptime.
-
Management of Large Datasets: As datasets grow, keeping all data on a single server becomes inefficient. Partitioning divides the dataset into manageable chunks, which are easier to maintain, back up, and restore.
There are two main types of partitioning:
-
Vertical Sharding: Splitting a database by tables or columns. For example, one table may reside on one server while another resides on a different server. This is used when different tables have different read/write patterns. However, vertical sharding is limited when data within a single table grows too large.
-
Horizontal Sharding: Splitting a single table's rows across multiple databases. This method is most effective for large tables that can't be stored on a single machine. Horizontal sharding can be implemented using key-range partitioning, where each partition holds a continuous range of keys, or hash-based partitioning, where a hash function distributes rows uniformly across shards.
Challenges: Partitioning introduces complexity in ensuring data consistency, performing distributed transactions, and handling failures. For instance, ensuring that a transaction affecting multiple shards maintains ACID properties can be difficult.
CAP Theorem: Partitioning also touches on the CAP theorem, which states that in a distributed system, you can only have two out of three properties: consistency, availability, and partition tolerance. When partitioning, systems must make trade-offs between consistency (ensuring the same data is seen across all partitions) and availability (the ability to serve requests even when some partitions are down).
In summary, partitioning is a crucial technique to scale databases, handle large datasets, and improve system availability and fault tolerance while managing challenges related to consistency and system complexity【6†source】【6†source】.
Choosing the best database sharding approach depends on the specific needs of your organization. Both vertical sharding and horizontal sharding have their own advantages and disadvantages, and the decision should be based on the size of your data, the complexity of your queries, and the expected growth in users and data.
Vertical Sharding:
This approach splits the database by tables or columns. It works well when different parts of the application access different parts of the data. For example, you can separate large binary objects (BLOBs) like images from the core business data to improve retrieval speed.
Pros:
- Suitable for splitting functionality: Different parts of the application access different tables or columns.
- Easier to optimize storage: Separate larger or less-used data, improving read performance for more frequently accessed data.
- Useful for scaling different components of the system independently.
Cons:
- Joins become complex if the data is split across multiple servers, which can slow down query performance.
- Limited scalability when data grows rapidly in a single table, as vertical sharding doesn’t address the row-level data scaling issue.
Horizontal Sharding:
This approach splits data by rows across multiple nodes, often based on a key such as user ID. It is ideal for scaling databases with large datasets by distributing the data across different nodes, each storing part of the table.
Pros:
- Better scalability for large datasets, as it spreads rows across nodes, allowing the system to handle more data and queries.
- Fault tolerance: Since the data is distributed across different nodes, the failure of one node affects only a portion of the data, not the entire system.
- Load balancing: Distributes read and write operations across nodes, improving system performance and reducing bottlenecks.
Cons:
- Increased complexity in ensuring data consistency across multiple nodes, especially with ACID properties.
- Difficulties with cross-shard queries: Operations like joins and aggregations can become expensive as data needs to be fetched from multiple shards.
- Rebalancing data can be tricky when nodes are added or removed, as it may require redistributing existing data.
Centralized Database (No Sharding):
For smaller datasets or simpler applications, a centralized database can be more effective and easier to manage.
Pros:
- Easier data maintenance and stronger consistency (ACID transactions).
- Simpler programming model for developers.
- Ideal for small businesses with limited data needs.
Cons:
- Single point of failure: If the database fails, the entire system is down.
- Limited scalability: As data and traffic grow, a single-node system will face latency issues and eventually reach its performance limits.
Conclusion:
- If you have large datasets or expect rapid data growth, horizontal sharding is likely the best approach, as it distributes rows across multiple nodes, providing better scalability and fault tolerance.
- Vertical sharding is useful when you need to separate different types of data or functions and scale them independently.
- For small, simple systems with limited data, a centralized database may be the most efficient and cost-effective option.
Ultimately, the best approach depends on your application’s specific needs, query patterns, and expected growth【6†source】【6†source】.
Зачем
Разделение данных (шардинг) является важным механизмом для масштабирования традиционных баз данных, управления увеличивающимся объемом данных и повышенной нагрузкой на чтение и запись. Вот почему это необходимо:
-
Масштабируемость: По мере роста данных и трафика, одна нода базы данных больше не может справляться с нагрузкой эффективно. Разделение позволяет распределять данные по нескольким узлам, что улучшает масштабируемость системы. Это позволяет каждому узлу обрабатывать только часть данных, снижая нагрузку на отдельные серверы и позволяя горизонтально масштабировать систему.
-
Улучшение производительности: Разделение данных и нагрузки на чтение/запись между несколькими серверами снижает задержки и повышает пропускную способность, предотвращая узкие места на одном узле. Если разделение выполнено правильно, это также минимизирует "горячие точки" — ситуации, когда один узел обрабатывает большинство запросов, распределяя их равномерно по шардам.
-
Доступность и отказоустойчивость: Распределение данных по нескольким узлам увеличивает доступность системы. Если один узел выходит из строя, система может продолжать работать, поскольку другие узлы продолжают обслуживать запросы к оставшимся разделам данных. Эта избыточность обеспечивает большую стабильность системы.
-
Управление большими наборами данных: По мере увеличения объемов данных хранение их на одном сервере становится неэффективным. Разделение делит набор данных на управляемые части, что упрощает их обслуживание, резервное копирование и восстановление.
Основные типы разделения данных:
-
Вертикальный шардинг: Разделение базы данных по таблицам или столбцам. Например, одна таблица может находиться на одном сервере, а другая — на другом. Этот подход применяется, если у разных таблиц разные шаблоны операций чтения/записи. Однако вертикальный шардинг ограничен, если данные в одной таблице становятся слишком большими.
-
Горизонтальный шардинг: Разделение строк одной таблицы между несколькими базами данных. Этот метод наиболее эффективен для больших таблиц, которые невозможно хранить на одном сервере. Горизонтальный шардинг можно реализовать с помощью шардинга на основе диапазона ключей, когда каждый раздел содержит непрерывный диапазон ключей, или хеш-шардинга, где хеш-функция равномерно распределяет строки по шардам.
Проблемы: Разделение данных увеличивает сложность поддержания согласованности данных, выполнения распределённых транзакций и обработки отказов. Например, обеспечить соблюдение свойств ACID при транзакциях, затрагивающих несколько шардов, может быть непросто.
Теорема CAP: Разделение также связано с теоремой CAP, которая утверждает, что в распределенной системе можно иметь только два из трёх свойств: согласованность, доступность и устойчивость к разделению. При разделении данных системы должны делать выбор между согласованностью (обеспечение одинаковых данных во всех разделах) и доступностью (способность обслуживать запросы даже при отказе некоторых разделов).
Таким образом, разделение данных — это важный метод для масштабирования баз данных, управления большими наборами данных и повышения доступности системы, несмотря на сложности, связанные с обеспечением согласованности и увеличением сложности системы【6†source】【6†source】.
Выбор наилучшего подхода к шардингу базы данных зависит от потребностей вашей организации. И вертикальный, и горизонтальный шардинг имеют свои плюсы и минусы, а решение следует принимать на основе объема данных, сложности запросов и ожидаемого роста пользователей и данных.
Вертикальный шардинг:
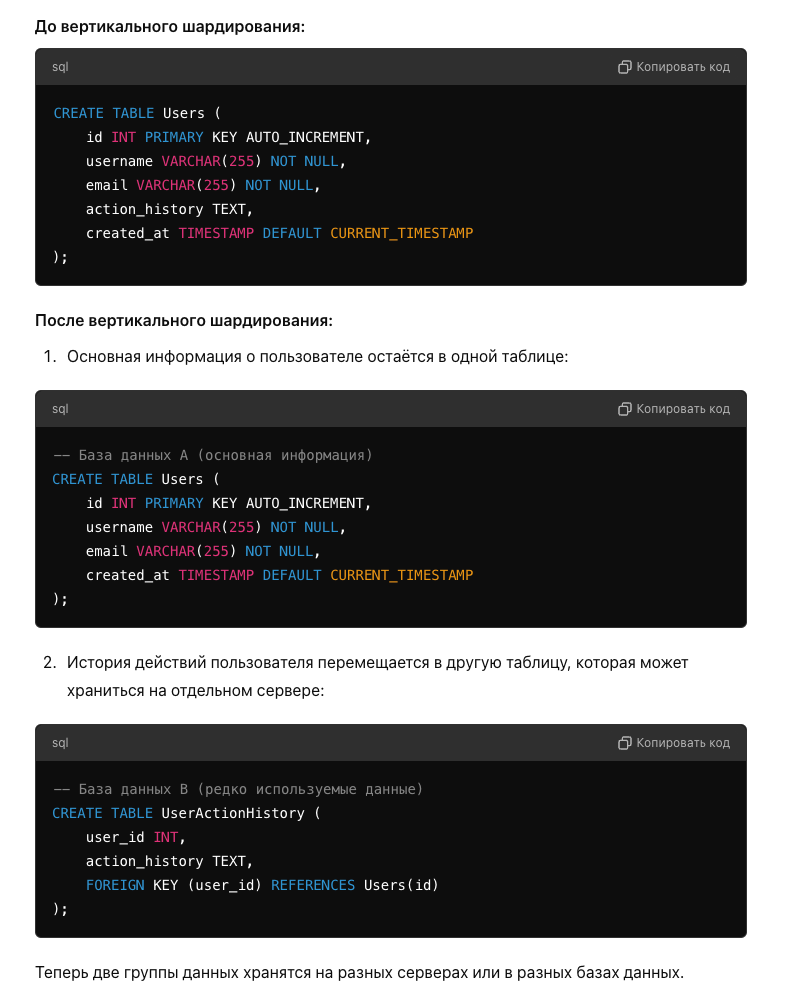
Этот подход делит базу данных по таблицам или столбцам. Он хорошо работает, когда разные части приложения обращаются к разным частям данных. Например, можно отделить большие бинарные объекты (BLOB), такие как изображения, от основных бизнес-данных, чтобы улучшить скорость их извлечения.
Преимущества:
- Подходит для разделения функционала: Разные части приложения используют разные таблицы или столбцы.
- Легче оптимизировать хранение: Можно отделить большие или редко используемые данные, что улучшает производительность чтения более востребованных данных.
- Полезен для независимого масштабирования компонентов системы.
Недостатки:
- Joins становятся сложными, если данные распределены по нескольким серверам, что может замедлить выполнение запросов.
- Ограниченная масштабируемость, если данные в одной таблице быстро растут, поскольку вертикальный шардинг не решает проблемы масштабирования на уровне строк.
Горизонтальный шардинг:
Этот подход делит данные по строкам между несколькими узлами, обычно на основе ключа, например, идентификатора пользователя. Он идеально подходит для масштабирования баз данных с большими наборами данных, распределяя их по различным узлам, каждый из которых хранит часть таблицы.
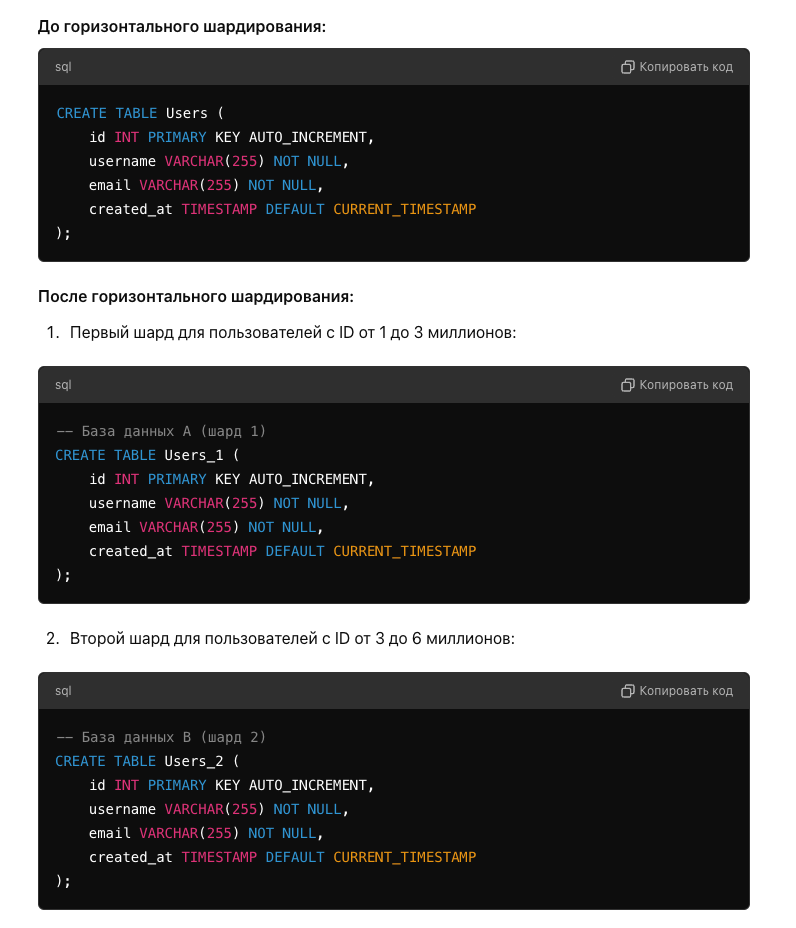
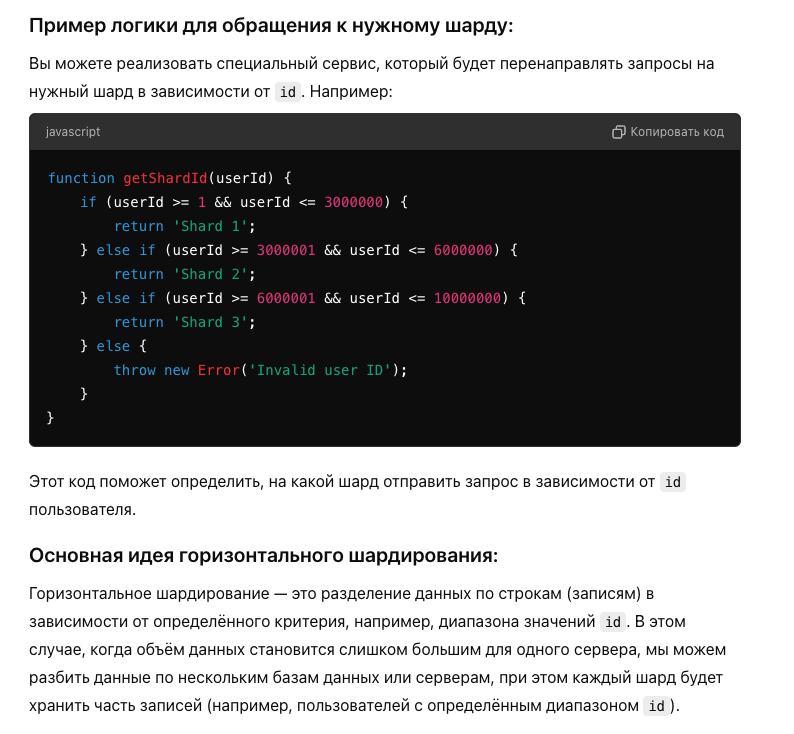
Преимущества:
- Лучшая масштабируемость для больших наборов данных, так как строки распределяются между узлами, позволяя системе обрабатывать больше данных и запросов.
- Отказоустойчивость: Поскольку данные распределены между узлами, сбой одного узла затрагивает только часть данных, а не всю систему.
- Балансировка нагрузки: Чтение и запись распределяются между узлами, что улучшает производительность системы и снижает риски возникновения узких мест.
Недостатки:
- Увеличение сложности в поддержании согласованности данных между узлами, особенно если требуется поддержка свойств ACID.
- Сложность с кросс-шардовыми запросами: Операции, такие как joins и агрегирование, могут стать дорогостоящими, так как данные нужно извлекать с нескольких шардов.
- Сложность ребалансировки данных при добавлении или удалении узлов, что может потребовать перераспределения существующих данных.
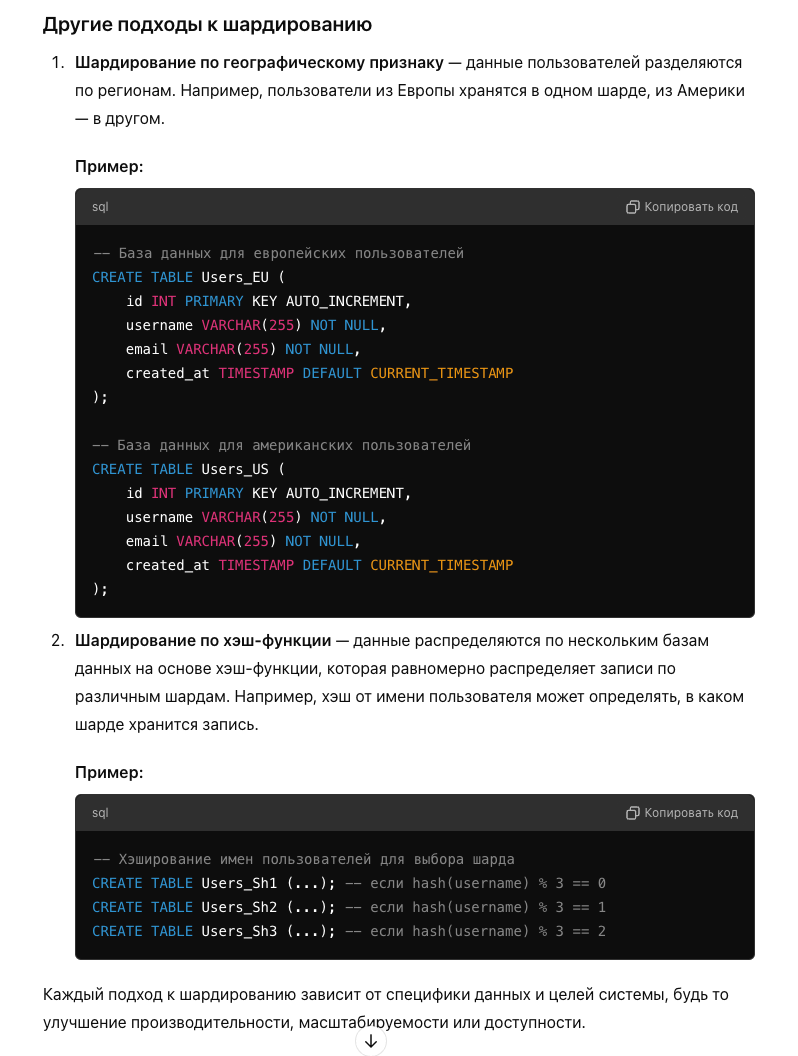
Централизованная база данных (без шардинга):
Для небольших наборов данных или простых приложений централизованная база данных может быть более эффективной и легкой в управлении.
Преимущества:
- Легкое обслуживание данных и более высокая согласованность (транзакции ACID).
- Более простой программный модель для разработчиков.
- Идеально подходит для небольших компаний с ограниченными потребностями в данных.
Недостатки:
- Единственная точка отказа: Если база данных выходит из строя, вся система перестает работать.
- Ограниченная масштабируемость: По мере роста данных и трафика система с одной нодой столкнется с проблемами задержек и в конце концов достигнет пределов производительности.
Вывод:
- Если у вас большие наборы данных или ожидается их быстрый рост, лучше использовать горизонтальный шардинг, так как он распределяет строки между узлами, обеспечивая лучшую масштабируемость и отказоустойчивость.
- Вертикальный шардинг полезен, если вам нужно разделить разные типы данных или функции и масштабировать их независимо.
- Для небольших и простых систем с ограниченными объемами данных может быть наиболее эффективным и экономичным решением централизованная база данных.
Итоговый выбор подхода зависит от конкретных потребностей вашего приложения, шаблонов запросов и ожидаемого роста【6†source】【6†source】.
Подходы к шардингу, такие как вертикальный и горизонтальный, применимы как к SQL, так и к NoSQL базам данных. Однако реализация и распространенность этих методов могут различаться в зависимости от типа базы данных.
SQL (реляционные базы данных):
- Вертикальный и горизонтальный шардинг активно используются в SQL-базах данных. Реляционные базы данных, такие как MySQL, PostgreSQL и Oracle, традиционно применяются для хранения структурированных данных с поддержкой ACID-транзакций. Шардинг помогает SQL базам справляться с увеличивающимися нагрузками и объемами данных.
- SQL-базы данных имеют сложные отношения между таблицами, такие как joins, что может усложнить горизонтальный шардинг. Например, запросы, требующие объединения данных из разных шардов, становятся более дорогими в исполнении.
- ACID-свойства могут усложнить шардинг, особенно при распределении данных по нескольким нодам, так как требуется обеспечение согласованности данных.
NoSQL (нереляционные базы данных):
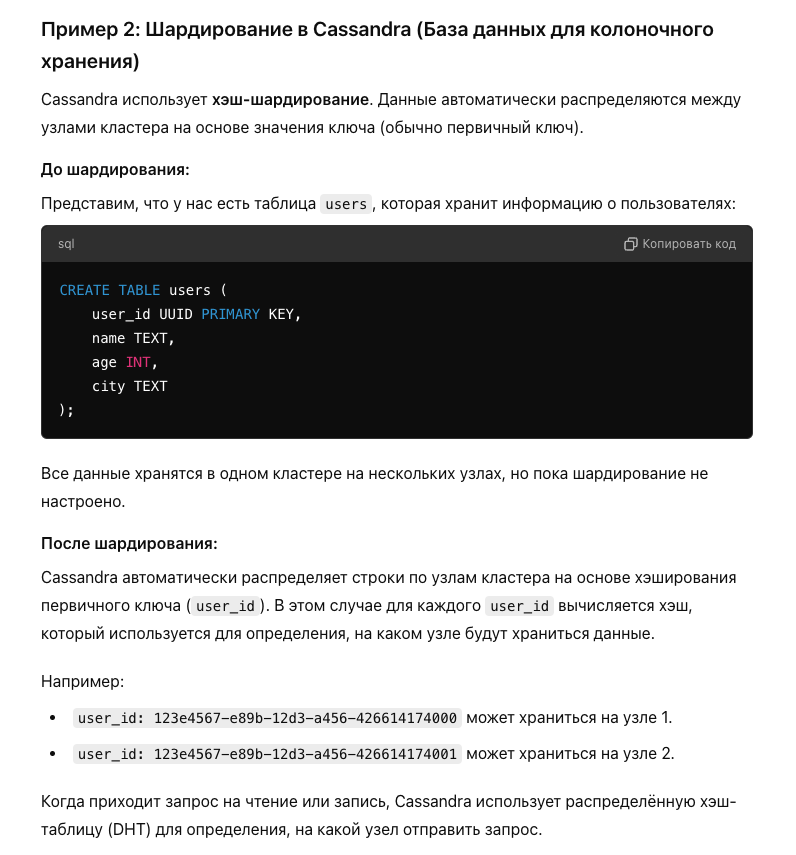
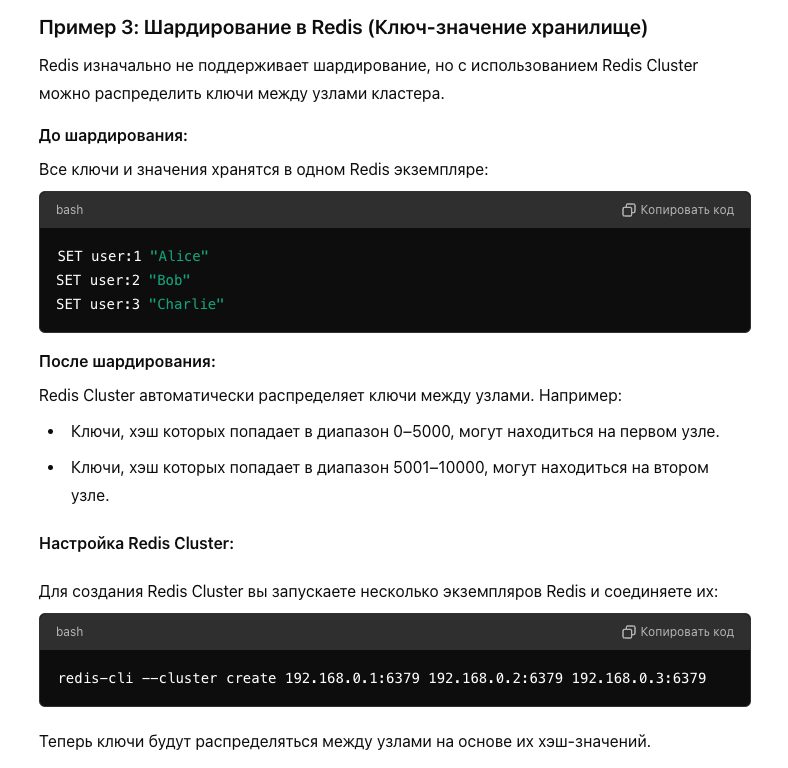
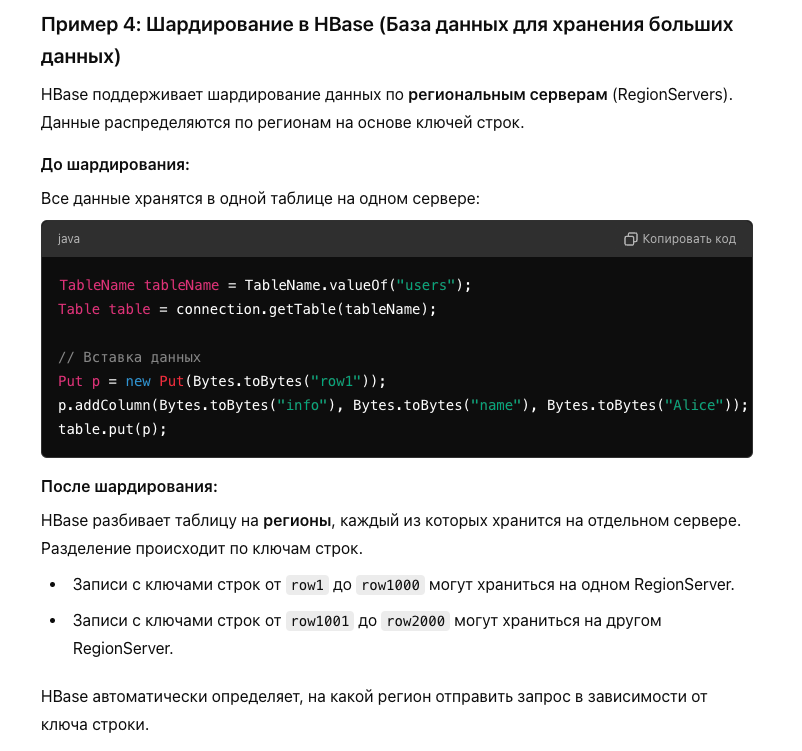
- В NoSQL базах данных, таких как MongoDB, Cassandra, Couchbase, горизонтальный шардинг часто встроен и является основным методом масштабирования. NoSQL ориентированы на работу с большими объемами данных, поэтому они оптимизированы для горизонтального шардинга.
- NoSQL базы часто предоставляют более гибкие схемы данных и могут работать с большими объемами нереляционных данных, что делает горизонтальный шардинг естественным выбором.
- CAP-теорема имеет большее значение в NoSQL системах. NoSQL базы данных могут жертвовать согласованностью (в пользу высокой доступности и устойчивости к разделению), что упрощает шардирование по сравнению с SQL.
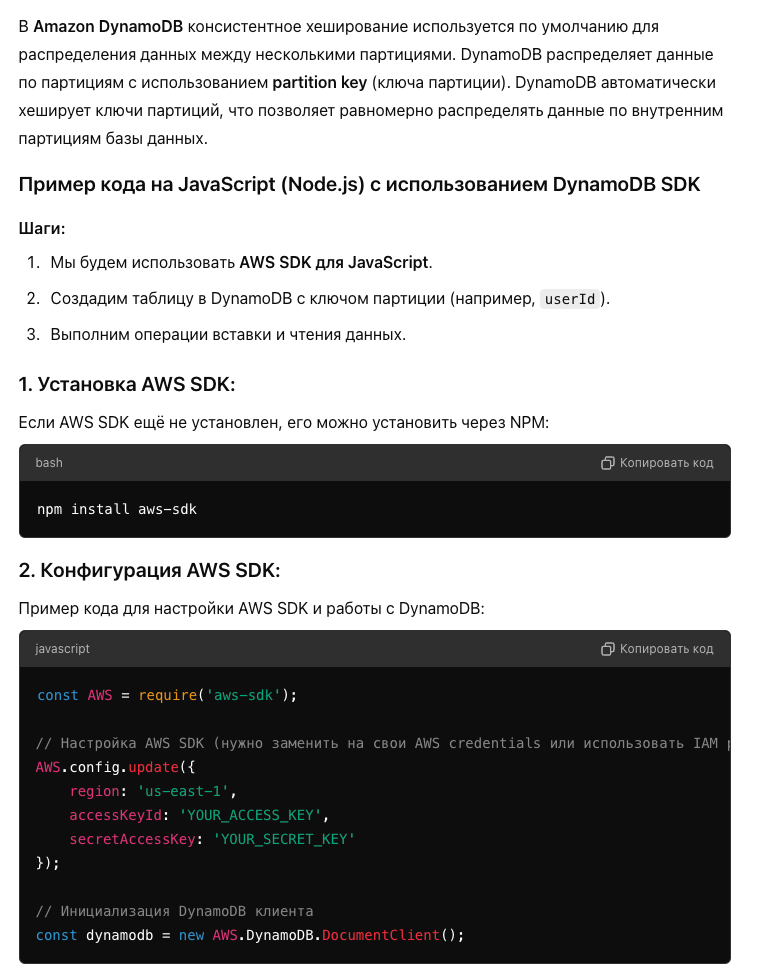
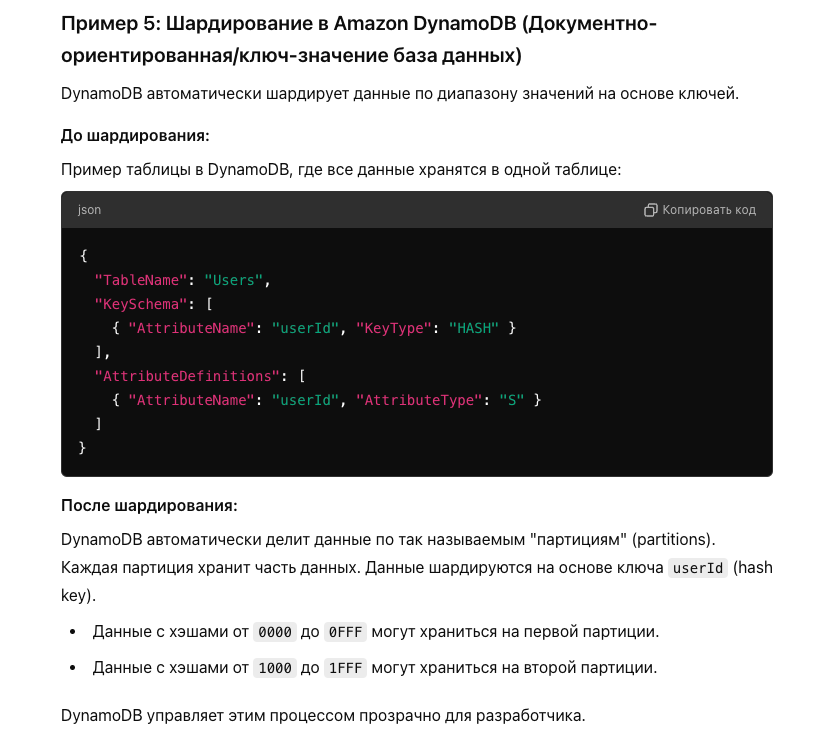
- NoSQL базы данных, такие как Cassandra и DynamoDB, используют консистентное хеширование для распределения данных по шардированным узлам, что помогает сбалансировать нагрузку и избежать горячих точек.
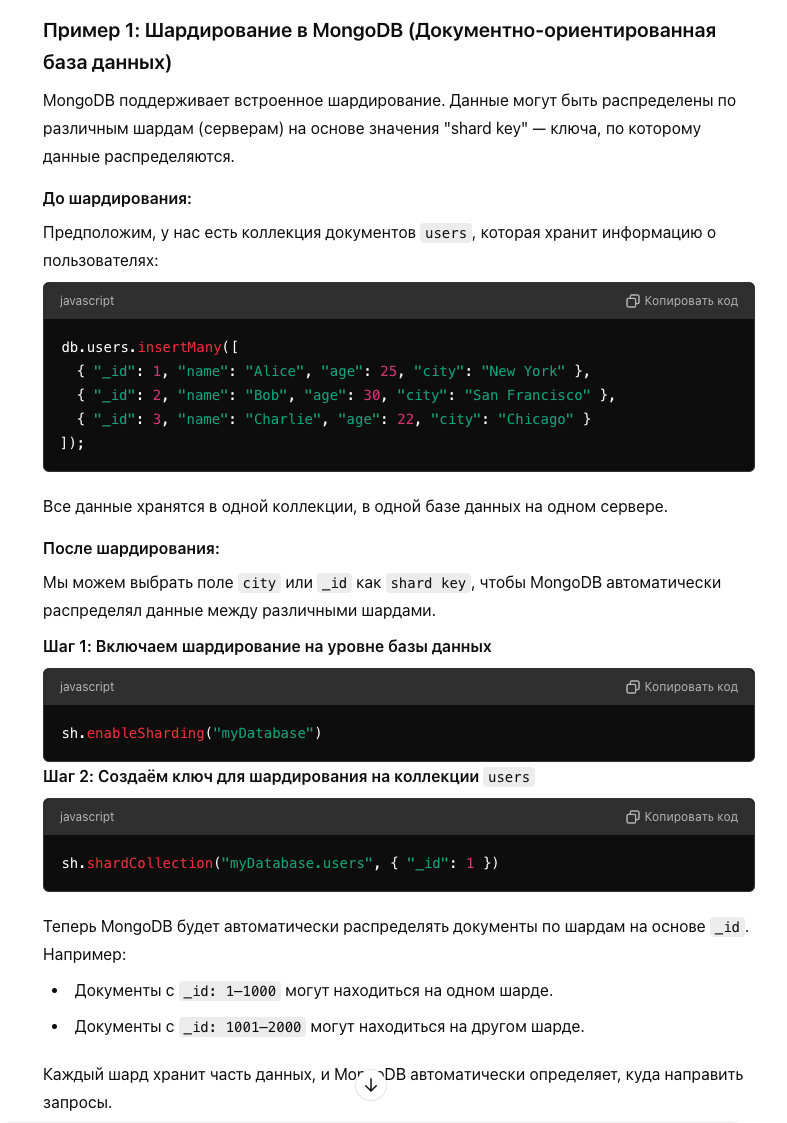
Вывод:
Оба подхода — как вертикальный, так и горизонтальный шардинг — могут использоваться в SQL и NoSQL базах данных, но в NoSQL они более распространены и часто встроены в архитектуру. SQL базы данных также используют шардинг, но из-за своей реляционной природы могут сталкиваться с дополнительными сложностями, такими как поддержка сложных транзакций и запросов.
Replication in Distributed Data Systems
Replication in Distributed Data Systems
Overview
Data replication is a strategy used to ensure availability, scalability, and fault tolerance in distributed data systems. By creating and maintaining copies of data across multiple nodes, the system ensures continuous operation even in the face of hardware or network failures. However, the method introduces challenges like consistency management, write conflicts, and the choice between synchronous or asynchronous replication models.
Key Challenges in Data Replication
- Consistency: How to ensure that data across replicas remains consistent, especially under concurrent writes or failures.
- Fault Tolerance: Managing the failure of replicas and ensuring that data can still be served without interruption.
- Synchronous vs. Asynchronous Replication: Synchronous replication ensures strong consistency but can introduce latency. Asynchronous replication provides low-latency writes but risks losing data during failures.
- Replication Lag: Handling delays in updates being propagated to all replicas.
- Write Conflicts: Especially relevant in multi-leader or peer-to-peer replication where multiple replicas may handle writes concurrently.
Replication Models
1. Single Leader (Primary-Secondary) Replication
- Description: A single leader (primary node) accepts write operations, which are then propagated to follower (secondary) nodes. Read operations can be handled by the leader or any follower.
- Use Case: Read-heavy workloads, where you can offload reads to the followers while keeping writes consistent through the primary.
- Advantages:
- Easy to reason about consistency (followers simply follow the primary).
- Scalable for read-heavy applications.
- Disadvantages:
- Write operations can be bottlenecked by the leader.
- Asynchronous replication risks inconsistency during leader failures.
2. Multi-Leader Replication
- Description: Multiple nodes accept writes, and each leader node propagates changes to other leader nodes and their followers. This approach is more complex due to the possibility of conflicts between writes from different leaders.
- Use Case: Suitable for geographically distributed applications or systems that need to support offline modes (e.g., calendar applications).
- Advantages:
- Higher write availability since any leader can accept writes.
- Better suited for collaborative applications or systems that need to operate even if isolated from other nodes.
- Disadvantages:
- Write conflicts require careful resolution (e.g., last-write-wins, custom conflict resolution).
- More complex to implement than single-leader replication.
3. Peer-to-Peer (Leaderless) Replication
- Description: No single node is designated as the leader. Instead, all nodes can accept reads and writes. This model is common in NoSQL databases like Cassandra.
- Use Case: Systems that require both high read and write scalability, with less focus on strict consistency.
- Advantages:
- High availability and fault tolerance.
- Scales well for both reads and writes.
- Disadvantages:
- Consistency is more difficult to guarantee.
- Quorums are required to handle read and write operations, making coordination more complex.
Synchronous vs. Asynchronous Replication
-
Synchronous Replication:
- The leader waits for acknowledgments from followers before confirming a write operation to the client.
- Pros:
- Strong consistency across replicas.
- Reads from any node provide the latest data.
- Cons:
- High latency for write operations, especially if any follower is slow or unavailable.
-
Asynchronous Replication:
- The leader confirms the write to the client immediately after updating itself, without waiting for follower acknowledgments.
- Pros:
- Low latency for writes.
- Better availability (leader doesn’t block if followers are down).
- Cons:
- Risk of data loss if the leader fails before updates are propagated to followers.
- Reads from different nodes may return stale data (eventual consistency).
CAP Theorem and Replication
- Consistency, Availability, Partition Tolerance (CAP) theorem states that in the presence of network partitions, a distributed system can only guarantee two out of the three: Consistency, Availability, or Partition Tolerance.
- Single Leader Systems tend to choose strong consistency and partition tolerance, sacrificing availability when a network partition occurs.
- Multi-Leader or Peer-to-Peer Systems might favor availability and partition tolerance, allowing data inconsistencies across nodes (eventual consistency).
Strategies for Resolving Conflicts
- Last-Write-Wins: The system uses the latest timestamp to resolve conflicts, though it can cause data loss if the most recent write is not the most important.
- Custom Conflict Resolution: Applications define custom logic to handle conflicts based on business rules.
- Quorums: To ensure consistent reads and writes, a system can use quorum-based approaches where a write is confirmed only when a majority of replicas acknowledge it.
Conclusion
Data replication offers availability, scalability, and performance, but it brings trade-offs in consistency and complexity. The choice of replication model depends on your system's requirements for latency, consistency, and fault tolerance【6†source】 . For example, in low-latency systems like financial platforms, asynchronous replication with eventual consistency may be acceptable, whereas a mission-critical database might require synchronous replication for strict consistency.
Репликация данных в распределенных системах
Обзор
Репликация данных — это стратегия, используемая для обеспечения доступности, масштабируемости и отказоустойчивости в распределенных системах данных. Создавая и поддерживая копии данных на нескольких узлах, система обеспечивает непрерывную работу даже при сбоях оборудования или сети. Однако этот метод приводит к таким вызовам, как управление согласованностью, конфликты при записи и выбор между синхронной и асинхронной репликацией.
Основные сложности репликации данных
- Согласованность: Как обеспечить, чтобы данные на всех репликах оставались согласованными, особенно при одновременных записях или сбоях.
- Отказоустойчивость: Управление отказом реплик и обеспечение того, что данные по-прежнему могут быть обслужены без прерываний.
- Синхронная vs. Асинхронная репликация: Синхронная репликация обеспечивает строгую согласованность, но может повысить задержку. Асинхронная репликация обеспечивает низкую задержку при записях, но рискует потерей данных при сбоях.
- Задержка репликации: Устранение задержек при распространении обновлений на все реплики.
- Конфликты записи: Особенно актуально в многолидерной или одноранговой репликации, где несколько реплик могут одновременно обрабатывать записи.
Модели репликации
1. Репликация с одним лидером (Первичный-вторичный)
- Описание: Один лидер (первичный узел) принимает операции записи, которые затем распространяются на последователей (вторичные узлы). Операции чтения могут выполняться как лидером, так и последователями.
- Применение: Работы с преобладанием операций чтения, где можно распределить нагрузку чтения по последователям, обеспечивая при этом согласованность через лидера.
- Преимущества:
- Простая логика согласованности (последователи просто синхронизируются с лидером).
- Масштабируется для приложений с высокой нагрузкой на чтение.
- Недостатки:
- Операции записи могут стать узким местом для лидера.
- Асинхронная репликация приводит к риску несогласованности при сбое лидера.
2. Многолидерная репликация
- Описание: Несколько узлов принимают записи, и каждый лидер отправляет изменения другим лидерам и их последователям. Этот подход сложнее из-за возможности конфликтов между записями от разных лидеров.
- Применение: Подходит для географически распределенных приложений или систем, которым необходимо поддерживать автономные режимы работы (например, приложения календарей).
- Преимущества:
- Повышенная доступность для записи, так как любой лидер может принимать записи.
- Лучше подходит для совместных приложений или систем, которые должны работать в автономном режиме.
- Недостатки:
- Конфликты записи требуют тщательного разрешения (например, стратегия "последняя запись побеждает", собственные алгоритмы разрешения конфликтов).
- Более сложная реализация по сравнению с репликацией с одним лидером.
3. Одноранговая репликация (без лидера)
- Описание: Нет единого узла-лидера. Вместо этого все узлы могут принимать запросы на чтение и запись. Эта модель часто используется в NoSQL базах данных, таких как Cassandra.
- Применение: Системы, которым требуется как высокая масштабируемость для чтения, так и для записи, при меньшем акценте на строгую согласованность.
- Преимущества:
- Высокая доступность и отказоустойчивость.
- Хорошо масштабируется для операций чтения и записи.
- Недостатки:
- Сложнее обеспечить согласованность данных.
- Для обработки операций чтения и записи требуется использование кворума, что усложняет координацию.
Синхронная vs. Асинхронная репликация
-
Синхронная репликация:
- Лидер ждет подтверждения от последователей перед тем, как подтвердить операцию записи клиенту.
- Плюсы:
- Сильная согласованность между репликами.
- Чтение с любого узла предоставляет самые актуальные данные.
- Минусы:
- Высокая задержка при операциях записи, особенно если какой-либо последователь медленный или недоступен.
-
Асинхронная репликация:
- Лидер сразу подтверждает запись клиенту, не дожидаясь подтверждения от последователей.
- Плюсы:
- Низкая задержка при записях.
- Лучшая доступность (лидер не блокируется, если последователи недоступны).
- Минусы:
- Риск потери данных, если лидер выходит из строя до того, как обновления будут переданы последователям.
- Чтение с разных узлов может возвращать устаревшие данные (в конечном итоге согласованность).
Теорема CAP и репликация
- Теорема CAP (Consistency, Availability, Partition Tolerance — согласованность, доступность, устойчивость к разделению) утверждает, что в условиях сетевых разделений распределенная система может гарантировать только два из трех: согласованность, доступность или устойчивость к разделению.
- Системы с одним лидером обычно выбирают строгую согласованность и устойчивость к разделению, жертвуя доступностью при сетевых разделениях.
- Многолидерные или одноранговые системы могут отдавать предпочтение доступности и устойчивости к разделению, позволяя несогласованности данных на узлах (в конечном итоге согласованность).
Стратегии разрешения конфликтов
- Последняя запись побеждает: Система использует последние метки времени для разрешения конфликтов, хотя это может привести к потере данных, если последняя запись не является самой важной.
- Пользовательская логика разрешения конфликтов: Приложения могут определять собственные алгоритмы для разрешения конфликтов в зависимости от требований бизнеса.
- Кворумы: Для обеспечения согласованных чтений и записей система может использовать подход на основе кворума, где запись считается успешной только при подтверждении большинством реплик.
Заключение
Репликация данных обеспечивает доступность, масштабируемость и производительность, но требует компромиссов в плане согласованности и сложности. Выбор модели репликации зависит от требований вашей системы к задержке, согласованности и отказоустойчивости【6†source】. Например, для систем с низкой задержкой, таких как финансовые платформы, приемлема асинхронная репликация с конечной согласованностью, тогда как для критически важных баз данных может потребоваться синхронная репликация для строгой согласованности.
Описанные принципы репликации данных применимы как к SQL, так и к NoSQL системам. Хотя реализация репликации может немного отличаться в зависимости от типа базы данных, большинство обсуждаемых концепций относятся к обеим категориям:
SQL базы данных:
- Репликация с одним лидером (Primary-Secondary): Широко используется в реляционных базах данных, таких как PostgreSQL или MySQL, где есть четкая структура транзакций и поддержка ACID (атомарность, согласованность, изолированность, долговечность). SQL базы данных часто используют синхронную репликацию для обеспечения строгой согласованности, а также асинхронную для повышения производительности.
- Многолидерная репликация в SQL системах встречается реже из-за сложности управления конфликтами. Однако некоторые базы данных, например MySQL, могут использовать внешние инструменты для реализации этой модели.
NoSQL базы данных:
- В NoSQL системах, таких как Cassandra, MongoDB, DynamoDB, часто используются более гибкие подходы к репликации. Здесь одноранговая репликация (Peer-to-Peer) и многолидерная репликация встречаются чаще, чем в SQL системах, поскольку NoSQL базы данных оптимизированы для горизонтального масштабирования и работы с большими объемами данных с высокой доступностью.
- Асинхронная репликация также очень популярна в NoSQL решениях, поскольку такие системы часто жертвуют строгой согласованностью в пользу доступности и отказоустойчивости (например, eventual consistency — конечная согласованность).
- Кворумы и механизмы согласования версий данных (например, quorum reads/writes) — часто используемые в NoSQL для управления несогласованностью данных между репликами.
Основные различия между SQL и NoSQL в контексте репликации:
- SQL базы данных обычно поддерживают более строгие требования к согласованности и транзакционности. Репликация в таких системах часто более сложна из-за необходимости поддерживать ACID свойства.
- NoSQL базы данных часто выбирают компромисс между согласованностью и доступностью (в рамках теоремы CAP), предлагая более гибкие подходы к репликации и управлению конфликтами, такие как модели с кворумами и случайные разрешения конфликтов.
Таким образом, принципы репликации данных актуальны и для SQL, и для NoSQL баз данных, но подходы к их реализации могут отличаться в зависимости от целей и архитектуры системы.
Шардированные счетчики для лайков, хештегов
Sharded Counters are a technique used in distributed systems to handle large-scale counting operations, particularly when a system needs to perform a high volume of writes, such as tracking likes, views, or clicks on a social media platform. Here's an overview of how they work, scale, and their advantages and disadvantages:
1. What is a Sharded Counter?
A sharded counter is a distributed data structure designed to overcome the write contention on a single counter. Instead of incrementing or decrementing a single counter, the counter is divided (sharded) into multiple independent sub-counters (shards), which can be updated in parallel. The total count is obtained by summing the values of all shards.
2. How Does it Work?
- Sharding the Counter: The counter is broken into multiple shards, each of which can be updated independently. Instead of a single update bottleneck, operations are distributed across different shards.
- Writing to a Counter: When a client increments or decrements the counter, the operation is directed to one of the shards, typically using a hashing function to distribute requests.
- Reading from the Counter: When the total value of the counter is needed, the values of all shards are aggregated (i.e., summed together).
- Parallelism: Since different shards can be updated in parallel, this approach avoids contention that arises from too many concurrent updates to a single counter.
3. How Does it Scale?
- Horizontal Scaling: Sharded counters allow a counter to scale horizontally because each shard can be updated independently. As the system grows, more shards can be added to distribute the load across additional machines.
- Reduced Contention: By spreading write operations across multiple shards, contention is significantly reduced compared to a single counter, where all operations would queue on a single value.
- Fault Tolerance and Replication: Shards can be replicated across multiple nodes for fault tolerance. If one shard is lost or experiences a failure, only a part of the total count is affected, and it can often be restored from replicas.
4. Why is it Important?
- High Write Throughput: Systems like social networks or analytics platforms need to process large numbers of writes (e.g., tracking millions of views or likes). A single counter would be a bottleneck, limiting performance. Sharded counters ensure the system can handle high throughput by distributing load.
- Low Latency: The parallelism of sharded counters enables faster write operations, as updates are performed on multiple counters at once, reducing the time taken to complete each request.
5. Components of a Sharded Counter System
- Shards (Sub-Counters): The individual counters that are incremented independently. Typically, these are stored in a distributed key-value store or database.
- Load Balancer or Hashing Function: Responsible for assigning incoming update requests to the correct shard.
- Aggregation Layer: Summing up the values of all shards when the total count is required.
- Storage: A distributed database or in-memory store that holds the individual shard values, such as Redis, DynamoDB, or Cassandra.
6. How to Use Sharded Counters
- Hash-Based Sharding: You can assign updates to shards using a hash function (e.g., hashing based on a user ID). This ensures uniform distribution across shards.
- Dynamic Sharding: As traffic increases, more shards can be added to the system. The keyspace can be repartitioned dynamically to scale with the system’s growth.
- Data Consistency: For most applications, eventual consistency is acceptable since small delays in summing the shards don’t affect the user experience significantly.
7. Weaknesses of Sharded Counters
- Read Overhead: Summing the values from multiple shards adds overhead to read operations. For applications that require frequent reads, this can increase latency.
- Inconsistent Counts: Since updates are happening in parallel across different shards, reads at any point in time might reflect a slightly inconsistent count. This is due to eventual consistency in distributed systems.
- Hotspots: If shard distribution is not balanced properly, some shards can become hotspots, receiving more updates than others, which can lead to performance bottlenecks.
8. Strengths of Sharded Counters
- High Write Scalability: The primary benefit of sharded counters is their ability to handle a high rate of writes by distributing operations across multiple shards.
- Fault Tolerance: By replicating shards across different nodes, the system can continue to function even if individual shards or nodes fail.
- Dynamic Scaling: Sharded counters can easily scale by adding more shards as traffic increases, making them ideal for systems with unpredictable load spikes.
In summary, sharded counters are critical for applications that need to handle high-frequency write operations, such as social media platforms or real-time analytics systems. They reduce write contention, provide fault tolerance, and allow horizontal scaling, though at the cost of some complexity in reads and potential for inconsistency during aggregation.
Шардингованные счётчики — это техника, используемая в распределённых системах для обработки операций подсчёта в условиях высокой нагрузки, особенно когда система должна выполнять большое количество записей, например, для отслеживания лайков, просмотров или кликов на платформах социальных сетей. Вот краткий обзор того, как они работают, масштабируются, их преимущества и недостатки:
1. Что такое шардингованный счётчик?
Шардингованный счётчик — это распределённая структура данных, которая позволяет преодолеть проблемы с блокировкой записи в одном счётчике. Вместо увеличения или уменьшения одного счётчика, он делится (шардуется) на несколько независимых под-счётчиков (шардов), которые могут обновляться параллельно. Общий счёт получают путём суммирования значений всех шардов.
2. Как работает?
- Разделение счётчика: Счётчик разбивается на несколько шардов, каждый из которых может обновляться независимо. Вместо единой точки записи, операции распределяются по разным шардам.
- Запись в счётчик: Когда клиент увеличивает или уменьшает значение счётчика, операция направляется на один из шардов, обычно с использованием хеш-функции для распределения запросов.
- Чтение счётчика: Для получения общего значения счётчика значения всех шардов агрегируются (суммируются).
- Параллелизм: Поскольку разные шарды могут обновляться параллельно, этот подход устраняет узкие места, возникающие при попытке обновить один счётчик.
3. Как масштабируется?
- Горизонтальное масштабирование: Шардингованные счётчики позволяют горизонтально масштабировать систему, так как каждый шард может обновляться независимо. По мере роста системы можно добавлять больше шардов для распределения нагрузки между несколькими машинами.
- Снижение конкуренции: Благодаря распределению операций записи по нескольким шардам, значительно снижается конкуренция за ресурсы по сравнению с использованием одного счётчика, где все операции происходят последовательно.
- Отказоустойчивость и репликация: Шарды могут реплицироваться на нескольких узлах для повышения отказоустойчивости. В случае потери одного шарда лишь часть общего счёта будет затронута, и её можно восстановить из реплик.
4. Почему это важно?
- Высокая пропускная способность записей: Такие системы, как социальные сети или аналитические платформы, обрабатывают огромное количество записей (например, миллионы просмотров или лайков). Одиночный счётчик стал бы узким местом, ограничивающим производительность. Шардингованные счётчики обеспечивают возможность обработки высокой нагрузки за счёт распределения операций.
- Низкая задержка: Параллельность в шардингованных счётчиках позволяет быстрее выполнять операции записи, так как обновления производятся сразу в нескольких местах, что сокращает время отклика.
5. Из каких компонентов состоит шардингованный счётчик?
- Шарды (подсчётчики): Отдельные счётчики, которые обновляются независимо. Обычно хранятся в распределённом хранилище ключ-значение или базе данных.
- Балансировщик нагрузки или хеш-функция: Отвечает за распределение входящих запросов на обновление между шардами.
- Слой агрегации: Суммирует значения всех шардов, когда необходимо получить общий счёт.
- Хранилище: Распределённая база данных или хранилище в памяти для хранения отдельных шардов, например, Redis, DynamoDB или Cassandra.
6. Как использовать шардингованные счётчики?
- Хеширование для шардинга: Операции записи можно распределять по шардам с помощью хеш-функции (например, хеширование на основе идентификатора пользователя). Это обеспечивает равномерное распределение нагрузки по шардам.
- Динамическое шардинг: По мере увеличения нагрузки можно добавлять больше шардов. Пространство ключей можно динамически перераспределять для масштабирования вместе с ростом системы.
- Консистентность данных: В большинстве приложений приемлема eventual consistency (конечная согласованность), поскольку небольшие задержки при суммировании шардов не оказывают значительного влияния на пользовательский опыт.
7. Слабые стороны шардингованных счётчиков
- Затраты на чтение: Суммирование значений из нескольких шардов увеличивает время на операции чтения. Для приложений, которым нужно часто читать данные, это может повысить задержку.
- Несогласованные значения: Поскольку обновления происходят параллельно в разных шардах, при чтении в любой момент времени может отразиться немного несогласованное значение из-за eventual consistency (конечной согласованности).
- Горячие точки: Если распределение шардов настроено неправильно, некоторые из них могут стать «горячими точками», получая больше обновлений, что создаёт узкое место в производительности.
8. Сильные стороны шардингованных счётчиков
- Высокая масштабируемость записей: Основное преимущество шардингованных счётчиков — это способность обрабатывать большое количество операций записи за счёт распределения нагрузки между несколькими шардами.
- Отказоустойчивость: Реплицируя шарды на разные узлы, система может продолжать работать даже при выходе из строя отдельных шардов или узлов.
- Динамическое масштабирование: Шардингованные счётчики можно легко масштабировать, добавляя больше шардов по мере увеличения трафика, что делает их идеальными для систем с непредсказуемыми нагрузками.
Таким образом, шардингованные счётчики играют важную роль в системах, где необходимо обрабатывать частые операции записи, таких как социальные сети или системы аналитики в реальном времени. Они уменьшают конкуренцию за ресурсы, обеспечивают отказоустойчивость и поддерживают горизонтальное масштабирование, хотя при этом могут возникать сложности с консистентностью и повышенными затратами на чтение.