Monitoring Server-side Errors
Design of a Monitoring System
Requirements
Подытожим, что мы хотим, чтобы наша система мониторинга выполняла:
-
Мониторинг критических локальных процессов на сервере для обнаружения сбоев.
-
Мониторинг любых аномалий в использовании процессора, памяти, диска или пропускной способности сети процессом на сервере.
-
Мониторинг общего состояния сервера, включая процессор, память, диск, пропускную способность сети, среднюю нагрузку и так далее.
-
Мониторинг неисправностей аппаратных компонентов на сервере, таких как сбои памяти, выход из строя или замедление диска и так далее.
-
Мониторинг способности сервера достигать критических внешних сервисов, таких как сетевые файловые системы и так далее.
-
Мониторинг всех сетевых коммутаторов, балансировщиков нагрузки и любого другого специализированного оборудования внутри дата-центра.
-
Мониторинг потребления энергии на уровне сервера, стойки и дата-центра.
-
Мониторинг любых событий, связанных с энергопотреблением на серверах, стойках и в дата-центре.
-
Мониторинг информации о маршрутизации и DNS для внешних клиентов.
-
Мониторинг задержки сетевых связей и путей внутри и между дата-центрами.
-
Мониторинг состояния сети в точках взаимосвязи.
-
Мониторинг общего состояния сервиса, который может охватывать несколько дата-центров, например, CDN и его производительность.
Мы хотим автоматизированный мониторинг, который выявляет аномалии в системе и информирует менеджера по предупреждениям или отображает прогресс на панели управления. Провайдеры облачных услуг предоставляют статус здоровья своих сервисов:
- AWS: AWS Health Status
- Azure: Azure Status
- Google: Google Cloud Status
In a distributed system, why is a dedicated monitoring solution necessary instead of simply relying on individual server logs?
State your reasoning in the widget below.
Details
In a distributed system, a dedicated monitoring solution is necessary for several key reasons:
Centralized visibility across the entire system: This allows for an overarching view of the system’s health and performance, making it easier to manage and monitor.
Detecting correlations and patterns that individual logs would miss: By analyzing data from across the system, a monitoring solution can identify issues that may not be apparent when looking at logs from a single server or component.
Proactive alerts and faster troubleshooting: A dedicated monitoring system can be configured to send alerts about potential issues before they become critical, enabling quicker response and resolution times.
These aspects are crucial for maintaining the reliability and performance of distributed systems.
Building Block We Will Use
В дизайне распределенной системы мониторинга будут использоваться следующие ключевые элементы:
- Blob Storage: Мы будем использовать блоб-хранилище для хранения информации о метриках.
High-level Design
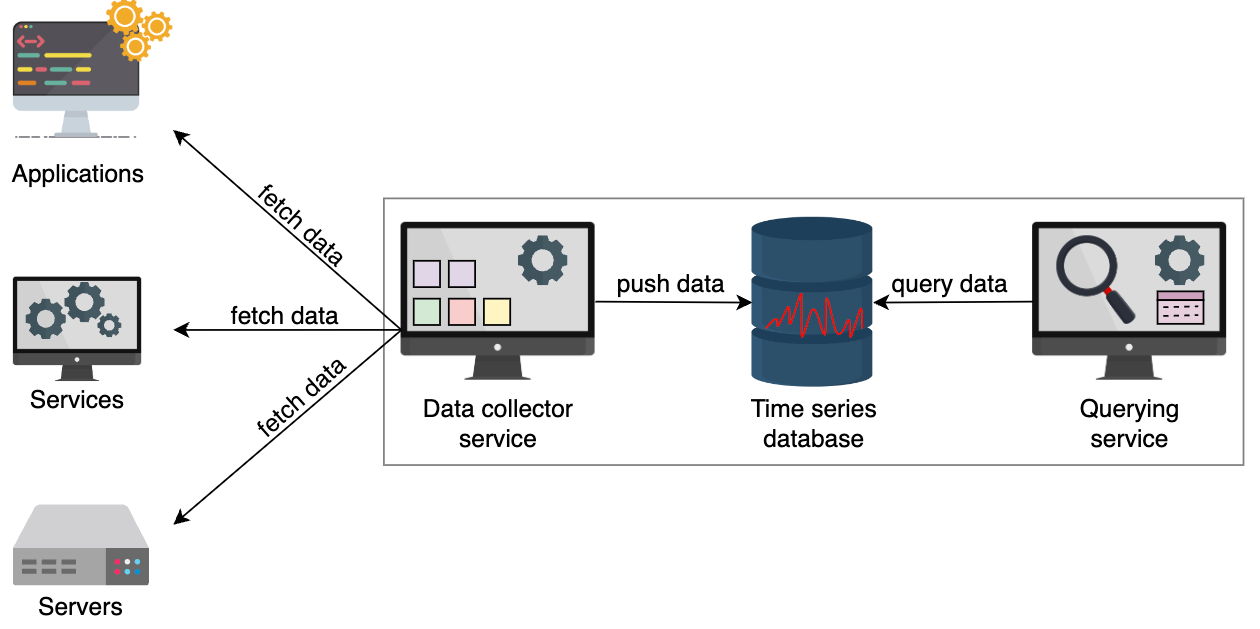
Основные компоненты нашей системы мониторинга:
-
Storage (Хранилище): База данных временных рядов для хранения данных о метриках, таких как текущая загрузка процессора или количество исключений в приложении.
-
Data Collector Service (Сервис сбора данных): Этот сервис извлекает соответствующие данные с каждого сервиса и сохраняет их в хранилище.
-
Querying Service (Сервис запросов): Это API, которое может выполнять запросы к базе данных временных рядов и возвращать соответствующую информацию.
Detailed Design of a Monitoring System
Storage
Мы будем использовать базы данных временных рядов для локального сохранения данных на сервере, где работает наша служба мониторинга. Затем мы интегрируем это с отдельным узлом хранения. Для хранения наших метрик будем использовать блоб-хранилище.
Правила и действия
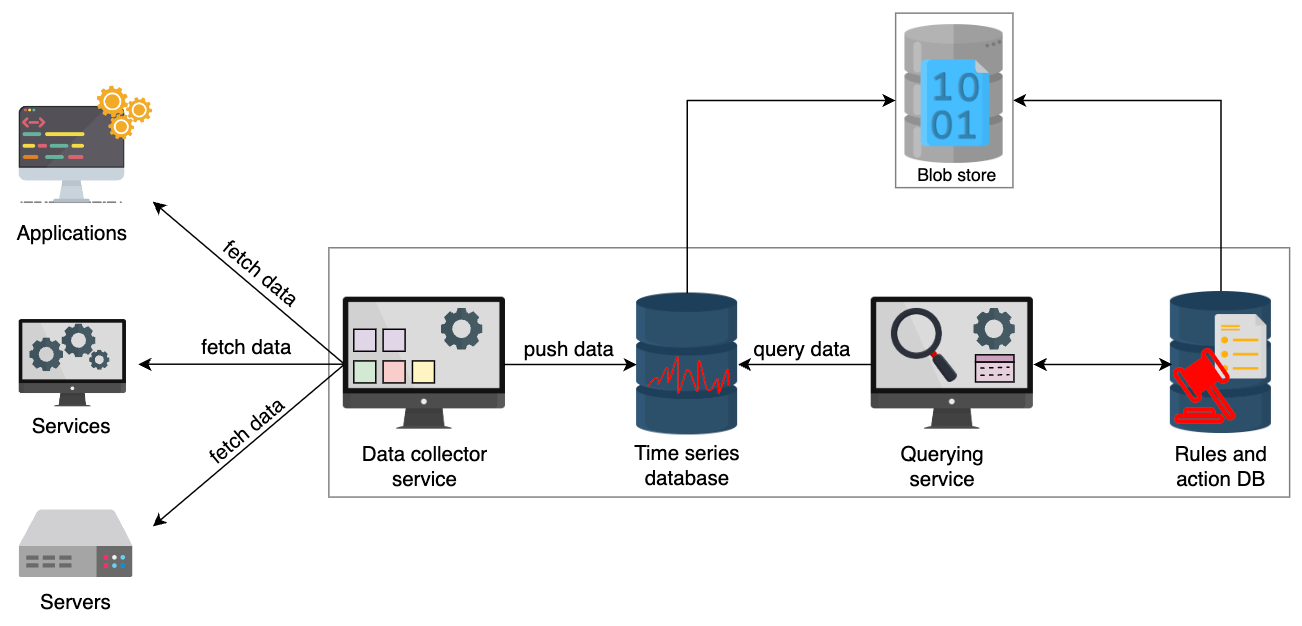
Нам нужно хранить метрики и знать, какие действия предпринимать, если метрика достигла определенного значения. Например, если использование CPU превышает 90%, мы генерируем оповещение для конечного пользователя, чтобы получатель оповещения мог предпринять необходимые шаги, такие как выделение дополнительных ресурсов для масштабирования. Для этого нам нужна еще одна область хранения, которая будет содержать правила и действия. Назовем ее Rules Database (База данных правил). В случае нарушения правил мы можем предпринять соответствующие действия.
Компоненты
Таким образом, мы определили два дополнительных компонента в нашем дизайне:
- Rules and Action Database (База данных правил и действий)
- Storage Node (Узел хранения) - Blob Storage
Data Collector
Для того чтобы система мониторинга могла обновлять нас о состоянии наших многочисленных дата-центров, нам нужно, чтобы информация о процессах достигала нас через логирование. Мы выберем стратегию pull. Затем мы извлечем соответствующие метрики из логов приложения.
Как обсуждалось в нашем дизайне логирования, мы использовали распределенную очередь сообщений. Сообщение в очереди содержит название сервиса, ID и краткое описание лога. Это поможет нам идентифицировать метрику и информацию для конкретного сервиса. Важно, чтобы сервисы экспонировали соответствующие метрики для сбора данных, чтобы наш Data Collector мог получить эти метрики из сервиса и сохранить их в базе данных временных рядов.
Реальный пример системы мониторинга, основанной на подходе pull, — это DigitalOcean. Они мониторят миллионы машин, распределенных по всему миру.
What are some drawbacks of using a push-based approach?
Details
The push-based monitoring tool collects metric data from the applications and servers and sends it to a central collection platform. Each microservice sends its metrics to the monitoring system, resulting in a heavy traffic load on the infrastructure. This is how monitoring might become a bottleneck for business operations. The monitoring can be near real-time. However, if appropriate care isn’t taken, it can overwhelm the infrastructure with continual push requests from all services, resulting in network floods. We must also install daemons on each of these targets to send metrics to the monitoring server, which requires additional work.
Service Discoverer
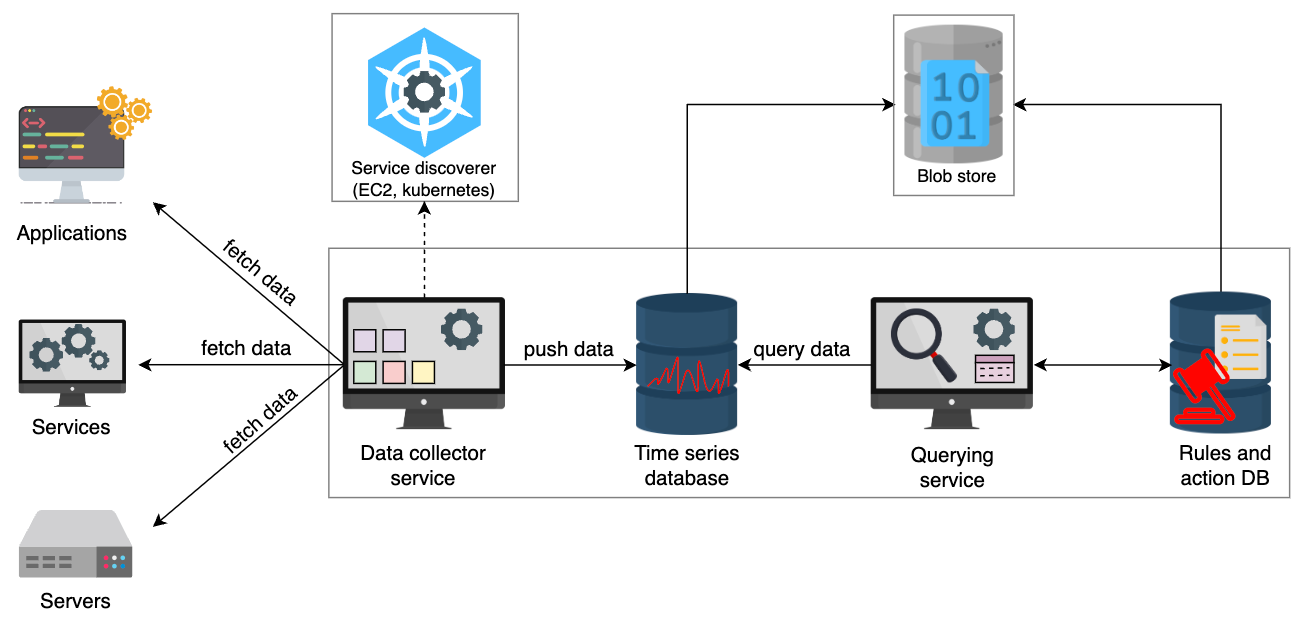
Service Discoverer отвечает за нахождение и отслеживание сервисов, которые нужно мониторить. Таким образом, система мониторинга не обязана вести учет всех сервисов. Вместо этого она может находить их с помощью сервиса обнаружения.
Мы будем сохранять относительную информацию о сервисах, которые необходимо мониторить. Для этого мы используем решение для Service Discovery и интегрируем его с несколькими платформами и инструментами, такими как EC2, Kubernetes и Consul. Это позволит нам автоматически находить сервисы, которые нужно мониторить. Подобное динамическое обнаружение также может использоваться для нового оборудования, введенного в эксплуатацию.
Давайте добавим наш недавно идентифицированный компонент в существующий дизайн.
Querying Service
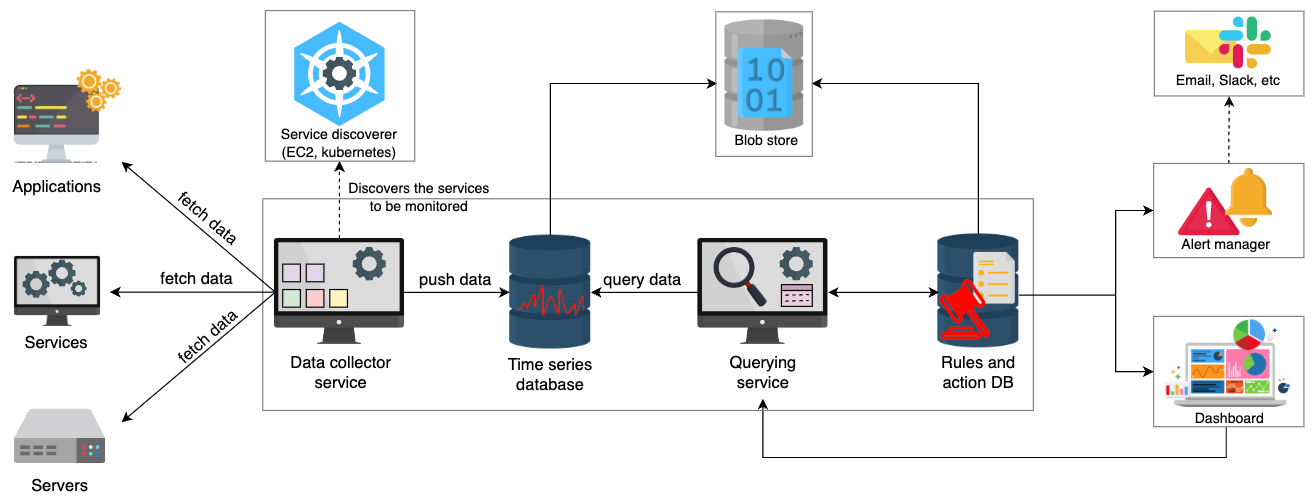
Мы хотим создать сервис, который будет обращаться к базе данных и извлекать соответствующие результаты запросов. Это необходимо, чтобы мы могли просматривать ошибки, такие как значения использования памяти на конкретном узле, или отправлять предупреждения, если какой-то показатель превышает установленный предел. Давайте добавим два необходимых компонента вместе с Querying Service.
Alert Manager
Alert Manager отвечает за отправку уведомлений при нарушении установленных правил. Он может отправлять уведомления по электронной почте, через Slack и другими способами.
Dashboard
Мы можем настроить Dashboard для отображения необходимой информации на основе собранных метрик — например, количество запросов за текущую неделю.
Давайте добавим обсуждаемые компоненты, чтобы завершить наш дизайн системы мониторинга.
Our Monitoring Service
Наше комплексное решение для мониторинга отлично подходит для активного отслеживания систем и сервисов. Оно собирает и сохраняет данные, поддерживает поиск, графики и отправку уведомлений.
Pros
- Непрерывность работы: Дизайн нашей системы мониторинга обеспечивает бесперебойную работу операций и следит за признаками надвигающихся проблем.
- Минимальная нагрузка на сеть: Наша система мониторинга избегает перегрузки сетевого трафика, самостоятельно извлекая необходимые данные.
- Высокая доступность: Мониторинговая система обеспечивает высокую доступность.
Cons
-
Масштабируемость: Хотя система кажется масштабируемой, управление большим количеством серверов может стать проблемой. Например, если у нас есть выделенный сервер, ответственный за запуск службы мониторинга, это может стать единой точкой отказа (SPOF). Для решения этой проблемы можно добавить резервный сервер для системы мониторинга. Однако это потребует поддержания консистентности между основным и резервным серверами. Тем не менее, такая архитектура также может столкнуться с ограничениями по масштабируемости при дальнейшем увеличении числа серверов.
-
Хранение данных: Мониторинг собирает огромное количество данных 24/7, и их постоянное хранение может оказаться нецелесообразным. Нам необходима политика и механизмы для периодического удаления ненужных данных, чтобы эффективно использовать ресурсы.
Improving Our Design
Мы хотим улучшить наш дизайн, чтобы наша система лучше масштабировалась и могла решать, какие данные сохранять, а какие удалять. Рассмотрим, как работает подход на основе push-модели. В push-модели приложение само отправляет свои данные в систему мониторинга.
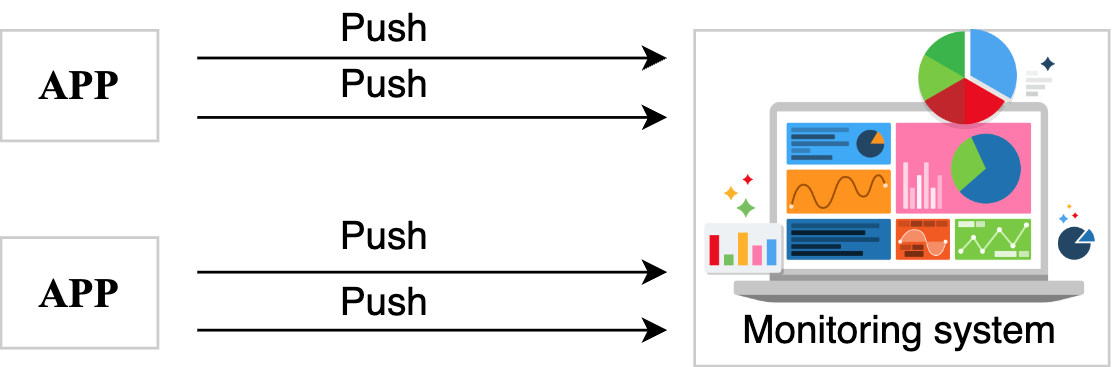
Мы использовали стратегию на основе pull, чтобы избежать перегрузки сети. Это также освобождает приложения от необходимости отправлять данные мониторинга в систему. Вместо этого система мониторинга сама извлекает или "тянет" данные. Чтобы удовлетворить потребности в масштабировании, нам нужно применить и push-подход. Мы будем использовать гибридный подход, сочетая pull и push стратегии.
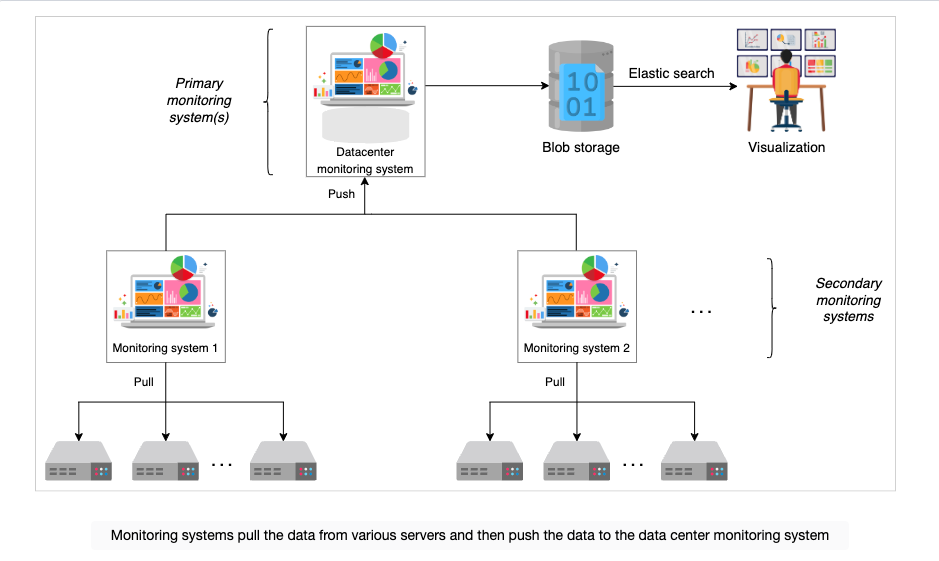
Мы продолжим использовать pull-стратегию для нескольких серверов в рамках одного дата-центра. Также мы назначим несколько серверов мониторинга для сотен или тысяч серверов в дата-центре — например, один сервер будет мониторить 5000 серверов. Мы назовем их вторичными серверами мониторинга.
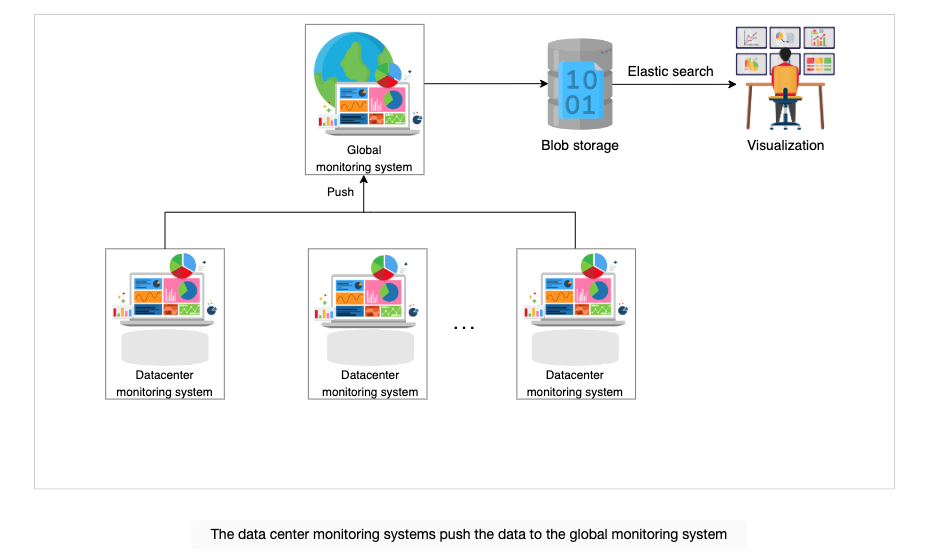
Теперь мы применим push-стратегию. Вторичные системы мониторинга будут отправлять свои данные на главный сервер дата-центра. Главный сервер дата-центра будет передавать свои данные в глобальную службу мониторинга, которая отвечает за проверку всех дата-центров по всему миру.
Мы будем использовать блоб-хранилище для хранения избыточных данных, применять elastic search и просматривать наши актуальные показатели с помощью визуализатора. По мере увеличения количества серверов или дата-центров, мы будем добавлять больше систем мониторинга.
Note: Использование иерархии систем для масштабирования — это распространенный шаблон в проектировании систем. Увеличивая количество узлов на уровне или вводя дополнительные уровни в иерархии, мы получаем возможность масштабироваться в соответствии с текущими потребностями.
What happens if a local or global monitoring system is down?
Details
We can store the data locally and wait for the system to be up and running again. But there’s a limit for the local data storage. So, either we delete previous data or we don’t store new data. To make a decision, relevant policies need to be created.
How can a monitoring system reliably work if it uses the same infrastructure in a data center that it was supposed to monitor? Consider this given that a failure of a network in a data center can knock out the monitoring components.
Details
The actual deployment of a monitoring system needs special care. We might have an internal, monitoring-specific network to isolate it from the common network. We should use a separate instance of blob stores and other services.
It also helps to have external components to the monitoring, where external might mean an independent service provider’s infrastructure. However, designing such a system is complex and is more expensive.
Humans need to consume enormous amounts of data, and even after different kinds of data summarizations, the data can still be huge. Next, we’ll tackle how to present enormous data to human administrators.
Visualize Data in a Monitoring System - Визуализация данных в системе мониторинга
Крупные дата-центры содержат миллионы серверов, и визуализация данных о состоянии всех этих серверов представляет собой сложную задачу. Важным аспектом мониторинга большого числа серверов является понимание, какие из них активны, а какие вышли из строя. Современный дата-центр может вместить тысячи серверов в одном здании. Мы можем использовать тепловую карту (heat map) для компактного отображения информации о тысячах серверов в дата-центре.
Тепловая карта — это метод визуализации данных, который отображает величину явления в двух измерениях с помощью цветов.
Использование тепловых карт для устранения неполадок
Мы будем определять, не работает ли сервер, с помощью тепловых карт. Каждая стойка серверов имеет название и сортируется по дата-центру, затем по кластеру, затем по ряду, так что проблемы, общие для любого из этих уровней, легко заметны.
Тепловая карта, отображающая состояние работы большого числа компонентов, является эффективным методом. Состояние каждого компонента обозначается цветом каждой ячейки в большой матрице. Узлы с зелеными ячейками работают в пределах допустимых параметров, а узлы с красными ячейками не реагируют на множественные запросы.
Ниже представлена тепловая карта, отображающая состояние серверов.
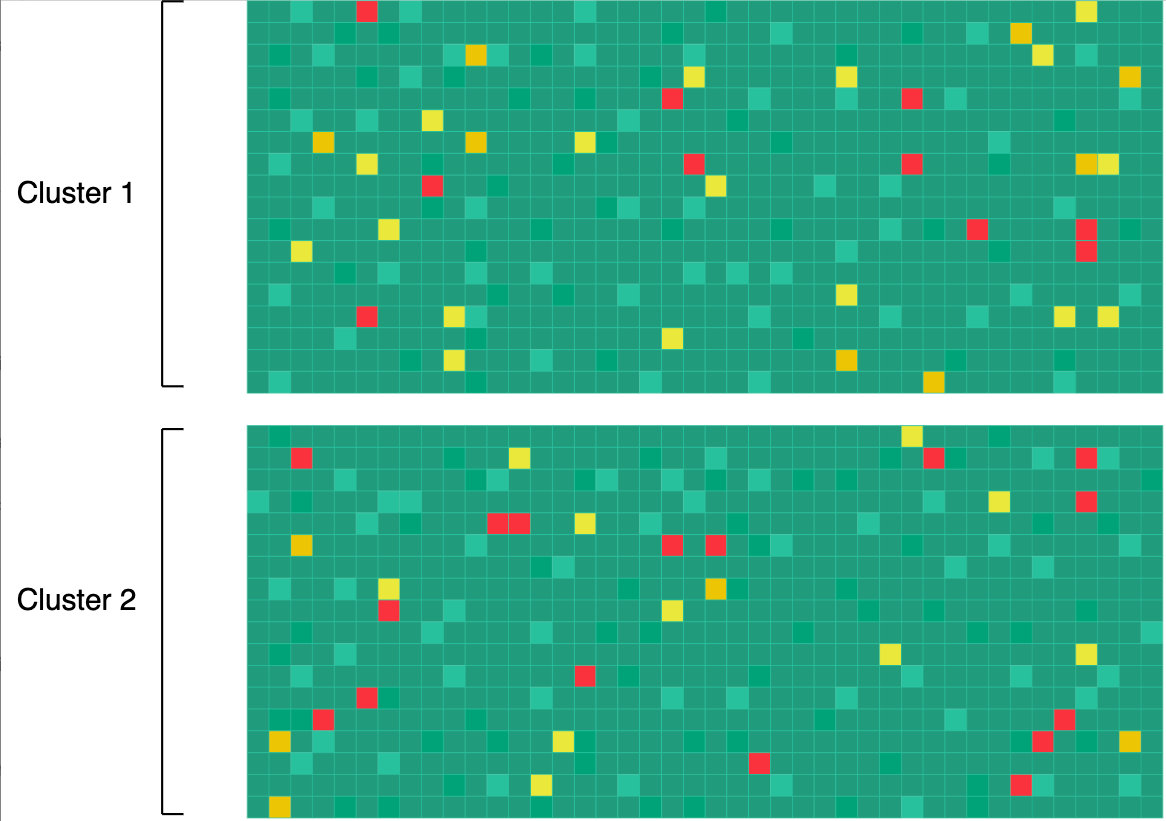
Мы можем использовать тепловые карты для глобально распределенных систем и постоянно обмениваться информацией о состоянии серверов. Для этого можно использовать один бит: единица для живого сервера и ноль для вышедшего из строя. Для мониторинга 1,000,000 серверов потребуется всего 125 КБ данных. Мы можем быстро определить, какой сервер не работает, по красному цвету на карте, и сосредоточиться на проблемных участках.
Мы также можем создавать аналогичные тепловые карты для получения общего представления о любых ресурсах, таких как файловые системы, сетевые коммутаторы, соединения и т.д.
Monitoring can be a tricky subject in system design interviews. Are you confident in what you’ve learned so far?
Details
Part 1 of Revision: Define the Models Pull-based monitoring: The central monitoring system periodically “pulls” metrics by sending requests to the monitored servers and retrieving the data. Push-based monitoring: Monitored servers actively “push” metrics to the central monitoring system at predetermined intervals.
Part 2 of Revision: Scenario Analysis Pull - Potential network congestion and scalability issues on the monitoring server itself. Push: Potential for overwhelming the central collection point and data loss if local agents are unreliable.
Резюме
Системы мониторинга критически важны в распределённых системах, так как они помогают анализировать систему и предупреждать заинтересованные стороны в случае возникновения проблем.
Мы можем сделать систему мониторинга масштабируемой, используя гибридный подход, сочетающий методы push и pull.
Тепловые карты являются мощным инструментом для визуализации и помогают быстро оценить состояние тысяч серверов в компактном формате.