YouTube
YouTube system design
YouTube — это популярный видеостриминговый сервис, где пользователи загружают, стримят, ищут, комментируют, делятся и ставят лайки или дизлайки видео. Крупные компании, а также частные лица ведут каналы, на которых размещают свои видео. YouTube позволяет бесплатно размещать видеоконтент, который можно делиться с пользователями по всему миру. YouTube считается основным источником развлечений, особенно среди молодежи, и, по данным Wikipedia на 2022 год, он занимает второе место по количеству просмотров после Google.
Популярность YouTube
Некоторые из причин, по которым YouTube набрал популярность за эти годы, включают следующие:
- Простота: YouTube имеет простой, но мощный интерфейс.
- Богатый контент: Благодаря простому интерфейсу и бесплатному хостингу, YouTube привлек большое количество создателей контента.
- Постоянное улучшение: Команда разработчиков YouTube непрерывно работала над тем, чтобы удовлетворить требования к масштабируемости со временем. Кроме того, Google приобрел YouTube в 2007 году, что повысило его авторитет.
- Источник дохода: YouTube разработал партнерскую программу, которая позволяет создателям контента зарабатывать деньги на своем вирусном контенте.
Кроме вышеперечисленных причин, YouTube также сотрудничал с крупными игроками рынка, такими как CNN и NBC, чтобы укрепить свои позиции.
Рост YouTube
Рассмотрим несколько интересных статистических данных о YouTube и его популярности.
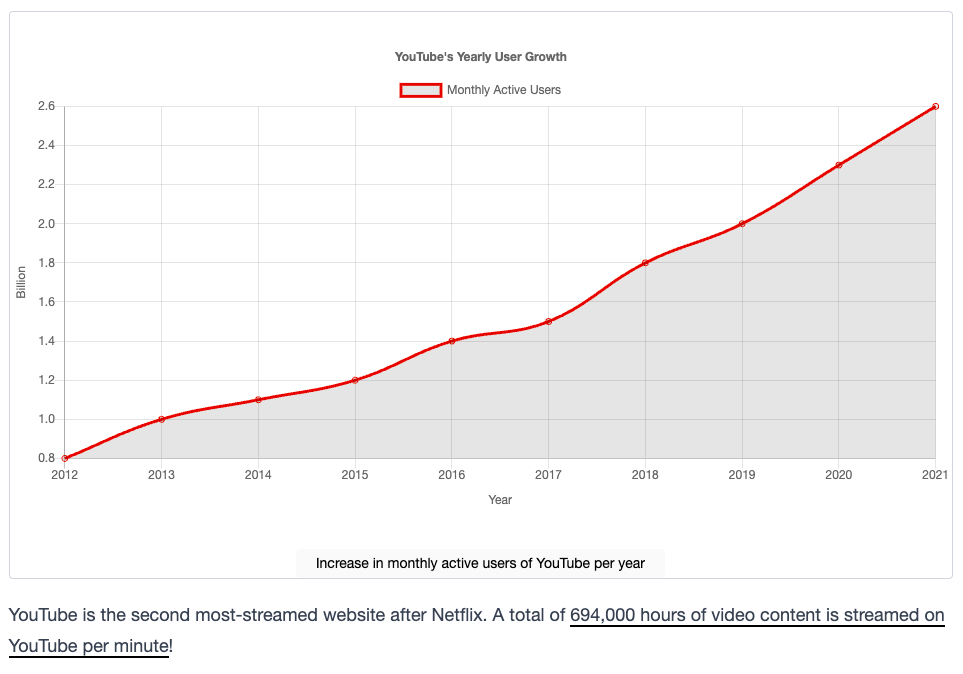
С момента своего основания в феврале 2005 года количество пользователей YouTube увеличилось многократно. На данный момент насчитывается более 2,5 миллиардов активных пользователей YouTube ежемесячно. Давайте взглянем на график ниже, чтобы увидеть, как количество пользователей YouTube увеличивалось за последнее десятилетие.
 https://www.statista.com/statistics/195140/new-user-generated-content-uploaded-by-users-per-minute/
Let’s evaluate your understanding of the building blocks required in the design of YouTube. Based on the functional and nonfunctional requirements given below, identify three key building blocks needed to curate the design of YouTube.
Functional requirements
- Stream videos
- Upload videos
- Search videos according to titles
- Like and dislike videos
- Add comments to videos
- View thumbnails
Nonfunctional requirements
- High availability
- Scalability
- Good performance
The three key building blocks required to design a system like YouTube are
- Databases, which are essential for storing metadata of videos, thumbnails, comments, and user information.
- Blob storage, crucial for holding all the videos on the platform.
- A Content Delivery Network (CDN), which is vital for efficiently delivering content to end users, minimizing delays and reducing the load on the primary servers.
Как мы будем проектировать YouTube?
Мы разделили проектирование YouTube на пять уроков:
-
Требования: Здесь мы определяем функциональные и нефункциональные требования. Мы также оцениваем ресурсы, необходимые для обслуживания миллионов пользователей каждый день. Этот урок отвечает на такие вопросы, как: сколько места для хранения потребуется YouTube, чтобы сохранить 500 часов видеоконтента, загружаемого на платформу каждую минуту.
-
Проектирование: В этом уроке мы объясняем, как будем проектировать сервис YouTube. Мы также кратко рассматриваем дизайн API и схемы баз данных. Наконец, мы кратко рассмотрим, как работает поиск на YouTube.
-
Оценка: Этот урок объясняет, как YouTube может выполнить все требования через предложенный дизайн. Мы также рассмотрим, как масштабирование в будущем может повлиять на систему и какие решения потребуются для решения проблем масштабирования.
-
Реальность сложнее: В этом уроке мы исследуем различные техники, которые YouTube использует для эффективной доставки контента клиентам и избежания перегрузок сети.
-
Викторина: Мы закрепляем основные концепции, которые мы изучили при проектировании YouTube, рассматривая, как мы могли бы спроектировать систему Netflix.
Наше обсуждение использования различных строительных блоков в дизайне будет ограничено, так как мы уже подробно рассмотрели их в главе о строительных блоках.
Requirements of YouTube's Design
Требования
Начнем с требований для проектирования системы, подобной YouTube.
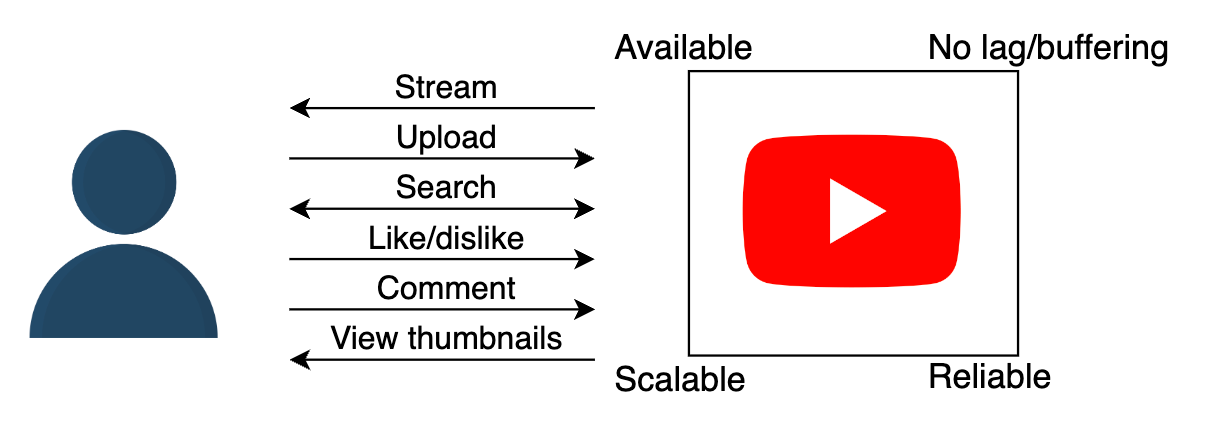
Функциональные требования
Система должна обеспечивать следующие функции:
- Стриминг видео
- Загрузка видео
- Поиск видео по заголовкам
- Возможность ставить лайки и дизлайки видео
- Добавление комментариев к видео
- Просмотр миниатюр (thumbnails)
Нефункциональные требования
Также важно, чтобы наша система соответствовала следующим требованиям:
- Высокая доступность: Система должна быть высокодоступной. Высокая доступность требует хорошего процента времени работы. В общем, время работы 99% и выше считается хорошим.
- Масштабируемость: По мере роста числа пользователей такие аспекты, как хранилище для загрузки контента, требуемая пропускная способность для одновременного просмотра и количество одновременных запросов пользователей не должны становиться узкими местами, перегружающими наше приложение или веб-сервер.
- Хорошая производительность: Плавный опыт стриминга приводит к общей лучшей производительности.
- Надежность: Контент, загруженный в систему, не должен быть утерян или поврежден.
 Нам не требуется строгая согласованность данных в дизайне YouTube. Например, если автор загружает видео, не все подписчики канала должны сразу же получить уведомление о загруженном контенте.
Вкратце, функциональные требования — это функции и возможности, которые получит пользователь, тогда как нефункциональные требования — это ожидания от системы с точки зрения производительности.
Исходя из требований, мы оценим необходимые ресурсы и разработаем дизайн нашей системы.
Оценка ресурсов
Оценка требует идентификации важных ресурсов, которые будут необходимы в системе.
Сотни минут видеоконтента загружаются на YouTube каждую минуту. Также большое количество пользователей будет одновременно стримить контент, что означает, что потребуются следующие ресурсы:
- Ресурсы для хранения, чтобы сохранить загруженный и обработанный контент.
- Большое количество запросов можно обрабатывать путем параллельной обработки. Это означает, что веб/приложение-серверы должны быть готовы обслуживать этих пользователей.
- Для обслуживания миллионов пользователей потребуется как пропускная способность загрузки, так и скачивания.
Чтобы перевести вышеуказанные ресурсы в реальные числа, примем следующие допущения:
- Общее количество пользователей YouTube: 1.5 миллиарда.
- Активные ежедневные пользователи (те, кто смотрит или загружает видео): 500 миллионов.
- Средняя продолжительность видео: 5 минут.
- Размер среднего (5-минутного) видео до обработки/кодирования (сжатие, изменение формата и так далее): 600 МБ.
- Размер среднего видео после кодирования (с использованием различных алгоритмов для разных разрешений, таких как MPEG-4 и VP9): 30 МБ.
Оценка объема хранилища
Чтобы оценить потребности YouTube в хранении данных, нам нужно оценить общее количество видео и продолжительность каждого видео, загружаемого на YouTube каждую минуту. Предположим, что на YouTube загружается контент длительностью 500 часов за одну минуту. Поскольку каждое видео размером 30 МБ имеет продолжительность 5 минут, нам требуется 30/5 = 6 МБ для хранения 1 минуты видео.
Представим это в виде формулы, приняв следующие допущения:
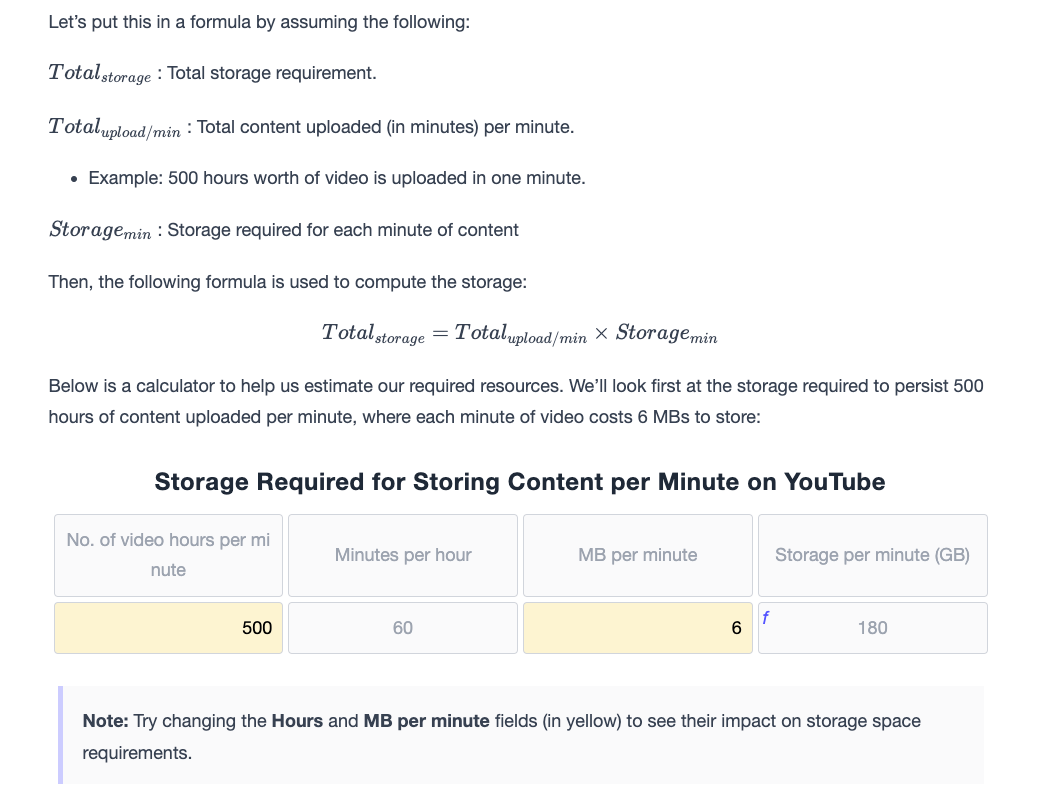
Приведенные выше числа соответствуют сжатым версиям видео. Однако нам нужно перекодировать видео в различные форматы, по причинам, которые мы рассмотрим в следующих уроках. Поэтому потребуется больше места для хранения, чем оценено выше.
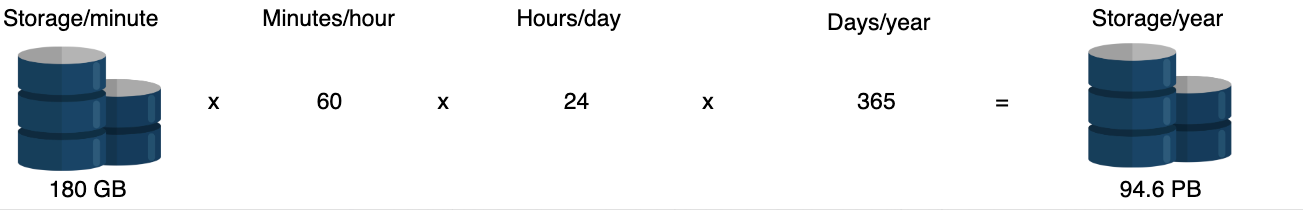
Примечание: В реальном мире дизайн YouTube требует хранилища для миниатюр, данных пользователей, метаданных видео, информации о каналах пользователей и так далее. Поскольку требуемый объем хранилища для этих наборов данных не будет значительным по сравнению с видеофайлами, для упрощения мы его игнорируем.
Assuming YouTube stores videos in five different qualities and the average size of a one-minute video is 6 MB, what would the estimated storage requirements per minute be?
Details
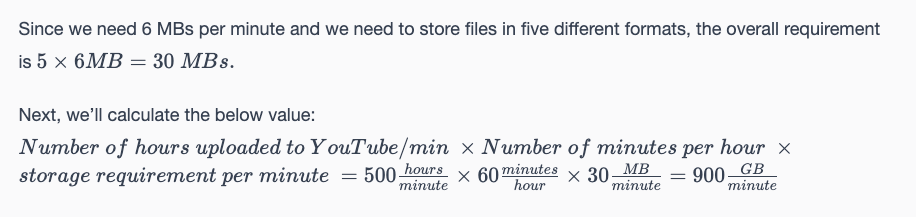
Оценка пропускной способности
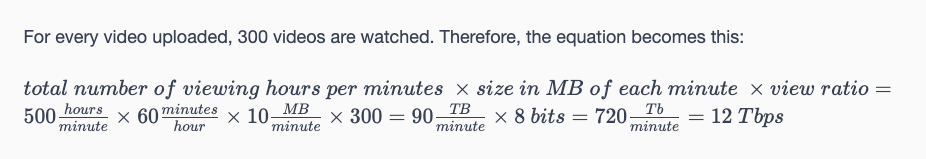
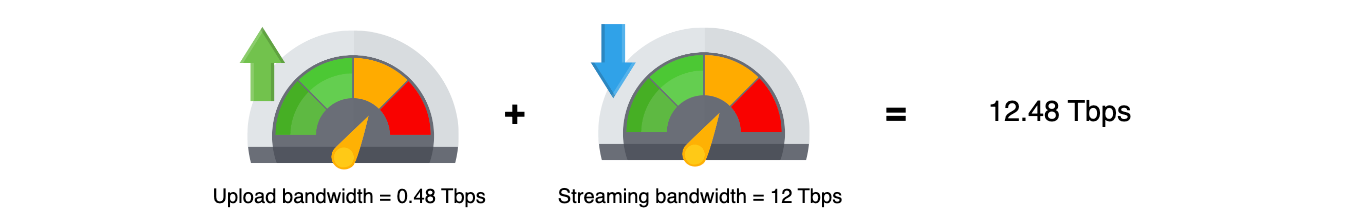
Для стриминга и загрузки видео на YouTube потребуется большой объем передачи данных. Поэтому нам нужно также рассчитать нашу оценку пропускной способности. Предположим, что соотношение загрузок к просмотрам составляет 1:300 — то есть на каждое загруженное видео приходится 300 просмотров в секунду. Нам также нужно помнить, что при загрузке видео оно не находится в сжатом формате, в то время как просматриваемые видео могут быть разных качеств. Давайте оценим пропускную способность, необходимую для загрузки видео.
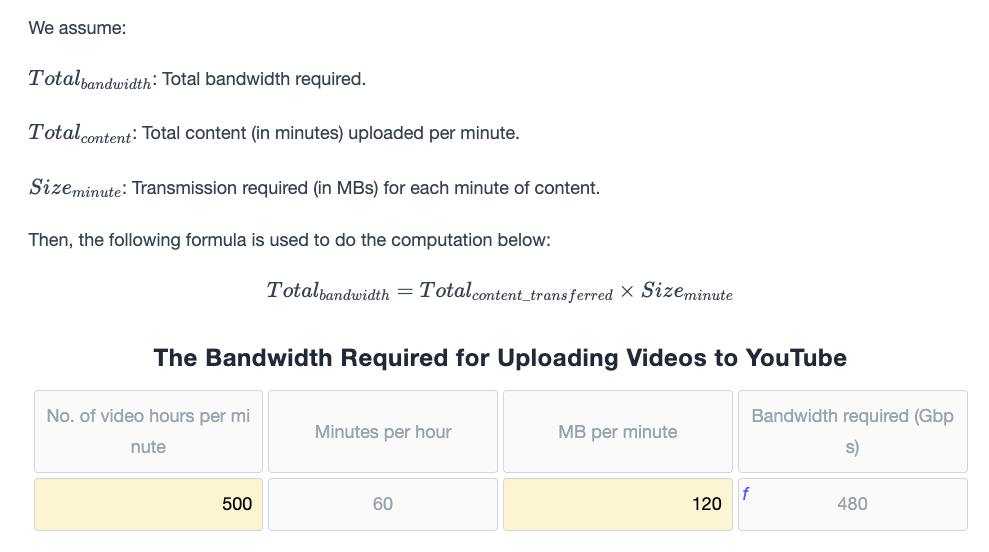
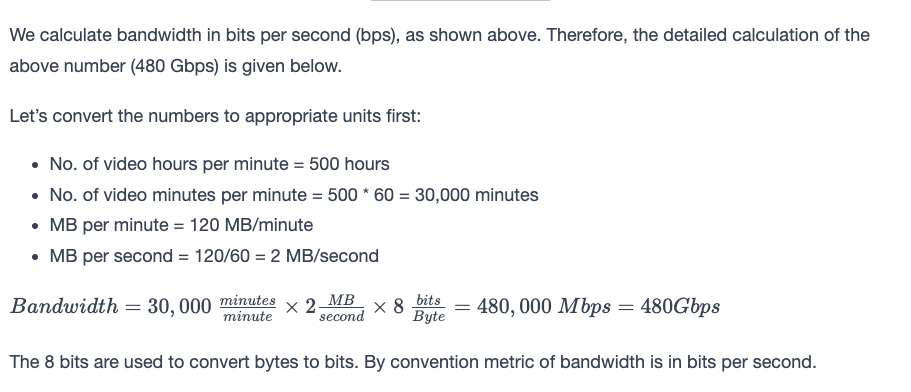
If 480 Gbps of bandwidth is required to satisfy uploading needs, how much bandwidth would be required to stream videos? Assume each minute of video requires 10 MB of bandwidth on average.
Hint: The upload:view ratio is provided.
Details
Оценка количества серверов
Предположим, что у нас есть 500 миллионов активных пользователей YouTube ежедневно. Учитывая наше предположение о использовании ежедневных активных пользователей в качестве прокси для количества запросов в секунду, чтобы определить количество серверов для пиковых нагрузок, мы получаем 500 миллионов запросов в секунду. Затем мы используем следующую формулу для расчета количества серверов:
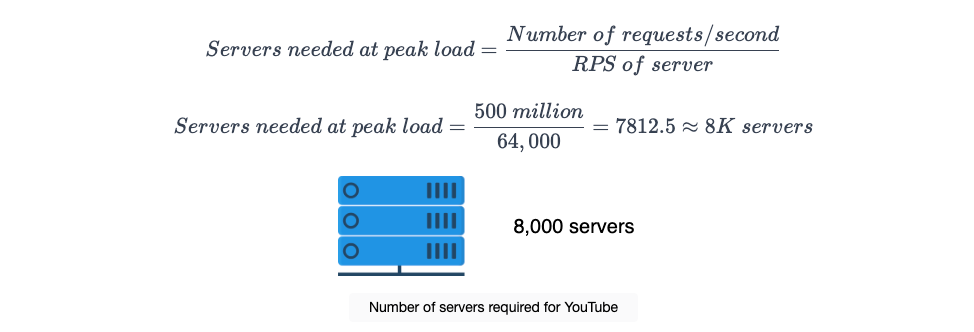 Примечание: Одновременные запросы значительно влияют на количество необходимых серверов по сравнению с запросами, распределенными по времени. Для более детального изучения уточнения предположений о пиковых нагрузках обратитесь к главе «Приблизительные вычисления» (Back-of-the-envelope Calculations).
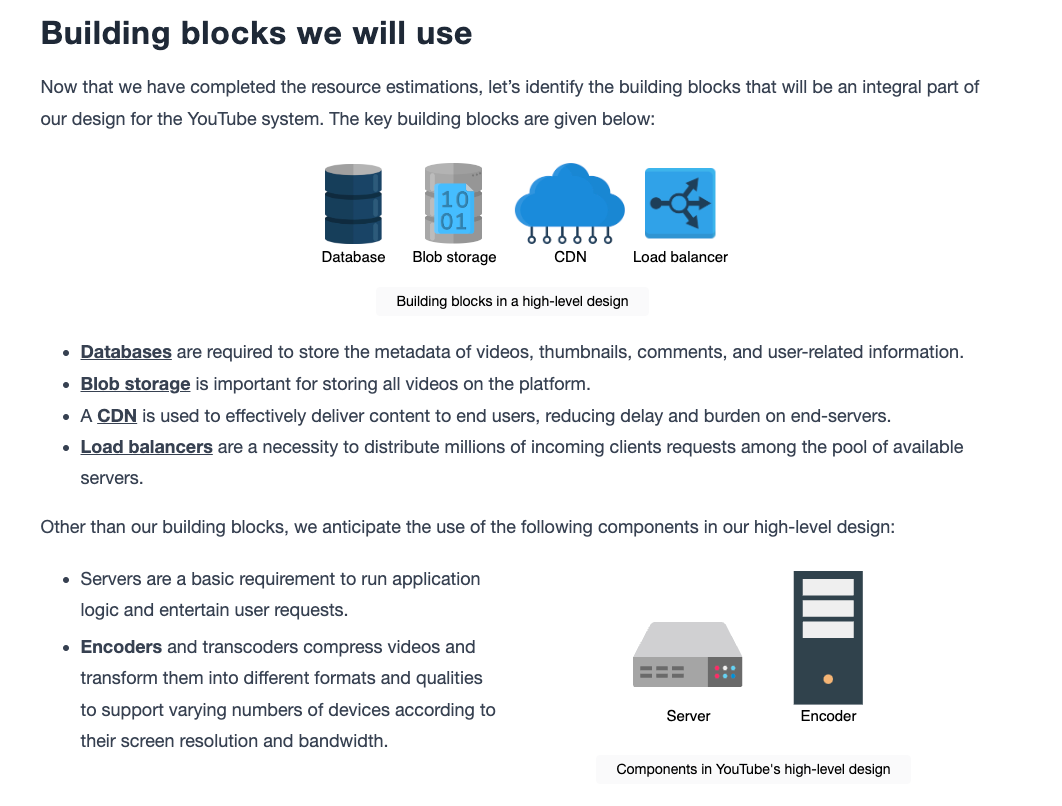
Design of YouTube
Высокоуровневое проектирование
Высокоуровневое проектирование показывает, как мы будем соединять различные компоненты, которые мы определили в предыдущем уроке. Мы начали разрабатывать решение, которое поддерживает функциональные и нефункциональные требования с помощью этого дизайна.
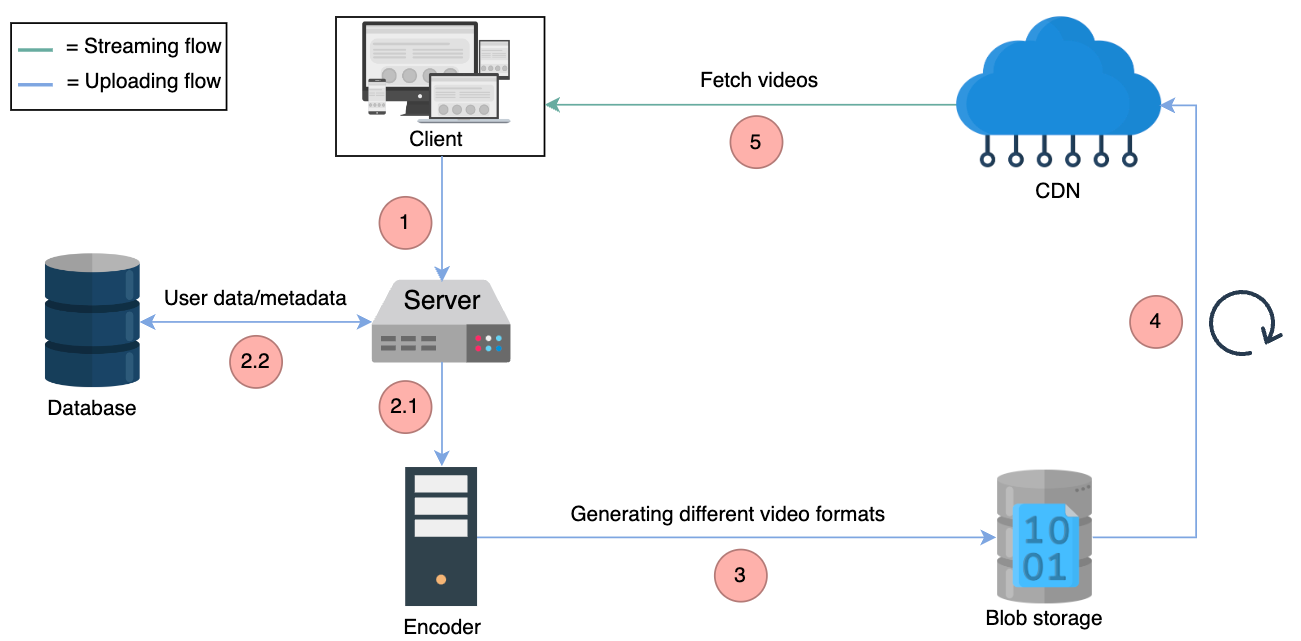
Рабочий процесс абстрактного дизайна выглядит следующим образом:
- Пользователь загружает видео на сервер.
- Сервер сохраняет метаданные и данные пользователя в базе данных и одновременно передает видео кодировщику для кодирования (см. 2.1 и 2.2 на иллюстрации выше).
- Кодировщик вместе с транскодером сжимает видео и преобразует его в несколько разрешений (например, 2160p, 1440p, 1080p и так далее). Видео сохраняются в хранилище блобов (похожее на GFS или S3).
- Некоторые популярные видео могут быть переданы на CDN, который действует как кэш.
- CDN, благодаря своей близости к пользователю, позволяет пользователю стримить видео с низкой задержкой. Однако CDN не является единственной инфраструктурой для доставки видео конечному пользователю, как мы увидим в детализированном проектировании.
Why don’t we upload the video directly to the encoder instead of to the server? Doesn’t the current strategy introduce an additional delay?
Details
There are several reasons why it’s a good idea to introduce a server in between the encoder and the client:
- The client could be malicious and could abuse the encoder.
- If the uploaded video is a duplicate, the server could filter it out.
- Encoders will be available on a private IP address within YouTube’s network and not available for public access.
Проектирование API
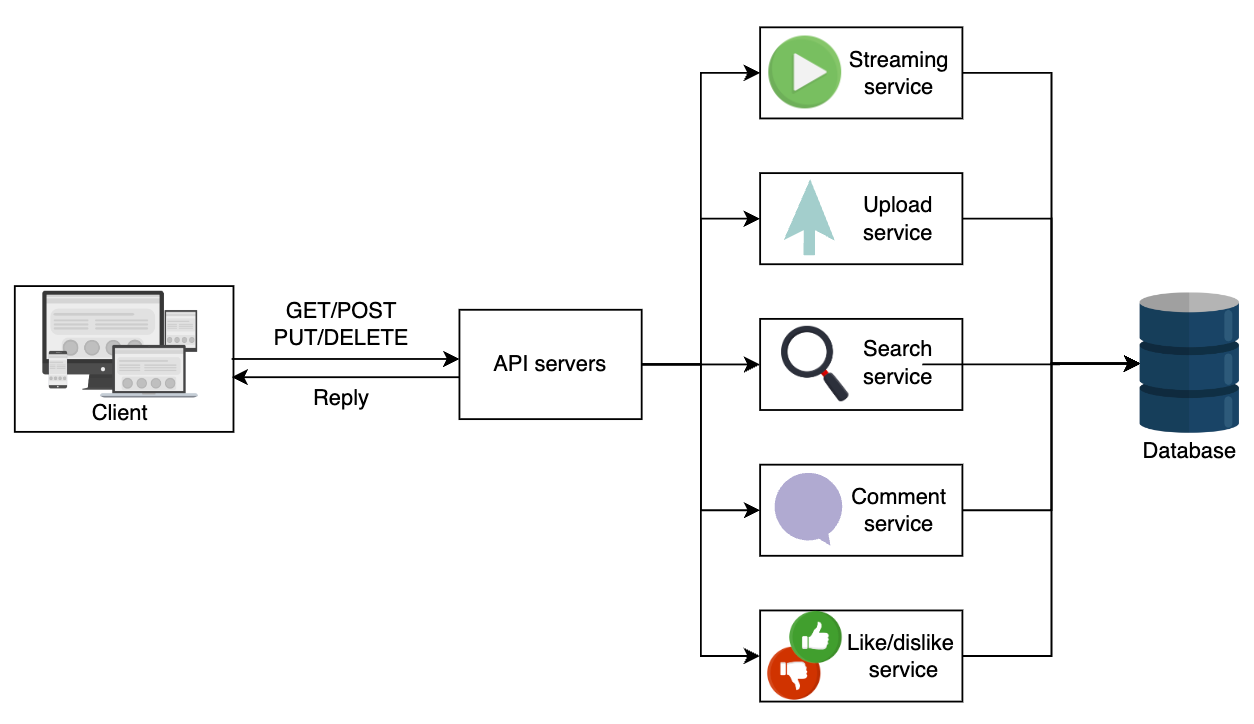
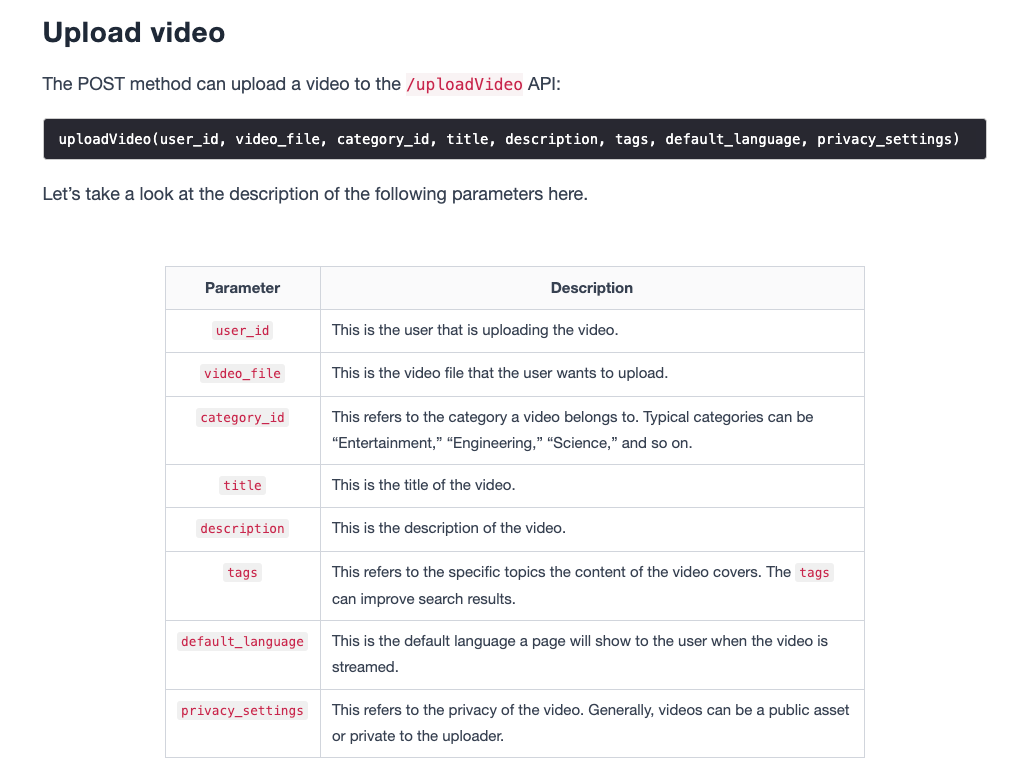
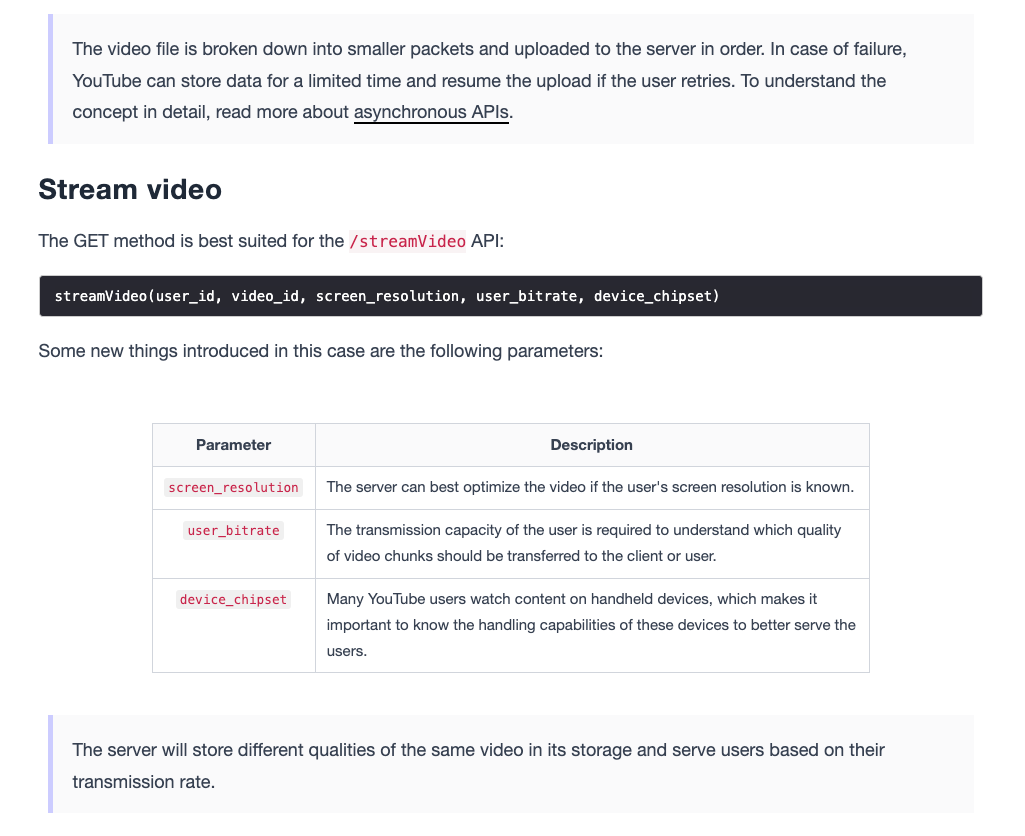
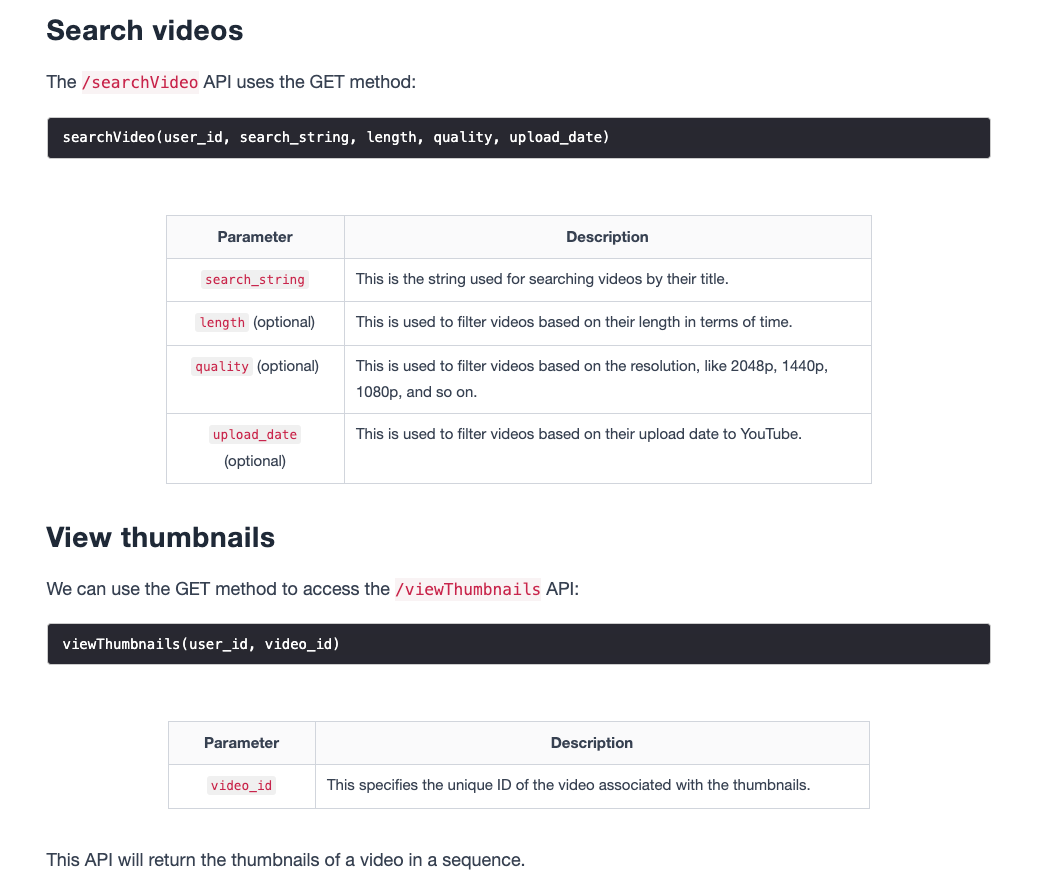
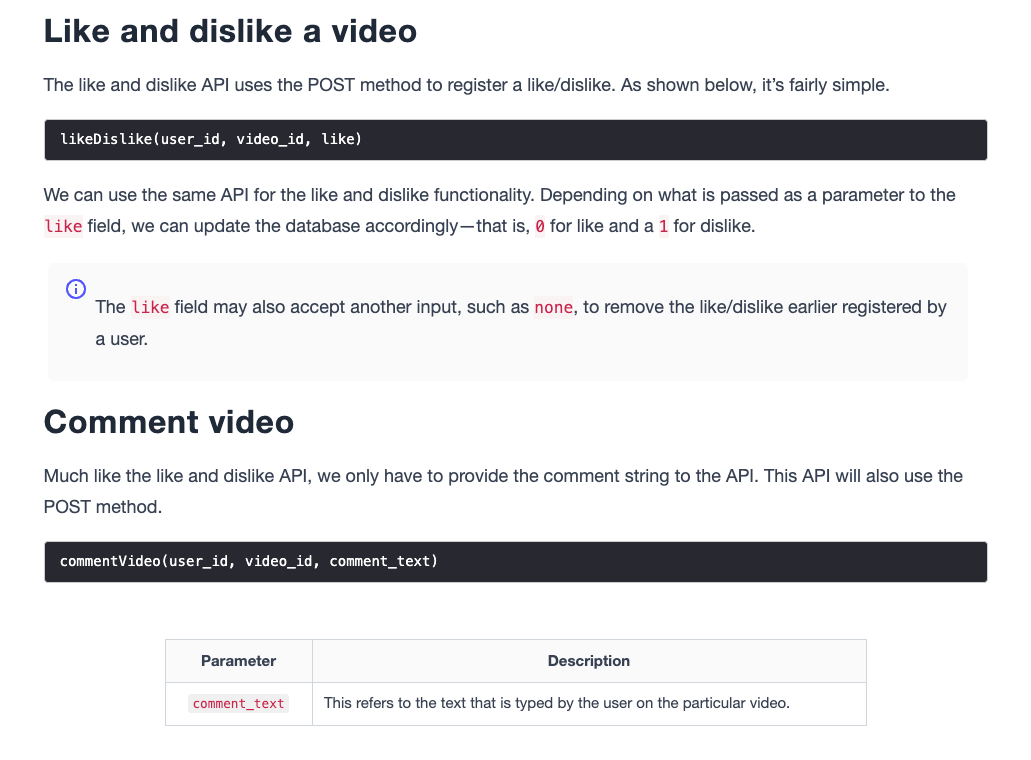
Давайте разберемся с дизайном API с точки зрения функций, которые мы предоставляем. Мы разработаем API для перевода нашего набора функций в технические спецификации. В этом случае для простоты и скорости могут быть использованы REST API. Раздел проектирования API поможет нам понять, как клиент будет запрашивать услуги у бэкэнд-приложения YouTube. Давайте разработаем API для каждой из следующих функций:
- Загрузка видео
- Стриминг видео
- Поиск видео
- Просмотр миниатюр (thumbnails)
- Лайк или дизлайк видео
- Комментирование видео
Детализированное проектирование
Теперь давайте вернемся к нашему высокоуровневому проектированию и посмотрим, сможем ли мы глубже изучить части дизайна. В частности, следующие области требуют более детального обсуждения:
- Интеграция компонентов: Мы рассмотрим некоторые связи между серверами и компонентами хранилища, чтобы лучше понять, как система будет работать.
- Миниатюры (thumbnails): Важно, чтобы пользователи могли видеть некоторые части видео через миниатюры. Поэтому мы добавим генерацию и хранение миниатюр в детализированное проектирование.
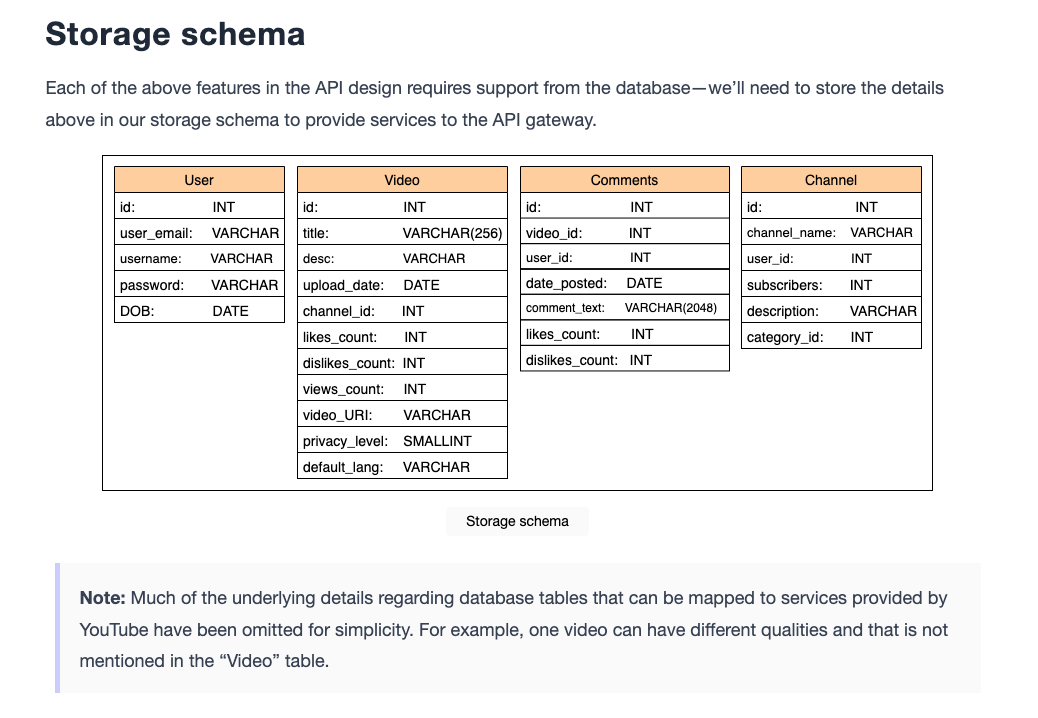
- Структура базы данных: Наша оценка показала, что нам требуется большое пространство для хранения данных. Нам также требуется хранить различные типы данных, такие как видео, метаданные видео и миниатюры, каждое из которых требует специализированного хранилища данных по производительным причинам. Понимание деталей базы данных позволит нам спроектировать систему с минимальными задержками.
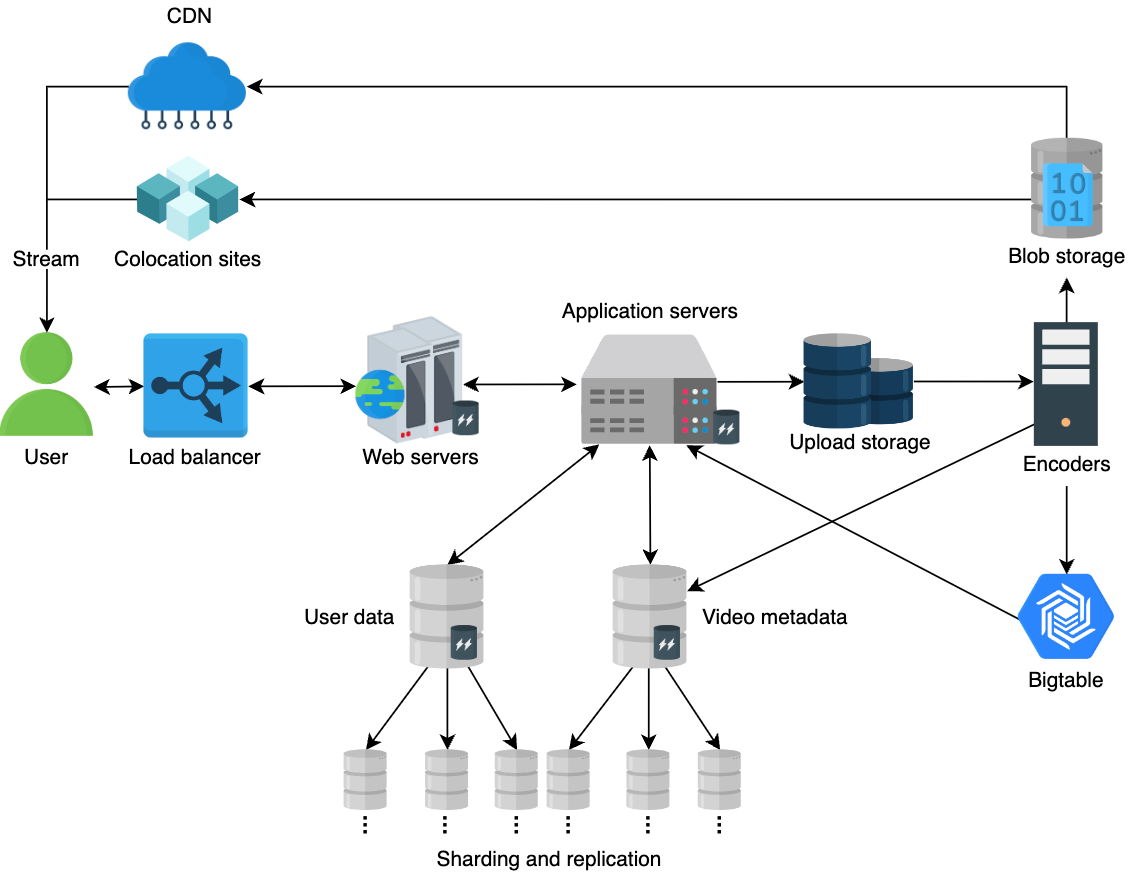
Давайте взглянем на диаграмму ниже. Мы объясним наш дизайн в два этапа: сначала рассмотрим, какие новые компоненты добавлены, а затем рассмотрим, как они взаимодействуют для построения системы YouTube.
Компоненты детализированного дизайна
Поскольку мы выделили требования к плавному стримингу, деталям на уровне серверов и функциям миниатюр, следующий дизайн удовлетворит наши ожидания. Давайте объясним назначение каждого добавленного компонента:
- Балансировщики нагрузки (Load balancers): Для распределения большого количества пользовательских запросов между веб-серверами нам потребуются балансировщики нагрузки.
- Веб-серверы (Web servers): Веб-серверы принимают запросы пользователей и отвечают на них. Они могут рассматриваться как интерфейс для наших API-серверов, которые обслуживают запросы пользователей.
- Сервер приложений (Application server): Приложения и бизнес-логика находятся на серверах приложений. Они подготавливают данные, необходимые веб-серверам для обработки запросов конечных пользователей.
- Хранилище пользователей и метаданных (User and metadata storage): Поскольку у нас большое количество пользователей и видео, хранилище, необходимое для хранения метаданных видео и данных, связанных с пользователями, должно храниться в разных кластерах хранения. Это связано с тем, что большое количество несвязанных данных должно быть разделено для целей масштабируемости.
- Bigtable: Для каждого видео нам потребуется несколько миниатюр. Bigtable — хороший выбор для хранения миниатюр благодаря его высокой пропускной способности и масштабируемости для хранения данных в формате ключ-значение. Bigtable оптимален для хранения большого количества данных размером менее 10 МБ. Поэтому это идеальный выбор для миниатюр YouTube.
- Хранилище загрузок (Upload storage): Хранилище загрузок — это временное хранилище, которое может хранить загруженные пользователями видео.
- Кодировщики (Encoders): Каждое загруженное видео требует сжатия и транскодирования в различные форматы. Генерация миниатюр также осуществляется с помощью кодировщиков.
- CDN и колокационные центры (CDN and colocation sites): CDN и колокационные центры хранят популярный и умеренно популярный контент, который находится ближе к пользователю для облегчения доступа. Колокационные центры используются там, где невозможно инвестировать в собственные дата-центры по бизнес-причинам.
Поток данных и использование технологий
Теперь, когда мы понимаем назначение каждого компонента, давайте обсудим поток данных и использование технологий в различных компонентах на следующих этапах:
- Пользователь может загрузить видео, подключившись к веб-серверам. Веб-сервер может использовать Apache или Lighttpd. Lighttpd предпочтителен, поскольку он может обслуживать статические страницы и видео благодаря своей высокой скорости.
- Запросы с веб-серверов передаются на серверы приложений, которые могут обращаться к различным хранилищам данных для чтения или записи данных пользователей, видео или метаданных видео. Существуют отдельные веб-серверы и серверы приложений, потому что мы хотим разделить клиентские сервисы и бизнес-логику. Разные языки программирования могут использоваться на этом уровне для выполнения различных задач эффективно. Например, язык программирования C может использоваться для шифрования. Кроме того, это дает нам дополнительный уровень кэширования, где наиболее запрашиваемые объекты хранятся на сервере приложений, а наиболее запрашиваемые страницы будут храниться на веб-серверах.
- Используются несколько блоков хранения. Давайте пройдемся по каждому из них:
- Хранилище загрузок (Upload storage) используется для временного хранения загруженных пользователями видео до их кодирования.
- Данные учетных записей пользователей хранятся в отдельной базе данных, в то время как метаданные видео хранятся отдельно. Идея заключается в том, чтобы разделить более часто и менее часто используемые кластеры хранения для оптимального времени доступа. Мы можем использовать MySQL, если количество одновременных операций чтения и записи ограничено. Однако, по мере роста числа пользователей, и, следовательно, числа одновременных операций чтения и записи, мы можем перейти на системы управления данными типа NoSQL.
- Поскольку Bigtable основан на Google File System (GFS), он предназначен для хранения большого количества небольших файлов с низкой задержкой при извлечении. Это разумный выбор для хранения миниатюр.
- Кодировщики создают миниатюры и также сохраняют дополнительные метаданные, связанные с видео, в базе данных метаданных. Они также предоставляют популярный и умеренно популярный контент для CDN и колокационных серверов соответственно.
- В конечном итоге пользователь может стримить видео с любого доступного сайта.
Примечание: Поскольку YouTube интенсивно использует хранилища, шардирование различных сервисов хранения станет эффективным по мере масштабирования и частых операций записи в базу данных. В то же время Bigtable имеет несколько уровней кэширования. Если мы комбинируем это с GFS, кэширование на уровне веб- и приложений дополнительно снизит задержку обработки запросов.
Поиск на YouTube
Поскольку YouTube является одним из самых посещаемых сайтов, большое количество пользователей будет использовать функцию поиска. Хотя мы уже рассмотрели строительные блоки для распределенного поиска, мы предоставим базовый обзор того, как работает поиск внутри системы YouTube.
Каждое новое видео, загруженное на YouTube, будет обрабатываться для извлечения данных. Мы можем использовать JSON-файл для хранения извлеченных данных, который включает следующее:
- Заголовок видео.
- Название канала.
- Описание видео.
- Содержание видео, возможно, извлеченное из транскриптов.
- Длина видео.
- Категории.
Каждый из JSON-файлов можно рассматривать как документ. Далее ключевые слова будут извлечены из документов и сохранены в хранилище данных ключ-значение. Ключ в хранилище данных ключ-значение будет содержать все ключевые слова, которые ищут пользователи, в то время как значение в хранилище данных ключ-значение будет содержать количество вхождений каждого ключа, его частоту и местоположение в различных документах. Когда пользователь ищет ключевое слово, возвращаются видео с наиболее релевантными ключевыми словами.
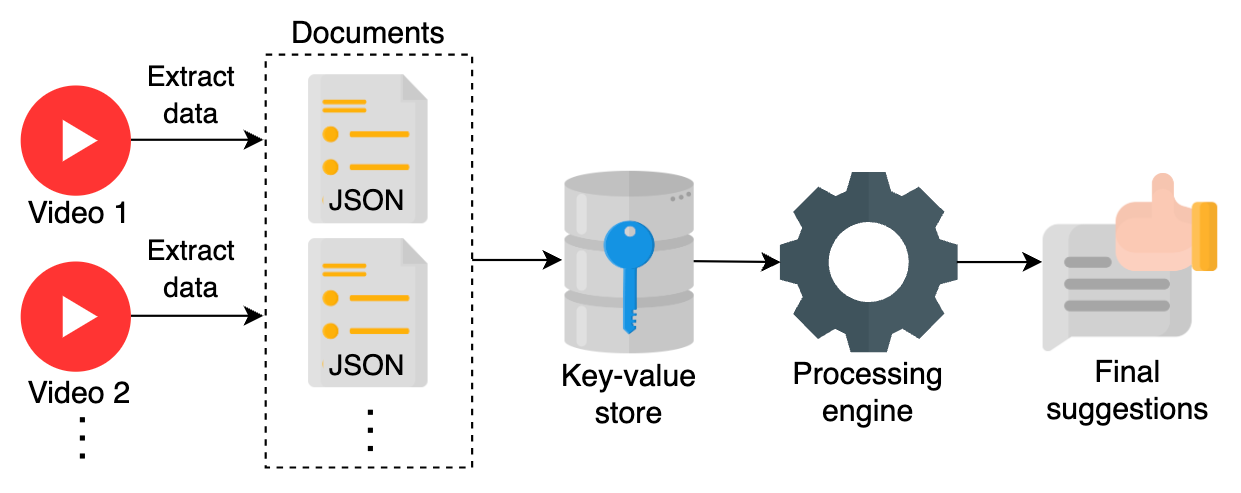
Приведенный выше подход прост, и релевантность ключевых слов — это не единственный фактор, влияющий на поиск в YouTube. На самом деле, важны и многие другие факторы. Процессор поиска улучшит результаты поиска путем фильтрации и ранжирования видео. Он будет использовать другие факторы, такие как количество просмотров, время просмотра видео и контекст, а также историю пользователя, чтобы улучшить результаты поиска.
Evaluation of YouTube's Design
Выполнение требований
Наше предлагаемое решение должно соответствовать требованиям, которые мы упомянули в предыдущих уроках. Наши основные требования — это плавный стриминг (низкая задержка), доступность и надежность. Давайте обсудим их по порядку.
Низкая задержка / Плавный стриминг
Низкую задержку и плавный стриминг можно достичь с помощью следующих стратегий:
- Географически распределенные серверы кэша на уровне провайдеров интернет-услуг (ISP) для хранения самого просматриваемого контента.
- Выбор соответствующих систем хранения для различных типов данных. Например, мы можем использовать Bigtable для хранения миниатюр, blob storage для хранения видео и так далее.
- Использование кэширования на различных уровнях через распределенную систему управления кэшем.
- Использование сетей доставки контента (CDN), которые активно используют кэширование и в основном предоставляют видео из памяти. CDN размещает свои сервисы вблизи конечных пользователей для обеспечения низкой задержки.
Масштабируемость
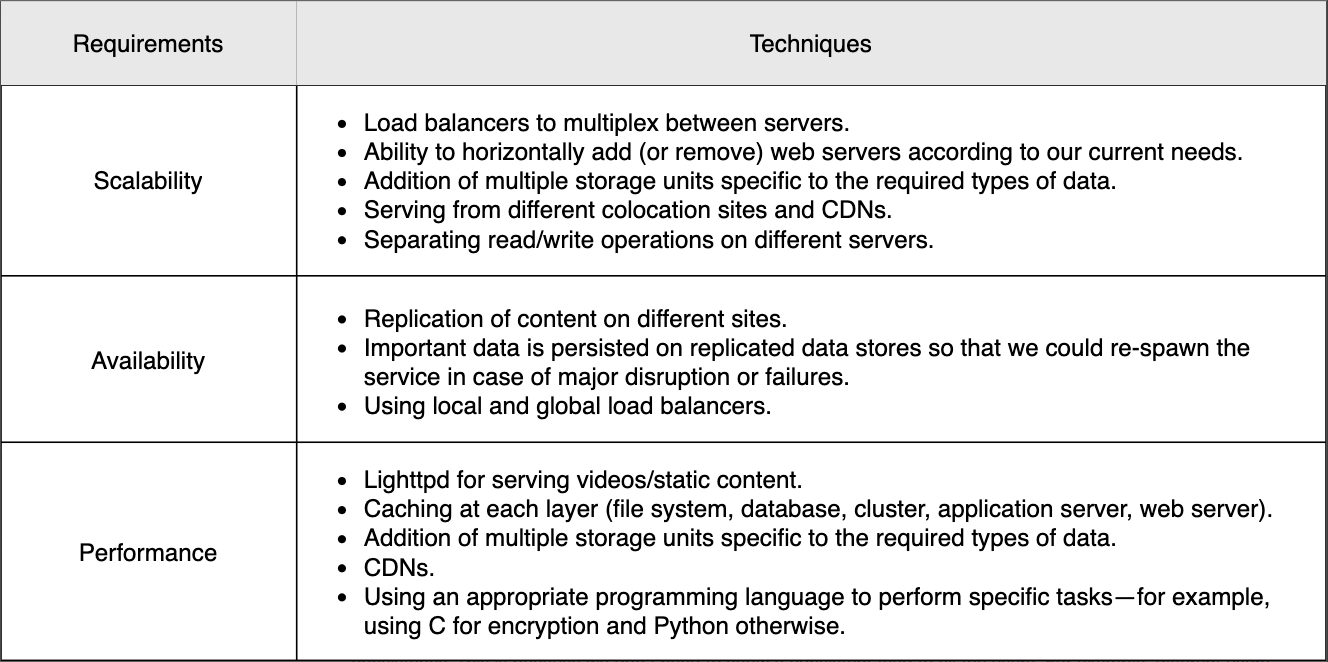
Мы предприняли различные шаги для обеспечения масштабируемости в нашем дизайне, как показано в таблице ниже. Горизонтальная масштабируемость веб- и серверов приложений не будет проблемой по мере роста числа пользователей. Однако, хранилище на основе MySQL не может масштабироваться за определенный предел. Как мы увидим в следующих разделах, это может потребовать некоторой реструктуризации.
Доступность
Систему можно сделать доступной с помощью избыточности, реплицируя данные на как можно большее количество серверов, чтобы избежать единой точки отказа. Репликация данных по разным дата-центрам обеспечит высокую доступность, даже если целый дата-центр выйдет из строя из-за проблем с питанием или сетью. Более того, локальные балансировщики нагрузки могут исключить любые неработающие серверы, а глобальные балансировщики нагрузки могут перенаправить трафик в другой регион, если возникнет такая необходимость.
Надежность
Систему YouTube можно сделать надежной, используя технику разделения данных и устойчивости к отказам. Благодаря разделению данных, недоступность одного типа данных не повлияет на другие. Мы можем использовать избыточное оборудование и программные компоненты для обеспечения устойчивости к отказам. Кроме того, мы можем использовать протокол heartbeat для мониторинга состояния серверов и исключения серверов, которые неисправны. Мы можем использовать вариант consistent hashing, чтобы бесшовно добавлять или удалять серверы и снижать нагрузку на конкретные серверы в случае неравномерной нагрузки.
Isn’t the load balancer a single point of failure (SPOF)?
Details
Just like with servers, we can use multiple load balancers. Users can be randomly forwarded to different load balancers from the Domain Name System (DNS).
Компромиссы
Обсудим некоторые компромиссы в нашем предлагаемом решении.
Согласованность
Наше решение предпочитает высокую доступность и низкую задержку. Однако, сильная согласованность может пострадать из-за высокой доступности (см. теорему CAP). Тем не менее, для системы, такой как YouTube, мы можем позволить себе отказаться от строгой согласованности. Это связано с тем, что нам не нужно показывать всем пользователям одинаковую ленту в одно и то же время. Например, разные пользователи, подписанные на один канал, могут не видеть новое загруженное видео одновременно. Важно отметить, что мы будем поддерживать сильную согласованность данных пользователей. Это еще одна причина, по которой мы отделили данные пользователей от метаданных видео.
Распределенный кэш
Мы предпочитаем распределенный кэш вместо централизованного в нашем дизайне YouTube. Это связано с тем, что факторы масштабируемости, доступности и устойчивости к отказам, которые необходимы для работы YouTube, требуют кэша, который не является единой точкой отказа. Вот почему мы используем распределенный кэш. Поскольку YouTube в основном обслуживает статический контент (миниатюры и видео), Memcached — хороший выбор, так как он является открытым и использует популярный алгоритм Least Recently Used (LRU). Поскольку модели доступа к видео на YouTube имеют длинный хвост, такие алгоритмы, как LRU, подходят для таких наборов данных.
Bigtable vs MySQL
Еще один интересный аспект нашего дизайна — использование различных технологий хранения для разных наборов данных. Почему мы выбрали MySQL и Bigtable?
Основная причина выбора — производительность и гибкость. Количество пользователей на YouTube может не масштабироваться так сильно, как количество видео и миниатюр. Кроме того, нам необходимо хранить данные пользователей и метаданные в структурированной форме для удобного поиска. Поэтому MySQL является подходящим выбором для таких случаев.
Однако количество загруженных видео и миниатюр для каждого видео будет очень большим. Потребности в масштабируемости заставляют нас использовать кастомное или NoSQL решение для этого хранилища. В качестве альтернативы GFS и Bigtable можно использовать HDFS и Cassandra.
Публичный vs частный CDN
Наш дизайн опирается на CDN для обеспечения низкой задержки при доставке контента. Однако CDN могут быть частными или публичными. YouTube может выбрать любой из двух вариантов.
Этот выбор скорее касается затрат, чем дизайна. Однако, в районах с низким трафиком YouTube может использовать публичный CDN по следующим причинам:
- Настройка частного CDN потребует значительных капитальных затрат (CAPEX).
- Для небольшого количества вирусного трафика в определенных регионах не будет достаточно времени для настройки нового CDN.
- В определенных регионах может не быть достаточно пользователей, чтобы поддерживать бизнес.
Однако, YouTube может рассмотреть возможность создания собственного CDN, если количество пользователей слишком велико, так как публичные CDN могут оказаться дорогими при высоком трафике. Частные CDN также могут быть оптимизированы для внутреннего использования для более качественного обслуживания клиентов.
Дублирующие видео
Текущий дизайн YouTube не решает проблему дублирующих видео, загружаемых пользователями или спамерами. Дублированные видео занимают дополнительное пространство, что приводит к компромиссу. В результате мы либо тратим пространство на хранение, либо сталкиваемся с дополнительной сложностью процесса загрузки для обработки дублирующих видео.
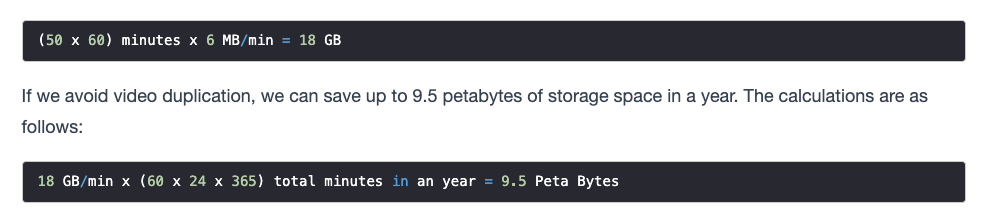
Давайте проведем некоторые расчеты для решения этой проблемы. Предположим, что 50 из 500 часов видео, загружаемых на YouTube, являются дубликатами. Учитывая, что одна минута видео требует 6 МБ пространства для хранения, дублированный контент займет следующее пространство для хранения:
 Трата места для хранения и другие вычислительные затраты — не единственные проблемы с дублирующими видео. Важный аспект дублирующих видео — это проблема авторских прав. Ни один создатель контента не захочет, чтобы его контент был плагиатом. Поэтому вполне разумно добавить сложность обработки дублирующих видео в дизайн YouTube.
Дублирование можно решить с помощью простых техник, таких как локально-чувствительное хеширование (locality-sensitive hashing). Однако могут быть и сложные техники, такие как алгоритмы блокового сопоставления (Block Matching Algorithms, BMAs) и фазовая корреляция (phase correlation) для обнаружения дубликатов. Реализация этого решения может быть довольно сложной в огромной базе данных видео. Нам может потребоваться использование таких технологий, как искусственный интеллект (AI).
Масштабирование в будущем
До сих пор мы сосредотачивались на проектировании и анализе предлагаемого дизайна YouTube. В реальности дизайн YouTube является довольно сложным и требует передовых систем. В этом разделе мы сосредоточимся на прагматической структуре хранилищ данных и веб-сервера.
Мы начнем наше обсуждение с некоторых ограничений в плане масштабирования YouTube. В частности, мы рассмотрим, какие изменения в дизайне нам придется внести, если нагрузка на наш сервис увеличится, скажем, в несколько раз.
Мы уже знаем, что нам придется масштабировать нашу существующую инфраструктуру, которая включает следующие элементы:
- Веб-серверы
- Серверы приложений
- Хранилища данных
- Установка балансировщиков нагрузки между каждым из вышеперечисленных уровней
- Реализация распределенных кэшей
Любая из вышеупомянутых инфраструктур требует некоторых изменений и адаптации к логике на уровне приложений. Например, если мы продолжим увеличивать наши данные на серверах MySQL, это может стать узким местом. Чтобы эффективно использовать шардированную базу данных, нам, возможно, придется вносить изменения в клиент базы данных, чтобы достичь хорошего уровня производительности и поддерживать свойства ACID (атомарность, согласованность, изоляция, долговечность). Однако, даже если мы продолжим изменять клиент базы данных по мере масштабирования, его сложность может достичь такой степени, что это станет неуправляемо. Также стоит отметить, что мы еще не включили механизм восстановления после сбоев в наш дизайн.
Чтобы решить вышеупомянутые проблемы, YouTube разработал решение под названием Vitess.
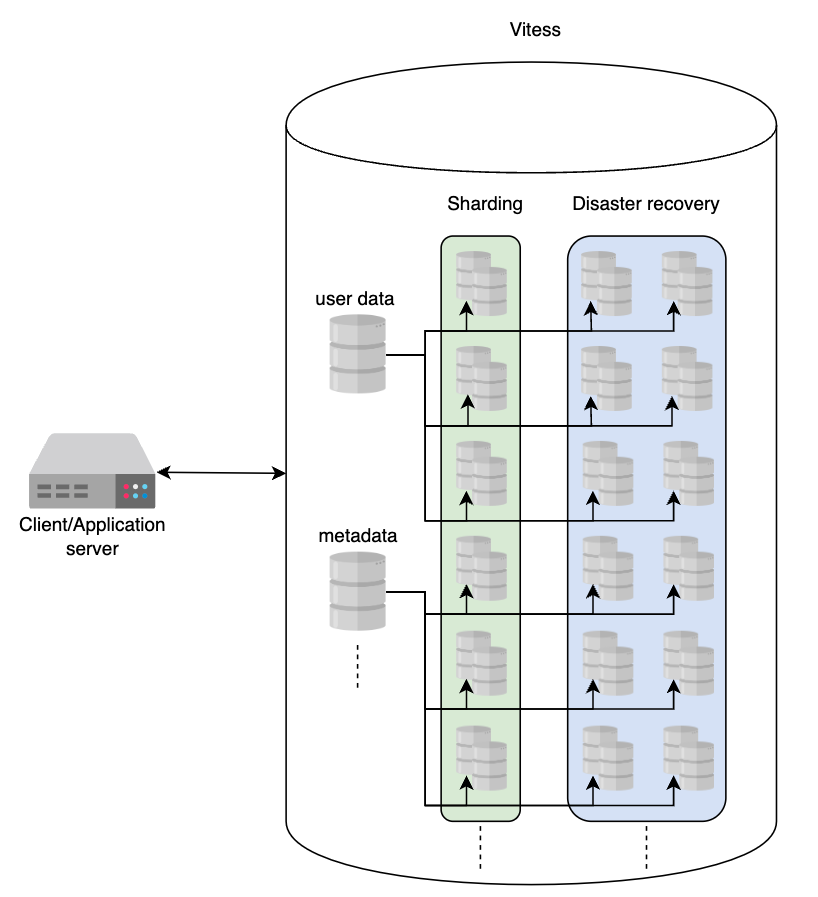
Ключевая идея Vitess заключается в создании абстракции над всеми уровнями базы данных, создавая у клиента базы данных иллюзию, что он работает с одним сервером базы данных. В данном случае этим сервером является система Vitess. Таким образом, вся сложность клиента базы данных переносится на Vitess. Это поддерживает свойства ACID, потому что внутренняя база данных, которая используется — это MySQL. Однако, мы можем включить масштабирование через разделение данных (partitioning). В результате мы получаем структуру базы данных MySQL, которая обеспечивает производительность системы хранения NoSQL. В то же время нам не придется иметь дело с сложным клиентом базы данных (логикой приложения). Следующая иллюстрация подчеркивает, как Vitess удается достичь как масштабируемости, так и структуры.

Можно представить использование таких техник, как денормализация данных вместо системы Vitess. Однако денормализация данных не подойдет, так как она снижает производительность при записи данных. Даже если наша работа ориентирована на чтение данных, по мере масштабирования системы, производительность записи может снизиться до неприемлемого уровня.
Веб-сервер
Веб-сервер является чрезвычайно важным компонентом, и при масштабировании кастомный веб-сервер может стать жизнеспособным решением. Это связано с тем, что большинство коммерческих или открытых решений общего назначения разработаны с учетом широкого круга пользователей. Поэтому кастомное решение для такого успешного сервиса является желательным.
Примечание: ESF — это кастомный веб-сервер, разработанный Google, и, начиная с начала 2022 года, он широко используется в экосистеме Google, поскольку готовые решения не удовлетворяли потребностям YouTube.
The Reality Is More Complicated
Введение
Теперь, когда мы хорошо поняли проектирование системы, давайте посмотрим, как YouTube может оптимизировать использование хранилищ и сетевых ресурсов, сохраняя при этом высокое качество пользовательского опыта (QoE).
Когда речь идет о предоставлении эффективных услуг конечным пользователям, важны следующие три шага:
-
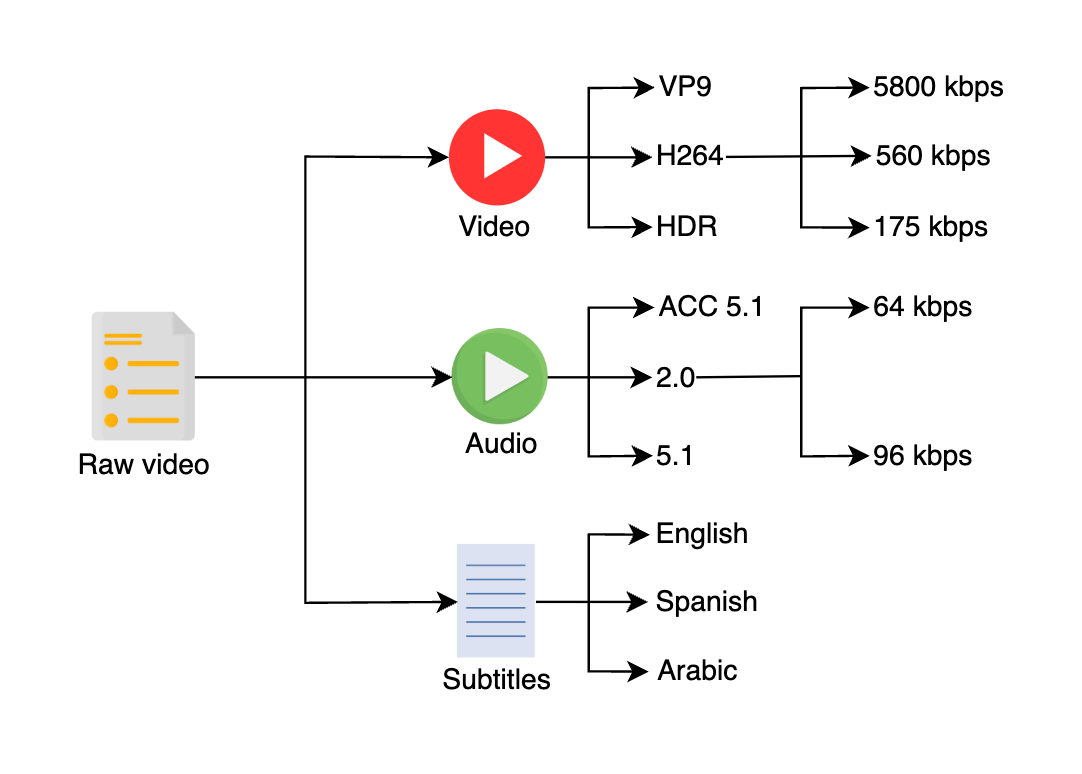
Кодирование (Encode): Исходные видео, загружаемые на YouTube, имеют значительные требования к хранилищу. Возможно использовать различные схемы кодирования, чтобы уменьшить размер этих исходных видеофайлов. Помимо сжатия, выбор схемы кодирования будет зависеть от типов устройств, используемых для стриминга видеоконтента. Поскольку одно и то же видео может воспроизводиться на разных устройствах, нам, возможно, придется закодировать одно и то же видео, используя различные схемы кодирования, что приведет к преобразованию одного исходного видеофайла в несколько файлов, каждый из которых закодирован по-разному. Эта стратегия приведет к улучшению восприятия пользователем, поскольку видео будет закодировано и сжато до определенного уровня, что сэкономит полосу пропускания, а закодированный видеофайл будет подходящим для клиента для плавного воспроизведения.
-
Развертывание (Deploy): Для обеспечения низкой задержки контент должен быть умно развернут, чтобы находиться ближе к большому количеству конечных пользователей. Это не только снизит задержку, но и уменьшит нагрузку на сети, а также на основные серверы YouTube.
-
Доставка (Deliver): Доставка клиенту требует знаний о клиенте или устройстве, используемом для воспроизведения видео. Эти знания помогут адаптироваться к условиям клиента и сети. Таким образом, мы сможем эффективно предоставлять контент.
Давайте теперь подробно разберем каждый этап.
Кодирование (Encode)
До сих пор мы рассматривали кодирование видео с использованием различных схем кодирования. Однако, если мы будем кодировать видео на основе отдельных сегментов, мы разделим видео на меньшие временные интервалы и закодируем их индивидуально. Мы можем разделить видео на более короткие временные интервалы и называть их сегментами. Каждый сегмент будет закодирован с использованием нескольких схем кодирования для создания различных файлов, называемых чанками (chunks). Выбор схемы кодирования для сегмента будет основываться на деталях внутри сегмента, чтобы достичь оптимального качества при меньших требованиях к хранилищу. В конечном итоге каждый сегмент будет закодирован в несколько размеров чанов, в зависимости от содержания сегмента и используемой схемы кодирования. По мере того, как мы делим исходное видео на сегменты, мы увидим его преимущества на этапах развертывания и доставки.
Давайте разберемся, как будет работать кодирование на основе сегментов. Для любого видео с динамическими цветами и высокой глубиной мы будем кодировать его иначе, чем видео с меньшим количеством цветов. Это означает, что менее динамичный сегмент будет закодирован таким образом, чтобы он был сжат больше, что позволит сэкономить дополнительное пространство для хранения. В конечном итоге нам придется передавать меньшие файлы и экономить полосу пропускания на этапах развертывания и стриминга.
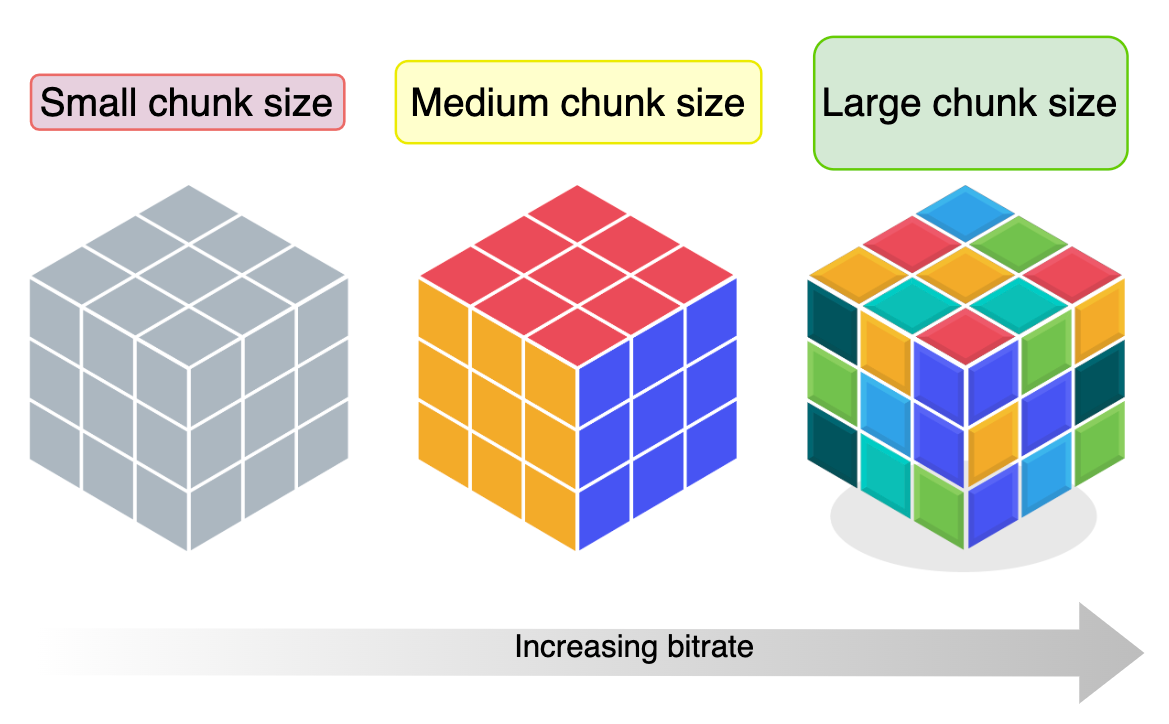
Используя вышеупомянутую стратегию, нам придется кодировать отдельные сегменты видео в различных форматах. Однако альтернативой этому будет хранение всего видео (без разделения на сегменты) после кодирования его в различных форматах. Если мы кодируем на основе сегментов, мы сможем оптимально уменьшить размер всего видео, проводя кодирование на более детализированном уровне. Мы также можем кодировать аудио в различных форматах, чтобы оптимально предоставить стриминг для различных клиентов, таких как телевизоры, мобильные телефоны и настольные компьютеры. Особенно для сервисов, таких как Netflix, аудиокодирование более полезно, так как аудио предлагается на различных языках.
Развертывание (Deploy)
Как обсуждалось в наших разделах о проектировании и оценке, нам нужно приблизить контент к пользователю. Это имеет три основных преимущества:
- Пользователи смогут стримить видео быстрее.
- Будет снижена нагрузка на исходные серверы.
- У интернет-провайдеров (ISP) будет больше свободной полосы пропускания.
Таким образом, вместо того, чтобы стримить непосредственно из наших дата-центров, мы можем развернуть чанки популярных видео в CDN и точках присутствия (PoP) ISP. В тех местах, где нет возможности сотрудничать с ISP, наш контент может быть размещен в точках обмена интернет-трафиком (IXP). Мы можем разместить контент в IXP, что не только приблизит его к пользователям, но и поможет заполнить кэш PoP ISP.
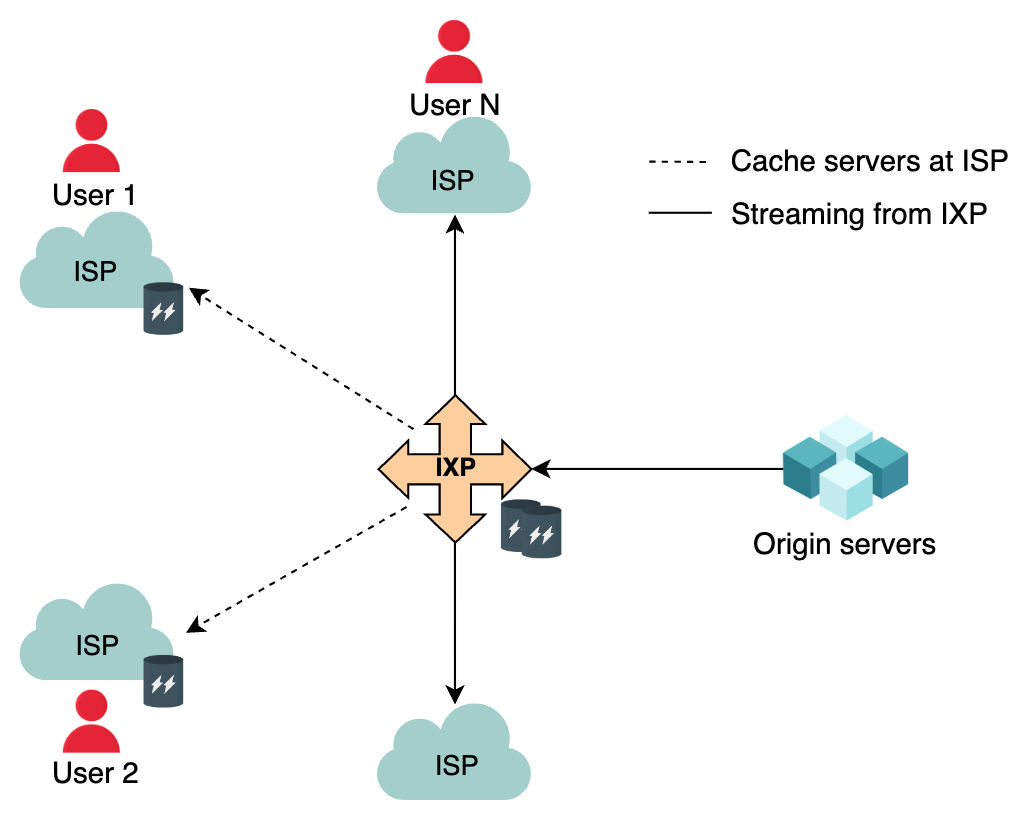
Следует учитывать, что кэширование на уровне ISP или IXP выполняется только для популярного или умеренно популярного контента из-за ограниченной емкости хранилища. Поскольку наша схема кодирования на основе сегментов экономит пространство для хранения, мы сможем обслуживать больше контента, используя кэш-инфраструктуру, ближе к конечным пользователям.
Кроме того, на исходных серверах могут быть два типа хранилищ:
- Флэш-серверы (Flash servers): Эти серверы хранят популярный и умеренно популярный контент. Они оптимизированы для доставки с низкой задержкой.
- Серверы хранения (Storage servers): Этот тип серверов хранит большую часть видео, которое не является популярным. Эти серверы оптимизированы для хранения больших объемов данных.
Примечание: Когда мы передаем стриминговый контент, это может привести к перегрузке сетей. Поэтому мы должны передавать контент на ISP в нерабочие часы.
Рекомендации
YouTube рекомендует видео пользователям на основе их профиля, учитывая такие факторы, как их интересы, история просмотров и поиска, подписанные каналы, связанные темы с уже просмотренным контентом и активность на контенте, такой как комментарии и лайки.
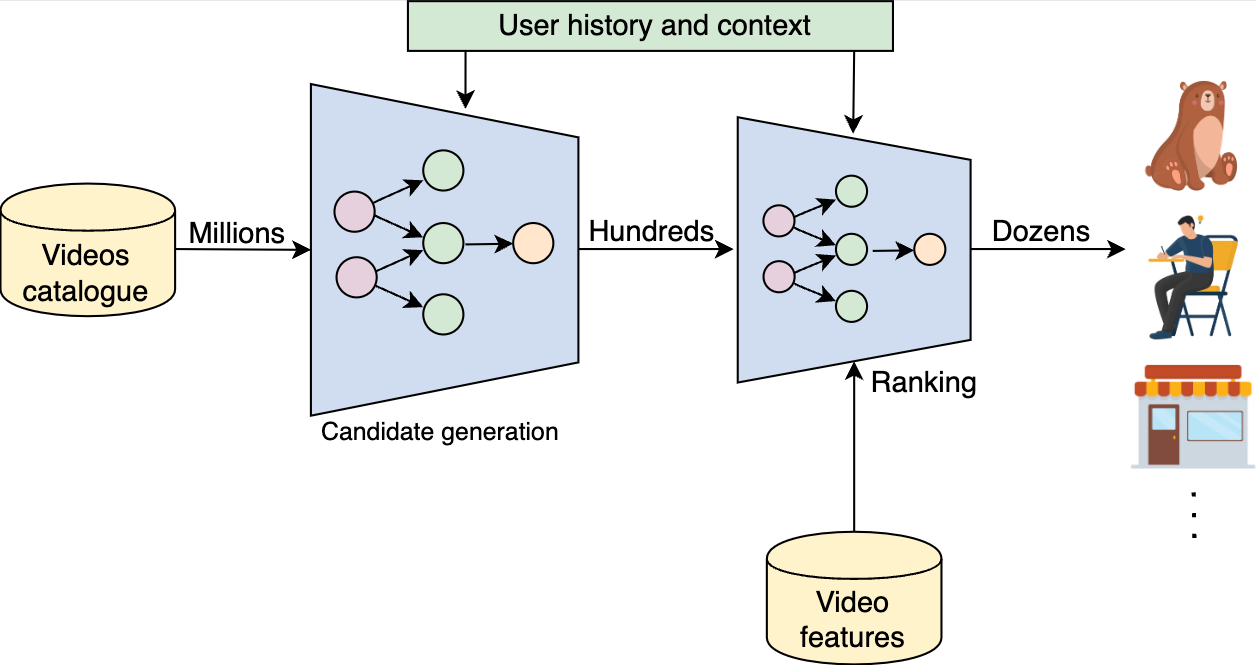
Приблизительное описание работы рекомендательной системы YouTube приведено ниже. YouTube фильтрует видео в два этапа:
- Генерация кандидатов (Candidate generation): На этом этапе миллионы видео YouTube фильтруются до сотен на основе истории пользователя и текущего контекста.
- Ранжирование (Ranking): На этапе ранжирования видео оцениваются на основе их характеристик и в соответствии с интересами и историей пользователя. Сотни видео фильтруются и ранжируются до нескольких десятков видео на этом этапе.
YouTube использует технологии машинного обучения на обоих этапах для предоставления рекомендаций пользователям.
Previously, we said that popular content is sent to ISPs, IXPs, and CDNs. We’ve now discussed YouTube’s feature that recommends content. What is the difference between popular and recommended content on YouTube?
Details
Recommendations are specific to users’ profiles and interests, whereas popular content is recognized on a regional or global basis. It is possible to present popular content to the general audience.
Can you provide some formulaic representation of how the YouTube algorithm for popular content would work?
Details
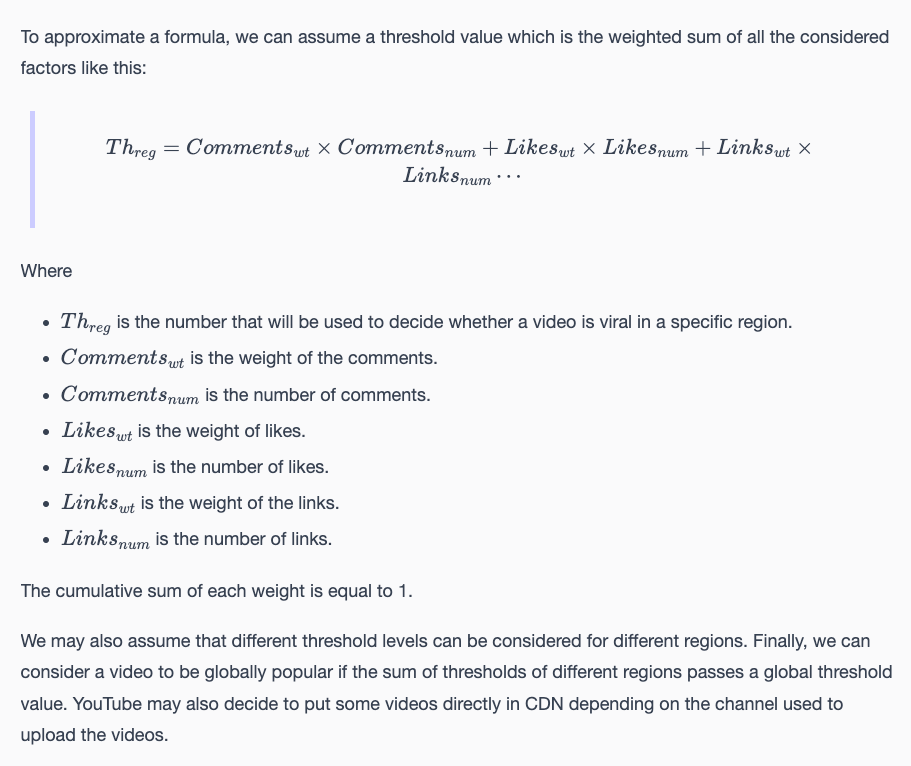
In reference to Question 2, how often do you think that the approximation calculation for whether content is popular will be made? On each click, like, or comment?
Details
Calculation per click, like, or comment requires special infrastructure to perform calculations correctly and in real-time. This should be limited to:
- The most popular channels.
- Alternatively, a particular metric that triggers the computation every time it crosses a certain value. A good trigger could be an increasing number of requests made for a specific video in a shorter period of time.
Доставка (Deliver)
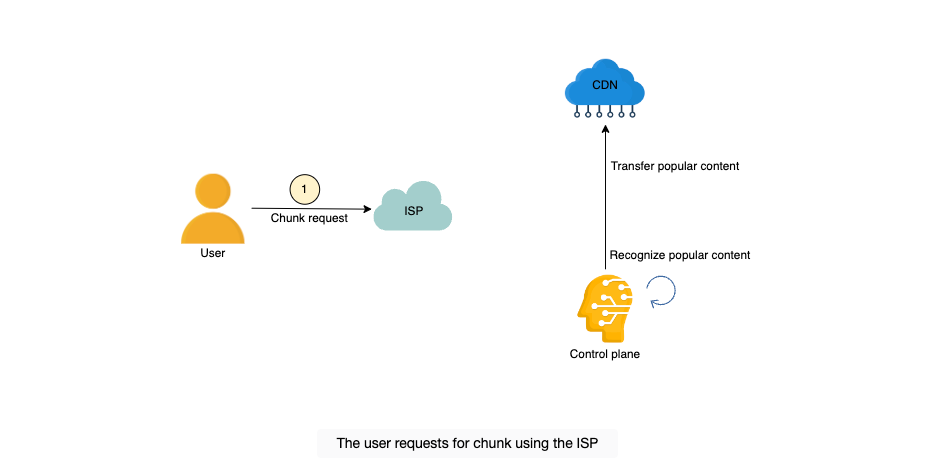
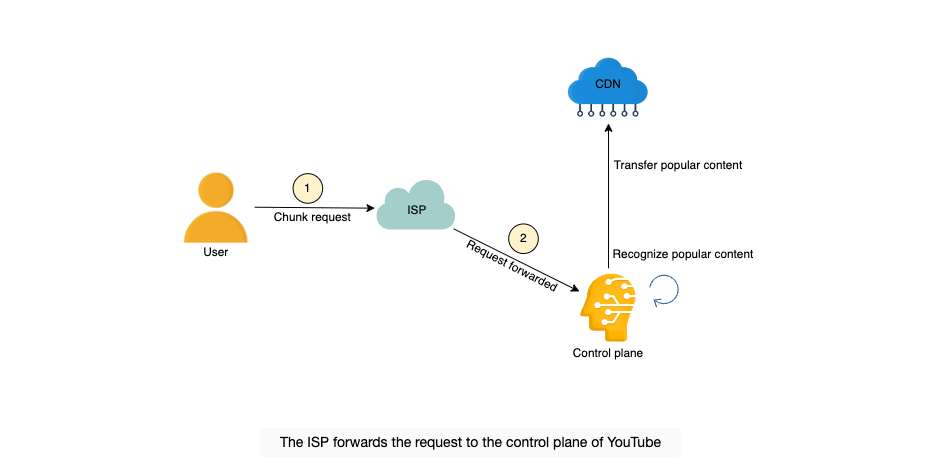
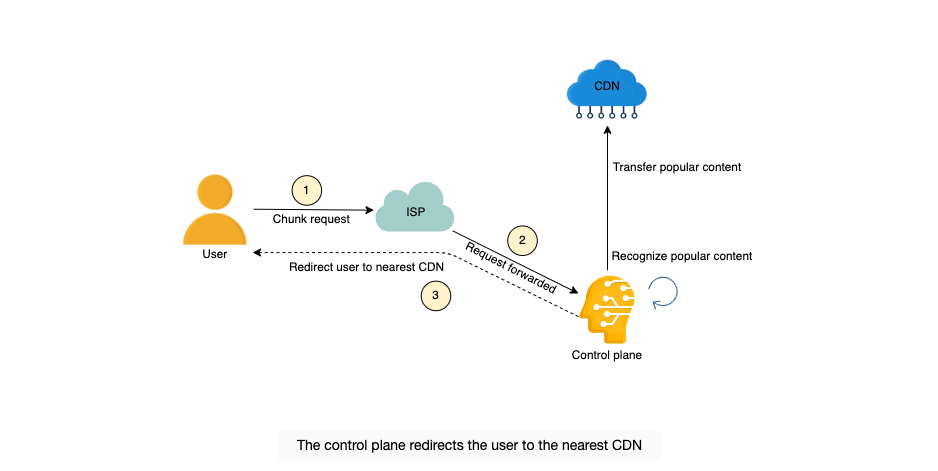
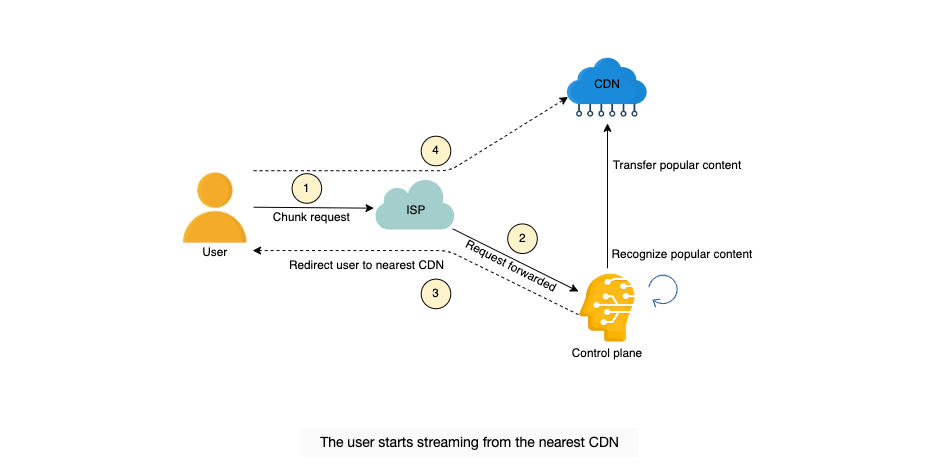
Давайте посмотрим, как конечный пользователь получает контент на свое устройство. Поскольку у нас уже есть чанки видео, развернутые рядом с пользователями, мы перенаправляем пользователей к ближайшим доступным чанкам. Как показано ниже, всякий раз, когда пользователь запрашивает контент, который YouTube распознал как популярный, YouTube перенаправляет пользователя к ближайшему CDN.
Однако в случае непопулярного контента пользователь обслуживается из колокационных центров или дата-центра YouTube, где контент изначально хранится. Мы уже узнали, как YouTube может уменьшить время задержки, имея распределенные кэши на различных уровнях проектирования.
Адаптивный стриминг (Adaptive streaming)
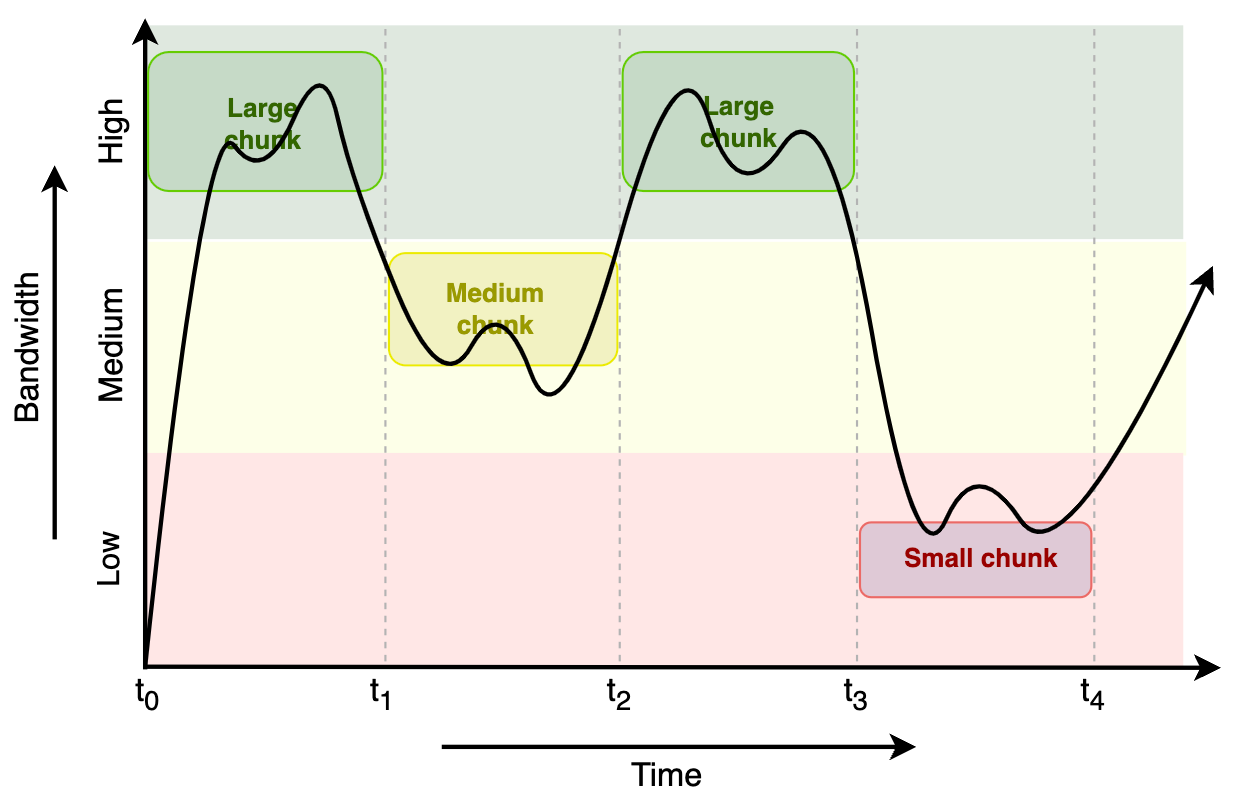
Во время доставки контента также постоянно отслеживается пропускная способность пользователя. Поскольку видео разделено на чанки разного качества, каждый из которых соответствует одному и тому же временному интервалу, чанки предоставляются клиентам в зависимости от изменяющихся условий сети.
Как показано ниже, когда пропускная способность высока, клиенту отправляется чанка более высокого качества и наоборот.
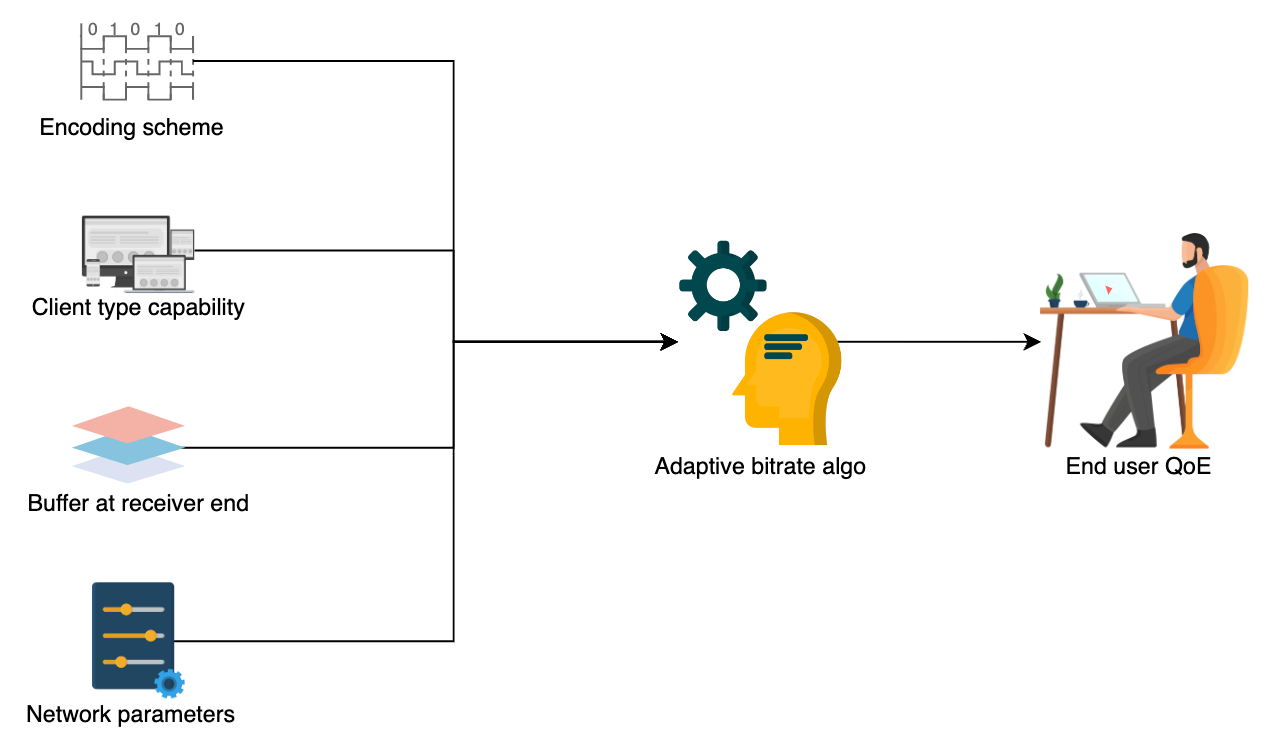
Алгоритм адаптивного битрейта зависит от следующих четырех параметров:
- Доступная пропускная способность от конца до конца (от CDN/серверов до конкретного клиента).
- Возможности устройства пользователя.
- Используемые техники кодирования.
- Объем буфера на стороне клиента.
We have now discussed the detailed system design of YouTube. In the requirements of YouTube’s design, we mentioned the need for our design solution to have low latency as a primary non-functional requirement.
What were the measures taken in our design to ensure low latency?
Details
To ensure low latency in our YouTube system design, we implemented several measures:
- Geographically Distributed Servers at ISP Level: We placed cache servers geographically closer to users at the ISP level. This helps in delivering the most viewed content with minimal delay.
- Caching at Various Layers: Our design includes a distributed cache management system that caches data at different layers, significantly reducing data retrieval times.
- Content Delivery Networks (CDNs): We utilize CDNs, which are optimized for caching and serving videos directly from memory. CDNs are strategically located near end users to ensure fast content delivery.
- Video Preprocessing: This involves encoding, decoding, and segmenting videos into different formats suitable for various devices, which helps in faster video streaming.
- Appropriate Storage Systems: Selecting the right storage systems for different types of data (e.g., Bigtable for thumbnails, blob storage for videos) ensures efficient data management and retrieval.
These measures collectively contribute to achieving low latency in our system design.
Потенциальные последующие вопросы
Система YouTube имеет множество аспектов, требующих глубокого изучения. Поэтому могут возникнуть различные вопросы. Некоторые вопросы и направления для их ответа следующие:
Вопрос: Возможно ли количественно оценить доступность, добавив показатели, такие как 99.99% доступности или 99.999% доступности? Какие изменения в дизайне потребуются в этом случае?
Это сложный вопрос. На практике такие показатели являются частью соглашения об уровне обслуживания (SLA), и они генерируются на основе моделей или долгосрочных эмпирических исследований. Хотя полезно знать, как рассчитываются эти показатели и как организации используют мониторинг для поддержания высокой доступности, возможно, лучшей стратегией будет обсуждение устойчивости системы к отказам — что произойдет в случае сбоев программного обеспечения, отказов серверов, полного отказа дата-центра и так далее. Если система устойчива к отказам, это подразумевает, что у системы будет хорошая доступность.
Вопрос: Мы предположили некоторые разумные цифры для оценки потребностей в ресурсах. Например, мы сказали, что средняя длина видео составляет пять минут. В этом случае мы проектируем систему для среднего поведения? Что произойдет с пользователями, которые не следуют среднему профилю?
Возможный ответ может быть таким: вышеуказанные цифры, вероятно, изменятся со временем. Наше проектирование системы должно быть горизонтально масштабируемым, чтобы с увеличением числа пользователей система продолжала работать адекватно. На практике системы могут перестать масштабироваться, когда какой-то аспект системы увеличивается на порядок. Когда некоторые аспекты системы увеличиваются на порядок (например, в 10 раз), нам обычно требуется новый, другой дизайн. Стоимость проектирования на уровне 10x и 100x масштабов очень разная.
Вопрос: Почему мы не обсуждали и не оценивали ресурсы для комментариев и лайков под видео?
Комментарии от одновременных пользователей на видео имеют примерно такую же сложность, как проектирование системы обмена сообщениями. Мы обсудим эту проблему в другом месте курса.
Вопрос: Как управлять неожиданными пиками нагрузки на систему?
Возможный ответ: поскольку наш дизайн горизонтально масштабируем, мы можем сбросить часть нагрузки на публичное облако благодаря его функции эластичности. Однако публичные облака не бесконечно масштабируемы. Им часто требуются предварительные бизнес-контракты, которые могут ограничить максимальное количество одновременно разрешенных ресурсов в различных дата-центрах.
Вопрос: Как мы будем развертывать глобальную сеть для подключения дата-центров и CDN-сайтов?
На практике YouTube использует сеть Google, которая создана для этой цели и соединяется с многими ISP мира. Это увлекательная область для изучения, которую мы оставили за пределами этого курса для дальнейшего изучения.
Вопрос: Почему в проекте не уделено больше внимания аудио/видео кодированию?
Существует множество вариантов кодирования аудио/видео, многие из которых являются общедоступными, а некоторые — проприетарными. Из-за высокой избыточности в мультимедийном контенте кодирование часто позволяет уменьшить огромный исходный контент до гораздо меньшего размера (например, с 600 МБ до 30 МБ). Мы оставили детали таких алгоритмов кодирования для вас, если вы заинтересованы в дальнейшем изучении.
Вопрос: Можем ли мы использовать специализированное оборудование (или ускорители, такие как GPU) для ускорения некоторых аспектов вычислений YouTube?
Когда мы оценивали количество серверов, мы предположили, что любой сервер может выполнять любую необходимую функцию. В реальности, с замедлением закона Мура, у нас есть специализированное оборудование (например, аппаратные кодеры/декодеры, ускорители машинного обучения, такие как Tensor Processing Units, и многое другое). Все такие платформы требуют своих собственных курсов для справедливого освещения материала. Поэтому мы избегали обсуждения этого в данной задаче проектирования.
Вопрос: Должно ли сжатие выполняться на стороне клиента или на стороне сервера во время загрузки контента?
Мы можем использовать некоторые алгоритмы сжатия без потерь, но с быстрой скоростью (например, Google Snappy) на стороне клиента, чтобы уменьшить объем данных, которые нужно загрузить. Это может означать, что нам понадобится более богатый клиент, или нам придется вернуться к простым данным, если компрессор будет недоступен. Оба эти варианта добавляют сложность в систему.
Вопрос: Есть ли другие преимущества от разделения файлов на чанки, кроме адаптивного битрейта?
Мы обсуждали чанки видеофайлов только в контексте адаптивного битрейта. Такие чанки также помогают параллелизовать любую предварительную обработку, что важно для выполнения требований реального времени, особенно для прямых трансляций. Параллельная обработка снова является полноценной темой для изучения, и мы оставили её для вас, если вы захотите исследовать её далее.