Databases
Постановка задачи
Начнем с простого вопроса. Можно ли создать программное приложение без использования баз данных? Допустим, у нас есть приложение, похожее на WhatsApp. Люди используют наше приложение для общения с друзьями. Теперь, где и как мы можем хранить информацию (список имен людей и их соответствующие сообщения) постоянно и получать к ней доступ?
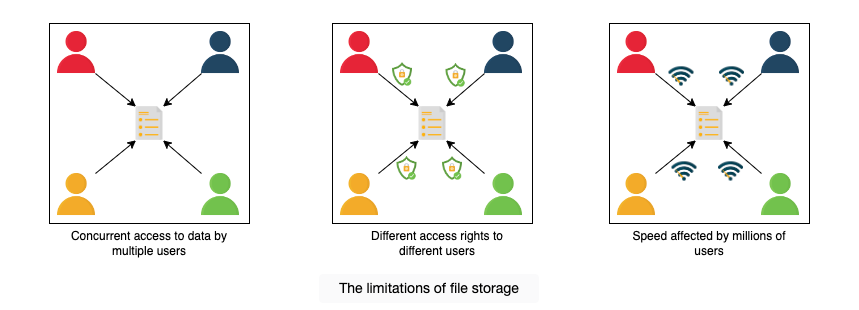
Мы можем использовать простой файл для хранения всех записей в отдельных строках и извлекать их из того же файла. Но использование файла для хранения имеет свои ограничения.
Ограничения файлового хранения
- Мы не можем обеспечить одновременное управление несколькими пользователями, которые получают доступ к файлам хранения из разных мест.
- Мы не можем предоставить разные права доступа разным пользователям.
- Как система будет масштабироваться и оставаться доступной при добавлении тысяч записей?
- Как мы будем искать контент для разных пользователей за короткое время?
Решение
Ограничения, упомянутые выше, можно устранить с помощью баз данных.
База данных — это организованная коллекция данных, которая легко управляется и к которой можно легко получить доступ. Базы данных создаются для упрощения хранения, извлечения, изменения и удаления данных в связи с различными процедурами обработки данных.
Некоторые из приложений, где используются системы управления базами данных (DBMS), включают банковские системы, интернет-магазины и т. д. Разные организации имеют базы данных различных размеров в зависимости от своих нужд.
Примечание: Согласно одному источнику, Всемирный центр данных по климату (World Data Center for Climate, WDCC) является крупнейшей базой данных в мире. Она содержит около 220 терабайт веб-данных и 6 петабайт дополнительных данных.
Существуют два основных типа баз данных:
- SQL (реляционные базы данных)
- NoSQL (нереляционные базы данных)
Они различаются по своему предполагаемому применению, типу информации, которую они хранят, и методу хранения данных.
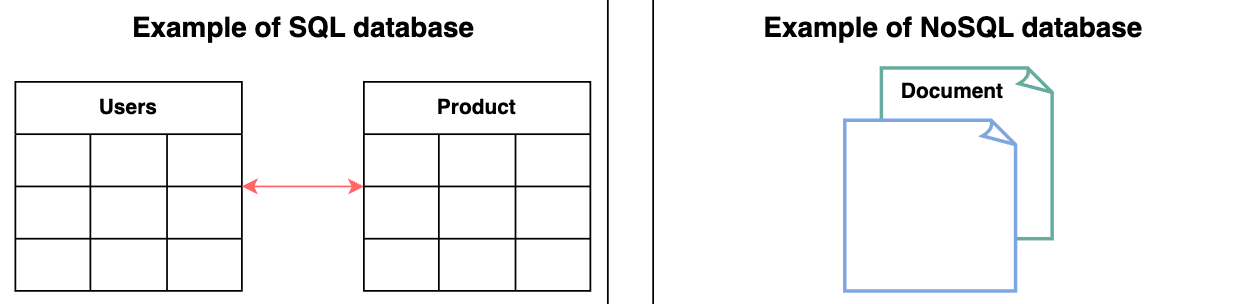
Реляционные и нереляционные базы данных
Реляционные базы данных, подобно телефонным книгам, которые записывают контактные номера и адреса, организованы и имеют заранее определенные схемы. Нереляционные базы данных, подобно файловым директориям, которые хранят все, от постоянной информации о человеке до предпочтений в покупках, неструктурированы, разбросаны и имеют динамическую схему. Мы обсудим их различия и типы более подробно в следующем уроке.
Преимущества баз данных
Правильная база данных необходима для каждого бизнеса или организации. Это связано с тем, что база данных хранит всю важную информацию об организации, такую как записи о персонале, транзакции, информация о зарплате и так далее. Ниже приведены некоторые причины, почему базы данных важны:
- Управление большими данными: Большое количество данных можно легко обрабатывать с помощью базы данных, что было бы невозможно с использованием других инструментов.
- Получение точных данных (консистентность данных): Благодаря различным ограничениям в базах данных, мы можем получать точные данные в любое время.
- Легкость обновления: Обновление данных в базах данных довольно легко с помощью языка манипулирования данными (DML).
- Безопасность: Базы данных обеспечивают безопасность данных, предоставляя доступ к данным только авторизованным пользователям.
- Целостность данных: Базы данных обеспечивают целостность данных с помощью различных ограничений.
- Доступность: Базы данных могут быть реплицированы (с использованием репликации данных) на различных серверах, которые могут обновляться одновременно. Эти реплики обеспечивают доступность.
- Масштабируемость: Базы данных разделяются (с использованием партиционирования данных) для управления нагрузкой на одном узле, что увеличивает масштабируемость.
Как мы будем объяснять базы данных?
Мы разделили главу по базам данных на четыре урока:
- Типы баз данных: Мы обсудим различные типы баз данных, их преимущества и недостатки.
- Репликация данных: Мы обсудим, что такое репликация данных и различные модели репликации с их плюсами и минусами.
- Партиционирование данных: Мы обсудим, что такое партиционирование данных и различные модели партиционирования с их плюсами и минусами.
- Анализ затрат и выгод: Мы обсудим, какой подход к шардингу базы данных лучше всего подходит для различных типов баз данных.
Давайте начнем с понимания различных типов баз данных и их предпочтительных сценариев использования.
Реляционные базы данных
Реляционные базы данных придерживаются определенных схем перед сохранением данных. Данные, хранящиеся в реляционных базах данных, имеют заранее заданную структуру. В основном, эта модель организует данные в одну или несколько таблиц (также называемых отношениями), где каждая строка (кортеж) имеет уникальный ключ. Каждая сущность данных состоит из экземпляров и атрибутов, где экземпляры хранятся в строках, а атрибуты каждого экземпляра — в столбцах. Поскольку каждый кортеж имеет уникальный ключ, кортеж в одной таблице может быть связан с кортежем в других таблицах через хранение первичных ключей в других таблицах, что обычно называется внешними ключами.
Для манипуляции с базой данных используется язык структурированных запросов (SQL). Это включает вставку, удаление и извлечение данных.
Преимущества реляционных баз данных
Существуют различные причины популярности и доминирования реляционных баз данных, среди которых простота, надежность, гибкость, производительность, масштабируемость и совместимость в управлении обобщенными данными.
Гибкость (Flexibility)
В контексте SQL, язык определения данных (DDL) предоставляет нам гибкость для модификации базы данных, включая изменение таблиц, столбцов, переименование таблиц и другие изменения. DDL даже позволяет нам изменять схему, пока другие запросы выполняются, и сервер базы данных продолжает работать.
Снижение избыточности (Reduced Redundancy)
Одним из самых больших преимуществ реляционной базы данных является устранение избыточности данных. Информация, связанная с конкретной сущностью, хранится в одной таблице, в то время как соответствующие данные, относящиеся к этой сущности, хранятся в других таблицах, связанных через внешние ключи. Этот процесс называется нормализацией и имеет дополнительное преимущество в виде устранения неконсистентной зависимости.
Параллелизм (Concurrency)
Параллелизм является важным фактором при проектировании корпоративной базы данных. В таких случаях данные одновременно читаются и записываются многими пользователями. Необходимо координировать такие взаимодействия, чтобы избежать неконсистентности данных — например, двойного бронирования номеров в гостинице. Параллелизм в реляционной базе данных обеспечивается через транзакционный доступ к данным. Как упоминалось ранее, транзакция рассматривается как атомарная операция, поэтому она также работает в обработке ошибок, либо откатывая, либо фиксируя транзакцию после успешного выполнения.
Интеграция (Integration)
Процесс агрегации данных из нескольких источников является обычной практикой в корпоративных приложениях. Обычным способом выполнения такой агрегации является интеграция общей базы данных, где несколько приложений хранят свои данные. Таким образом, все приложения могут легко получить доступ к данным друг друга, при этом меры контроля параллелизма обеспечивают доступность данных для множества приложений.
Резервное копирование и восстановление после сбоев (Backup and Disaster Recovery)
Реляционные базы данных гарантируют, что состояние данных всегда будет согласованным. Операции экспорта и импорта упрощают резервное копирование и восстановление. Большинство облачных реляционных баз данных выполняют непрерывное зеркалирование, чтобы избежать потери данных и упростить процесс восстановления.
Реляционные базы данных обеспечивают свойства атомарности, согласованности, изоляции и долговечности (ACID) для поддержания целостности базы данных. ACID — это мощная абстракция, которая упрощает сложные взаимодействия с данными и скрывает многие аномалии (такие как "грязные" чтения, записи, искажения при чтении, потерянные обновления, искажения при записи и фантомные чтения) за простой транзакцией.
Подробное рассмотрение ACID:
-
Атомарность (Atomicity): Транзакция рассматривается как атомарная единица. Поэтому либо все операторы в рамках транзакции будут успешно выполнены, либо ни один из них не будет выполнен. Если какой-либо оператор в транзакции завершится с ошибкой, транзакция должна быть прервана и откатана.
-
Согласованность (Consistency): В любой момент времени база данных должна находиться в согласованном состоянии и должна оставаться в согласованном состоянии после каждой транзакции. Например, если несколько пользователей хотят просмотреть запись из базы данных, она должна возвращать одинаковый результат каждый раз.
-
Изоляция (Isolation): В случае одновременного выполнения нескольких транзакций они не должны влиять друг на друга. Конечное состояние базы данных должно быть таким же, как если бы транзакции выполнялись последовательно.
-
Долговечность (Durability): Система должна гарантировать, что завершенные транзакции будут сохраняться в базе данных навсегда, даже в случае отказа системы.
Почему реляционные базы данных?
Реляционные базы данных являются выбором по умолчанию для специалистов по программному обеспечению для хранения структурированных данных. Они предлагают множество преимуществ, таких как гибкость, снижение избыточности данных, поддержка параллельности, интеграция данных и резервное копирование/восстановление после сбоев.
Недостаток: Несоответствие импедансов
Несоответствие импедансов — это разница между реляционной моделью и структурами данных в памяти. Реляционная модель организует данные в табличную структуру с отношениями и кортежами. Операция SQL на этих структурированных данных возвращает отношения, соответствующие реляционной алгебре. Однако это имеет некоторые ограничения. В частности, значения в таблице принимают простые значения, которые не могут быть структурой или списком. В памяти же может храниться сложная структура данных. Чтобы сделать сложные структуры совместимыми с отношениями, потребуется перевод данных в свете реляционной алгебры. Поэтому несоответствие импедансов требует перевода между двумя представлениями, как показано на следующей схеме:
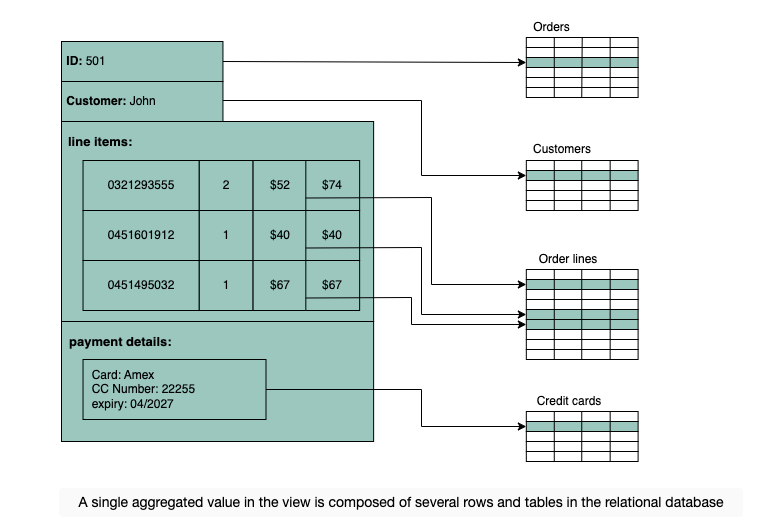
Несоответствие импедансов (impedance mismatch) в контексте реляционных баз данных и программирования связано с разницей между структурой данных, используемой в реляционных базах данных, и тем, как данные организуются в памяти в программах.
Реляционная модель — это способ организации данных в базе данных. Данные хранятся в таблицах, каждая из которых представляет собой набор записей (строк) с определенными атрибутами (столбцами). Таблицы связаны между собой отношениями, и операции с данными выполняются с помощью SQL, основываясь на реляционной алгебре.
Реляционная алгебра — это формальная система для работы с отношениями в реляционной базе данных. Она включает в себя набор операций, таких как выборка (SELECT), объединение (JOIN), проекция (PROJECTION) и другие, которые позволяют манипулировать данными в таблицах.
Проблема несоответствия импедансов возникает из-за того, что реляционные базы данных используют простую табличную структуру, где данные представлены в виде строк и столбцов с простыми значениями, такими как числа или строки. В то же время, программы на современных языках программирования оперируют сложными структурами данных, такими как объекты, списки, словари и т.д. Для того чтобы сохранить или извлечь такие сложные структуры из базы данных, необходимо выполнять преобразования между реляционной моделью данных и внутренними структурами данных программы. Это может быть сложным и трудоемким процессом, который требует дополнительных усилий со стороны разработчиков.
Таким образом, несоответствие импедансов — это проблема преобразования данных между двумя различными способами их организации: в реляционной базе данных и в оперативной памяти программы.
Почему выбирают нереляционные (NoSQL) базы данных?
NoSQL базы данных предназначены для работы с различными моделями данных для доступа и управления ими. Существует несколько типов NoSQL баз данных, о которых мы подробнее расскажем в следующем разделе. Эти базы данных используются в приложениях, которые требуют обработки большого объема полуструктурированных и неструктурированных данных, низкой задержки и гибких моделей данных. Это достигается за счет ослабления некоторых ограничений на консистентность данных, которые есть у других баз данных. Вот некоторые характеристики NoSQL баз данных:
Простой дизайн (Simple Design)
В отличие от реляционных баз данных, NoSQL не требует работы с проблемой несовместимости — например, хранение всех данных сотрудников в одном документе вместо нескольких таблиц, требующих выполнения операций объединения (join). Эта стратегия упрощает процесс написания кода, отладки и поддержки.
Горизонтальное масштабирование (Horizontal Scaling)
NoSQL базы данных предпочтительны в основном из-за их способности работать на крупных кластерах. Это решает проблему увеличения количества одновременных пользователей. NoSQL упрощает масштабирование за счет того, что данные, связанные с конкретным сотрудником, хранятся в одном документе, а не в нескольких таблицах, распределенных по узлам. NoSQL базы данных часто распределяют данные по нескольким узлам и автоматически балансируют данные и запросы между узлами. В случае сбоя узла его можно заменить прозрачно, без прерывания работы приложения.
Доступность (Availability)
Для повышения доступности данных замена узлов может выполняться без простоя приложения. Большинство вариантов нереляционных баз данных поддерживают репликацию данных, чтобы обеспечить высокую доступность и восстановление после сбоев.
Поддержка неструктурированных и полуструктурированных данных (Support for Unstructured and Semi-Structured Data)
Многие NoSQL базы данных работают с данными, которые не имеют схемы на момент конфигурации базы данных или записи данных. Например, документные базы данных не имеют фиксированной структуры; они позволяют документам (JSON, XML, BSON и т. д.) содержать различные поля. Например, один JSON документ может содержать меньше полей, чем другой.
Стоимость (Cost)
Лицензии на многие системы управления реляционными базами данных (RDBMS) достаточно дороги, тогда как многие NoSQL базы данных являются открытыми и бесплатными. Кроме того, некоторые RDBMS зависят от дорогого проприетарного оборудования и систем хранения данных, тогда как NoSQL базы данных обычно используют кластеры дешевых стандартных серверов.
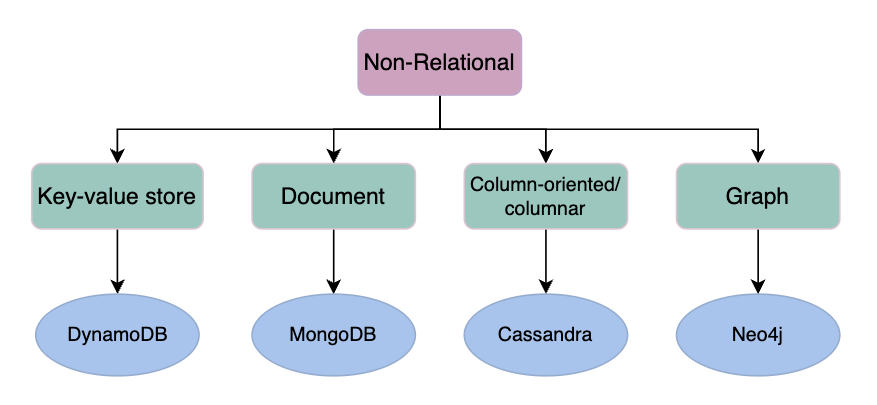
NoSQL базы данных делятся на различные категории в зависимости от характера операций и особенностей, включая документные хранилища, колоночные базы данных, хранилища ключ-значение и графовые базы данных. Мы обсудим каждую из них и их примеры использования с точки зрения проектирования систем в следующих разделах.
Types of NoSQL databases
Key-value database
Key-value базы данных используют методы ключ-значение, такие как хеш-таблицы, для хранения данных в парах ключ-значение. Это изображено на рисунке ниже. Здесь ключ служит в качестве уникального или первичного ключа, а значения могут быть любыми — от простых скалярных значений до сложных объектов. Эти базы данных позволяют легко выполнять разделение (partitioning) и горизонтальное масштабирование данных. Некоторые популярные key-value базы данных включают Amazon DynamoDB, Redis и Memcached.
Пример использования
Key-value базы данных эффективны для приложений, ориентированных на сессии. Приложения, ориентированные на сессии, такие как веб-приложения, хранят данные пользователей в оперативной памяти или базе данных в течение сессии. Эти данные могут включать информацию профиля пользователя, рекомендации, целевые акции, скидки и многое другое. Уникальный идентификатор (ключ) присваивается каждой сессии пользователя для удобного доступа и хранения. Поэтому для хранения таких данных лучше всего подходят key-value базы данных.
Следующий рисунок показывает пример key-value базы данных. Идентификатор продукта (Product ID) и Тип (Type) товара рассматриваются как первичный ключ. Это считается ключом для этой key-value базы данных. Более того, схема хранения атрибутов товара определяется в зависимости от его природы и количества атрибутов.
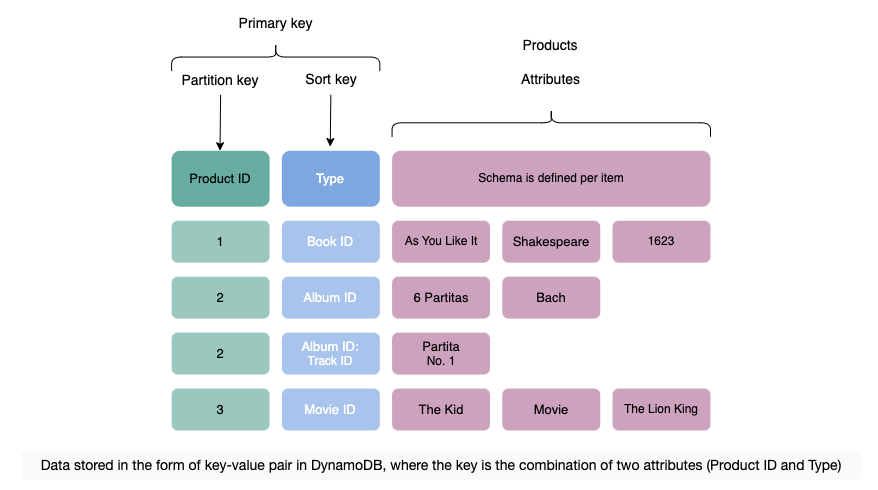
Эти базы данных поддерживают горизонтальное масштабирование и разделение данных, что делает их эффективными для высоконагруженных систем.
Document database
Документные базы данных предназначены для хранения и извлечения документов в таких форматах, как XML, JSON, BSON и других. Эти документы состоят из иерархической древовидной структуры данных, которая может включать карты, коллекции и скалярные значения. Документы в таких базах данных могут иметь различные структуры и данные. Примеры документных баз данных включают MongoDB и Google Cloud Firestore.
Пример использования
Документные базы данных подходят для неструктурированных данных каталогов, таких как файлы JSON или другие сложные структурированные иерархические данные. Например, в приложениях для электронной коммерции у продукта могут быть тысячи атрибутов, что невозможно эффективно хранить в реляционной базе данных из-за влияния на производительность чтения. В этом случае документная база данных может эффективно хранить каждый атрибут в отдельном файле для удобного управления и более быстрой скорости чтения. Кроме того, документные базы данных являются хорошим выбором для приложений по управлению контентом, таких как блоги и видеоплатформы. Каждая сущность, необходимая для приложения, хранится как отдельный документ в таких системах.
Следующий пример показывает данные, хранящиеся в JSON-документе. Эти данные касаются человека. В файле хранятся различные атрибуты, включая id, имя, email и так далее.
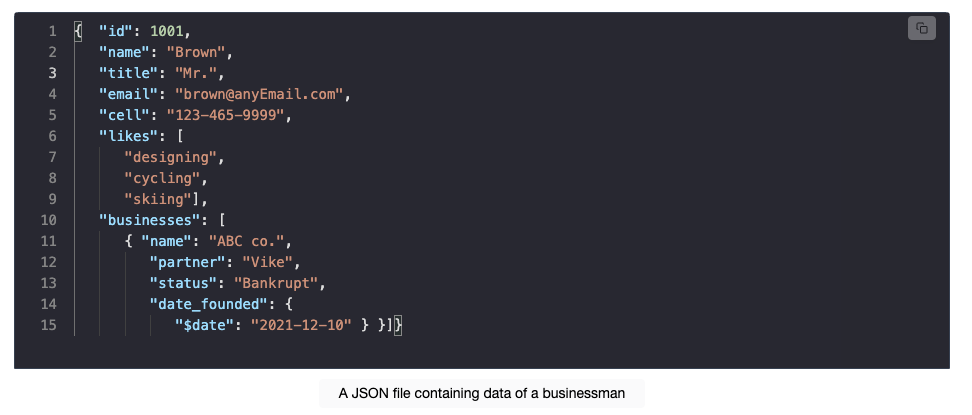
JSON и BSON — распространенные форматы для хранения данных в таких базах данных.
Graph database
Графовые базы данных используют структуру данных графа для хранения информации, где узлы представляют сущности, а рёбра показывают отношения между этими сущностями. Организация узлов на основе их связей позволяет выявлять интересные паттерны между ними. Графовые базы данных позволяют хранить данные один раз и затем интерпретировать их по-разному в зависимости от взаимосвязей. Популярные графовые базы данных включают Neo4J, OrientDB и InfiniteGraph. Данные графа хранятся в файловом хранилище для постоянного хранения. Каждый файл содержит данные для определенной части графа, таких как узлы, связи, свойства и так далее.
В следующем примере данные хранятся с использованием структуры графа, где узлы соединены между собой рёбрами, представляющими отношения между узлами. Каждый узел имеет некоторые свойства, такие как имя, идентификатор и возраст. Узел с идентификатором 2 имеет имя James и возраст 29 лет.
Пример использования
Графовые базы данных могут быть использованы в социальных приложениях для предоставления интересных фактов и данных о различных пользователях и их действиях. Основная задача графовых баз данных — хранение данных и создание возможностей для анализа и принятия решений на основе отношений между сущностями. Природа графовых баз данных делает их подходящими для различных приложений, таких как регулирование данных и обеспечение конфиденциальности, исследования в области машинного обучения, финансовые приложения и многие другие.
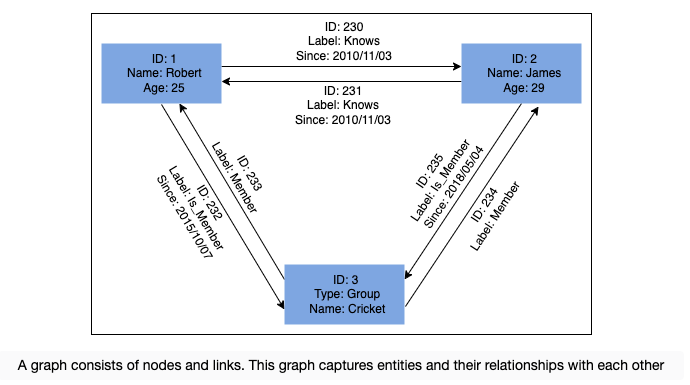
Примеры популярных графовых баз данных: Neo4J, OrientDB, InfiniteGraph.
Columnar database
Колонковые базы данных хранят данные в столбцах вместо строк. Это позволяет быстро и эффективно получать доступ ко всем записям в столбце базы данных. Популярные колонковые базы данных включают HBase, Hypertable и Amazon Redshift.
Пример использования
Колонковые базы данных эффективны для выполнения большого количества агрегатных запросов и запросов по аналитике данных. Они существенно снижают требования к вводу-выводу данных на диске и объем данных, который необходимо загрузить с диска. Например, в приложениях, связанных с финансовыми учреждениями, существует необходимость суммировать финансовые транзакции за определенный период времени. Колонковые базы данных ускоряют эту операцию, считывая только столбец с суммой денег, игнорируя другие атрибуты клиентов.
В следующем примере показана колонковая база данных, где данные хранятся в формате, ориентированном на столбцы. Это отличается от реляционных баз данных, которые хранят данные в строках:
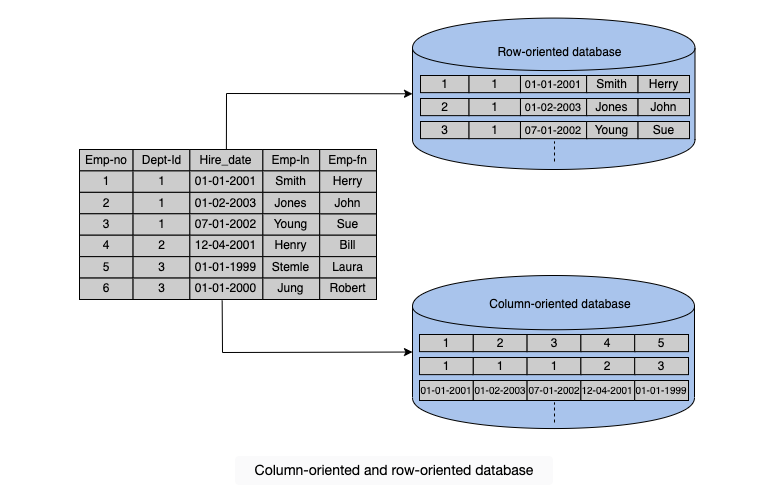
Примеры популярных колонковых баз данных: HBase, Hypertable, Amazon Redshift.
Недостатки NoSQL баз данных
-
Отсутствие стандартизации NoSQL не следует каким-либо конкретным стандартам, таким как реляционные базы данных следуют реляционной алгебре. Перенос приложений с одного типа NoSQL базы данных на другой может быть вызовом.
-
Консистентность NoSQL базы данных предоставляют различные продукты, основанные на конкретных компромиссах между консистентностью и доступностью в условиях возможных сбоев. Мы не будем иметь сильной целостности данных, такой как первичная и ссылочная целостность в реляционной базе данных. Данные могут быть не строго консистентными, но медленно сходиться, используя слабую модель, такую как eventual consistency.
Вопрос для оценки понимания
Imagine we’re designing a recommendation engine for a social networking platform with millions of users. The goal is to provide personalized recommendations for users to connect with others based on their interests, activities, and connections. Which database would be a natural fit for modeling and querying the complex relationship in a social network and why?
Выбор подходящей базы данных
Различные факторы влияют на выбор базы данных для использования в приложении. В таблице ниже показано сравнение реляционных и нереляционных баз данных, что поможет сделать правильный выбор:
| Реляционная база данных | Нереляционная база данных |
|---|---|
| Если данные, которые нужно хранить, структурированы | Если данные, которые нужно хранить, неструктурированы |
| Если требуются свойства ACID | Если необходимо сериализовать и десериализовать данные |
| Если размер данных относительно небольшой и может уместиться на одном узле | Если размер данных большой |
Примечание: Когда NoSQL базы данных только появились, их программирование и использование значительно отличались от традиционных баз данных. Однако благодаря обширным исследованиям в академической среде и индустрии за последние годы, различия между NoSQL и традиционными хранилищами, с точки зрения программиста, становятся менее заметными. Мы можем использовать те же SQL-конструкции для работы с NoSQL-хранилищем и получать аналогичный уровень производительности и консистентности, как и в традиционном хранилище. Примером такой базы данных является Google Cloud Spanner, которая поддерживает гео-репликацию с автоматическим горизонтальным шардированием и высокоскоростными глобальными снимками данных.
Quiz
Data Replication
Понимать модели, с помощью которых данные реплицируются на несколько узлов.
Репликация данных
Данные являются важным активом для организации, поскольку они управляют всем бизнесом. Данные предоставляют критически важные бизнес-инсайты о том, что важно и что нужно изменить. Организациям также необходимо надежно хранить данные своих клиентов и предоставлять к ним доступ по запросу. Своевременный доступ к необходимым данным в различных условиях (увеличение числа операций чтения и записи, отказ дисков и узлов, сбои в сети и электропитании и т.д.) необходим для успешного ведения онлайн-бизнеса.
Для нашего хранилища данных требуются следующие характеристики:
- Доступность в условиях сбоев (отказ отдельных дисков, узлов, сетевых и энергетических сбоев).
- Масштабируемость (при увеличении числа операций чтения, записи и других операций).
- Производительность (низкая задержка и высокая пропускная способность для клиентов).
Достичь вышеуказанных характеристик на одном узле сложно, а иногда и невозможно.
Репликация
Репликация означает поддержание нескольких копий данных на различных узлах (предпочтительно географически распределенных) для обеспечения доступности, масштабируемости и производительности. В этом уроке мы предполагаем, что один узел достаточно для хранения всех наших данных. Мы не будем использовать это предположение при обсуждении разделения данных на несколько узлов. Часто концепции репликации и разделения данных идут вместе.
Однако наряду с множеством преимуществ, таких как доступность, репликация вносит свои сложности. Репликация относительно проста, если реплицированные данные не требуют частых изменений. Основная проблема в репликации возникает, когда нужно поддерживать изменения в реплицированных данных с течением времени.
Дополнительные сложности, которые могут возникнуть из-за репликации:
- Как поддерживать согласованность нескольких копий данных друг с другом?
- Как справляться с отказами реплик-узлов?
- Следует ли выполнять репликацию синхронно или асинхронно?
- Как справляться с задержкой репликации в случае асинхронной репликации?
- Как обрабатывать параллельные записи?
- Какую модель согласованности нужно предоставить конечным программистам?
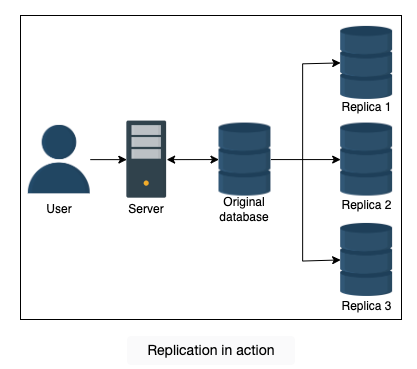
Когда говорится, что "один узел достаточно для хранения всех наших данных", это означает следующее:
-
Один узел (сервер): В данном контексте "узел" означает сервер или компьютер, который участвует в системе. Если говорится, что один узел достаточно для хранения всех данных, это значит, что весь объем данных может быть размещен на одном сервере без необходимости распределения этих данных на другие серверы.
-
Хранение всех данных на одном сервере: Если все данные могут быть размещены на одном сервере, то для данной задачи, теоретически, не требуется распределение (шардирование) данных по нескольким серверам. Это может быть актуально для небольших объемов данных или для начальных этапов разработки системы.
-
Ограниченность предположения: Важно понимать, что это предположение ограниченно. В реальных сценариях, когда объем данных растет, или когда требуется обеспечить высокую доступность и отказоустойчивость, система может потребовать хранения данных на нескольких узлах (серверах). Это делается для того, чтобы справляться с нагрузкой и обеспечивать бесперебойную работу системы в случае выхода из строя одного из узлов.
-
Репликация и шардирование: Часто концепции репликации (создание копий данных на нескольких узлах) и шардирования (разделение данных на части, которые хранятся на разных узлах) идут вместе. Репликация обеспечивает доступность и отказоустойчивость, а шардирование позволяет распределить нагрузку и обрабатывать большие объемы данных.
Пример: Предположим, у вас есть небольшое приложение с базой данных объемом 100 ГБ. В этом случае, один сервер с достаточным количеством памяти и дискового пространства может легко справиться с хранением всех данных. Однако если ваш объем данных увеличится до 10 ТБ, вам, скорее всего, понадобится распределить эти данные на несколько серверов и использовать репликацию и шардирование для обеспечения производительности и надежности системы.
Таким образом, утверждение о том, что "один узел достаточно", указывает на гипотетическую ситуацию, но в реальных условиях масштабирования вам, скорее всего, придется использовать более сложные схемы хранения данных.
Синхронная и асинхронная репликация
Прежде чем мы объясним различные типы репликации, давайте разберемся с синхронными и асинхронными подходами к репликации.
Синхронная и асинхронная репликация
Существуют два способа распространения изменений на реплики узлов:
- Синхронная репликация
- Асинхронная репликация
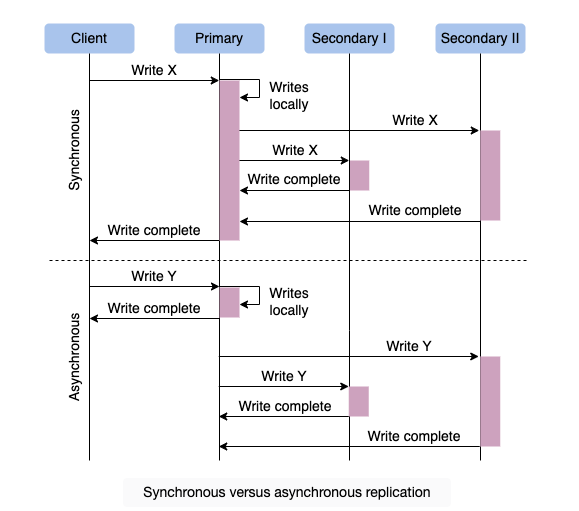
В синхронной репликации первичный узел ожидает подтверждения от вторичных узлов о том, что данные были обновлены. После получения подтверждения от всех вторичных узлов первичный узел сообщает клиенту об успешном выполнении операции. В асинхронной репликации первичный узел не ждет подтверждения от вторичных узлов и сообщает об успешном выполнении операции клиенту сразу после того, как обновил себя.
Преимущество синхронной репликации заключается в том, что все вторичные узлы полностью синхронизированы с первичным узлом. Однако у этого подхода есть недостаток. Если один из вторичных узлов не отправит подтверждение из-за сбоя или ошибки в сети, первичный узел не сможет подтвердить операцию клиенту до тех пор, пока не получит успешное подтверждение от сбойного узла. Это вызывает высокую задержку в ответе от первичного узла клиенту.
С другой стороны, преимущество асинхронной репликации заключается в том, что первичный узел может продолжать свою работу, даже если все вторичные узлы вышли из строя. Однако, если выйдет из строя сам первичный узел, записи, которые не были скопированы на вторичные узлы, будут потеряны.
Таким образом, здесь возникает компромисс между согласованностью данных и доступностью в условиях возможных отказов различных компонентов системы.
Вопрос для оценки понимания
Imagine you’re leading the database architecture for a real-time financial trading platform that operates globally. The platform demands extremely low-latency data updates to ensure traders receive up-to-the-moment information for making split-second decisions. The existing database infrastructure is struggling to meet the stringent latency requirements. In this case, the low latency is paramount, and a certain degree of eventual consistency is acceptable. Which one of the following two choices would you recommend for data updates in the database and why?
- Synchronous updates
- Asynchronous updates
Модели репликации данных
Теперь давайте обсудим различные механизмы репликации данных. В этом разделе мы рассмотрим следующие модели вместе с их сильными и слабыми сторонами:
- Репликация с одним лидером (single leader) или первично-вторичная репликация (primary-secondary replication)
- Репликация с несколькими лидерами (multi-leader replication)
- Репликация типа "все равны" или без лидера (peer-to-peer or leaderless replication)
Репликация с одним лидером (single leader)/первично-вторичная репликация (primary-secondary replication)
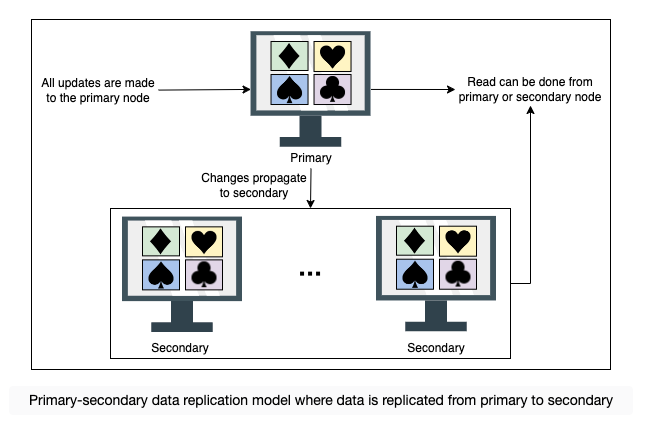
В первично-вторичной репликации данные реплицируются на несколько узлов. Один узел назначается первичным. Он отвечает за обработку всех записей данных, хранящихся в кластере. Также он отправляет все записи на вторичные узлы, чтобы поддерживать их синхронность.
Первично-вторичная репликация подходит, когда рабочая нагрузка преимущественно связана с чтением данных. Чтобы лучше масштабироваться с увеличением числа чтений, можно добавить больше вторичных узлов и распределить нагрузку на чтение между доступными вторичными узлами. Однако репликация данных на многие вторичные узлы может сделать первичный узел узким местом. Кроме того, первично-вторичная репликация не подходит, если рабочая нагрузка связана с большим объемом записи.
Еще одно преимущество первично-вторичной репликации заключается в ее устойчивости при чтении. Вторичные узлы могут продолжать обрабатывать запросы на чтение в случае сбоя первичного узла. Поэтому это полезный подход для приложений с интенсивным чтением.
Однако репликация данным способом может привести к несогласованности данных, если используется асинхронная репликация. Клиенты, читающие данные с разных реплик, могут видеть несогласованные данные в случае сбоя первичного узла, который не успел передать обновленные данные вторичным узлам. Таким образом, если первичный узел выйдет из строя, любые обновления, не переданные на вторичные узлы, могут быть потеряны.
Вопрос для оценки понимания
What happens when the primary node fails?
Методы первично-вторичной репликации
Существует несколько различных методов репликации в первично-вторичной репликации:
- Репликация на основе запросов (Statement-based replication)
- Передача журнала предзаписи (Write-ahead log, WAL)
- Логическая (построчная) репликация (Logical (row-based) replication)
Давайте подробно рассмотрим каждый из них.
Репликация на основе запросов (Statement-based replication)
Репликация на основе запросов (SBR) используется в базах данных MySQL. В этом подходе первичный узел выполняет SQL-запросы, такие как INSERT, UPDATE, DELETE и т.д., после чего запросы записываются в лог-файл. На следующем этапе лог-файл отправляется на вторичные узлы для выполнения. Этот тип репликации использовался в MySQL до версии 5.1.
Хотя этот тип репликации кажется удобным, у него есть и недостатки. Например, любые недетерминированные функции, такие как NOW(), могут привести к различным записям на первичном и вторичных узлах.
Примечание: Функция NOW() возвращает текущие дату и время в соответствии с системными часами.
Передача журнала предзаписи (Write-ahead log, WAL)
Передача журнала предзаписи (WAL) — это метод репликации данных, используемый в PostgreSQL и Oracle. В этом методе, когда происходит транзакция, она изначально записывается в транзакционный лог-файл, который затем записывается на диск. После этого записанные операции выполняются в основной базе данных, а затем передаются на вторичные узлы для выполнения. В отличие от SBR, WAL сохраняет транзакционные логи, а не SQL-запросы, что обеспечивает согласованность при работе с недетерминированными функциями. Запись на диск также помогает в восстановлении в случае сбоев.
Например, когда выполняется операция UPDATE в PostgreSQL, она сначала записывается в транзакционный лог-файл и на диск, прежде чем применяться к базе данных. Эта запись в транзакционном логе может содержать такие детали, как идентификатор транзакции, тип операции, затронутая таблица и новые значения, после чего изменения реплицируются на вторичные узлы. Однако недостатком WAL является его тесная связь с внутренней структурой движка базы данных, что усложняет обновление программного обеспечения на первичном и вторичных узлах.
Логическая (построчная) репликация (Logical (row-based) replication)
Логическая (построчная) репликация используется в различных реляционных базах данных, включая PostgreSQL и MySQL. В этом подходе изменения в базе данных фиксируются на уровне отдельных строк и затем реплицируются на вторичные узлы. Вместо репликации фактических физических изменений в базе данных этот подход фиксирует операции в логическом формате и затем выполняет их на вторичных узлах.
Например, когда выполняются операции INSERT или UPDATE, на первичном узле фиксируется вся затронутая строка, содержащая все значения столбцов указанной строки. Это зафиксированное изменение затем выполняется на вторичных узлах, где обеспечивается, что данные остаются согласованными с данными на первичном узле. Этот метод предлагает преимущества с точки зрения гибкости и совместимости с различными типами схем.
Многолидерная репликация (Multi-leader replication)
Как обсуждалось выше, у репликации с одним лидером (single leader replication) с использованием асинхронной репликации есть недостаток. Существует только один первичный узел, и все записи должны проходить через него, что ограничивает производительность. В случае сбоя первичного узла вторичные узлы могут не иметь обновленной базы данных.
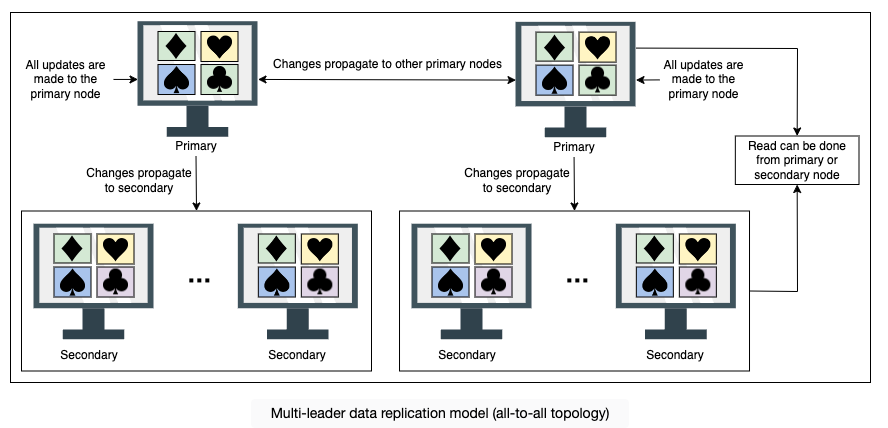
Многолидерная репликация (Multi-leader replication) является альтернативой репликации с одним лидером. Существует несколько первичных узлов, которые обрабатывают записи и отправляют их на все остальные первичные и вторичные узлы для репликации. Этот тип репликации используется в базах данных вместе с внешними инструментами, такими как Tungsten Replicator для MySQL.
Этот вид репликации особенно полезен в приложениях, в которых можно продолжать работу даже в автономном режиме. Например, в календарном приложении, где можно устанавливать встречи, даже если у вас нет доступа к интернету. Когда вы снова подключаетесь к сети, изменения реплицируются с локальной базы данных (ваш мобильный телефон или ноутбук действует как первичный узел) на другие узлы.
Конфликт в многолидерной репликации
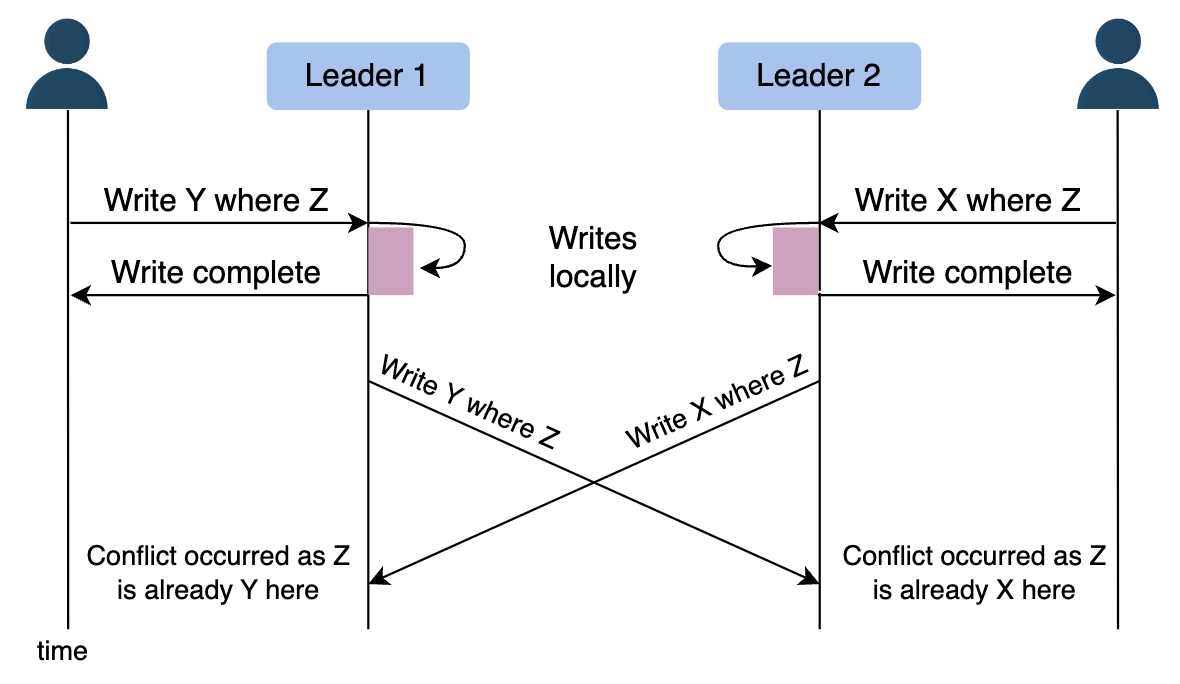
Многолидерная репликация обеспечивает лучшую производительность и масштабируемость по сравнению с репликацией с одним лидером, но также имеет значительный недостаток. Поскольку все первичные узлы одновременно обрабатывают запросы на запись, они могут модифицировать одни и те же данные, что может привести к конфликту между ними. Например, если два клиента одновременно редактируют одни и те же данные, их записи будут успешными на их соответствующих первичных узлах, но когда они асинхронно достигнут других первичных узлов, возникнет конфликт.
Обработка конфликтов
Конфликты могут привести к различным данным на разных узлах. Эти конфликты должны быть обработаны эффективно, чтобы не потерять данные. Рассмотрим некоторые подходы к обработке конфликтов:
Избежание конфликтов (Conflict avoidance)
Один из простых способов обработки конфликтов — предотвратить их возникновение. Конфликтов можно избежать, если приложение может убедиться, что все операции записи для данной записи проходят через одного лидера.
Однако конфликт может возникнуть, если пользователь переместится в другое место и окажется ближе к другому дата-центру. В таком случае необходимо перенаправить трафик. В подобных сценариях подход избегания конфликтов может не сработать, что приведет к возникновению конкурентных записей.
Подход "Последнее изменение побеждает" (Last-write-wins)
Все узлы присваивают временную метку каждому обновлению с использованием своих локальных часов. Когда возникает конфликт, выбирается обновление с самой последней временной меткой.
Этот подход также может создать проблемы, так как синхронизация часов между узлами в распределенных системах является сложной задачей. Смещение часов может привести к потере данных.
Пользовательская логика (Custom logic)
В этом подходе можно написать собственную логику для обработки конфликтов в соответствии с потребностями приложения. Эта пользовательская логика может выполняться как при чтении, так и при записи. Когда система обнаруживает конфликт, она вызывает пользовательский обработчик конфликтов.
Топологии многолидерной репликации (Multi-leader replication topologies)
Существует множество топологий для реализации многолидерной репликации, таких как круговая топология (circular topology), звездообразная топология (star topology) и топология "все ко всем" (all-to-all topology). Наиболее распространенной является топология "все ко всем". В звездообразной и круговой топологиях существует схожий недостаток: если один из узлов выходит из строя, это может повлиять на всю систему. Именно поэтому топология "все ко всем" является наиболее используемой.
Репликация Peer-to-peer/без лидера (Peer-to-peer/leaderless replication)
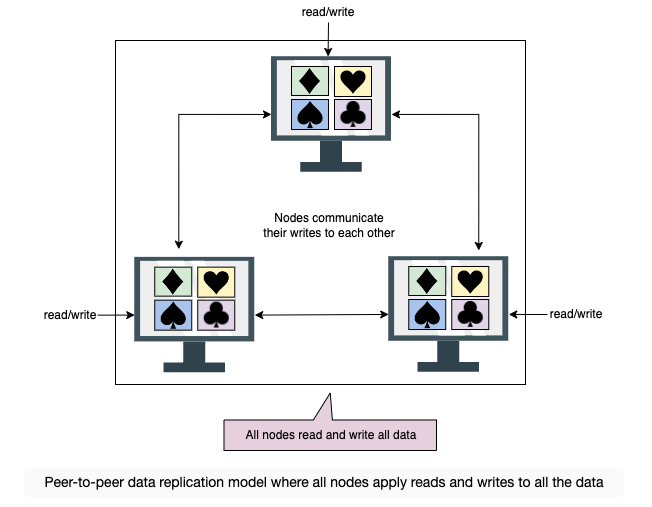
В репликации "лидер-последователь" (primary-secondary replication) первичный узел является узким местом и единственной точкой отказа. Кроме того, этот подход помогает достичь масштабируемости чтения, но не обеспечивает масштабируемость записи. Модель репликации peer-to-peer решает эти проблемы, не имея одного первичного узла. Все узлы имеют равный вес и могут принимать запросы на чтение и запись. Эта схема репликации используется в базе данных Cassandra.
Все три модели репликации данных — с одним лидером (single leader), с несколькими лидерами (multi-leader), и без лидера (leaderless) — могут быть реализованы как с использованием синхронной, так и асинхронной репликации. Давайте рассмотрим каждую модель:
Итог по репликациям
1. Репликация с одним лидером (Single Leader or Primary-Secondary Replication)
-
Синхронная репликация: В этой конфигурации основной узел (лидер) синхронно передает обновления вторичным узлам (репликам). Это значит, что лидер будет ждать подтверждения от вторичных узлов о том, что данные были успешно записаны, прежде чем считать транзакцию завершенной. Это обеспечивает высокий уровень согласованности данных, но может привести к увеличению задержки, если вторичные узлы находятся далеко или имеют низкую производительность.
-
Асинхронная репликация: В этом случае лидер передает данные вторичным узлам асинхронно. Лидер не ждет подтверждения от вторичных узлов и сразу же отвечает клиенту об успешном завершении операции. Это улучшает производительность и снижает задержки, но может привести к временной неконсистентности данных на вторичных узлах, особенно в случае сбоя основного узла до завершения репликации.
2. Репликация с несколькими лидерами (Multi-Leader Replication)
-
Синхронная репликация: Лидеры синхронно обмениваются данными между собой, чтобы обеспечить консистентность данных во всех узлах. Однако это может привести к значительным задержкам и усложнению процесса, особенно при географически распределенных узлах.
-
Асинхронная репликация: Лидеры асинхронно передают данные друг другу. Это уменьшает задержки и повышает производительность, но также увеличивает риск возникновения конфликтов при записи, так как изменения могут не сразу распространяться между лидерами.
3. Репликация типа "все равны" или без лидера (Peer-to-Peer or Leaderless Replication)
-
Синхронная репликация: Каждый узел в сети синхронно обменивается данными с другими узлами. Например, для записи данных требуется подтверждение от большинства узлов (кворум), что обеспечивает высокий уровень согласованности. Однако это может существенно замедлить операции записи.
-
Асинхронная репликация: Узлы асинхронно передают обновления друг другу, что улучшает производительность, но может привести к возникновению конфликтов и временной неконсистентности данных. Например, в таких системах, как Cassandra, используется механизм кворума для чтения и записи, чтобы смягчить эффект асинхронной репликации.
Вывод
Все три модели репликации могут быть реализованы как с синхронной, так и с асинхронной репликацией, в зависимости от требований к согласованности, доступности и производительности системы. Синхронная репликация обеспечивает более высокую согласованность, но может ухудшить производительность, в то время как асинхронная репликация повышает доступность и производительность за счет временной неконсистентности данных.
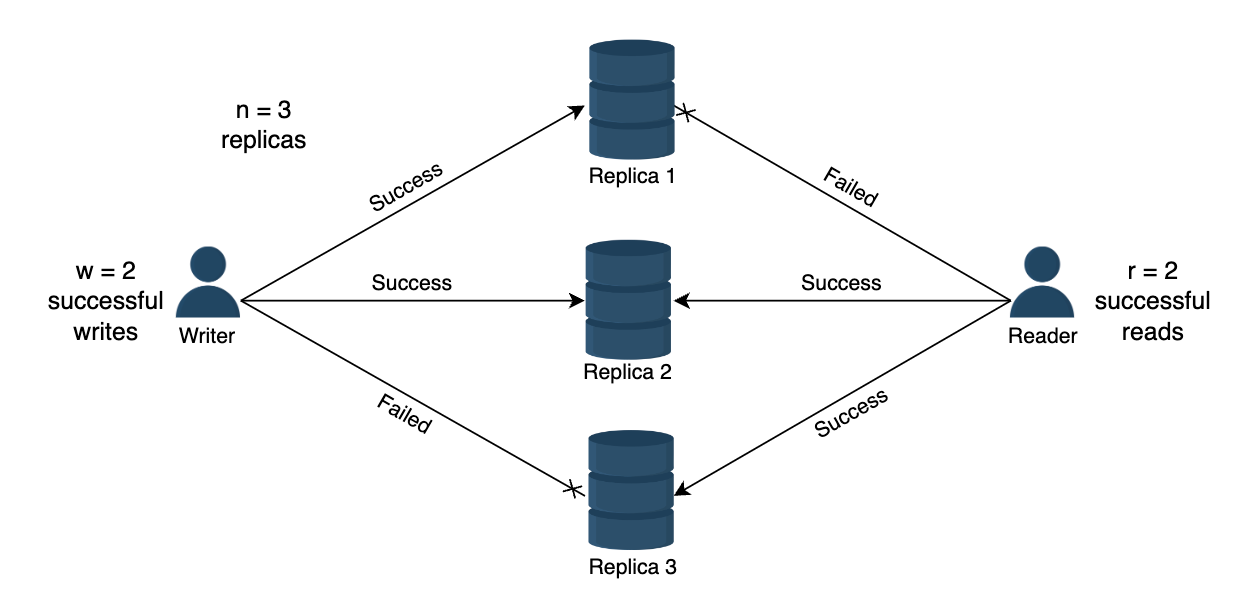
Кворумы (Quorums)
Предположим, у нас есть три узла. Если как минимум два из трёх узлов успешно принимают обновления, это означает, что только один узел вышел из строя. Это значит, что если мы читаем данные с двух узлов, по крайней мере один из них будет иметь обновлённую версию, и наша система сможет продолжать работать.
Вопрос для оценки понимания
Data Partitioning - Разделение данных
Why do we partition data? - Зачем мы разделяем данные?
Данные являются важным активом для любой организации. С увеличением объема данных и числа одновременных операций чтения/записи на традиционные базы данных оказывается давление по масштабируемости. В результате увеличивается задержка и снижается пропускная способность. Традиционные базы данных привлекательны благодаря таким свойствам, как запросы диапазона, вторичные индексы и транзакции с поддержкой свойств ACID.
Однако в какой-то момент базы данных на одном узле перестают справляться с нагрузкой. Возникает необходимость распределить данные по нескольким узлам, при этом стремясь сохранить все преимущества реляционных баз данных. На практике оказалось сложно обеспечить свойства одноузловых баз данных в распределенных системах.
Одним из решений может стать переход на систему, подобную NoSQL. Однако миграция на NoSQL может быть дорогой и сложной задачей, особенно если текущий код тесно связан с традиционными базами данных.
Организации могут попытаться масштабировать традиционные базы данных с помощью сторонних решений. Однако часто интеграция таких решений может быть связана с дополнительными сложностями. Более того, существует множество возможностей для оптимизации в соответствии с конкретной задачей, что может дать лучшие результаты по сравнению с универсальными решениями.
Разделение данных (или шардирование) позволяет нам использовать несколько узлов, каждый из которых управляет определенной частью данных. Чтобы справиться с ростом числа запросов и объема данных, необходимо стремиться к сбалансированным разделам и равномерной нагрузке на операции чтения/записи.
В этом уроке мы обсудим различные способы разделения данных, связанные с этим проблемы и их решения.
Sharding - Шардирование
Чтобы распределить нагрузку между несколькими узлами, необходимо разделить данные с помощью метода, известного как partitioning или sharding. В этом подходе мы разбиваем большой набор данных на более мелкие части, которые хранятся на разных узлах нашей сети.
Partitioning должен быть сбалансированным, чтобы каждая часть получала примерно одинаковое количество данных. Если partitioning несбалансирован, большинство запросов будет попадать на несколько частей. Части, которые сильно загружены, создадут узкое место в системе. Эффективность partitioning пострадает, так как значительная часть запросов на извлечение данных будет направляться к узлам, на которых находятся перегруженные шардированные части. Такие части данных известны как hotspots. Обычно мы используем следующие два способа sharding данных:
Vertical sharding - Вертикальное шардирование
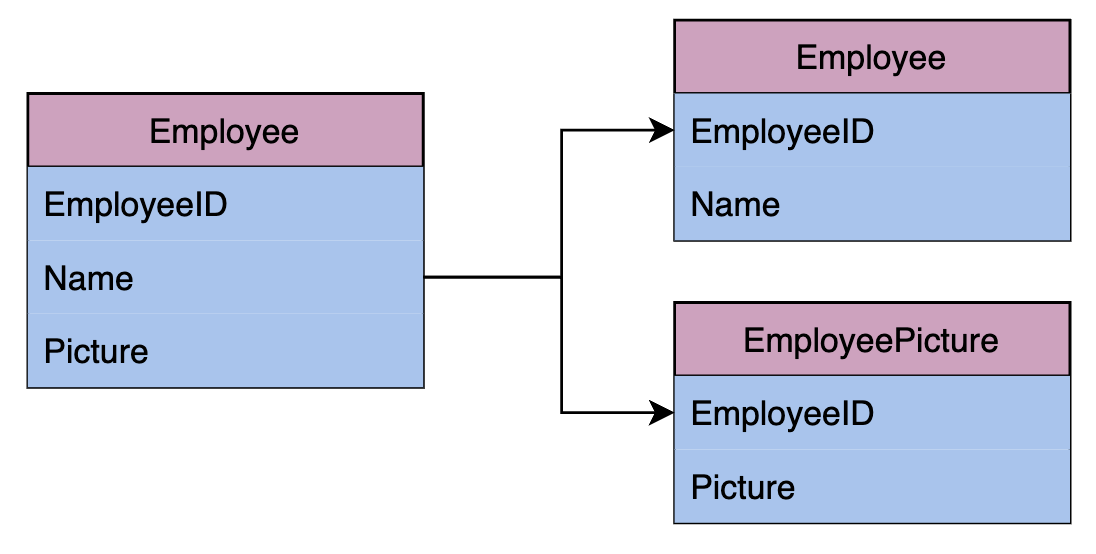
Мы можем размещать разные таблицы в различных экземплярах базы данных, которые могут работать на разных физических серверах. Мы можем разделить одну таблицу на несколько, чтобы одни столбцы находились в одной таблице, а остальные — в другой. Нужно быть осторожными, если есть связи (joins) между несколькими таблицами. В таких случаях мы можем предпочесть держать такие таблицы вместе на одном shard.
Часто vertical sharding используется для увеличения скорости извлечения данных из таблицы, содержащей столбцы с очень широким текстом или бинарными большими объектами (blob). В этом случае столбец с большим текстом или blob разделяется на отдельную таблицу.
Как показано на рисунке ниже, таблица Employee делится на две таблицы: уменьшенная таблица Employee и таблица EmployeePicture. Таблица EmployeePicture имеет всего два столбца: EmployeeID и Picture, отделенные от исходной таблицы. Более того, первичный ключ EmployeeID таблицы Employee добавляется в обе разделенные таблицы. Это упрощает чтение и запись данных, а также эффективно выполняет восстановление таблицы.
Vertical sharding имеет свои сложности и больше подходит для ручного partitioning, когда заинтересованные стороны тщательно решают, как разделить данные. В сравнении с ним horizontal sharding более пригоден для автоматизации, даже в динамичных условиях.
Horizontal sharding - Горизонтальное шардирование
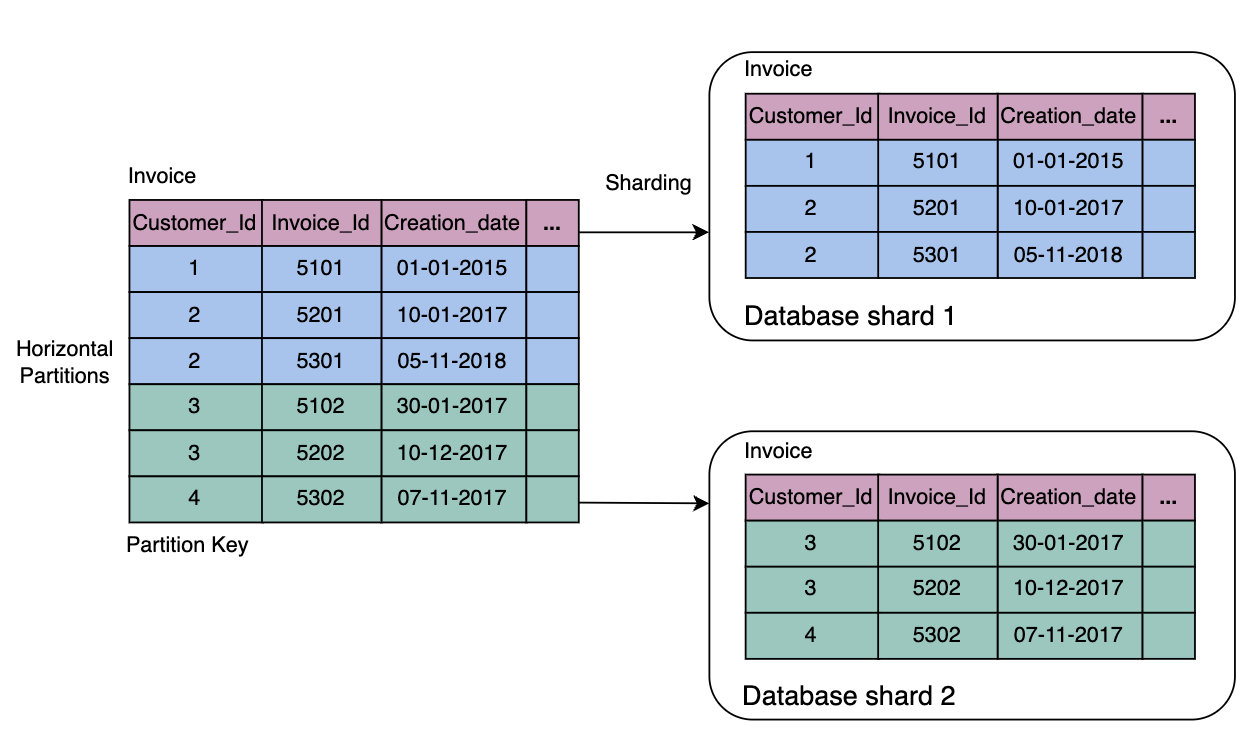
Иногда некоторые таблицы в базах данных становятся слишком большими и влияют на задержку операций чтения/записи. Горизонтальное шардирование (Horizontal sharding) или разделение используется для деления таблицы на несколько таблиц путем разбиения данных по строкам, как показано на рисунке в следующем разделе. Каждая часть оригинальной таблицы, распределенная по серверам баз данных, называется шардом (shard). Обычно доступны две стратегии:
Key-range Based Sharding - Шардирование на основе диапазона ключей
В Key-range based sharding каждая часть данных назначается непрерывному диапазону ключей.
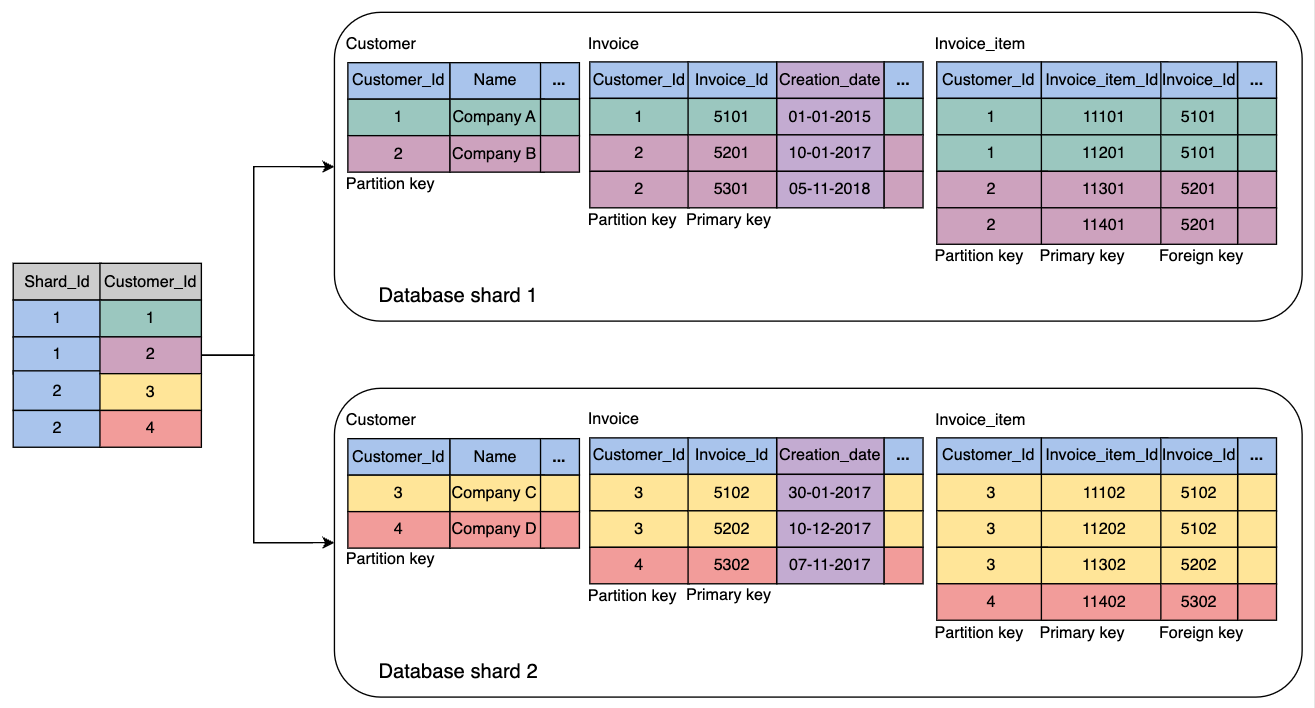
На следующем рисунке горизонтальное разделение таблицы Invoice выполняется с использованием Key-range based sharding, где в качестве ключа разделения (partition key) используется Customer_Id. Две таблицы разных цветов представляют собой разделы (partitions).
Иногда база данных состоит из нескольких таблиц, связанных между собой внешними ключами (foreign key relationships). В таком случае горизонтальное шардирование (horizontal partition) выполняется с использованием одного и того же ключа разделения (partition key) для всех таблиц в отношениях. Таблицы (или подтаблицы), относящиеся к одному и тому же ключу разделения, распределяются в один шард базы данных. На следующем рисунке показано, что несколько таблиц с одним и тем же ключом разделения помещены в один шард базы данных:
Преимущества Key-range Based Sharding
- Используя метод шардирования на основе диапазона ключей (key-range-based sharding), схема запросов по диапазону ключей легко реализуется. Мы точно знаем, где (на каком узле, в каком шарде) искать определенный диапазон ключей.
- Запросы по диапазону могут выполняться с использованием ключей разделения, которые можно хранить в разделах в отсортированном порядке. Как именно происходит такая сортировка с течением времени, когда появляются новые данные, зависит от реализации.
Недостатки Key-range Based Sharding
- Запросы по диапазону не могут выполняться с использованием ключей, отличных от ключа разделения.
- Если ключи выбраны неправильно, некоторые узлы могут оказаться перегруженными данными из-за неравномерного распределения трафика.
Hash-based sharding - Хеш-шардирование
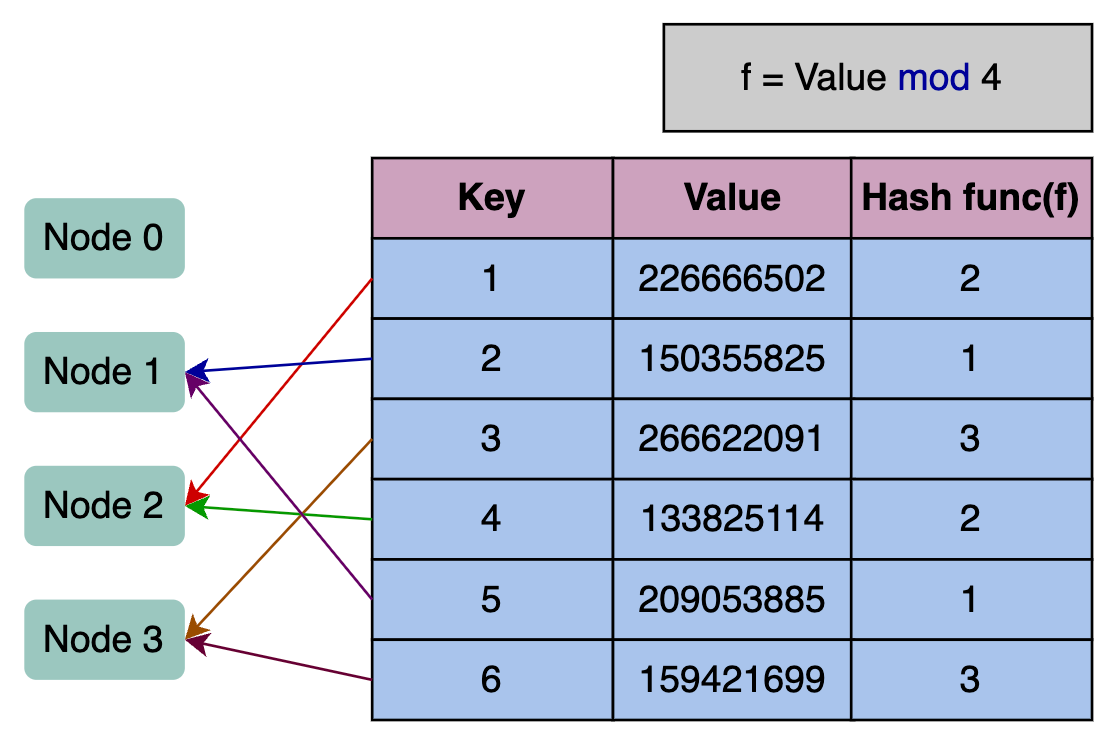
Hash-based sharding использует хеш-функцию для атрибута. Эта хеш-функция создает значение хеша, которое используется для выполнения разделения. Основная концепция заключается в использовании хеш-функции на ключе для получения значения хеша, а затем взятия остатка от деления на количество разделов. После того как мы нашли подходящую хеш-функцию для ключей, мы можем присвоить каждому разделу диапазон хешей (вместо диапазона ключей). Любой ключ, чей хеш попадает в этот диапазон, будет храниться в этом разделе.
На рисунке ниже мы используем хеш-функцию Value mod n. Здесь n — это количество узлов, равное четырем. Мы распределяем ключи по узлам, проверяя результат операции mod для каждого ключа. Ключи с остатком от деления равным 2 присваиваются узлу 2. Ключи с остатком от деления равным 1 присваиваются узлу 1. Ключи с остатком от деления равным 3 присваиваются узлу 3. Так как нет ключей с остатком от деления равным 0, узел 0 остается пустым.
Преимущества Hash-based sharding
- Ключи равномерно распределены по узлам.
Недостатки Hash-based sharding
- Мы не можем выполнять запросы по диапазону с помощью этой техники. Ключи будут распределены по всем разделам.
Consistent hashing - Консистентное хеширование
Consistent hashing - это метод, который назначает каждому серверу или объекту в распределенной хэш-таблице место на абстрактном круге, называемом кольцом, независимо от количества серверов в таблице. Это позволяет масштабировать серверы и объекты без ущерба для общей производительности системы.
Преимущества consistent hashing
- Легко масштабировать горизонтально.
- Увеличивает пропускную способность и улучшает задержку приложения.
Недостатки consistent hashing
- Случайное назначение узлов в кольце может привести к неравномерному распределению.
Rebalance the partitions - Перебалансировка разделов
Нагрузка на запросы может быть неравномерно распределена между узлами по многим причинам, включая следующие:
- Распределение данных неравномерно.
- Слишком большая нагрузка на одну партицию.
- Увеличение трафика запросов, требующее добавления большего количества узлов для поддержания производительности.
Стратегии для перебалансировки разделов
Avoid hash mod n - Избегайте hash mod n
Обычно мы избегаем использования хэша ключа для разделения (такую схему мы использовали ранее для объяснения концепции хеширования в простых терминах). Проблема с добавлением или удалением узлов в случае hash mod n заключается в том, что номер партиции каждого узла изменяется, и множество данных перемещается. Например, предположим, что у нас есть hash(key)=1235. Если у нас есть пять узлов, ключ будет назначен на узел 1 (1235 mod 5 = 0). Теперь, если добавляется новый узел, ключ придется переместить на узел 6 (1235 mod 6 = 5), и так далее. Это перемещение ключей между узлами делает перебалансировку затратной.
Fixed number of partitions - Фиксированное количество разделов
В этом подходе количество создаваемых разделов фиксируется на этапе настройки базы данных. Мы создаем большее количество разделов, чем узлов, и назначаем эти разделы узлам. Таким образом, когда новый узел добавляется в систему, он может забрать несколько разделов у существующих узлов, пока разделы не будут равномерно распределены.
Минус этого подхода заключается в том, что размер каждого раздела увеличивается с общим объемом данных в кластере, так как все разделы содержат небольшую часть общих данных. Если раздел слишком мал, это приведет к чрезмерным накладным расходам, так как нам придется создавать большое количество мелких разделов, каждый из которых требует дополнительных затрат. Если раздел слишком велик, перебалансировка узлов и восстановление после сбоев будут дорогостоящими. Очень важно правильно выбрать количество разделов. Подход с фиксированным количеством разделов используется в Elasticsearch, Riak и многих других.
Dynamic partitioning - Динамическое разделение
В этом подходе, когда размер раздела достигает порогового значения, он делится на два равных раздела. Один из двух разделов назначается одному узлу, а другой - другому узлу. Таким образом, нагрузка равномерно распределяется. Количество разделов адаптируется к общему объему данных, что является преимуществом динамического разделения.
Недостатки Dynamic partitioning
Трудно применять динамическую перебалансировку во время чтения и записи. Динамическая перебалансировка во время чтения и записи сложна, так как она включает перемещение данных между узлами, что вызывает задержки и возможные конфликты. Обеспечение консистентности данных (так как данные одновременно перемещаются и обращаются к ним) и доступности (возможно, потребуется приостановить операции чтения/записи во время перебалансировки) вводит сложности, которые могут повлиять на производительность и надежность системы. Этот подход используется в HBase и MongoDB.
Partition proportionally to nodes - Пропорциональное разделение на узлы
В этом подходе количество разделов пропорционально количеству узлов, что означает, что каждый узел имеет фиксированные разделы. В предыдущих подходах количество разделов зависело от размера набора данных. Здесь это не так. Пока количество узлов остается постоянным, размер каждого раздела увеличивается в зависимости от размера набора данных. Однако с увеличением числа узлов разделы уменьшаются. Когда новый узел входит в сеть, он случайным образом делит определенное количество текущих разделов, затем берет одну половину раздела и оставляет другую половину. Это может привести к неравномерному разделению. Этот подход используется в Cassandra и Ketama.
Who performs the rebalancing? Is it automatic or manual?
There are two ways to perform rebalancing: automatic and manual. In automatic rebalancing, there’s no administrator. The system determines when to perform the partitions and when to move data from one node to another.
In manual rebalancing, the administrator determines when and how to perform the partitioning. Organizations perform rebalancing according to their needs. Some use automatic rebalancing, and some use manual.
Partitioning and secondary indexes - Разделение и вторичные индексы
Мы обсудили схемы разделения моделей данных key-value, в которых записи извлекаются с помощью первичных ключей. Но что, если нам нужно получить доступ к записям через вторичные индексы? Вторичные индексы — это записи, которые не идентифицируются первичными ключами, а используются для поиска по определенным значениям. Например, на предыдущем рисунке горизонтального шардирования присутствует таблица клиентов, где выполняется поиск всех клиентов с одинаковым годом создания.
Мы можем разделить данные с использованием вторичных индексов следующими способами.
Partition secondary indexes by document - Разделение вторичных индексов по документам
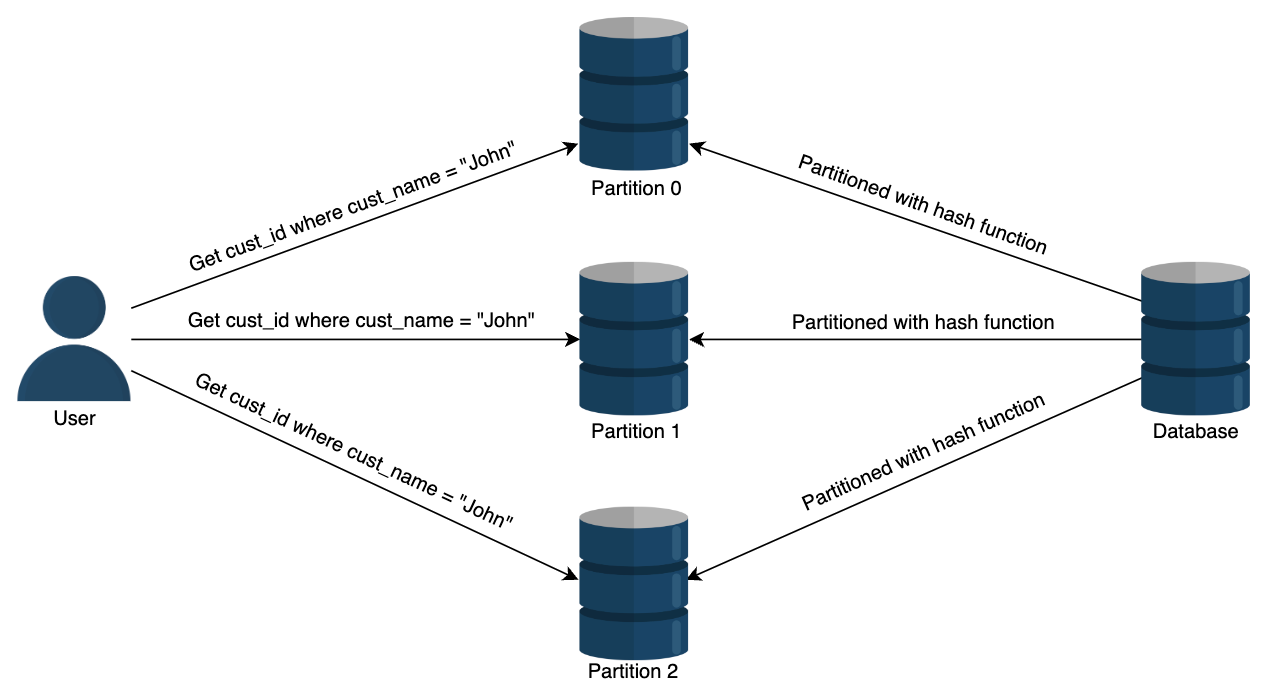
В этом подходе индексирования каждая партиция полностью независима. Каждая партиция имеет свои вторичные индексы, охватывающие только документы в этой партиции. Она не учитывает данные, хранящиеся в других партициях. Если мы хотим записать что-либо в нашу базу данных, мы должны работать только с той партицией, которая содержит ID документа, который мы записываем. Этот метод также известен как локальный индекс (local index). На рисунке ниже показаны три партиции, каждая из которых имеет свою собственную идентичность и данные. Если мы хотим получить все ID клиентов с именем Джон, нам придется сделать запрос ко всем партициям.
Однако такой тип запросов по вторичным индексам может быть дорогим. В результате ограничения по задержке слабо работающей партиции время выполнения запросов на чтение может увеличиться.
Partition secondary indexes by the term - Разделение вторичных индексов по термину
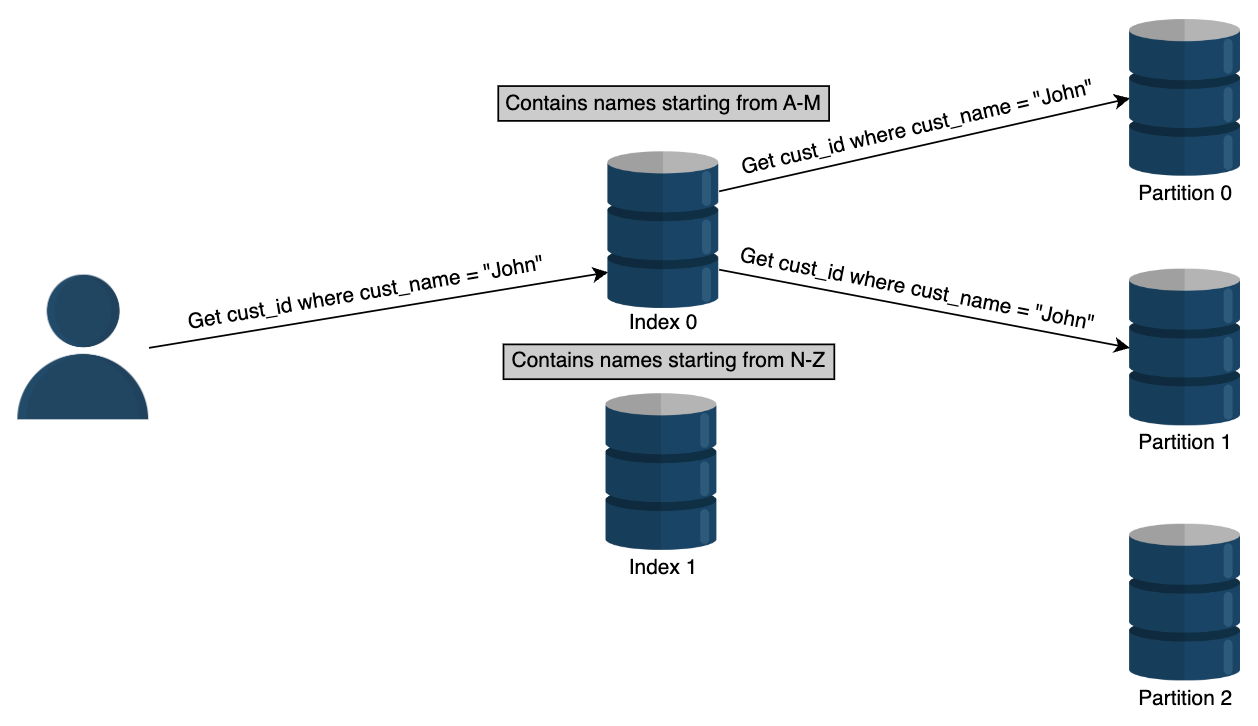
Вместо создания вторичного индекса для каждой партиции (локального индекса) мы можем создать глобальный индекс для вторичных терминов, который охватывает данные из всех партиций.
На рисунке ниже мы создаем индексы по именам (термин, по которому мы разделяем) и храним все индексы имен на отдельных узлах. Чтобы получить cust_id всех клиентов с именем Джон, нам нужно определить, где расположен наш индекс термина. Индекс 0 содержит всех клиентов с именами, начинающимися на "A" до "M". Индекс 1 включает всех клиентов с именами, начинающимися на "N" до "Z". Так как имя Джон находится в индексе 0, мы получаем список cust_id с именем Джон из индекса 0.
Разделение вторичных индексов по термину более эффективно для чтения, чем разделение вторичных индексов по документам. Это связано с тем, что метод обращается только к партиции, содержащей данный термин. Однако одна запись в этой схеме затрагивает несколько партиций, что делает метод более ресурсоемким и сложным при записи данных.
Request routing - Маршрутизация запросов
Мы уже узнали, как разделять наши данные. Однако возникает вопрос: как клиент узнает, к какому узлу подключиться при выполнении запроса? Распределение партиций по узлам меняется после перебалансировки. Если мы хотим прочитать определенный ключ, как мы узнаем, к какому IP-адресу нужно подключиться для чтения?
Эта проблема также известна как service discovery (обнаружение сервисов). Рассмотрим несколько подходов к ее решению:
-
Разрешить клиентам запрашивать любой узел в сети. Если этот узел не содержит запрашиваемые данные, он перенаправляет запрос на узел, который содержит соответствующие данные.
-
Использование уровня маршрутизации. Все запросы сначала направляются на уровень маршрутизации, который определяет, к какому узлу нужно подключиться для выполнения запроса.
-
Клиенты уже обладают информацией о разделении данных и о том, какая партиция подключена к какому узлу. Таким образом, они могут напрямую обращаться к узлу, который содержит необходимые данные.
Во всех этих подходах основной задачей является определение того, как эти компоненты узнают об изменениях в партиционировании узлов.
ZooKeeper
Чтобы отслеживать изменения в кластере, многим распределенным системам данных требуется отдельный сервер управления, такой как ZooKeeper. ZooKeeper отслеживает все сопоставления в сети, и каждый узел подключается к ZooKeeper для получения этой информации. Когда происходит изменение в партиционировании или добавляется/удаляется узел, ZooKeeper обновляется и уведомляет уровень маршрутизации о произошедших изменениях. HBase, Kafka и SolrCloud используют ZooKeeper.
Imagine you’re a database architect for a rapidly expanding e-commerce platform with a global user base. The platform experiences varying user activity levels across different regions, as illustrated below. The existing monolithic database struggles to handle the increasing load. Users in different regions have distinct sets of preferences and tend to interact more within their regions. Now, we’re looking for an efficient and scalable solution to optimize performance, enhance scalability, and cater to regional variations in user behavior. Regarding this, which one of the following strategies would you adopt, and why?
Database sharding
Database replication
Note: Provide your answer in the following interactive widget:
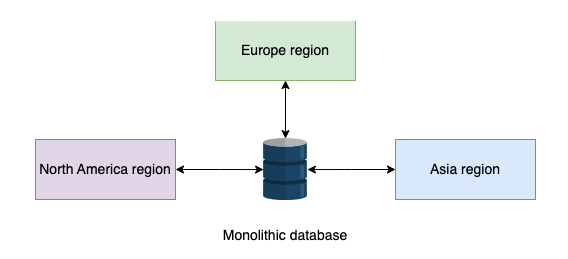
In the given scenario of a rapidly expanding e-commerce platform with regional variations in user behavior, the most suitable strategy would be to implement database sharding. This approach involves dividing the database into smaller, manageable parts known as shards, with each shard responsible for a subset of data. This strategy aligns well with the regional variations in user behavior and activity levels, thereby optimizing performance and enhancing scalability.
Conclusion - Заключение
Для всех современных распределенных систем разделение данных (partitioning) стало стандартным протоколом. Поскольку объем данных в системах постоянно растет, разделение данных становится необходимым, так как оно ускоряет как запись, так и чтение. Это увеличивает доступность, масштабируемость и производительность системы.
Trade-offs in Databases
Which is the best database sharding approach? - Какой подход к шардированию базы данных является лучшим?
И горизонтальное, и вертикальное шардирование предполагают добавление ресурсов в нашу вычислительную инфраструктуру. Наши бизнес-заинтересованные стороны должны решить, какой подход подходит для нашей организации. Мы должны масштабировать ресурсы соответственно для роста нашей организации и бизнеса, чтобы предотвратить простои и уменьшить задержку. Мы можем масштабировать эти ресурсы, корректируя такие параметры, как CPU, требования к физической памяти, настройки жесткого диска и пропускную способность сети.
Следующие разделы объясняют плюсы и минусы отсутствия шардирования и шардирования.
Advantages and disadvantages of a centralized database - Преимущества и недостатки централизованной базы данных
Advantages - Преимущества
- Обслуживание данных, такое как обновление и создание резервных копий централизованной базы данных, является простым.
- Централизованные базы данных обеспечивают более сильную консистентность и транзакции с поддержкой ACID по сравнению с распределенными базами данных.
- Централизованные базы данных обеспечивают гораздо более простую модель программирования для конечных программистов по сравнению с распределенными базами данных.
- Это более эффективно для бизнеса, который имеет небольшой объем данных, который может храниться на одном узле.
Disadvantages - Недостатки
- Централизованная база данных может замедляться, вызывая высокую задержку для конечных пользователей, когда количество запросов в секунду, обращающихся к централизованной базе данных, приближается к пределам одного узла.
- Централизованная база данных имеет одну точку отказа. Из-за этого вероятность ее недоступности намного выше.
Advantages and disadvantages of a distributed database - Преимущества и недостатки распределенной базы данных
Advantages - Преимущества
- Доступ к данным в распределенной базе данных быстрый и легкий, так как данные извлекаются из ближайшего шардированного узла или часто используемого узла.
- Данные с разными уровнями прозрачности распределения могут храниться в разных местах.
- Интенсивные транзакции, состоящие из запросов, могут быть разделены на несколько оптимизированных подзапросов, которые могут обрабатываться параллельно.
Disadvantages - Недостатки
- Иногда требуется доступ к данным с нескольких сайтов, что может занять больше времени, чем ожидалось.
- Отношения разделены вертикально или горизонтально между разными узлами. Поэтому такие операции, как соединения (joins), требуют восстановления полных отношений, что может стать более дорогим и сложным.
- Поддержание консистентности данных между сайтами в распределенной базе данных сложно и требует дополнительных мер.
- Обновления и создание резервных копий в распределенных базах данных требуют времени для синхронизации данных.
Query optimization and processing speed in a distributed database - Оптимизация запросов и скорость обработки в распределенной базе данных
Транзакция в распределенной базе данных зависит от типа запроса, количества задействованных сайтов (шардов), скорости передачи данных и других факторов, таких как базовое оборудование и тип используемой базы данных. Рассмотрим следующий пример:
Предположим, что в запросе участвуют три таблицы: Store, Product и Sales, которые находятся на разных сайтах.
Схема базы данных, состоящая из трех таблиц: Store, Product, и Sales
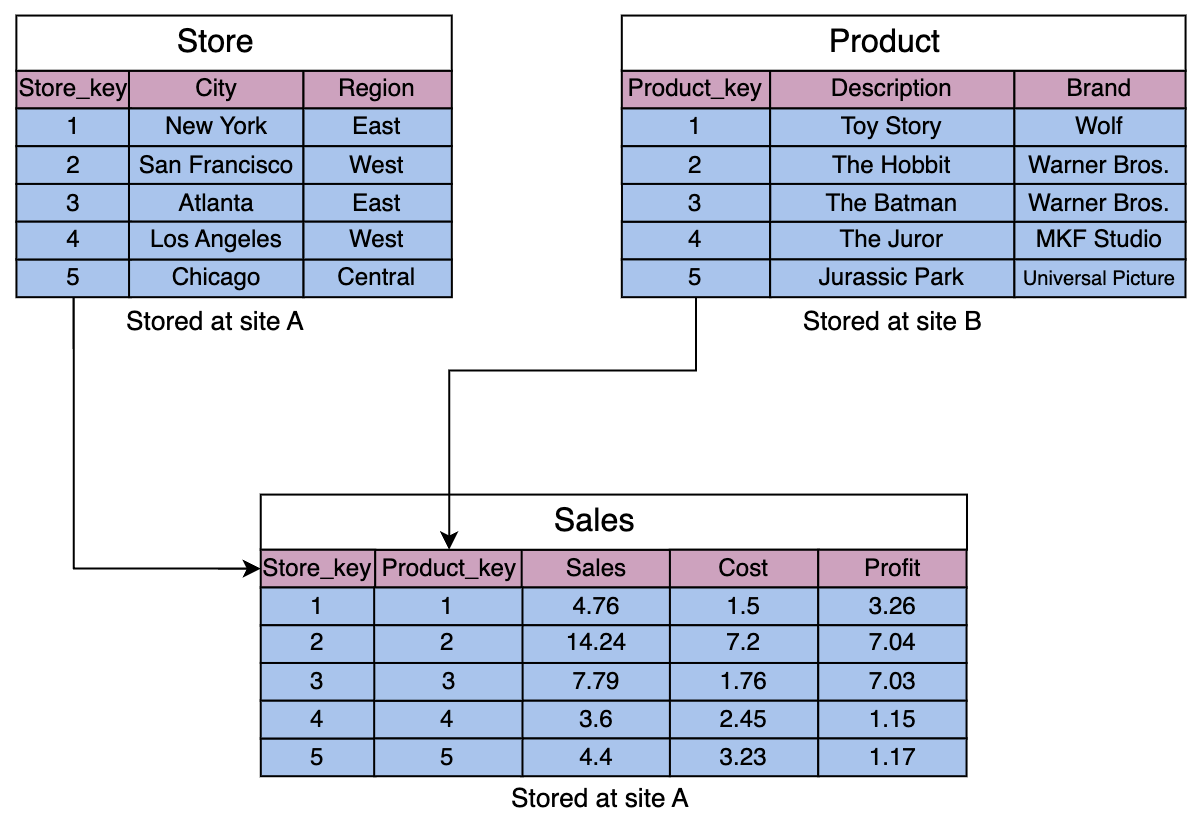
Предположим, что распределение этих таблиц по разным сайтам следующее:
- Таблица
Storeсодержит 10,000 кортежей, хранящихся на сайте A. - Таблица
Productсодержит 100,000 кортежей, хранящихся на сайте B. - Таблица
Salesсодержит один миллион кортежей, хранящихся на сайте A.
Теперь предположим, что нам нужно обработать следующий запрос:
Select Store_key from (Store JOIN Sales JOIN Product)
where Region= 'East' AND Brand='Wolf';
Вышеприведенный запрос выполняет операции JOIN над таблицами Store, Sales и Product и извлекает значения Store_key из таблицы, сгенерированной в результате операций JOIN.
Предположим, что каждый сохраненный кортеж имеет длину 200 бит, что равно 25 байтам. Кроме того, оценочные кардинальности некоторых промежуточных результатов следующие:
- Количество бренда
Wolfравно 10. - Количество магазинов в регионе
Eastсоставляет 3000 (поскольку в таблицеStoreесть 10,000 строк, из которых 3000 имеют регионEast).
Предположения о связи следующие:
- Скорость передачи данных = 50 Мбит в секунду
- Задержка доступа = 0.1 секунда
Параметры предположения
Прежде чем обрабатывать запрос с использованием различных подходов, давайте определим некоторые параметры:
a= Общая задержка доступаb= Скорость передачи данныхv= Общий объем данных
Теперь давайте вычислим общее время передачи данных T по следующей формуле:
T = a + (v / b)
Возможные подходы
- Переместить таблицу Product на сайт A и обработать запрос на A:
T = 0.1 + (100,000 × 200) / 50,000,000 = 0.5 секунд
Здесь 0.1 — это задержка доступа к таблице на сайте A, а 100,000 — это количество кортежей в таблице Product. Размер каждого кортежа в битах — 200, а скорость передачи данных — 50,000,000. Эти значения (200 и 50,000,000) будут использоваться во всех последующих расчетах.
- Переместить таблицы Store и Sales на сайт B и обработать запрос на B:
T = 0.2 + (10,000 + 1,000,000) × 200 / 50,000,000 = 4.24 секунд
Здесь 0.2 — это задержка доступа к таблицам Store и Sales. Числа 10,000 и 1,000,000 — это количество кортежей в таблицах Store и Sales соответственно.
- Ограничить Brand на сайте B значением Wolf (так называемая выборка) и переместить результат на сайт A:
T = 0.1 + (10 × 200) / 50,000,000 ≈ 0.1 секунд
Здесь 0.1 — это задержка доступа к таблице Product. Число бренда Wolf равно 10, следовательно, количество кортежей также равно 10.
Когда мы сравниваем три подхода, третий подход обеспечивает наименьшую задержку (0.1 секунды). Мы не рассчитывали фильтрацию на сайте A, так как количество строк будет намного больше, и, следовательно, объем данных будет больше, чем в третьем случае (фильтрация на сайте B и затем выборка данных). Этот пример показывает, что тщательная оптимизация запросов также имеет критическое значение в распределенной базе данных.
Заключение
Распределение данных (вертикальное и горизонтальное шардирование) по нескольким узлам направлено на улучшение следующих характеристик, учитывая, что запросы оптимизированы:
- Надежность (устойчивость к отказам)
- Производительность
- Сбалансированная емкость хранения и затраты
Централизованные и распределенные базы данных имеют свои плюсы и минусы. Мы должны выбирать их в зависимости от потребностей нашего приложения.