The Sharded Counters
Why do we need them?
Problem statement
Реальные приложения, такие как Facebook, Twitter и YouTube, испытывают высокий пользовательский трафик. Пользователи взаимодействуют с приложениями и выполняют множество операций (просмотр, лайк, комментарий и так далее) в зависимости от структуры приложения. Например, изображение опубликовано на странице в Facebook, у которой миллионы подписчиков, и количество лайков к посту быстро растет с каждой миллисекундой. В этом случае может быть легко посчитать лайки для одного изображения, но что мы будем делать, когда тысячи таких изображений или видео загружаются одновременно множеством знаменитостей, у каждой из которых миллионы подписчиков? Эта проблема известна как проблема «тяжелых хитов» (heavy hitters problem).
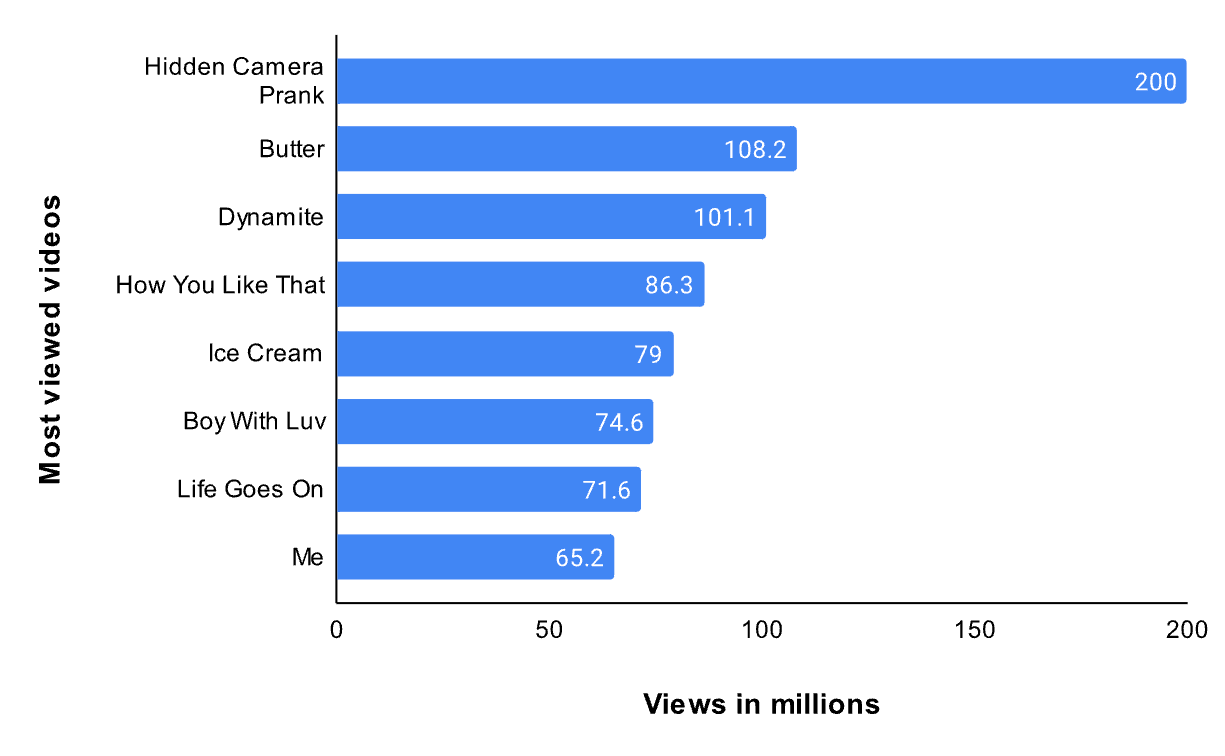
В приведенном выше сценарии показано, как простая операция подсчета становится сложной задачей с точки зрения точности и производительности. Следующая иллюстрация показывает видео на YouTube, которые были просмотрены миллионами пользователей за 24-часовой период в августе 2021 года:
В среднем на Twitter отправляется шесть тысяч твитов в секунду, что равно 360,000 твитов в минуту и около 500 миллионов твитов в день. Сложная задача заключается в обработке миллиардов лайков на эти 500 миллионов твитов в день. В следующей таблице показаны твиты, которые получили наибольшее количество лайков за один день на 2022 год:
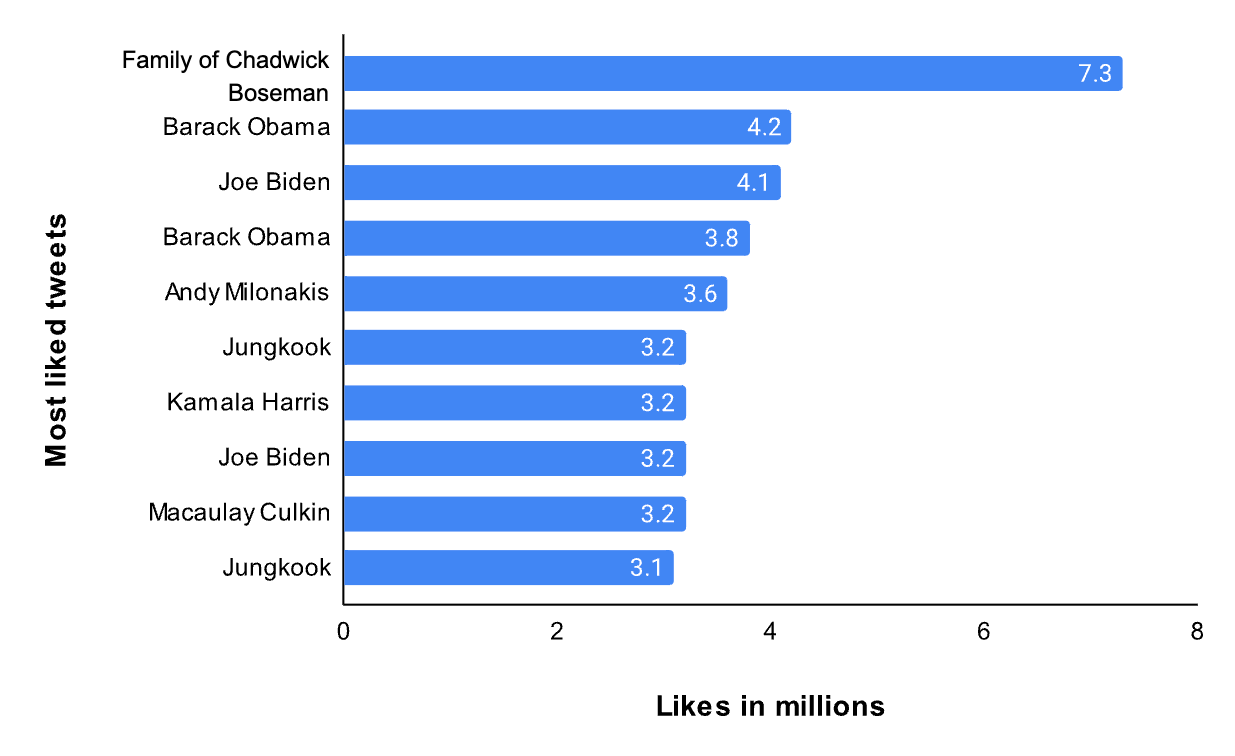
Как мы будем обрабатывать миллионы запросов на запись, поступающих против лайков на тысячи твитов в минуту? Проблема заключается в том, что запись занимает больше времени, чем чтение, и параллельная активность усложняет эту задачу. С увеличением числа параллельных записей для какого-либо счетчика (который может быть переменной, находящейся в памяти узла) конфликт блокировок (lock contention) увеличивается нелинейно. После определенного момента мы можем потратить большую часть времени на получение блокировки, чтобы безопасно обновить счетчик.
Как мы будем проектировать шардированные счетчики?
Мы разделили проектирование шардированных счетчиков на три урока:
- Высокоуровневое проектирование: В этом уроке мы обсудим высокоуровневое проектирование шардированных счетчиков. Кроме того, мы также кратко объясним дизайн API.
- Детализированное проектирование: В этом уроке мы глубоко погрузимся в проектирование шардированных счетчиков. Более того, мы также оценим предложенный дизайн.
- Викторина: Мы рассмотрим основные концепции проектирования шардированных счетчиков с помощью викторины.
Давайте начнем с высокоуровневого решения для шардированных счетчиков.
High-level Design of Sharded Counters
High-level solution sketch
Управление миллионами лайков на твиты требует работы множества счетчиков на множестве узлов. Для управления этими счетчиками нам нужна эффективная система, которая может обеспечивать высокую производительность и масштабируемость по мере роста числа пользователей.
Что произойдет, когда один твит в Twitter наберет миллион лайков, и сервер приложения получит запрос на запись для каждого лайка, чтобы увеличить соответствующий счетчик? Эти миллионы запросов в конечном итоге сериализуются в очередь для обеспечения согласованности данных. Такая сериализация — один из способов справиться с параллельной активностью, хотя и за счет увеличения задержки. Реальные приложения стремятся поддерживать высокое качество пользовательского опыта, минимизируя задержку для конечного пользователя.
Рассмотрим следующую иллюстрацию, чтобы понять эту проблему:
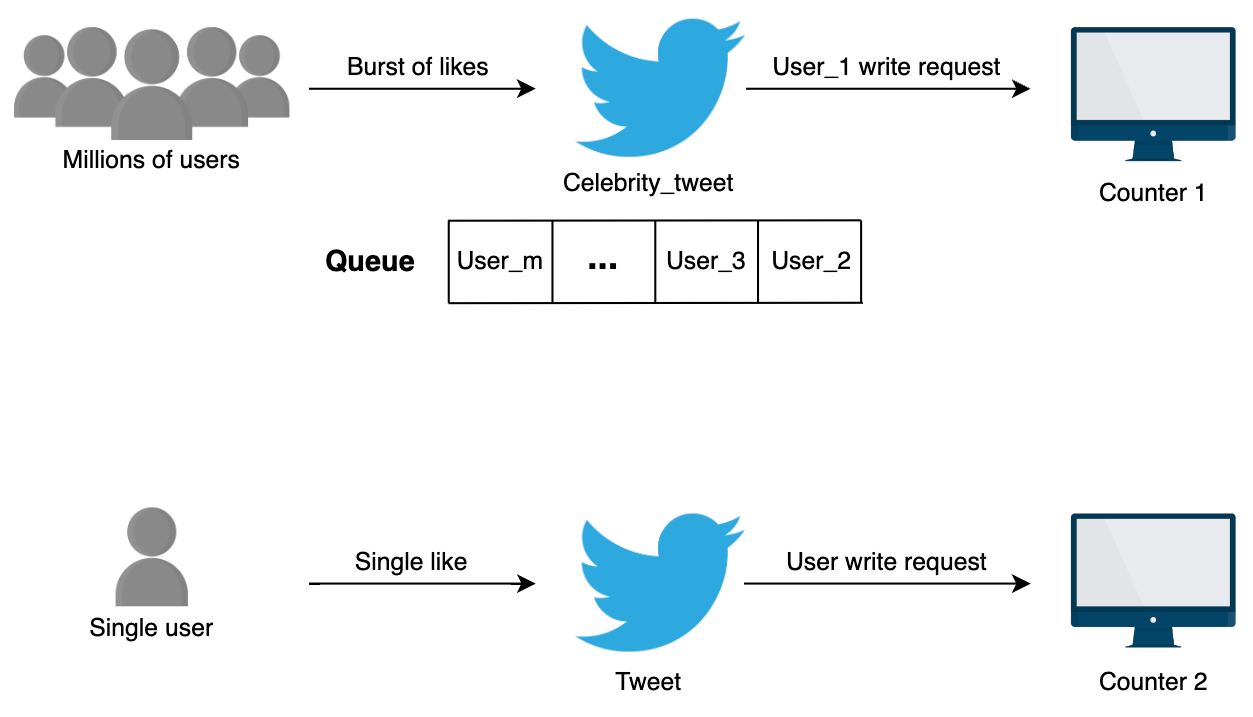
Один счетчик для каждого твита, опубликованного знаменитостью, недостаточен для обработки миллионов пользователей. Решением этой проблемы является шардированный счетчик (sharded counter), также известный как распределенный счетчик (distributed counter), где каждый счетчик имеет определенное количество шардов в зависимости от необходимости. Эти шарды работают на различных вычислительных единицах параллельно. Мы можем улучшить производительность и уменьшить конфликт блокировок (contention), распределяя миллионы запросов на запись по разным шартам.
Сначала запрос на запись пересылается в соответствующий счетчик твита, когда пользователь ставит лайк этому твиту. Затем система выбирает доступный шард соответствующего счетчика твита для увеличения количества лайков. Давайте посмотрим на иллюстрацию ниже, чтобы понять, как работают шардированные счетчики с определенными шарами:
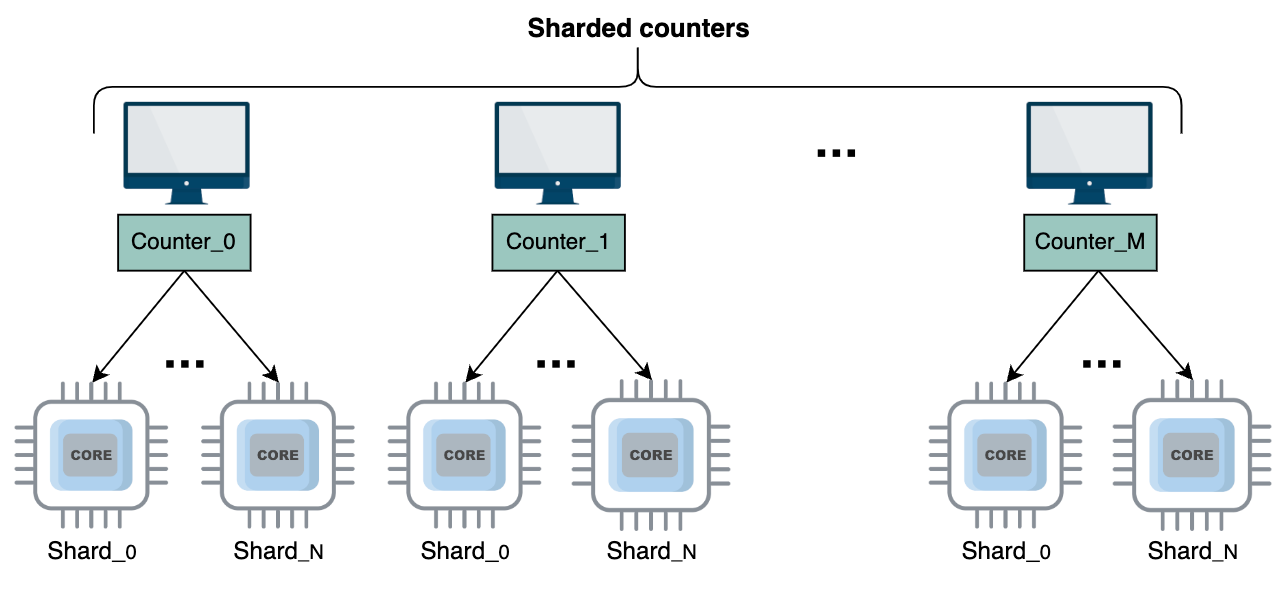 На вышеуказанной иллюстрации общее количество шардов на счетчик равно (N + 1). Мы будем использовать соответствующее значение для (N) в зависимости от наших потребностей. Рассмотрим пример, чтобы понять, как шардированные счетчики обрабатывают миллионы запросов на запись и чтение для одного поста.
Предположим, что известный канал на YouTube с миллионами подписчиков загружает новое видео. Сервер получает всплеск запросов на запись о просмотрах видео от пользователей по всему миру. Сначала создается новый счетчик для нового загруженного видео. Сервер перенаправляет запрос в соответствующий счетчик, и наша система случайным образом выбирает шард и обновляет его значение, которое изначально равно нулю. В отличие от этого, когда сервер получает запросы на чтение, он складывает значения всех шардов счетчика, чтобы получить текущее итоговое значение.
Мы можем использовать шардированные счетчики для любого сценария, где требуется масштабируемый подсчет (например, посты на Facebook и видео на YouTube).
API design for sharded counters
В этом разделе обсуждаются API, которые будут вызываться для работы с шардированными счетчиками. Наш дизайн API поможет нам понять взаимодействие между шардированными счетчиками и их вызовами. Чтобы сделать наше обсуждение конкретным, мы рассмотрим каждую функцию API в контексте Twitter. Давайте разработаем API для каждой из следующих функций:
- Create counter
- Write counter
- Read counter
Хотя приведенный выше список функций API не является исчерпывающим, они представляют собой одни из самых важных.
Create counter
API \createCounter инициализирует распределенный счетчик для использования. Ниже приведен API \createCounter:
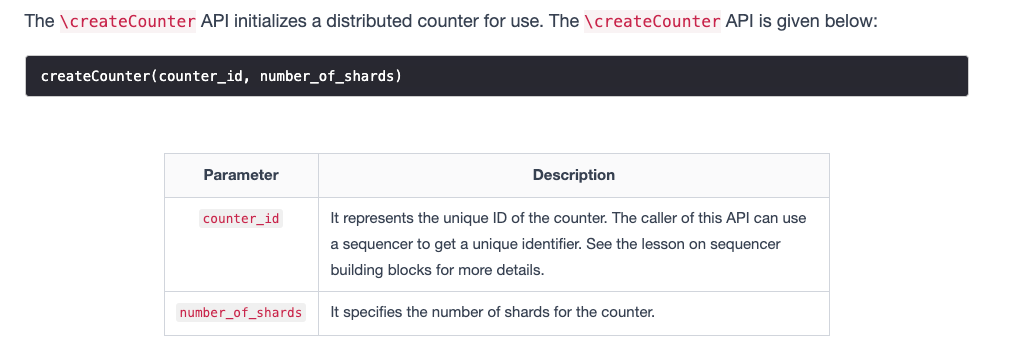
Мы можем использовать соответствующее хранилище данных для хранения наших метаданных, которые включают идентификаторы счетчиков, их количество шардов и сопоставление шардов с физическими машинами.
Рассмотрим Twitter в качестве примера, чтобы понять, как приложение использует указанный выше API. API \createCounter используется, когда пользователь публикует что-то в социальной сети. Например, если пользователь публикует твит в Twitter, сервер приложения вызывает API \createCounter. Параметр content_type — это тип публикации, который система использует для определения количества счетчиков, которые нужно создать. Например, счетчик просмотров требуется только в том случае, если твит содержит видео.
Для нахождения подходящего значения number_of_shards мы можем использовать следующие эвристики:
- Параметр
followers_countобозначает количество подписчиков пользователя, который публикует твит. - Параметр
post_typeуказывает, является ли пост публичным или защищенным. Защищенные твиты предназначены только для подписчиков, и в этом случае у нас есть более точный предсказатель количества шардов.
Write counter
API \writeCounter используется, когда мы хотим увеличить (или уменьшить) счетчик. На самом деле увеличивается или уменьшается конкретный шард счетчика, и наш сервис принимает это решение на основе множества факторов, которые мы обсудим позже. Ниже приведен API \writeCounter:
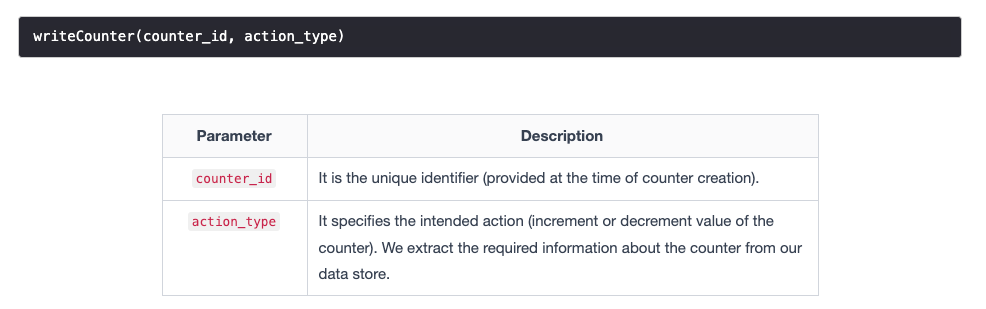
В нашем примере с Twitter API \writeCounter используется, когда пользователи взаимодействуют с постом (например, ставят лайк, отвечают и так далее) — как с чужим, так и со своим.
Read counter
API \readCounter используется, когда мы хотим узнать текущее значение счетчика. Наша система извлекает соответствующую информацию из хранилища данных, чтобы собрать значения со всех шардов. Ниже приведен API \readCounter:
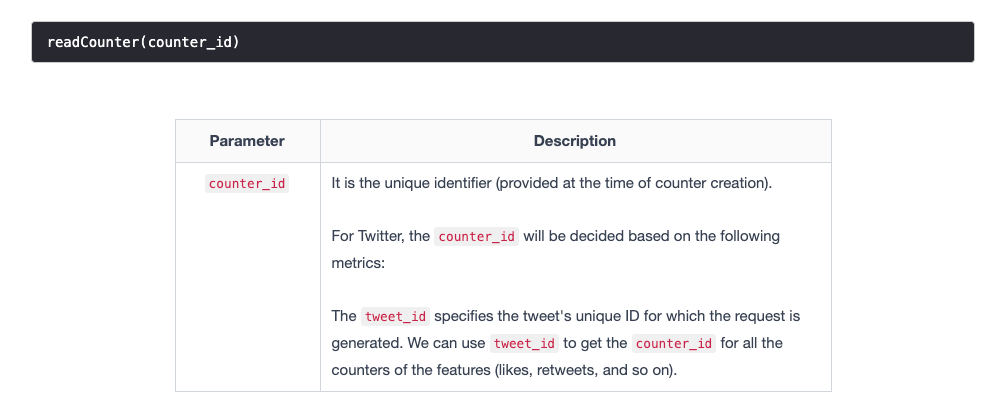
API \readCounter вызывается, когда пользователи хотят увидеть количество лайков или просмотров на определенном твите. Обычно этот API вызывается другим API, когда пользователи хотят увидеть свою домашнюю страницу или ленту пользователя.
Следующий раздел обсудит, что происходит в системе на заднем плане при вызове всех вышеперечисленных API.
Detailed Design of Sharded Counters
Detailed Design
Теперь давайте подробно рассмотрим три основные функции шардированного счетчика — создание, запись и чтение. Мы рассмотрим многие важные вопросы, используя Twitter в качестве примера. Эти вопросы включают:
- Сколько шардов должно быть создано для каждого нового твита?
- Как будет увеличиваться значение шардов для конкретного твита?
- Что произойдет в системе, когда поступят запросы на чтение от конечных пользователей?
Sharded Counter Creation
Как мы уже обсуждали ранее, когда пользователь публикует твит в Twitter, вызывается API \createCounter. Система создает несколько счетчиков для каждого нового поста, созданного пользователем. Вот список основных счетчиков, создаваемых для каждого нового твита:
- Счетчик лайков твита
- Счетчик ответов на твит
- Счетчик ретвитов
- Счетчик просмотров твита, если твит содержит видео
Теперь возникает вопрос: как система определяет количество шардов для каждого счетчика? Количество шардов критически важно для хорошей производительности. Если количество шардов слишком мало для определенной нагрузки на запись, мы сталкиваемся с высокой конкуренцией при записи, что приводит к замедлению операций записи. С другой стороны, если количество шардов слишком велико для конкретного профиля записи, мы сталкиваемся с увеличенными затратами на операцию чтения. Причина более медленного чтения заключается в необходимости сбора значений из разных шардов, которые могут находиться на разных узлах внутри географически распределенных дата-центров. Стоимость чтения значения счетчика возрастает линейно с увеличением числа шардов, так как значения всех шардов соответствующего счетчика складываются. Записи масштабируются линейно по мере добавления новых шардов из-за увеличения числа запросов. Таким образом, существует компромисс между ускорением записи и производительностью чтения. Позже мы обсудим, как можно улучшить производительность чтения.
Решение о количестве шардов зависит от множества факторов, которые вместе пытаются предсказать нагрузку на запись для конкретного счетчика в краткосрочной перспективе. Для твитов эти факторы включают количество подписчиков. Твит пользователя с миллионами подписчиков получает больше шардов, чем твит пользователя с небольшим количеством подписчиков, поскольку существует вероятность, что его твиты наберут много, часто миллионы, лайков. Иногда твит знаменитости включает один или несколько хэштегов. Система также создает шардированный счетчик для этого хэштега, потому что существует высокая вероятность того, что он станет трендом.
Многие человеческие активности часто имеют «длиннохвостовой» паттерн активности, где многие люди концентрируются на относительно небольшом наборе действий. Возможно, здесь играет роль сокращение продолжительности внимания. Это означает, что через некоторое время поток лайков снизится, и нам может не понадобиться столько шардов для счетчика, сколько было нужно раньше. Аналогично, наше первоначальное предсказание будущих записей может оказаться неверным, и нам может понадобиться больше шардов для обработки запросов на запись. Мы требуем, чтобы наша система могла динамически расширять или сокращать количество шардов в зависимости от текущих нужд.
Мы должны мониторить нагрузку на запись для всех шардов, чтобы правильно направлять запросы к конкретным шарам, возможно, используя балансировщики нагрузки. Такой механизм обратной связи также может помочь нам решить, когда следует закрыть некоторые шарды для счетчика и когда добавить дополнительные шарды. Этот процесс не только обеспечивает хорошую производительность для конечного пользователя, но и позволяет оптимально использовать ресурсы.
What happens when a user with just a few followers has a post go viral on Twitter?
Details
The system needs to detect such cases where a counter unexpectedly starts getting very high write traffic. We’ll dynamically increase the number of shards of the affected counter to mitigate the situation.
Burst of Write Requests
Как мы упоминали ранее, миллионы пользователей взаимодействуют с твитом знаменитости, что в конечном итоге посылает бурю запросов на запись в систему. Система назначает каждый запрос на запись доступным шартам соответствующего счетчика конкретного твита. Как система выбирает эти шарды, работающие на разных вычислительных узлах (нодах), чтобы назначить запросы на запись? Мы можем использовать три подхода для этого:
Round-robin Selection
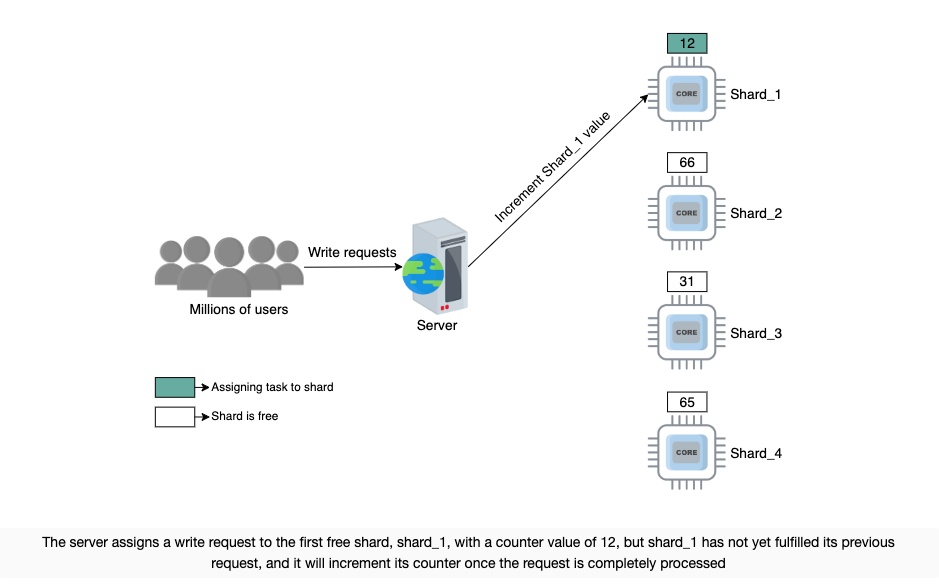
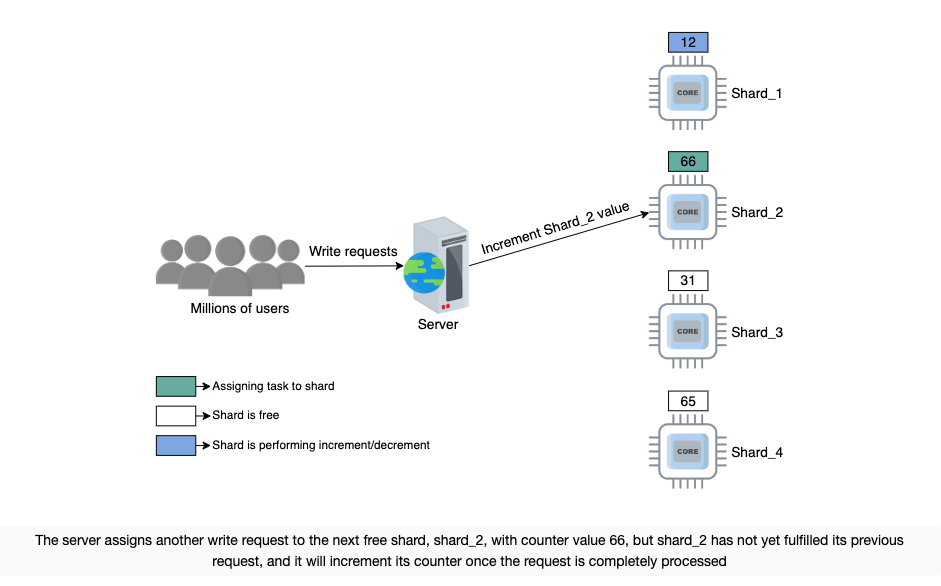
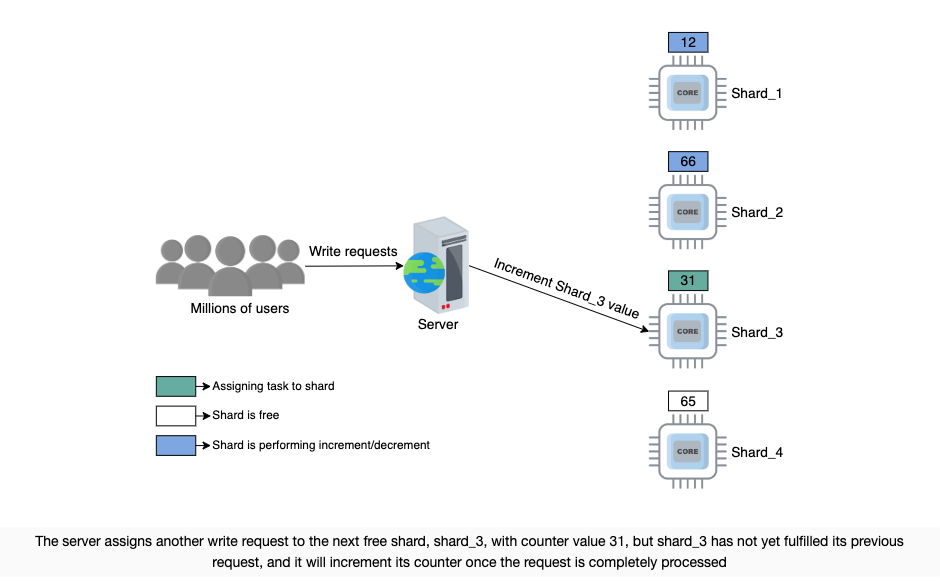
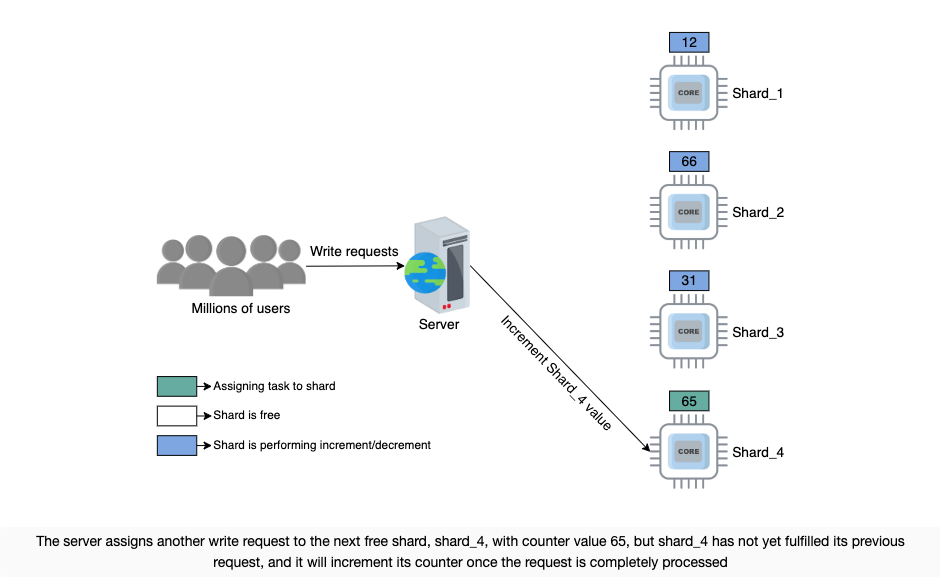
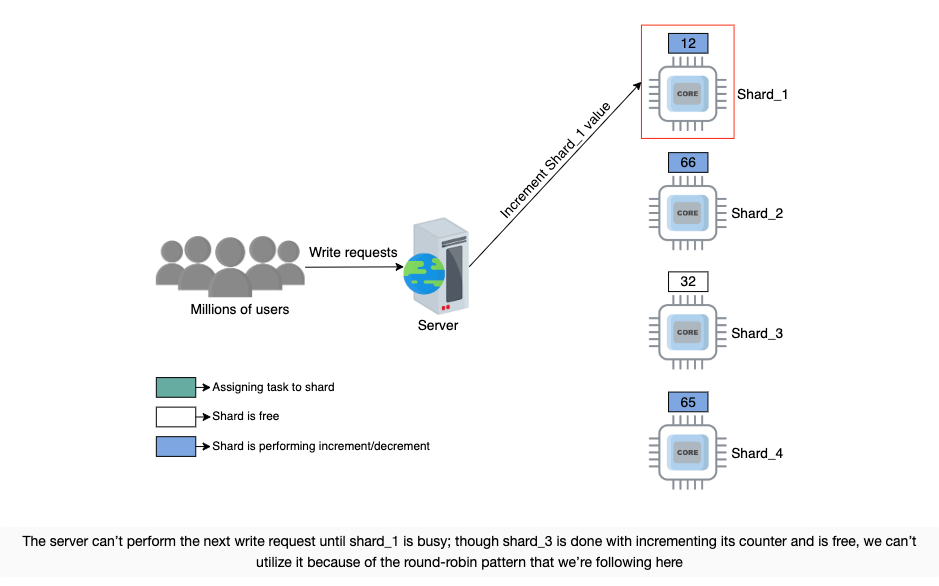
Один из способов решения этой проблемы — использовать круговой выбор шардов (round-robin selection). Например, допустим, количество шардов равно 100. Система начинает с shard_1, затем shard_2 и так далее, пока не достигнет shard_100. Обычно распределение задач по круговому алгоритму приводит к перегрузке или недоиспользованию ресурсов, так как планирование выполняется без учета текущей нагрузки. Однако, если каждый запрос аналогичен (и требует примерно одинакового времени на обслуживание), подход с круговым распределением может использоваться и привлекателен своей простотой.
Следующая иллюстрация показывает выбор шардов с использованием техники round-robin. Мы предполагаем, что запросы пользователей сначала передаются на соответствующий сервер через балансировщик нагрузки. Затем каждый такой сервер использует свое собственное круговое планирование для использования шарда. Мы показали один сервер для простоты, но сервер шарда может получать запросы от многих серверов одновременно и может быть перегружен, что вызывает задержки для запросов этого сервера, как показано на следующей иллюстрации.
Random Selection
Другой простой подход может заключаться в равномерном и случайном выборе шарда для записи. Проблема как с круговым выбором, так и со случайным выбором заключается в изменении нагрузки на узлы (где размещены шарды). Сложно правильно распределить нагрузку на доступные шарды. Изменчивость нагрузки на узлах — это обычное явление, поскольку физический узел часто используется для нескольких целей.
Metrics-based Selection
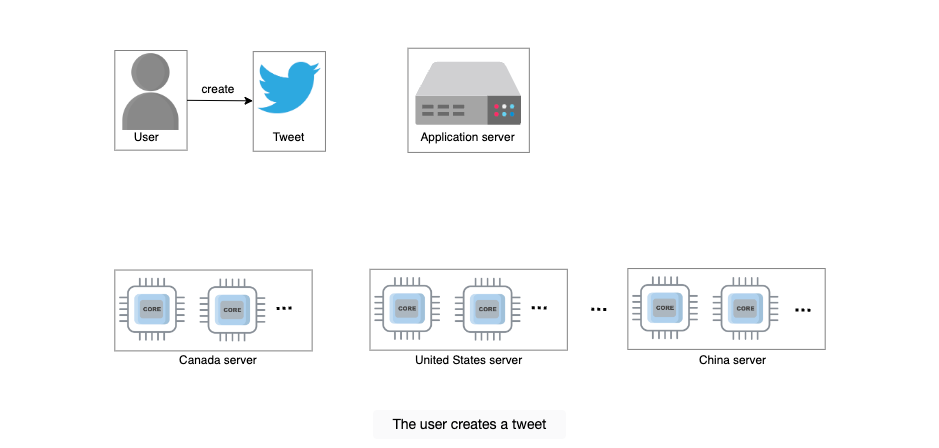
Третий подход — выбор шарда на основе определенных метрик. Например, выделенный узел (балансировщик нагрузки) управляет выбором шардов, считывая статус шардов. Следующая иллюстрация показывает, как создаются шардированные счетчики:
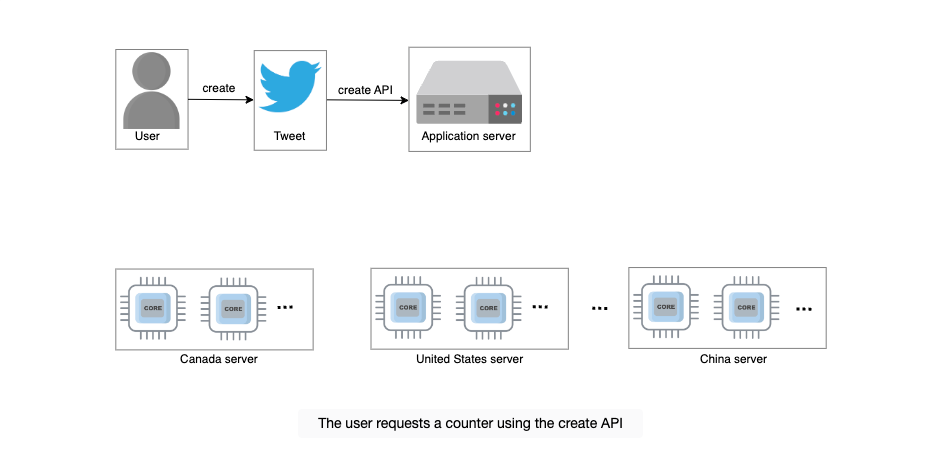
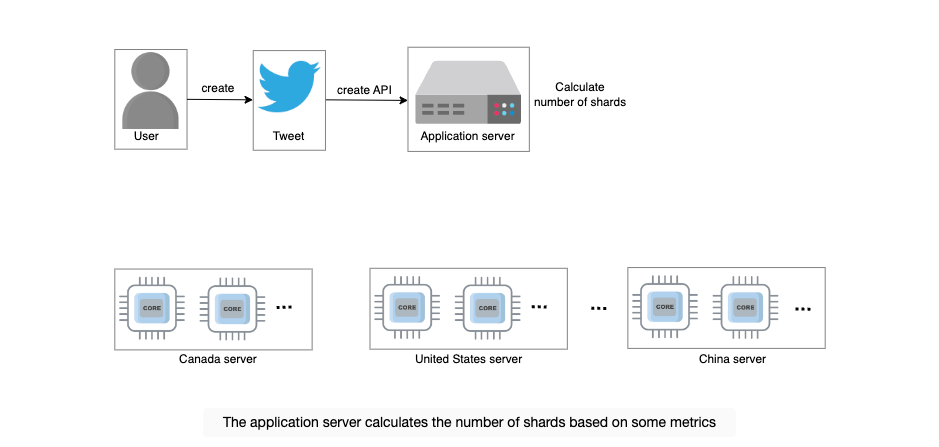
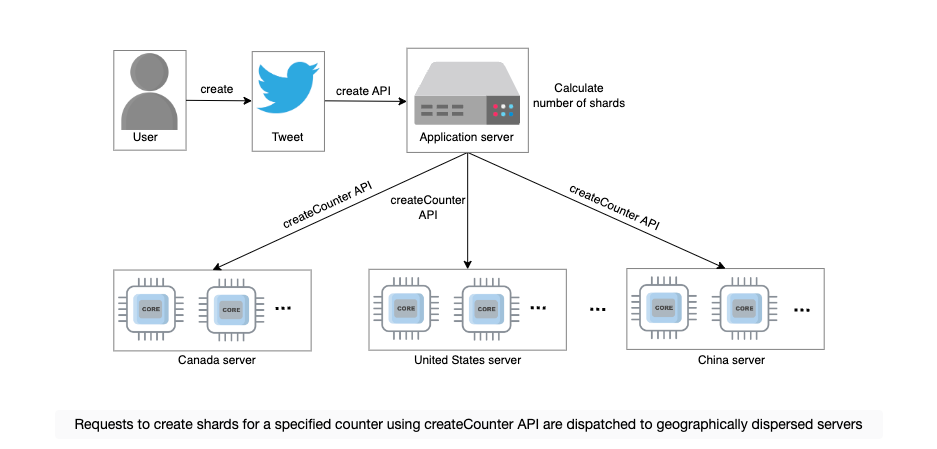
Manage Read Requests
Когда пользователь отправляет запрос на чтение, система агрегирует значение всех шардов указанного счетчика, чтобы вернуть общее количество (например, лайков или ответов). Суммирование значений всех шардов при каждом запросе на чтение приведет к низкой пропускной способности чтения и высокой задержке чтения.
Решение о том, когда система будет суммировать значения всех шардов, также очень критично. Если есть высокая нагрузка на запись наряду с запросами на чтение, то может оказаться практически невозможно получить реальное текущее значение, потому что к тому времени, когда мы сообщаем значение чтения клиенту, оно уже изменится. Поэтому периодическое чтение всех шардов счетчика и кэширование результатов должно удовлетворять большинству случаев использования. Уменьшая период накопления, мы можем увеличить точность значений при чтении.
Can you think of a use case where sharded counters with the above-mentioned consistency model might not be suitable?
Details
We might not use shared counters with a relaxed consistency model where we need strong consistency. An example can be read-then-write scenarios where we first need to get the accurate value of something before deciding to modify it (actually, such a scenario will need transaction support).
Using Sharded Counters for the Top K Problem
В этом разделе мы обсудим, как мы можем использовать шардированные счетчики для решения реальной проблемы, известной как «Top K проблема». Мы продолжим использовать Twitter в качестве примера, где вычисление трендов является одной из задач Top K для Twitter. Здесь (K) обозначает количество лучших трендов. Многие пользователи используют различные хэштеги в своих твитах. Управление подсчетом миллионов хэштегов для их отображения в лентах трендов пользователей в зависимости от их местоположения — огромная задача.
Шардированный счетчик является ключом к решению этой проблемы. Как обсуждалось ранее, в Twitter система создает счетчики для каждого хэштега и определяет количество шардов в зависимости от количества подписчиков пользователя, использовавшего хэштег в твите. Когда пользователи Twitter снова используют тот же хэштег в своем твите, счетчик поддерживает тот же счетчик, созданный при первом использовании этого хэштега.
Twitter показывает тренды, главным образом, на основе популярности конкретного хэштега в регионе пользователя. Twitter будет поддерживать отдельный счетчик для каждого из обсуждаемых показателей вместе с глобальным счетчиком хэштега. Давайте обсудим каждый из этих показателей ниже:
- Региональный подсчет хэштегов указывает количество твитов с одним и тем же хэштегом, использованным в определенном географическом регионе. Например, тысячи твитов с одинаковыми тегами из Нью-Йорка предполагают, что пользователи из Нью-Йорка могут видеть этот хэштег в своей ленте трендов.
- Оконное время указывает время, в течение которого были опубликованы твиты с определенными тегами.
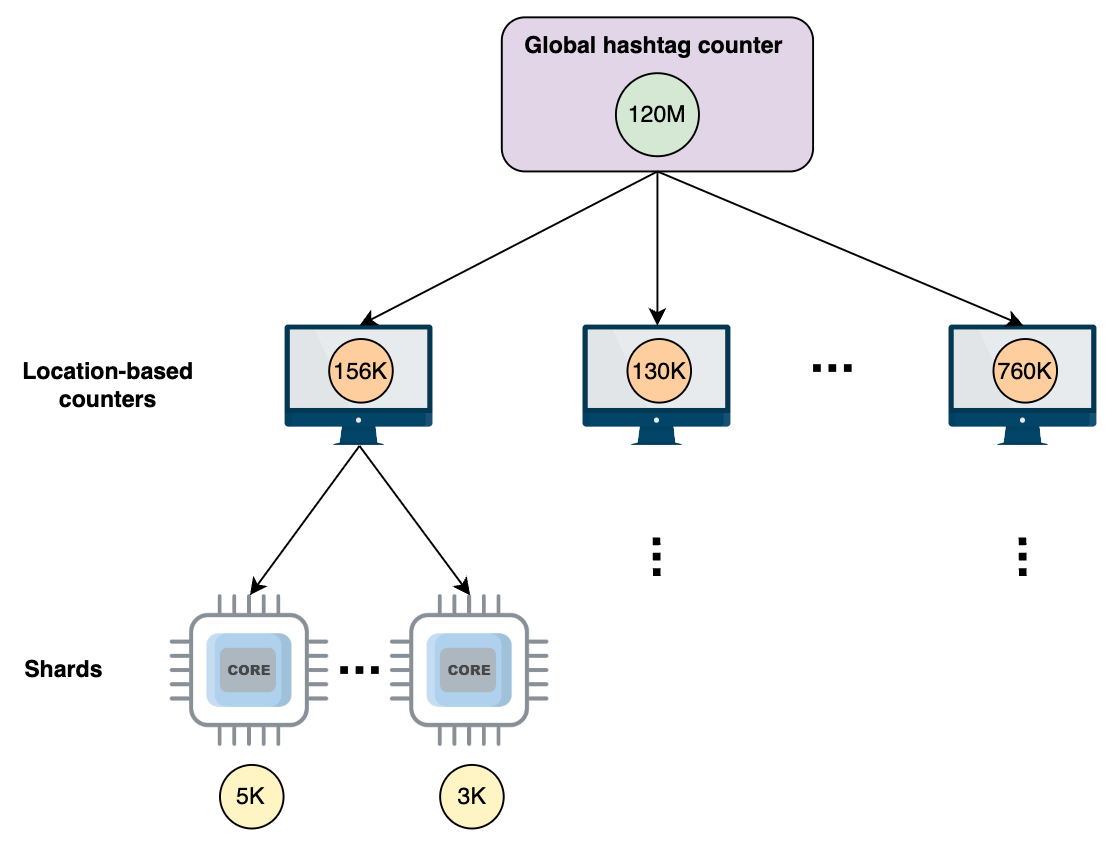
Ниже приведена дополнительная информация о вышеуказанной иллюстрации:
- Глобальный счетчик хэштега представляет собой сумму всех региональных счетчиков.
- Региональные счетчики показывают их текущее значение, когда система достигает установленного порога за определенное время, и хэштег становится трендом для некоторых пользователей. Например, Twitter устанавливает пороговое значение в 10,000. Когда региональные счетчики хэштегов достигают 10,000, Twitter показывает эти хэштеги в ленте трендов пользователей соответствующей страны, где используется этот хэштег. Указанный хэштег может отображаться по всему миру, если подсчеты увеличиваются во всех странах.
Далее мы обсудим Top K твитов в домашней ленте пользователя. Top K твиты включают аккаунты, на которые подписан пользователь, твиты, которые он лайкнул, и ретвиты аккаунтов, на которые он подписан. Твиты получают приоритет в задачах Top K на основе количества подписчиков и времени. Twitter также показывает рекламные твиты и некоторые твиты от аккаунтов, на которые пользователь не подписан, в домашней ленте пользователя в зависимости от популярности твита и местоположения.
Примечание: Twitter также использует другие метрики для оптимизации выбора Top K, но здесь мы обсудили основные метрики.
Placement of Sharded Counters
Важным вопросом является то, где следует размещать шардированные счетчики. Должны ли они находиться на тех же узлах, что и серверы приложений, на отдельных узлах в дата-центре или на узлах CDN на краю сети рядом с конечными пользователями? Точный ответ на этот вопрос зависит от конкретного использования. Для Twitter мы можем вычислять подсчеты, размещая шардированные счетчики рядом с пользователем, что также помогает эффективно решать проблемы heavy hitter и Top K.
Should we lock all shards of a counter before accumulating their values?
Details
No. Reads can happen concurrently with writes without the need for an across-shards lock. This lock will decimate the write performance, the original reason we used sharded counters. Under a relaxed consistency model, where the value of a counter might not reflect the exact current value, there is no need for simultaneous read locks across all shards.
However, depending on the specific use case, such a mechanism might be used when reads frequency is very low.
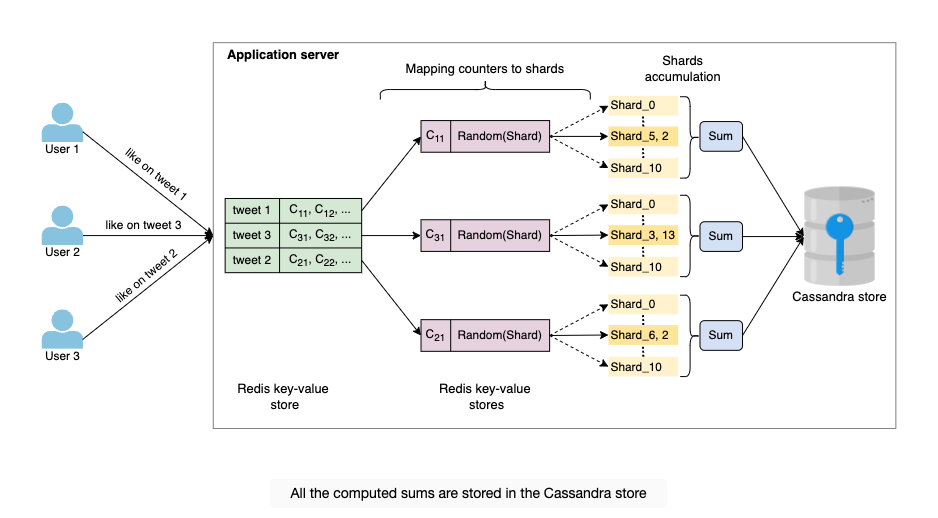
Чтения могут сохранять значения счетчиков в соответствующих хранилищах данных и полагаться на эти хранилища для масштабируемости чтения. Хранилище Cassandra можно использовать для поддержания количества просмотров, лайков, комментариев и многих других показателей пользователей в указанном регионе. Эти подсчеты представляют собой последний вычисленный итог всех шардов определенного счетчика.
Когда пользователи создают ленту, запросы на чтение направляются на ближайшие серверы, и затем для ответа можно использовать сохраненные значения в хранилище. Это хранилище также помогает показать региональные Top K тренды. Список локальных трендов Top K отправляется на сервер приложения, и затем сервер приложения сортирует все списки, чтобы составить список глобальных Top K трендов. В конечном итоге сервер приложения отправляет все детали счетчиков в кэш.
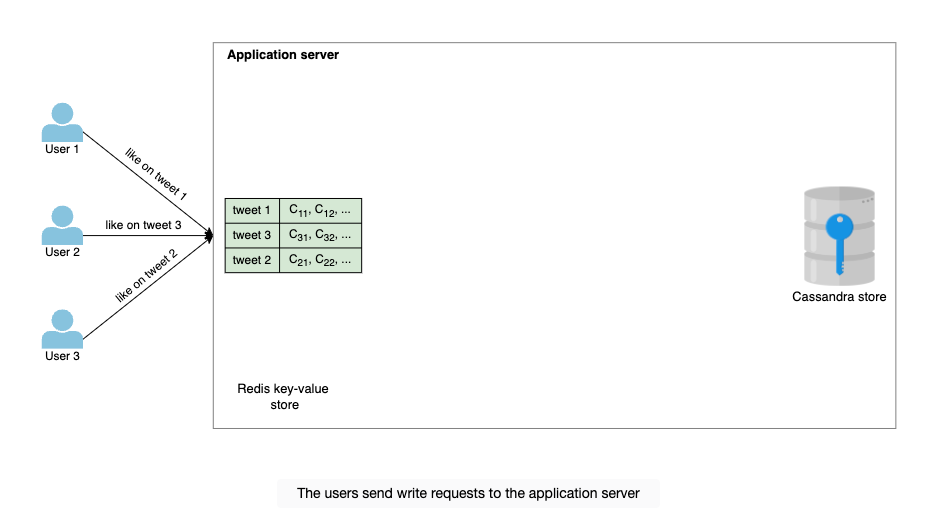
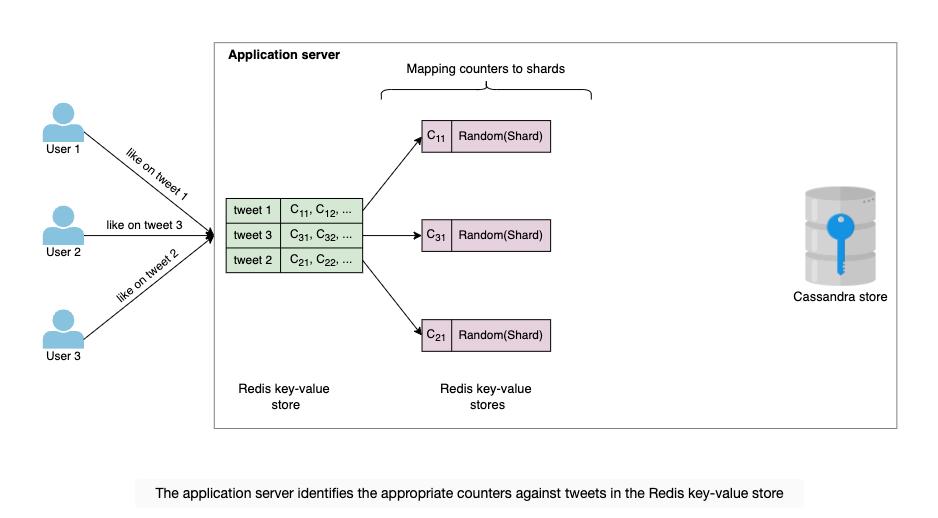
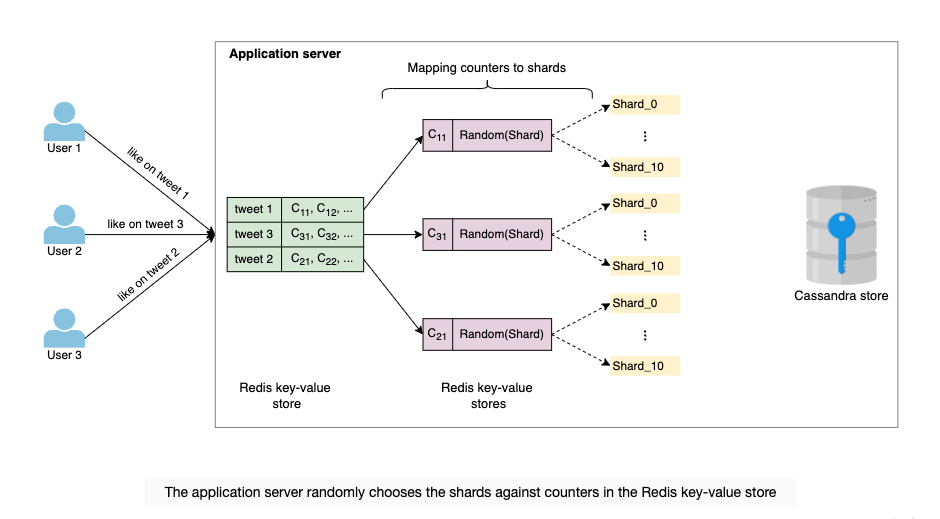
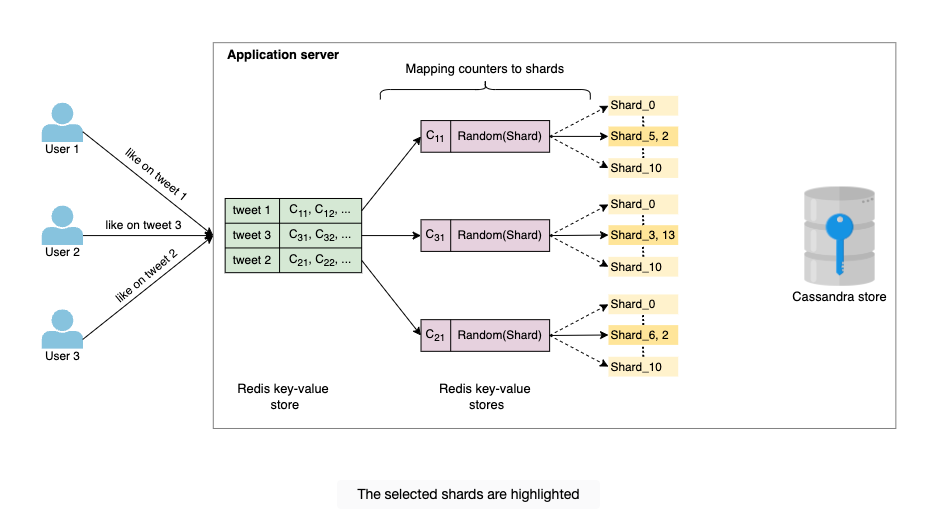
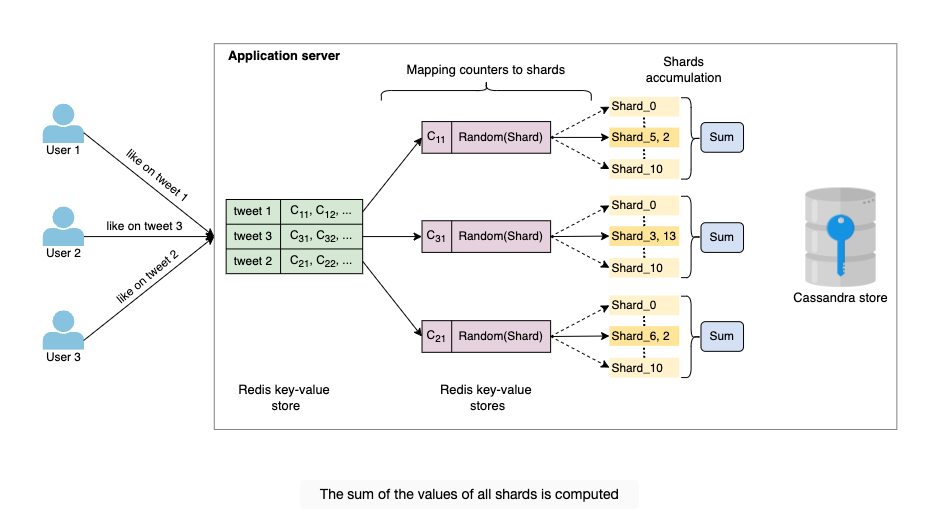
Также нам нужно хранилище для шардированных счетчиков, которое сохраняет всю информацию о них вместе с их метаданными. Здесь могут сыграть важную роль серверы Redis или Memcache. Например, уникальный идентификатор каждого твита может стать ключом, а значение этого ключа может быть идентификатором счетчика или списком идентификаторов счетчиков (например, счетчик лайков, счетчик ответов и так далее). Кроме того, у каждого идентификатора счетчика есть собственное хранилище ключ-значение, где идентификатор счетчика (например, счетчик лайков) является ключом, а значение — списком назначенных шардов.
Задача идентификации соответствующего счетчика и сопоставления всех запросов на запись с соответствующим счетчиком в шардированных счетчиках может выполняться параллельно. Мы сопоставляем все запросы на запись с соответствующим счетчиком, и затем каждый счетчик случайным образом выбирает шард на основе некоторых метрик для выполнения увеличений и уменьшений. В отличие от этого, мы периодически уменьшаем количество шардов для агрегации значения всех шардов определенного счетчика. Затем эти значения счетчиков могут храниться в хранилище Cassandra. Следующая иллюстрация помогает проиллюстрировать эти моменты:
Evaluation of the Sharded Counters
В этом разделе мы оценим шардированные счетчики и объясним, как шардированные счетчики повышают производительность, обеспечивая высокую доступность и масштабируемость.
Availability
Единичный счетчик для любой функции (например, лайка, просмотра или ответа) имеет высокий риск единой точки отказа. Шардированные счетчики устраняют единую точку отказа, запуская множество шардов для определенного счетчика. Система остается доступной, даже если некоторые шарды выходят из строя или сталкиваются с неисправностью. Таким образом, шардированные счетчики обеспечивают высокую доступность.
Scalability
Шардированные счетчики позволяют достигать высокой горизонтальной масштабируемости по мере необходимости. Шарды, работающие на дополнительных узлах, могут быть легко добавлены в систему для увеличения наших операционных мощностей. В конечном итоге эти дополнительные шарды также увеличивают производительность системы.
Reliability
Еще одной основной целью шардированных счетчиков является снижение нагрузки на систему записи за счет сопоставления каждого запроса на запись с конкретным шардом. Каждый запрос на запись обрабатывается по мере поступления, и запросов, ожидающих в очереди, нет. Благодаря этому повышается частота попаданий и надежность системы. Более того, система периодически сохраняет вычисленные значения в стабильное хранилище — в данном случае Cassandra.
Conclusion
Сегодня шардированные счетчики играют ключевую роль в улучшении общей производительности крупных сервисов. Они обеспечивают высокую масштабируемость, доступность и надежность. Шардированные счетчики решили значительные проблемы, включая задачи heavy hitter и Top K, которые очень распространены в масштабных приложениях.