Back-of-the-Envelope Calculations (BOTECs)
Основная идея Back-of-the-Envelope Calculations (BOTECs)
Back-of-the-envelope calculations (BOTECs) — это быстрые, приблизительные и упрощенные оценки или вычисления, которые обычно выполняются на бумаге или, фигурально выражаясь, "на обратной стороне конверта". Эти расчеты не предназначены для получения точных результатов, но служат для быстрой и предварительной оценки ключевых параметров и осуществимости системы.
BOTECs в системном дизайне
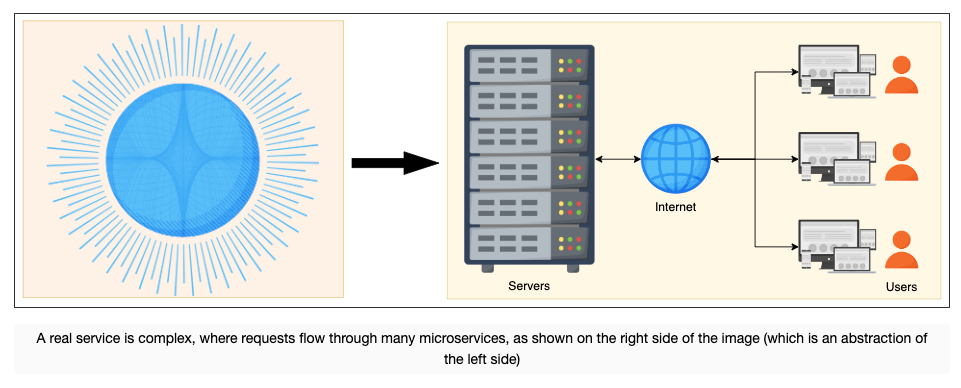
Современная система представляет собой сложную сеть вычислительных ресурсов, соединенных через сеть. В системе могут быть разные типы узлов, такие как load balancers, web servers, application servers, caches, in-memory databases и storage nodes, которые совместно обслуживают клиентов. Такая система может быть спроектирована по-разному, включая monolithic architecture, modular monolith architecture или microservices architecture.
В процессе проектирования (особенно на интервью) не всегда целесообразно или возможно учитывать все детали и сложности системы. BOTECs помогают нам игнорировать эти детали и сосредоточиться на более важных аспектах, таких как оценка осуществимости сервиса с точки зрения вычислительных ресурсов.
Примеры, где часто используются BOTECs:
- Оценка количества одновременных TCP-соединений, которые может поддерживать сервер.
- Оценка количества запросов в секунду (RPS), которые могут обрабатывать web, database или cache servers.
- Оценка требований к хранилищу для сервиса.
Используя BOTECs, мы абстрагируемся от сложных деталей, таких как различия в типах серверов, задержки доступа, пропускная способность компонентов системы и различные типы запросов. Затем, абстрагируясь от этих деталей, мы учимся оценивать количество RPS, которое сервер может обработать, а также делаем примеры оценки пропускной способности, серверов и хранилища.
Типы серверов в дата-центре
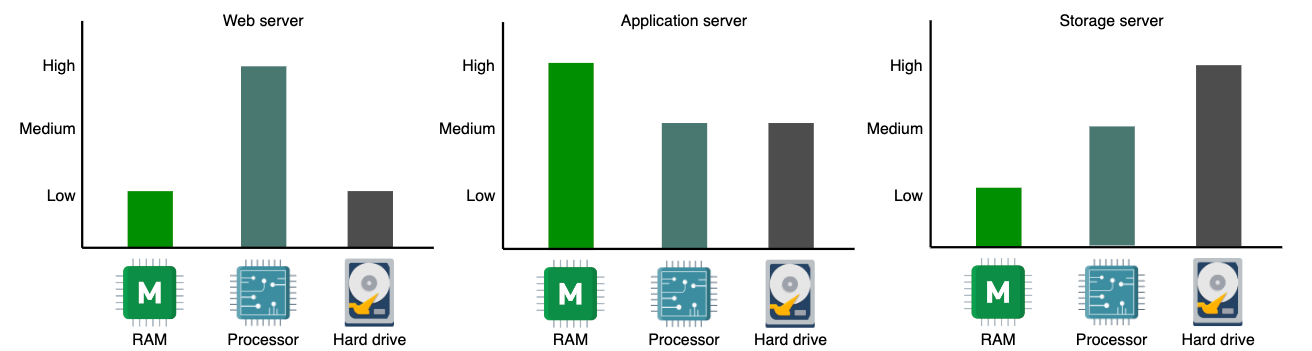 Дата-центры не ограничиваются одним типом серверов. Корпоративные решения используют стандартное оборудование (commodity hardware) для снижения затрат и создания масштабируемых решений. Ниже мы обсудим типы серверов, которые часто используются в дата-центре для обработки различных типов нагрузок.
Web servers (Веб-серверы)
Для обеспечения масштабируемости веб-серверы отделены от серверов приложений (application servers). Веб-серверы являются первой точкой контакта после балансировщиков нагрузки (load balancers). В дата-центрах есть стойки, заполненные веб-серверами, которые обычно обрабатывают API-запросы от клиентов. В зависимости от предоставляемой услуги, память и хранилище на веб-серверах могут быть от небольших до средних по размеру. Однако такие серверы требуют хороших вычислительных ресурсов. Например, Facebook использовал веб-серверы с 32 ГБ оперативной памяти и 500 ГБ места для хранения.
Application servers (Серверы приложений)
Серверы приложений запускают основное программное обеспечение и бизнес-логику. Различие между веб-серверами и серверами приложений несколько размыто. Серверы приложений в основном предоставляют динамический контент, тогда как веб-серверы в основном обслуживают статический контент клиенту. Серверы приложений могут требовать значительных вычислительных и хранилищных ресурсов. Хранилище может быть как оперативным, так и постоянным. Facebook использовал серверы приложений с оперативной памятью до 256 ГБ и двумя типами хранилищ — традиционные вращающиеся диски и флеш-накопители — с ёмкостью до 6,5 ТБ.
Storage servers (Серверы хранения)
С ростом числа пользователей Интернета объем данных, хранимых крупными сервисами, многократно увеличился. Кроме того, различные типы данных теперь хранятся в различных хранилищах. Например, YouTube использует следующие хранилища данных:
- Blob storage: Используется для хранения закодированных видео.
- Temporary processing queue storage: Хранит несколько сотен часов видео, загружаемого на YouTube каждый день для обработки.
- Bigtable: Специализированное хранилище для хранения большого количества миниатюр видео.
- Relational database management system (RDBMS): Хранит метаданные пользователей и видео (комментарии, лайки, каналы пользователей и т.д.).
Другие хранилища данных, такие как Hadoop HDFS, используются для аналитики. Серверы хранения в основном включают в себя системы управления данными как структурированными (например, SQL), так и неструктурированными (NoSQL).
Возвращаясь к примеру Facebook: они использовали серверы с ёмкостью до 120 ТБ. С учётом количества используемых серверов Facebook способен хранить эксабайты данных (один эксабайт — это (10^18) байт). При этом оперативная память этих серверов составляет всего 32 ГБ.
Важно помнить
Для того чтобы планировать и реализовывать сервисы, необходимо иметь базовые знания о том, какие нагрузки могут обрабатывать машины. Задержки (latencies) играют важную роль в определении объема нагрузки, которую может обработать машина. В таблице ниже показаны важные числа, которые системные архитекторы должны знать для оценки ресурсов.
Важные задержки (Important Latencies)
| Компонент | Время (наносекунды) | Категория |
|---|---|---|
| Ссылка на кэш L1 | 0.9 | CPU-bound |
| Ссылка на кэш L2 | 2.8 | CPU-bound |
| Ссылка на кэш L3 | 12.9 | CPU-bound |
| Ссылка на основную память | 100 | Memory-bound |
| Сжатие 1 КБ с помощью Snzip | 3,000 (3 микросекунды) | CPU-bound |
| Чтение 1 МБ последовательно из памяти | 9,000 (9 микросекунд) | Memory-bound |
| Чтение 1 МБ последовательно из SSD | 200,000 (200 микросекунд) | IO-bound |
| Round trip в том же дата-центре | 500,000 (500 микросекунд) | IO-bound |
| Чтение 1 МБ последовательно из SSD с скоростью ~1ГБ/сек SSD | 1,000,000 (1 миллисекунда) | IO-bound |
| Поиск диска | 4,000,000 (4 миллисекунды) | IO-bound |
| Чтение 1 МБ последовательно с диска | 2,000,000 (2 миллисекунды) | IO-bound |
| Отправка пакета SF->NYC | 71,000,000 (71 миллисекунда) | IO-bound |
Важно помнить, что разница в порядке величин между различными компонентами и операциями важнее, чем запоминание точных чисел. Например, важно знать, что выполнение операций, связанных с вводом-выводом (например, чтение 1 МБ данных последовательно с SSD-диска), на два порядка медленнее, чем операции, зависящие от процессора (например, сжатие 1 КБ данных с помощью snzip). Вы можете задаться вопросом, почему в этом сравнении используются разные размеры данных!
Пока данные для сжатия доступны процессору из кэшей L1, L2 или L3, время на сжатие будет относительно постоянным. Данные размером до L3-кэша сервера (который обычно составляет несколько мегабайт — около 45 МБ для типичного сервера, как упоминалось выше) полностью помещаются в кэш, и поэтому сжатие данных до этого предела займет почти одинаковое время. Это происходит потому, что процессор может быстро получить доступ к данным из кэша без дополнительных задержек, связанных с извлечением данных из более медленных уровней памяти или хранилища.
Помимо перечисленных выше задержек, числа пропускной способности измеряются как количество запросов в секунду (QPS), которые может обработать типичный односерверный хранилище данных.
Важные скорости (Important Rates)
| Количество запросов в секунду (QPS) | Описание |
|---|---|
| 1000 | Обрабатывает MySQL |
| 10,000 | Обрабатывает key-value store |
| 100,000–1 M | Обрабатывает cache server |
Эти числа являются приблизительными и могут значительно варьироваться в зависимости от множества факторов, таких как тип запроса, спецификация машины, дизайн базы данных, индексация, нагрузка на сервер и т.д.
Примечание: Для реальных проектов начальные этапы проектирования используют BOTECs, аналогичные тем, которые применяются на интервью по системному дизайну. По мере того как дизайн проходит итерации для создания реальных продуктов, мы можем использовать справочные числа, полученные из синтетических нагрузок, которые соответствуют нашим запросам (например, spec int для характеристики процессоров и TPC-C для измерения транзакций баз данных за единицу времени). Начальные прототипы используются для проверки предположений на уровне дизайна. Позже встроенный мониторинг ресурсов и нагрузки тщательно анализируется, чтобы выявить узкие места и планировать будущие потребности в мощностях.
Типы клиентских запросов и их классификация
В следующем разделе мы увидим, что при оценке количества запросов, которые сервер может обработать, мы не вникаем в детали того, какого типа эти запросы. Однако на практике все запросы не одинаковы. Нагрузки (запросы клиентов) можно разделить на три основные категории: CPU-bound, memory-bound и IO-bound.
CPU-bound запросы
Эти запросы в первую очередь зависят от процессора узла. Примером CPU-bound запроса является сжатие 1 КБ данных с помощью snzip. В таблице выше указано, что эта операция занимает 3 микросекунды.
Memory-bound запросы
Эти запросы ограничены подсистемой оперативной памяти. Примером является последовательное чтение 1 МБ данных из оперативной памяти узла. Эта операция занимает 9 микросекунд (в три раза медленнее, чем CPU-bound операция).
IO-bound запросы
Эти запросы в основном ограничены подсистемой ввода-вывода (например, дисками или сетью). Примером является последовательное чтение 1 МБ данных с диска. Эта операция занимает 200 микросекунд (на 66 раз медленнее, чем CPU-bound операции).
Упрощение расчетов
Подобно BOTECs, мы можем утверждать, что если выполнение CPU-bound запроса занимает X единиц времени на узле, то для memory-bound запросов требуется на порядок больше времени (10X), а для IO-bound запросов — на два порядка больше времени (100X). Такие упрощения позволяют облегчить дальнейшие вычисления.
Абстрагирование от сложностей реальных систем
Мы рассмотрели сложности, присущие реальным системам. Вы могли заметить, что учитывать все эти сложности на уровне проектирования, особенно в ограниченные временные рамки (например, на собеседовании), непрактично.
BOTECs являются ценным инструментом для выполнения быстрых, высокоуровневых оценок и принятия решений на ранних этапах проектирования системы или когда требуется быстрая оценка.
Оценка количества запросов в системном дизайне
Этот раздел посвящен оценке количества запросов, которые типичный сервер может обработать за секунду. Реальный запрос может пройти через множество узлов в дата-центре для различных видов обработки перед тем, как будет отправлен ответ клиенту, и мы будем учитывать всю эту работу для наших оценок.
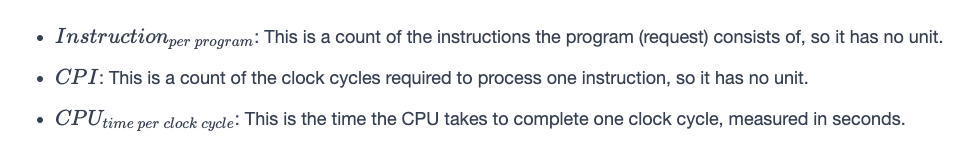
Следующее уравнение рассчитывает время на выполнение программы (запроса) процессором. Для простоты мы предполагаем, что каждая инструкция может быть выполнена за один такт; таким образом, CPI (clock cycles per instruction) равно 1. Допустим, средняя тактовая частота процессора наших серверов составляет 3.5 GHz (3,500,000,000 тактов в секунду). Предположим также, что для полного выполнения одного запроса требуется несколько миллионов инструкций. Для простоты предположим, что в среднем каждый запрос требует 3.5 миллиона инструкций.

Пример расчетов
Мы установили, что каждая инструкция выполняется за один такт (CPI = 1), и процессор работает на частоте 3.5 GHz. Сначала найдем время на один такт:
Теперь, подставив это значение в формулу вместе с 3.5 миллионами инструкций, получаем:
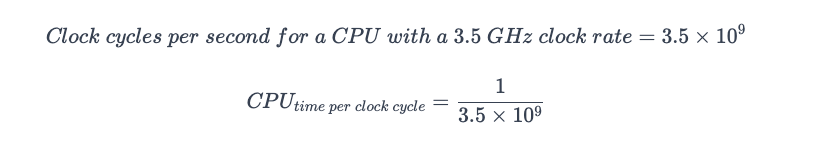
Таким образом, процессор выполняет один запрос за 1 миллисекунду. А если у нас сервер с 64 ядрами:
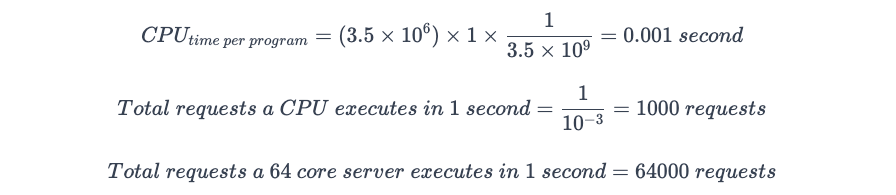
Этот расчет показывает, что сервер с 64 ядрами может обрабатывать примерно 64,000 запросов в секунду. Обратите внимание, что изменение предположений (например, количество инструкций в запросе) изменит окончательные результаты. Однако такие оценки, основанные на BOTECs, предоставляют разумные и быстрые результаты.
Основная идея
BOTECs — это ценный инструмент для быстрого создания высокоуровневых оценок и принятия решений на ранних этапах проектирования системы или когда требуется быстрая оценка. Они позволяют избегать сложностей, связанных с реальными системами, и фокусироваться на ключевых аспектах для оценки ресурсов.
Tasks
With reference to the throughput numbers given above, what will be your reply if an interviewer says that they think that for a MySQL database, the average count of queries per second handled is 2000?
With reference to the table above, why does a key-value store serve an order of magnitude more queries per second as compared to a MySQL database?
Примеры оценки ресурсов
Введение
Теперь, когда мы заложили основы для оценки ресурсов, давайте используем знания, чтобы оценить такие ресурсы, как серверы, хранилище и пропускную способность. Рассмотрим сервис, подобный Twitter, сделаем некоторые предположения, и на основе этих предположений произведем оценки. Приступим!
Оценка количества необходимых серверов
Сделаем следующие предположения о сервисе, подобном Twitter.
Предположения: Assumptions
- Есть 500 миллионов (M) ежедневно активных пользователей (DAU).
- Один пользователь делает в среднем 20 запросов в день.
- Известно, что один сервер (с 64 ядрами) может обрабатывать 64,000 запросов в секунду (RPS).
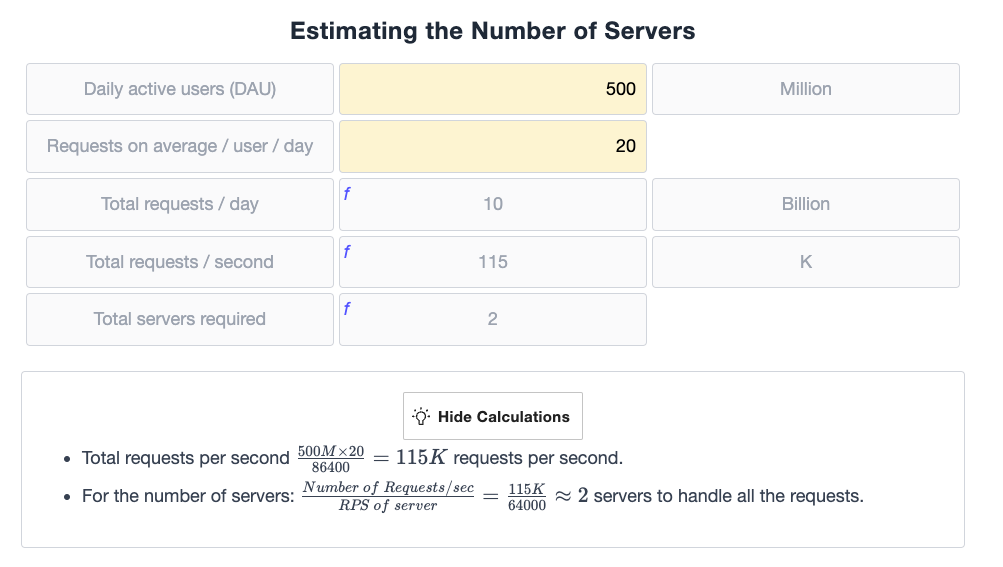
When we divided the daily user requests by the number of seconds in a day, we assumed that those requests were uniformly distributed over those seconds.
This raises the question if the above assumption is reasonable? Rarely will a service get such a nice, uniform distribution of requests.
Doing the above is a simple strategy; what we get can be considered a lower bound on the respective resource.
По всем BOTEC нам необходимо оценить, кажутся ли наши цифры разумными. Например, если полученная нами оценка составляла два сервера для крупного сервиса с миллионами ежедневных пользователей, это число может быть нижней границей, но кажется далеким от реальности.
Пиковая нагрузка (Peak Capacity)
Часто крупные сервисы должны быть готовы к внезапным всплескам активности пользователей (например, флешмобы или другие события, вызывающие массовый одновременный приток запросов). Мы можем оценить пиковую нагрузку, предположив, что есть определенная секунда в течение дня, когда все запросы всех пользователей поступают в систему одновременно. Это позволяет нам сделать оценку необходимой мощности системы для обработки пиковых нагрузок. Для более точных расчетов нам понадобятся распределения запросов и ответов, которые могут быть доступны на этапе прототипирования. Мы можем предположить, что запросы следуют определенному типу распределения, например, распределению Пуассона.
Используя DAU (Daily Active Users) в качестве прокси для пикового времени, мы избегаем сложностей, связанных с поиском распределений запросов. В этом случае DAU становится числом запросов в секунду. Таким образом, количество серверов, необходимых для обработки пиковых нагрузок, можно рассчитать следующим образом:
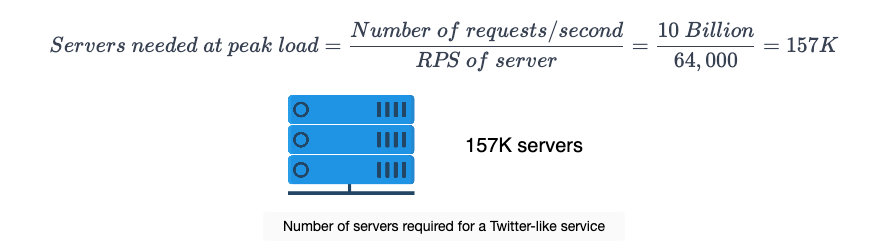
Количество серверов, необходимых для сервиса, подобного Twitter
Если наше предположение верно и все нагрузки могут поступить одновременно в определенную секунду, и каждый из наших серверов может обрабатывать 64,000 запросов в секунду, нам потребуется астрономическое количество в 157,000 серверов! Если это неосуществимо, то у нас есть два возможных пути, описанных ниже.
Улучшение RPS сервера (Improving the RPS of a Server)
Если мы считаем, что наше предположение о пиковых нагрузках верно, мы можем рассчитать, сколько серверов в максимуме мы можем задействовать. Предположим, что мы можем использовать максимум 100,000 серверов. Это означает:
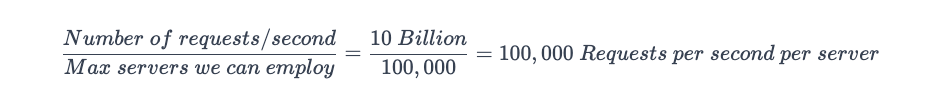
Нам потребуется значительное инженерное усилие, чтобы увеличить RPS, которые мы можем извлечь из одного сервера, с 64,000 до 100,000!
Примеры улучшений RPS:
-
Первый пример: В 2012 году WhatsApp сообщал, что они могут управлять 2 миллионами одновременных TCP-соединений на одном сервере. В 2017 году сообщалось, что WhatsApp использует около 700 серверов IBM для своего сервиса. Неизвестно, какими конкретными характеристиками обладали эти серверы.
-
Второй пример: Исследовательская система, которая была тщательно оптимизирована для IO, выиграла несколько соревнований по сортировке данных в 2010 году. Они отсортировали один триллион записей данных за 172 минуты, используя всего четверть вычислительных ресурсов по сравнению с другим держателем рекорда, что означает, что они улучшили RPS в три раза.
Эти примеры подчеркивают, что улучшение RPS для конкретных случаев использования возможно, хотя и требует значительных усилий в области НИОКР и связанных с ними затрат.
Улучшение предположений о пиковой нагрузке (Improving Over the Peak Load Assumption)
Второй вариант для нас — изменить предположение о пиковой нагрузке. Используя принцип Парето (также известный как правило 80/20), оценка пикового трафика может быть разумным подходом во многих случаях. Принцип Парето предполагает, что примерно 80% эффектов происходит от 20% причин. В контексте оценки пиковой нагрузки мы можем предположить, что 80% нашего пикового трафика происходит в пределах 20% времени (то есть 4,8-часовое окно в течение 24 часов).
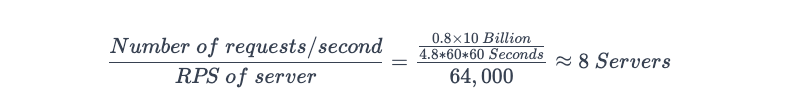
Мы снова предполагаем, что запросы равномерно распределены в 4,8-часовом окне. Приведенные выше примеры показывают, что это имеет огромное значение, если запросы поступают одновременно, а не распределяются во времени. Когда системы строятся на таких предположениях, необходимы системы мониторинга, чтобы убедиться, что эти предположения никогда не нарушаются. Если нагрузка становится выше, чем мы предполагаем, можно использовать такие техники, как load-shedding (сброс нагрузки), circuit-breakers (автоматическое отключение) и throttling (ограничение пропускной способности). Работа с неожиданными пиковыми нагрузками — это сложная задача.
Цена серверов - Cost of servers
We picked an EC2 instance type called m7i.16xlarge with a 64-core processor and 256 GB of RAM to get a handle on the dollar cost of servers. It’s powered by 4th-Generation Intel Xeon Scalable processors. The hourly cost of one such instance is $3.54816 with a 1-year contract plan.
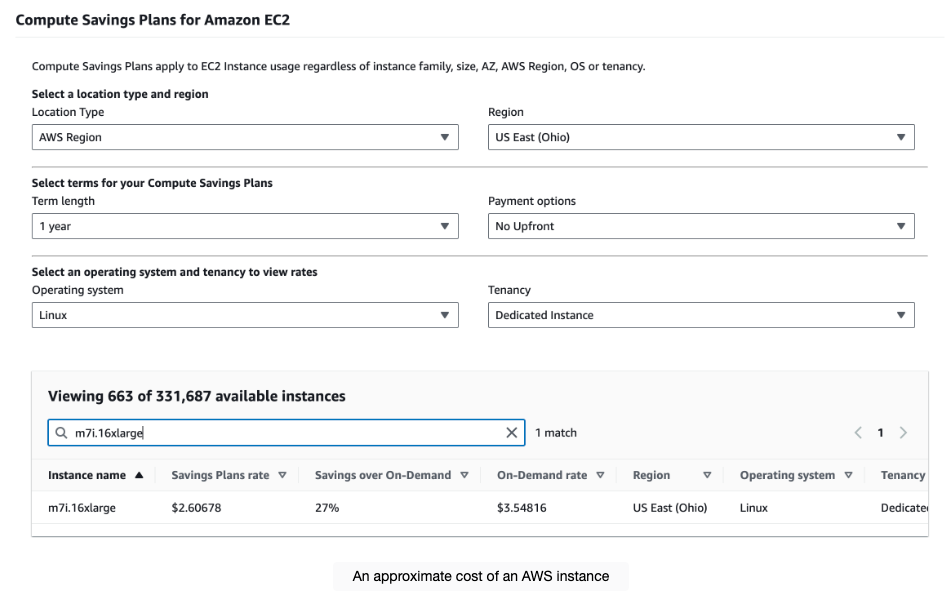
https://aws.amazon.com/savingsplans/compute-pricing/
EC2 Instance Specifications
Instance Size: m7i.16xlarge
Specifications:
- vCPU: 64
- Memory (GiB): 256
- Instance Storage (GB): EBS-Only
- Network Bandwidth (Gbps): 25
- EBS Bandwidth (Gbps): 20
Стоимость серверов
Следующая таблица показывает стоимость экземпляров m7i.16xlarge для двух, восьми и 157,000 серверов. Как видно из таблицы, при пиковой нагрузке стоимость может быстро накапливаться. В реальных проектах бюджет на такие статьи, как серверы, часто является жестким ограничением, которое инженерная команда должна соблюдать.
| Количество серверов | Низкая стоимость за час (Low bound server cost per hour) | Стоимость при 80–20 за час (Cost under 80–20 assumptions per hour) | Стоимость при пиковой нагрузке за час (Peak load cost per hour) |
|---|---|---|---|
| 2 | 2 * $3.548 = $7.096 | - | - |
| 8 | - | 8 * $3.548 = $28.38 | - |
| 157,000 | - | - | 157K * $3.548 = $557,061 |
Из таблицы видно, что стоимость серверов может значительно возрасти в случае пиковой нагрузки. При наличии 157,000 серверов стоимость за час может достигать более полумиллиона долларов. Это подчеркивает важность правильного планирования инфраструктуры и бюджетирования для успешного выполнения проекта.
Требования к хранилищу (Storage Requirements)
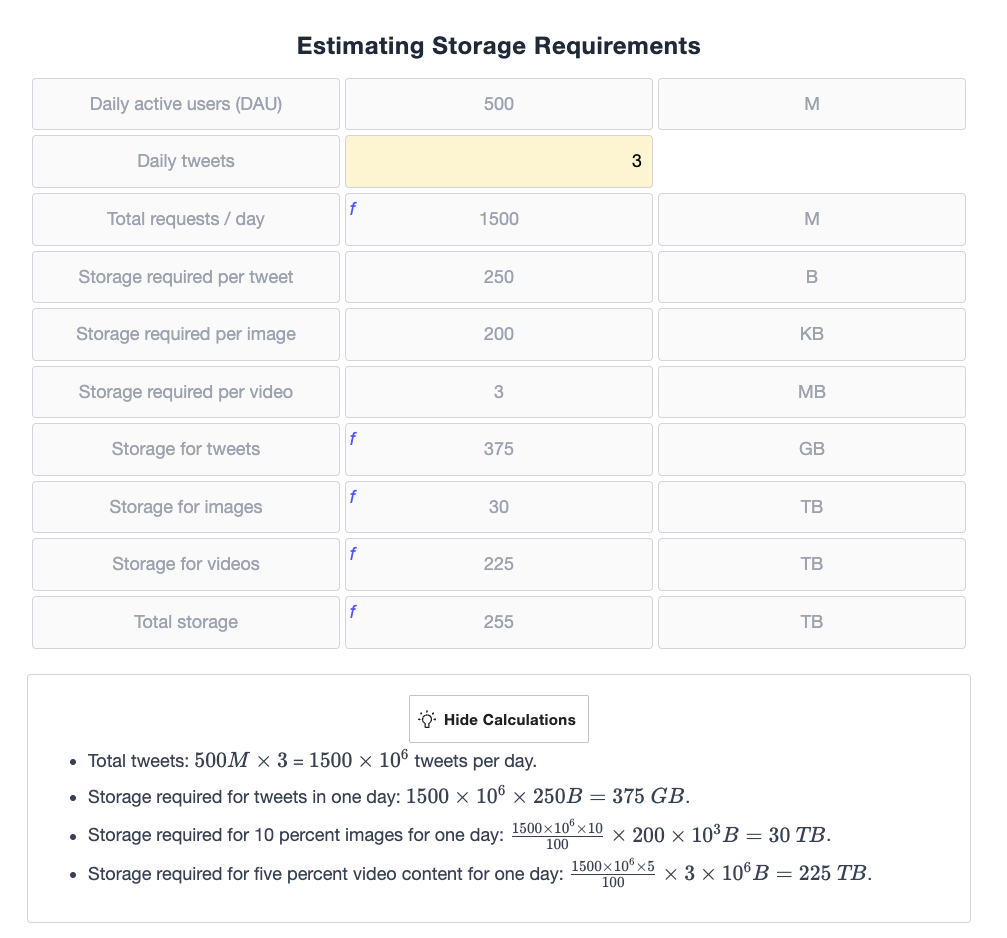
В этом разделе мы попытаемся понять, как оценивается необходимый объем хранилища, используя Twitter в качестве примера. Мы оценим объем пространства для хранения, необходимый для новых твитов за год. Давайте сделаем следующие предположения:
- У нас всего 500 миллионов ежедневно активных пользователей.
- Каждый пользователь публикует три твита в день.
- Десять процентов твитов содержат изображения, а пять процентов — видео. Любой твит, содержащий видео, не будет содержать изображение, и наоборот.
- Размер изображения составляет 200 КБ, а видео — 3 МБ, в среднем.
- Текст твита и его метаданные требуют в общей сложности 250 байтов для хранения в базе данных.
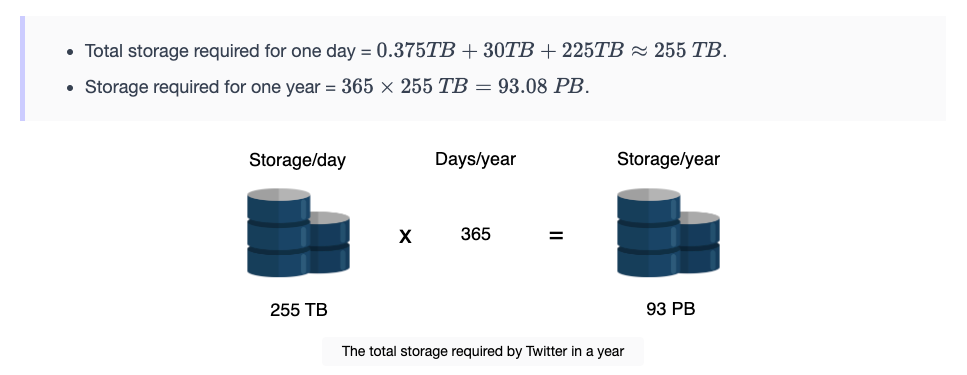
Затем, на основе этих предположений, будет рассчитано необходимое пространство для хранения за день:
Требования к пропускной способности (Bandwidth Requirements)
Для того чтобы оценить требования к пропускной способности сервиса, мы используем следующие шаги:
- Оценка объема входящих данных в сервис за день.
- Оценка объема исходящих данных из сервиса за день.
- Оценка пропускной способности в Гбит/с (Gigabits per second) путем деления объема входящих и исходящих данных на количество секунд в сутках.
Входящий трафик (Incoming Traffic):
Продолжим с предыдущего примера Twitter, которому требуется 255 ТБ хранилища каждый день. Соответственно, входящий трафик должен поддерживать следующую пропускную способность в секунду:

Примечание: Мы умножаем на 8, чтобы конвертировать байты (B) в биты (b), так как пропускная способность измеряется в битах в секунду.
Исходящий трафик (Outgoing Traffic):
Предположим, что один пользователь просматривает 50 твитов в день. Учитывая ту же пропорцию, что и ранее — пять процентов для видео и десять процентов для изображений, из 50 твитов 2.5 твита будут содержать видео, а пять твитов — изображение. Учитывая, что у нас 500 миллионов ежедневно активных пользователей, мы можем сделать следующие расчеты:
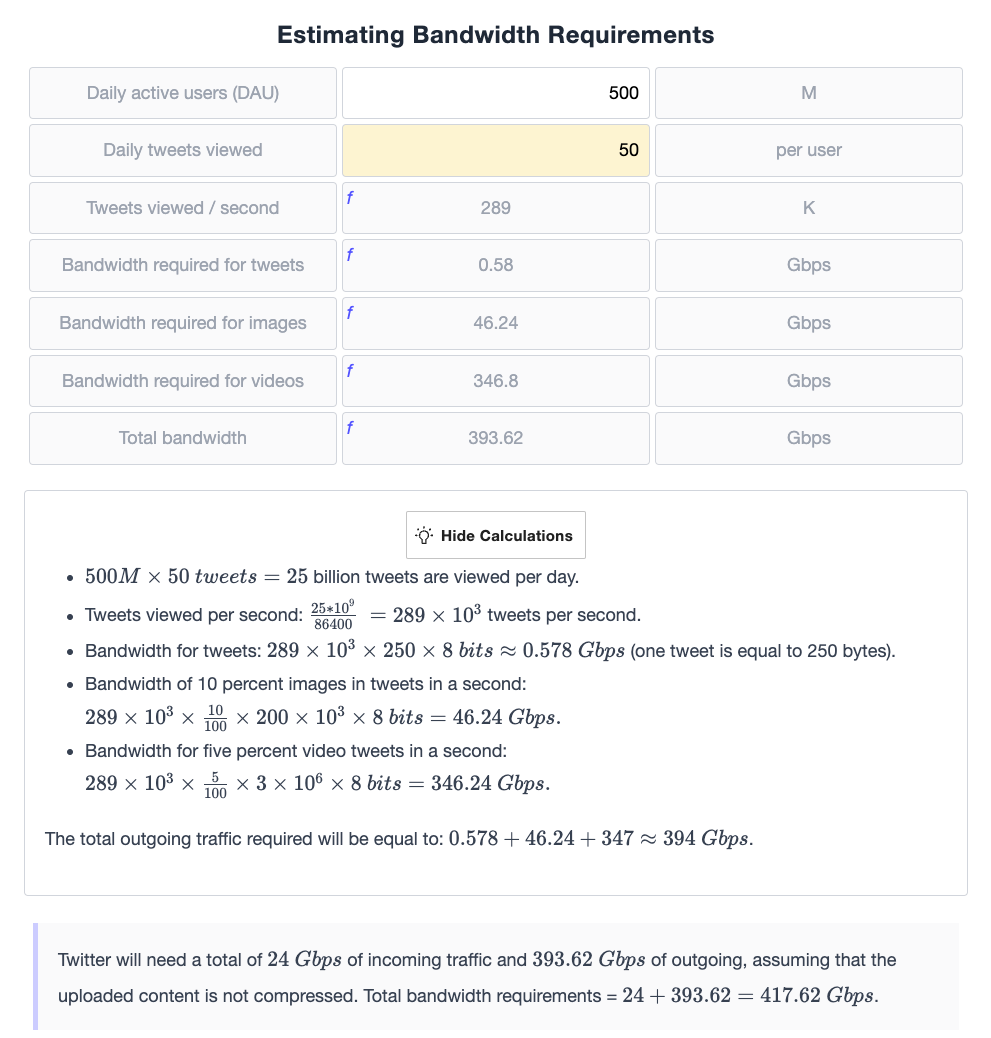
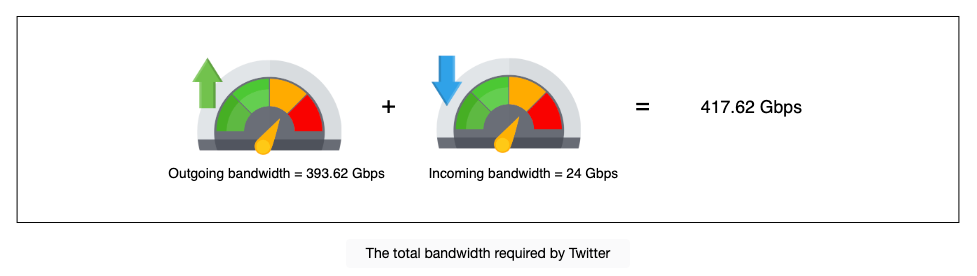
Для Twitter потребуется в общей сложности 24 Gbps входящего трафика и 393.62 Gbps исходящего трафика, если предположить, что загружаемый контент не сжат.
Итого, общие требования к пропускной способности составляют:
\[ 24 + 393.62 = 417.62 \, Gbps \]
Таким образом, для работы сервиса при таком уровне нагрузки потребуется общая пропускная способность 417.62 Gbps.
Оценка пропускной способности в 417.62 Gbps: Много это или мало?
Пропускная способность в 417.62 Gbps (гигабит в секунду) является значительной нагрузкой и требует серьезных сетевых ресурсов. Чтобы лучше понять, много это или мало, давайте рассмотрим несколько факторов:
1. Сравнение с типичными интернет-сервисами
- Для крупных интернет-сервисов, таких как Google, Facebook или Twitter, пропускная способность в сотни гигабит в секунду — это стандартная нагрузка, которую их дата-центры обрабатывают ежедневно. Такие компании имеют возможность поддерживать инфраструктуру, которая позволяет им управлять таким объемом трафика.
- Для среднего или небольшого интернет-сервиса пропускная способность в 417.62 Gbps может оказаться чрезмерной и потребует значительных финансовых вложений в инфраструктуру и сети.
2. Стоимость и реализация
- Поддержание такой пропускной способности связано с высокими затратами на оборудование, включая высокоскоростные маршрутизаторы, коммутаторы, и каналы связи.
- Потребуются мощные и масштабируемые дата-центры с надежной сетью, чтобы обеспечить устойчивую работу при такой нагрузке.
3. Сравнение с сетями
- Для сравнения, 417.62 Gbps — это более чем достаточно для обычного интернет-провайдера среднего размера, который обслуживает тысячи пользователей. Это также сравнимо с пропускной способностью, которую используют для трансляции крупных спортивных мероприятий или масштабных онлайн-игр.
4. Реальная потребность
- Для Twitter, с его миллионами активных пользователей и обширным контентом, такой уровень пропускной способности является обоснованным, особенно во время пиковых нагрузок, когда много пользователей одновременно загружают и просматривают медиа-контент.
417.62 Gbps — это очень высокая пропускная способность, которая требует масштабируемой и дорогостоящей инфраструктуры. Для крупных интернет-сервисов такой объем данных является управляемым, но для меньших компаний это будет значительной задачей, требующей значительных инвестиций.
Опять же, приведенные выше расчеты зависят от нашего конкретного предположения о составе трафика (текст, изображения или видео) и соотношении чтения/записи.
Tasks
Let’s consider a service hosting the dynamic and personalized website of a large news organization. Due to some unexpected events, such as 9/11, flash crowds are coming to the website to find out updates. It might be a situation where all the DAUs come in simultaneously. Such a situation will clearly break our usual load assumptions. Can you think of some way to gracefully degrade the service to meet such an unexpected load?
We came up with the number of 93 PB for storage needs per year. Is this number plausible?
Isn’t need for the network bandwidth of ~ 400 Gbps too high?
Заключение
Этот урок является шаблоном для оценки ресурсов в остальной части курса. Мы будем использовать цифры из этого урока на протяжении всего курса. BOTEC позволяют нам показать осуществимость системы в рамках определенного проекта. Во время собеседований способность выполнять такие расчеты демонстрирует навыки решения проблем кандидата перед лицом неизвестности. На собеседовании мы можем сделать не так много. Однако в реальном мире организации полагаются на реальные измерения для своей конкретной рабочей нагрузки и вводные данные для своих расчетов на заднем плане.