Key value Store
Introduction to key-value stores - Введение в key-value хранилища
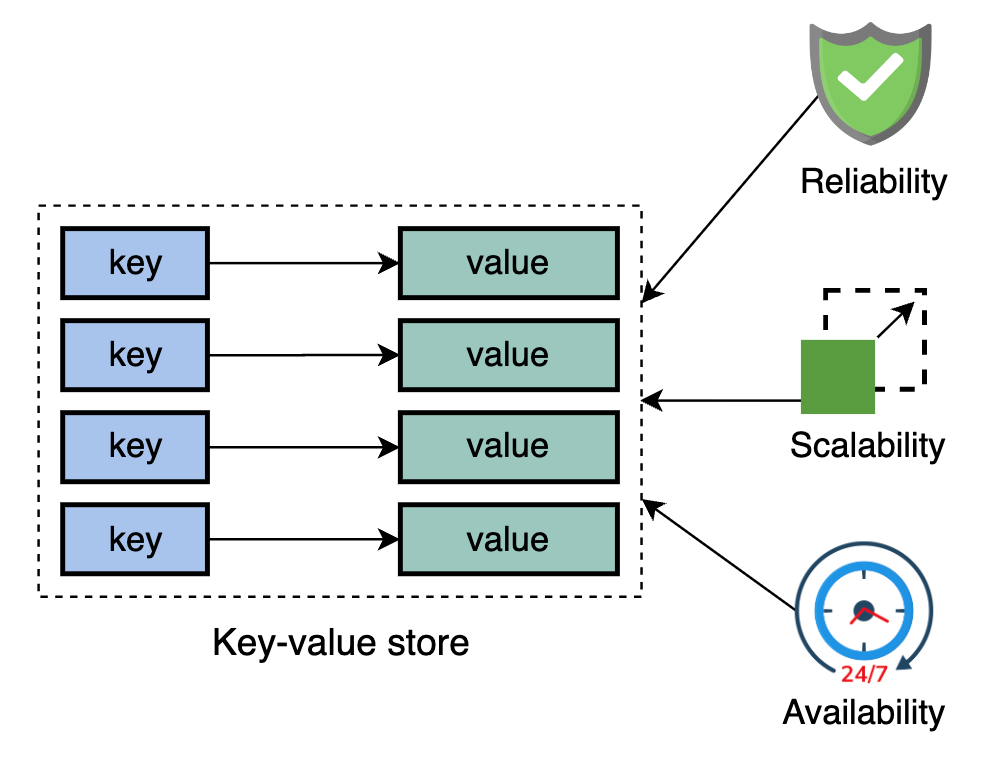
Key-value stores представляют собой распределенные хэш-таблицы (DHT). Ключ генерируется хэш-функцией и должен быть уникальным. В key-value хранилище ключ связывается с определенным значением и не предполагает ничего о структуре этого значения. Значение может быть любым: blob, изображение, имя сервера или любой другой объект, который пользователь хочет сохранить под уникальным ключом.
Обычно предпочтительно, чтобы размер значения был относительно небольшим (от КБ до МБ). Мы можем хранить большие данные в blob-хранилище, а ссылки на эти данные помещать в поле значения. Key-value хранилища полезны во многих ситуациях, таких как хранение пользовательских сессий в веб-приложении и построение NoSQL баз данных.
Масштабирование традиционных баз данных с сильной консистентностью и высокой доступностью в распределенной среде является сложной задачей. Многие реальные сервисы, такие как Amazon, Facebook, Instagram, Netflix и многие другие, используют доступ по первичному ключу к хранилищу данных вместо традиционных OLTP баз данных. Примеры использования key-value хранилищ включают списки бестселлеров, корзины покупок, предпочтения клиентов, управление сессиями, рейтинги продаж и каталоги продуктов.
Традиционные OLTP (SQL как правило) базы данных (Online Transaction Processing) предназначены для обработки большого количества простых транзакций, таких как вставка, обновление или удаление данных. Эти базы данных поддерживают сильную консистентность данных, используя транзакции с поддержкой свойств ACID (Atomicity, Consistency, Isolation, Durability). OLTP системы часто используются в реляционных базах данных, где структура данных строго определяется схемами, а операции выполняются в реальном времени.
Основные характеристики традиционных OLTP баз данных:
- Сильная консистентность: Данные всегда остаются в согласованном состоянии после выполнения транзакции.
- Поддержка сложных запросов: OLTP базы данных поддерживают сложные SQL-запросы, включая соединения (joins), вложенные запросы и агрегатные функции.
- ACID-транзакции: Обеспечивают атомарность, консистентность, изоляцию и долговечность каждой транзакции.
Однако в современных распределенных системах, таких как Amazon, Facebook, Instagram, и Netflix, объем данных и нагрузка на систему значительно возросли, что приводит к определенным проблемам при использовании традиционных OLTP баз данных:
- Масштабируемость: OLTP базы данных сложно масштабировать горизонтально, т.е. распределять данные по множеству серверов.
- Высокая задержка: Сложные транзакции могут приводить к задержкам, что критично для крупных систем с высокой нагрузкой.
- Ограниченная гибкость: Строгая схема и сильная консистентность затрудняют управление большими объемами данных, которые распределены по нескольким узлам.
Из-за этих ограничений многие компании перешли на использование key-value хранилищ и других NoSQL решений, которые предлагают более гибкую модель данных и лучше подходят для горизонтального масштабирования:
- Горизонтальная масштабируемость: NoSQL базы данных, такие как key-value хранилища, легче масштабировать по множеству узлов, что улучшает производительность и доступность.
- Эластичность: NoSQL базы данных не требуют строгих схем, что позволяет быстро адаптироваться к изменяющимся требованиям приложения.
- Первичный ключ: В key-value хранилищах данные хранятся и извлекаются с использованием первичных ключей, что позволяет значительно упростить и ускорить операции по сравнению с традиционными OLTP базами данных.
Таким образом, различие между OLTP базами данных и NoSQL хранилищами заключается в подходе к управлению данными и транзакциями: OLTP системы ориентированы на сильную консистентность и сложные транзакции, в то время как NoSQL решения предлагают масштабируемость и гибкость, жертвуя некоторыми традиционными возможностями, такими как сложные запросы и строгая консистентность.
Key-value store - Key-value хранилище
Примечание: Многим приложениям может не требоваться богатая программная модель, предоставляемая традиционной системой управления реляционными базами данных (RDBMS). Использование RDBMS для таких приложений часто бывает дорогостоящим с точки зрения затрат и производительности.
How will we design a key-value store? - Как мы будем проектировать key-value хранилище?
Мы разделили проектирование key-value системы на следующие четыре урока:
- Design a Key-value Store: Мы определим требования к key-value хранилищу и разработаем API.
- Ensure Scalability and Replication: Мы научимся достигать масштабируемости с использованием консистентного хеширования и реплицировать распределенные данные.
- Versioning Data and Achieving Configurability: Мы научимся разрешать конфликты, возникающие из-за изменений, внесенных несколькими сущностями, и сделаем нашу систему более настраиваемой для различных сценариев использования.
- Enable Fault Tolerance and Failure Detection: Мы научимся делать key-value хранилище отказоустойчивым и обнаруживать сбои в системе.
Design of a Key-value Store
Requirements - Требования
Перечислим требования к проектированию key-value хранилища для преодоления проблем традиционных баз данных.
Functional requirements - Функциональные требования
Обычно от key-value хранилищ ожидают предоставления таких функций, как get и put. Однако эта конкретная система key-value хранилища отличается своими уникальными характеристиками, объясненными ниже:
-
Configurable service - Конфигурируемый сервис: Некоторые приложения могут предпочесть пожертвовать сильной консистентностью ради более высокой доступности. Необходимо предоставить конфигурируемый сервис, чтобы разные приложения могли использовать различные модели консистентности. Требуется строгий контроль над компромиссами между доступностью, консистентностью, экономической эффективностью и производительностью.
Примечание: Такие настройки могут быть выполнены только при создании нового экземпляра key-value хранилища и не могут быть изменены динамически во время работы системы.
-
Ability to always write - Возможность всегда записывать данные: Приложения должны всегда иметь возможность записывать данные в key-value хранилище. Если пользователь хочет сильную консистентность, это требование может не всегда выполняться из-за ограничений, налагаемых теоремой CAP.
Примечание: Контекст задачи определяет, что будет классифицировано как функциональное требование, а что как нефункциональное. Например, возможность всегда записывать данные (высокая доступность) является функциональным требованием для приложения корзины покупок Amazon, тогда как в других случаях высокая доступность может рассматриваться как нефункциональное требование. Вдохновляясь хранилищем ключ-значение Dynamo от Amazon, мы можем классифицировать возможность всегда записывать данные как функциональное требование.
-
Hardware heterogeneity - Аппаратная гетерогенность: Мы хотим иметь возможность добавлять новые серверы с разной и большей мощностью в наш кластер, не изменяя и не модернизируя существующие серверы. Наша система должна уметь приспосабливаться к серверам разной мощности, обеспечивая корректное выполнение основных функций (чтение и запись данных) и равномерное распределение нагрузки в соответствии с мощностью каждого сервера. Это требует разработки одноранговой сети без выделенных узлов.
Non-functional requirements - Нефункциональные требования
Нефункциональные требования следующие:
-
Scalability - Масштабируемость: Key-value хранилища должны работать на десятках тысяч серверов, распределенных по всему миру. Инкрементальная масштабируемость крайне желательна. Мы должны иметь возможность добавлять или удалять серверы по мере необходимости с минимальными или нулевыми нарушениями доступности сервиса. Более того, наша система должна справляться с огромным количеством пользователей key-value хранилища.
-
Fault tolerance - Отказоустойчивость: Key-value хранилище должно работать непрерывно, несмотря на сбои серверов или их компонентов.
Now that you understand the functional and non-functional requirements of a key-value store, what do you think are the key differences between key-value stores and traditional databases?
In what scenarios are key-value stores particularly advantageous?
Key-value stores vs. Traditional Relational Databases
Key-value stores and traditional relational databases differ primarily in their data model and access patterns. Key-value stores are optimized for fast retrieval by using a simple key, do not support complex query languages, and often prioritize availability and scalability over strict consistency. They typically handle unstructured data. These stores are particularly advantageous in scenarios requiring rapid data access, managing massive volumes of data, and when the data structure is flexible or not fully known in advance.
Why do we need to run key-value stores on multiple servers?
Answer
A single-node-based hash table can fall short due to one or more of the following reasons:
- No matter how big a server we get, this server can’t meet data storage and query requirements.
- Failure of this one mega-server will result in service downtime for everyone.
So, key-value stores should use many servers to store and retrieve data.
Assumptions - Предположения
Мы примем следующие предположения для упрощения нашего дизайна:
- Дата-центры, в которых размещается сервис, считаются доверенными (не враждебными).
- Все необходимые процедуры аутентификации и авторизации уже выполнены.
- Запросы и ответы пользователей передаются через HTTPS.
API design - Дизайн API
Key-value хранилища, как и обычные хэш-таблицы, предоставляют две основные функции: get и put.
Рассмотрим дизайн API.
The get function - Функция get
API вызов для получения значения должен выглядеть так:
get(key)
Мы возвращаем соответствующее значение на основе параметра key. Когда данные реплицируются, система находит реплику объекта, связанную с определенным ключом, которая скрыта от конечного пользователя. Это выполняется системой, если хранилище настроено на использование менее строгой модели консистентности данных. Например, при eventual consistency (конечная согласованность) может быть возвращено более одного значения по одному ключу.
Параметры:
- key: Ключ, по которому необходимо получить значение.
- The put function - Функция put
API вызов для записи значения в систему должен выглядеть так:
put(key, value)
Он сохраняет значение, связанное с ключом. Система автоматически определяет, где должны быть размещены данные. Кроме того, система часто хранит метаданные о сохраненном объекте, такие как версия объекта.
Параметры:
- key: Ключ, по которому нужно сохранить значение.
- value: Объект, который нужно сохранить под данным ключом.
We often keep hashes of the value (and at times, value + associated key) as metadata for data integrity checks. Should such a hash be taken after any data compression or encryption, or should it be taken before?
Details
Answer
The correct answer might depend on the specific application. Still, we can use hashes either before or after any compression or encryption. But we’ll need to do that consistently for put and get operations.Data type - Тип данных
Ключ в key-value хранилище часто является первичным ключом, тогда как значение может быть любыми произвольными бинарными данными.
Примечание: В системе Dynamo используется MD5 хэширование ключа для генерации 128-битного идентификатора. Эти идентификаторы помогают системе определить, какой серверный узел будет ответственен за данный ключ.
Следующие шаги
В следующем уроке мы научимся проектировать наше key-value хранилище. Сначала мы сосредоточимся на добавлении масштабируемости, репликации и версионирования данных в нашу систему. Затем мы обеспечим выполнение функциональных требований и сделаем нашу систему отказоустойчивой. Мы сначала выполним несколько нефункциональных требований, поскольку реализация функциональных требований зависит от выбранного метода масштабируемости.
Примечание: Этот раздел основан на работе Dynamo, которая оказала значительное влияние на область key-value хранилищ.
Обеспечьте масштабируемость и репликацию - Ensure Scalability and Replication
Add scalability - Добавление масштабируемости
Начнем с одного из ключевых требований дизайна: масштабируемость. Мы храним данные key-value в узлах хранения. С изменением спроса, нам может понадобиться добавить или удалить узлы хранения. Это означает, что нам нужно разделить данные по узлам в системе, чтобы распределить нагрузку между всеми узлами.
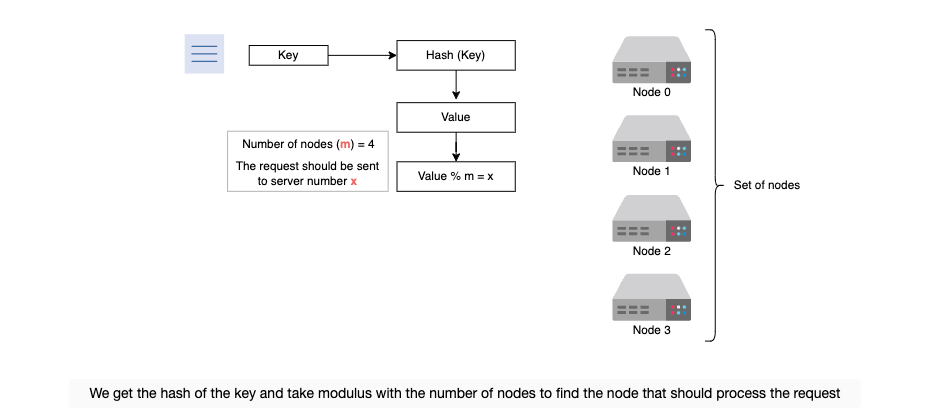
Например, предположим, что у нас есть четыре узла, и мы хотим, чтобы 25% запросов отправлялись на каждый узел, чтобы равномерно распределить нагрузку. Традиционный способ решения этой задачи заключается в использовании оператора модуля. Каждый запрос, который поступает, имеет связанный с ним ключ. Когда поступает запрос, мы вычисляем хеш ключа. Затем находим остаток от деления (модуль) хешированного значения на количество узлов m. Значение остатка x соответствует номеру узла, и мы отправляем запрос на этот узел для обработки.
Следующие слайды объясняют этот процесс:
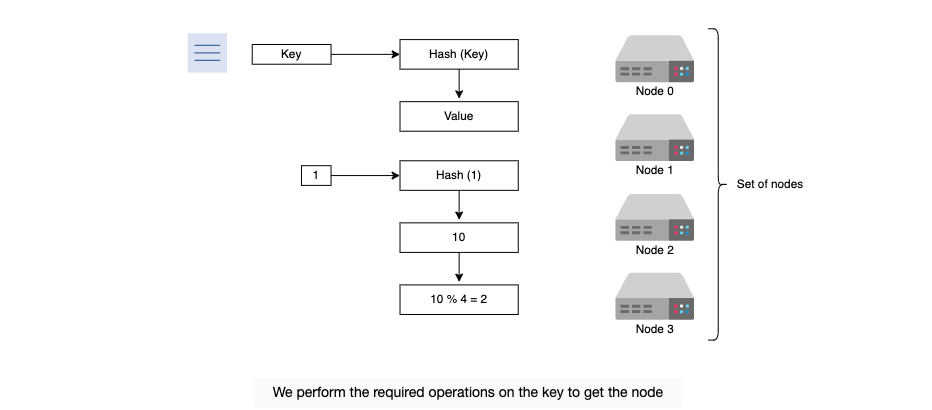
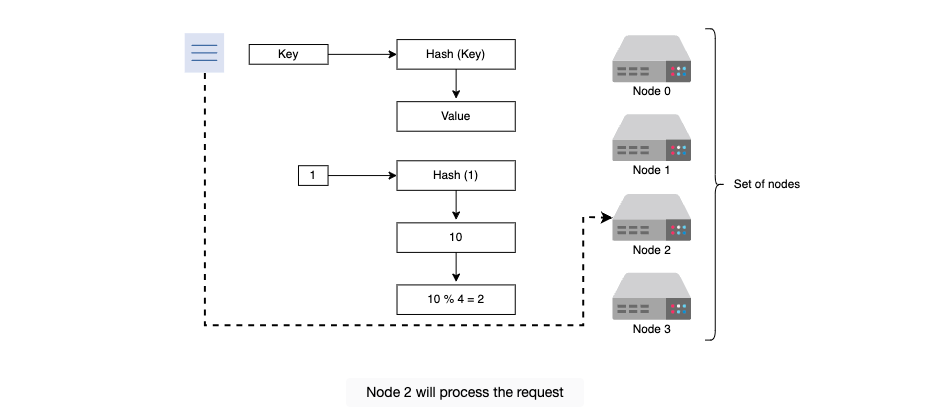
Мы хотим добавлять и удалять узлы с минимальными изменениями в нашей инфраструктуре. Однако при использовании традиционного метода модуля, когда мы добавляем или удаляем узел, нам нужно перемещать большое количество ключей, что неэффективно. Например, если узел 2 будет удален, тот же ключ теперь может обрабатываться узлом 1, потому что 10 % 3 = 1. Узлы хранят информацию в своих локальных кэшах, такую как ключи и их значения. Это означает, что нам нужно перенести данные, связанные с этим ключом, на новый узел, ответственный за обработку запроса. Однако этот процесс репликации может быть затратным и привести к высокой задержке.
В следующем разделе мы рассмотрим, как эффективно копировать и управлять данными в таких сценариях.
Why didn’t we use load balancers to distribute the requests to all nodes?
Details
Answer
Load balancers distribute client requests according to an algorithm. That algorithm can be as simple as explained above, or it can be something detailed, as described in the next section. The next method we’ll discuss can be one of the ways the load balancers balance the requests across the nodes.Consistent hashing - Консистентное хеширование
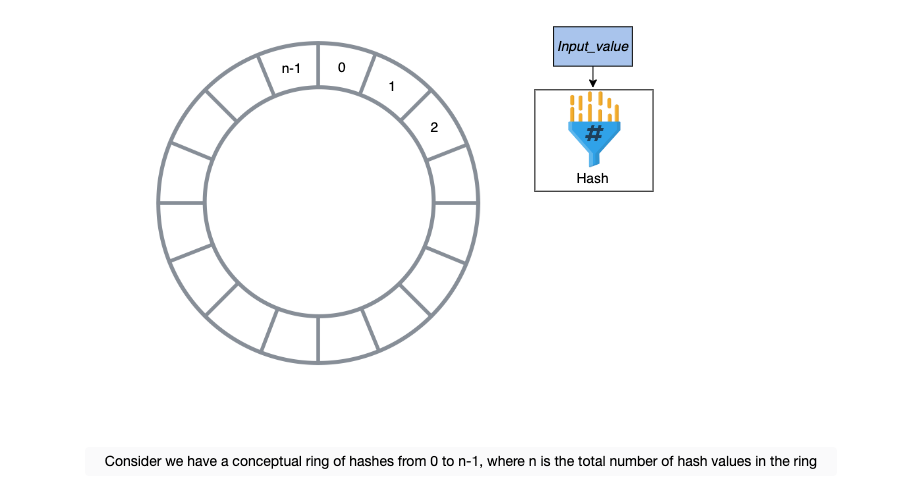
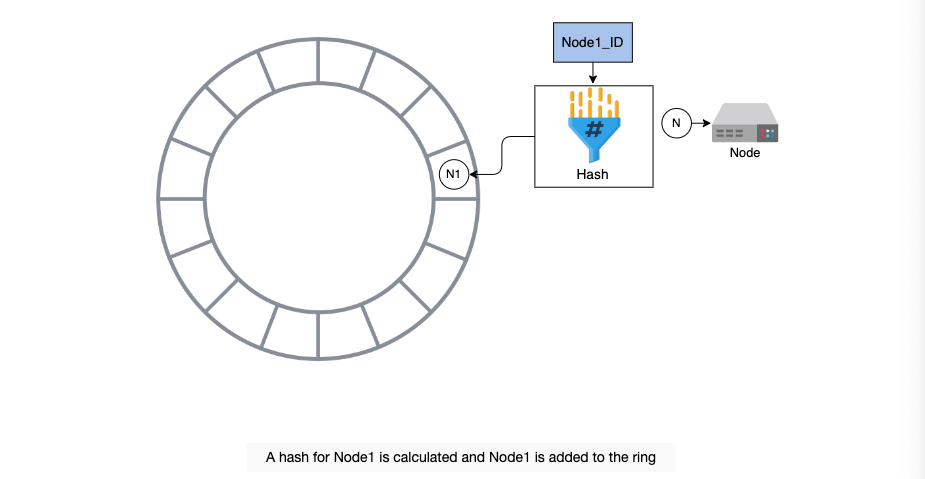
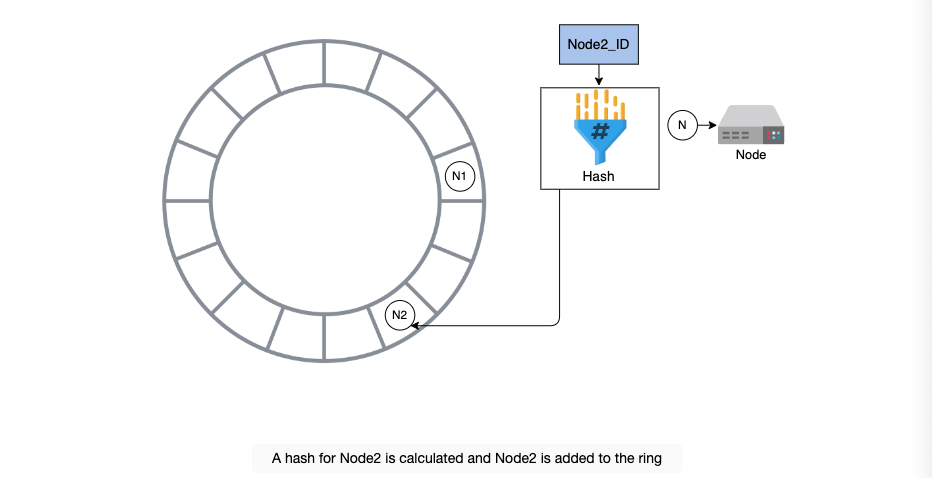
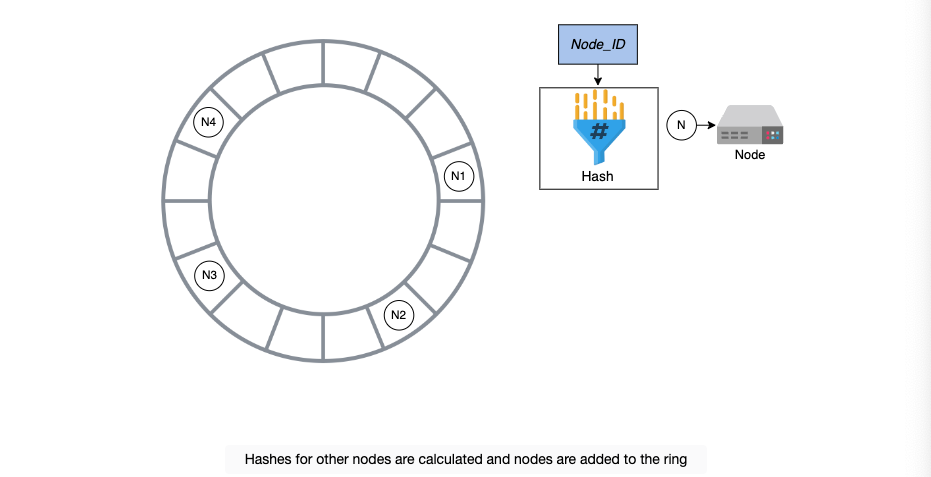
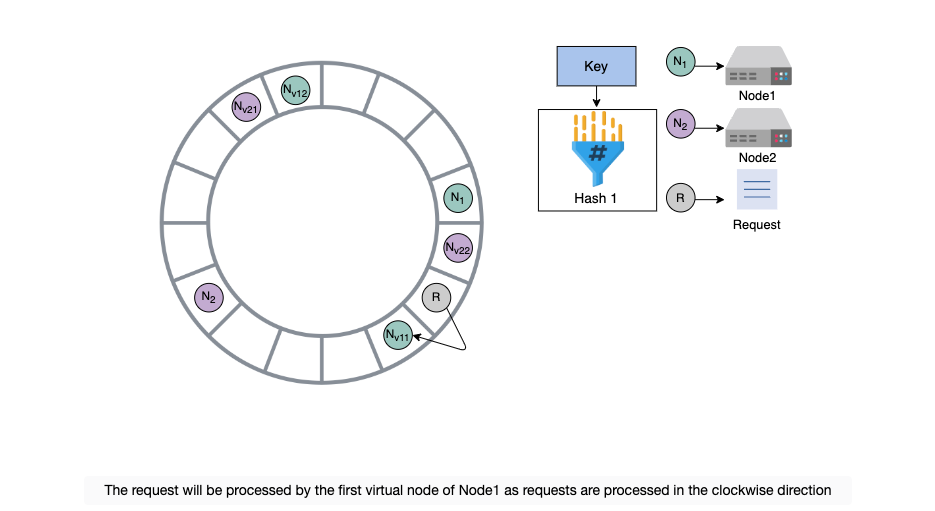
Консистентное хеширование — это эффективный способ управления нагрузкой на набор узлов. В консистентном хешировании мы представляем концептуальное кольцо хешей от 0 до n−1, где n — это количество доступных значений хеша. Мы используем идентификатор каждого узла, вычисляем его хеш и отображаем его на кольце. Тот же процесс применяется к запросам. Каждый запрос обрабатывается следующим узлом, который он находит, двигаясь по кольцу по часовой стрелке.
Когда новый узел добавляется в кольцо, это влияет только на следующий узел, который должен поделиться своими данными с новым узлом, в то время как остальные узлы остаются неизменными. Масштабировать систему просто, поскольку изменения в узлах минимальны. Это происходит потому, что только небольшая часть всех ключей нуждается в перемещении. Хеши распределены случайным образом, поэтому можно ожидать, что нагрузка запросов будет случайной и в среднем равномерно распределена по кольцу.
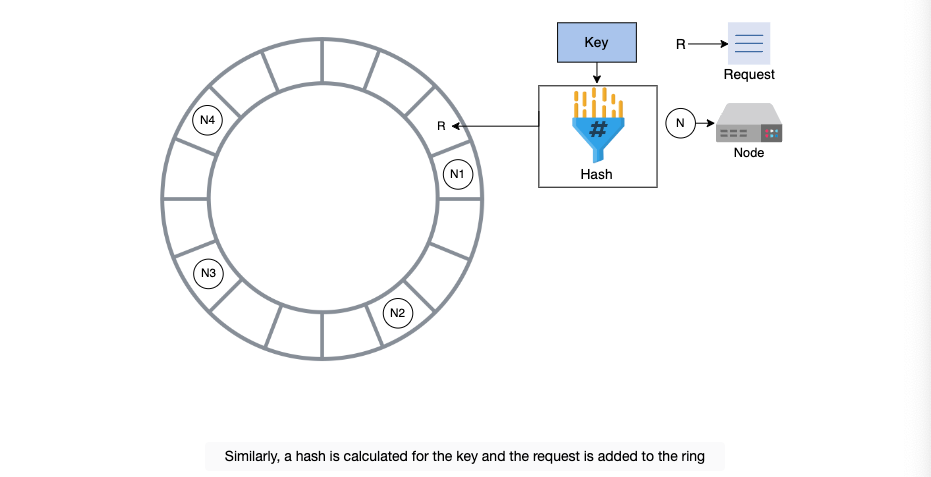
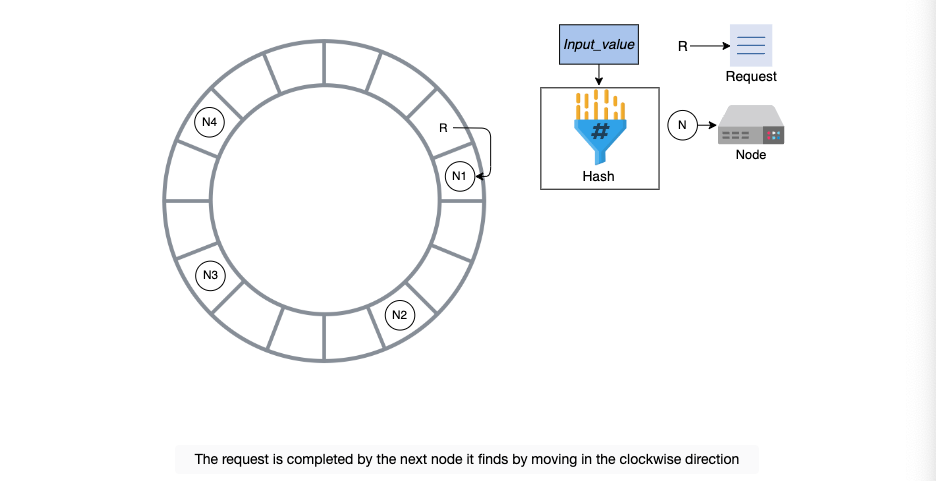
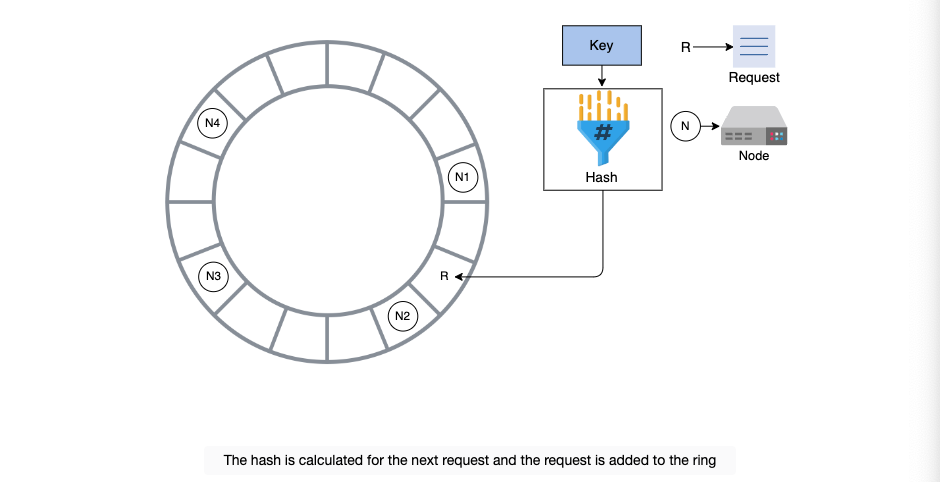
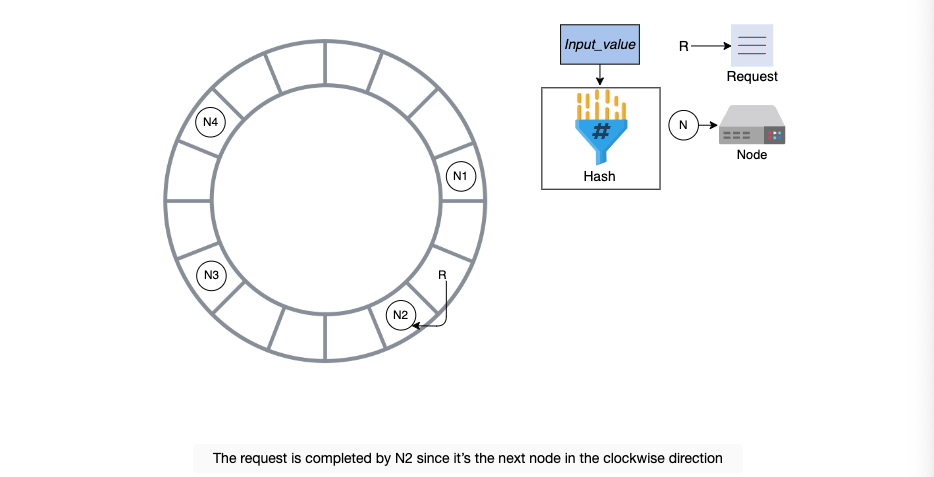
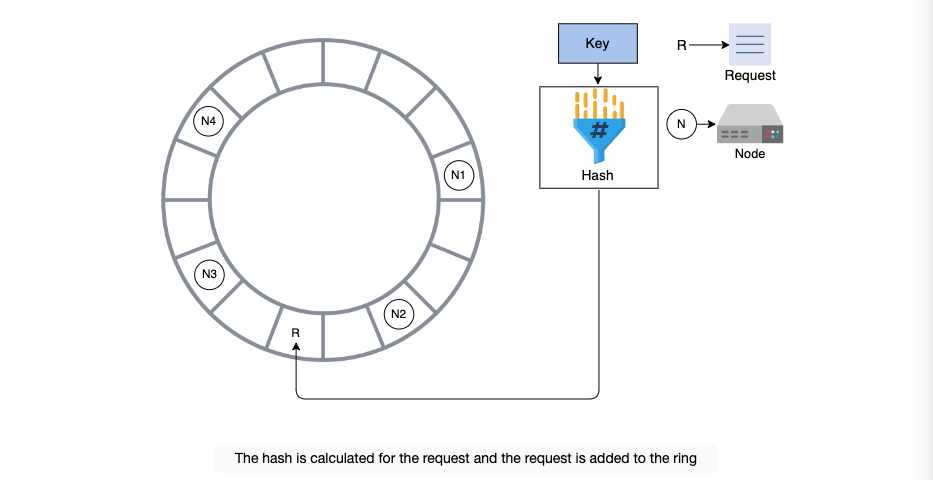
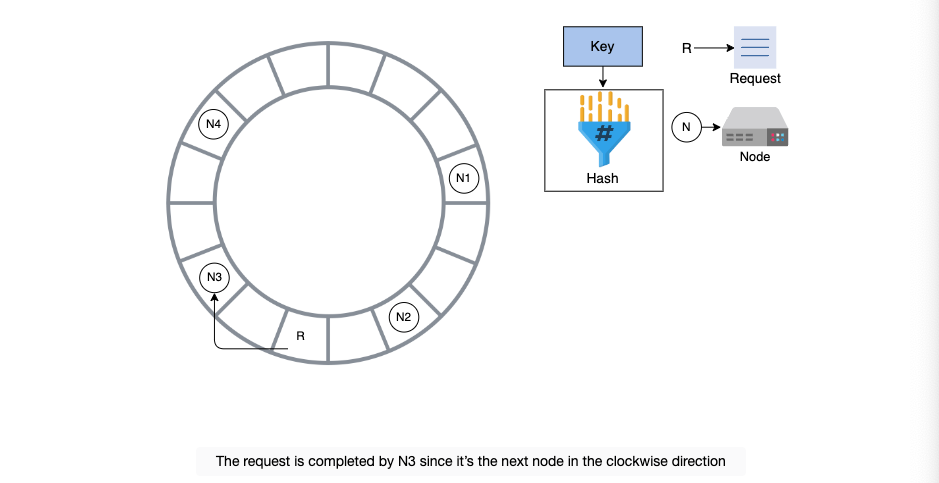
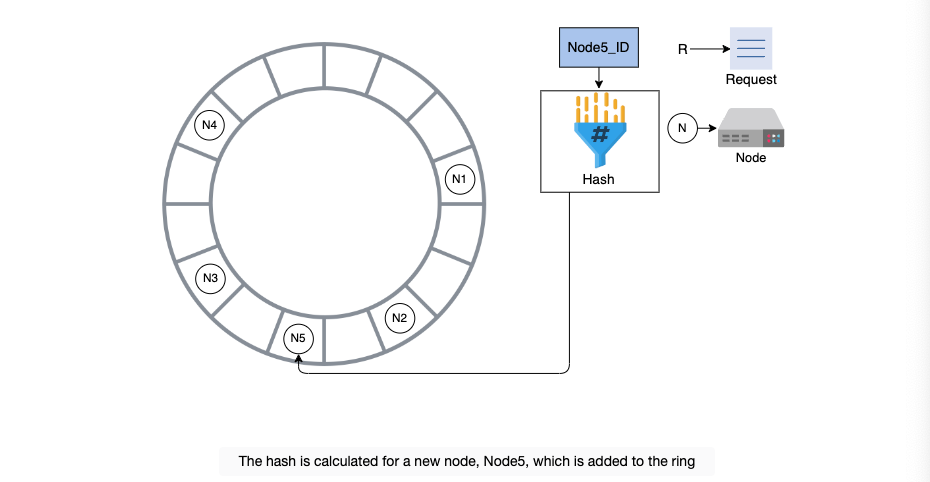
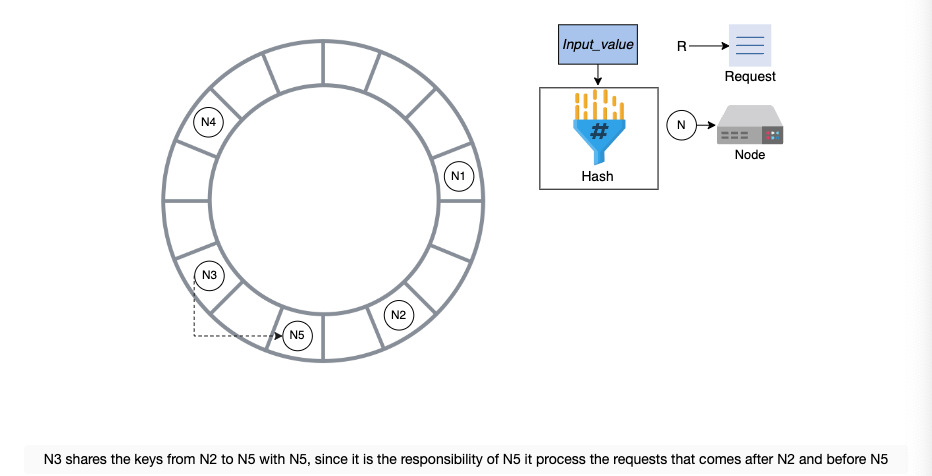
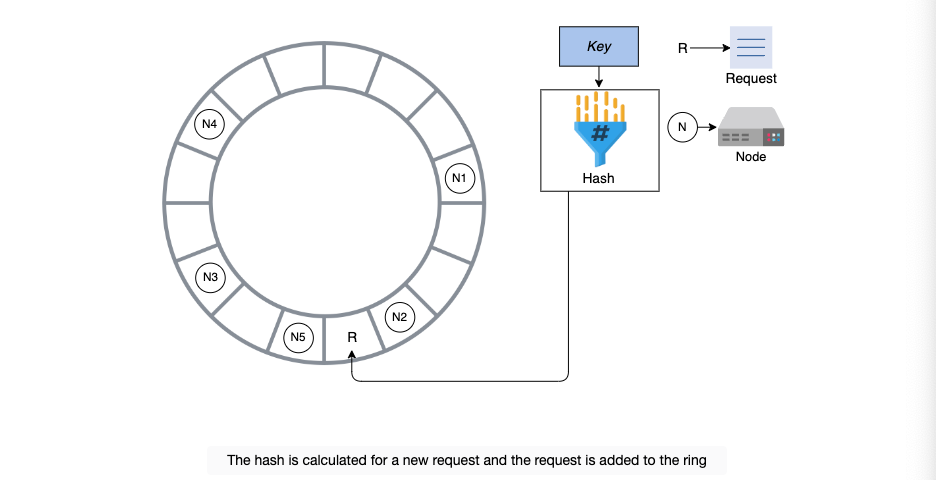
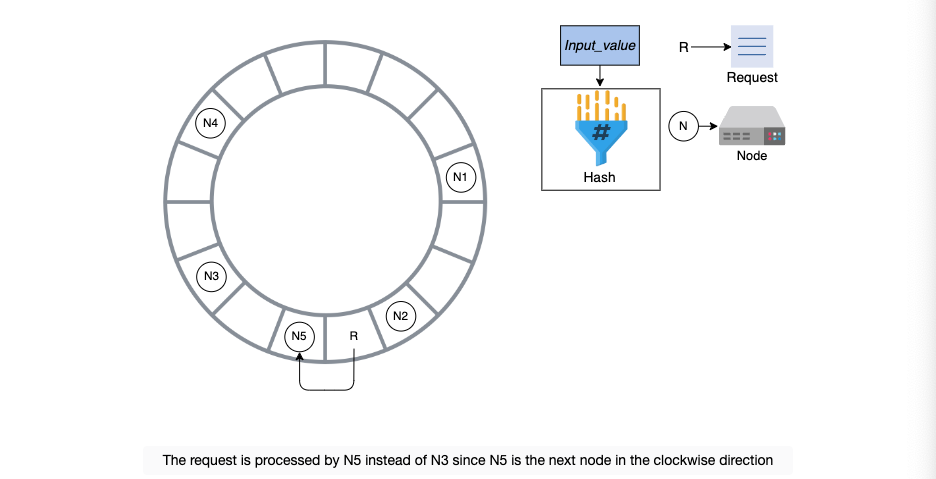
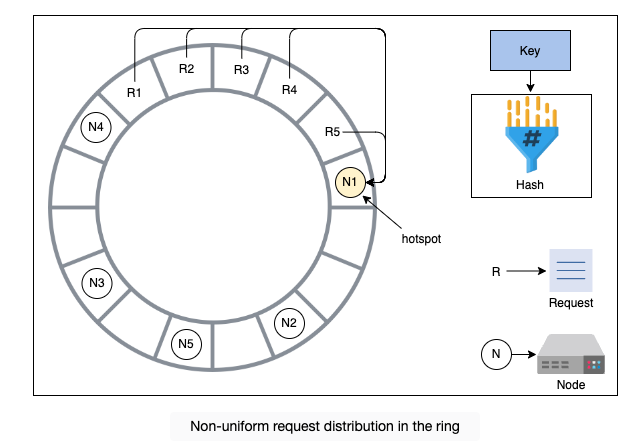
Основное преимущество консистентного хеширования заключается в том, что при добавлении или удалении узлов минимальное количество ключей нуждается в перемещении. Однако на практике нагрузка на запросы не всегда распределяется равномерно. Любой сервер, который обрабатывает большой объем данных, может стать узким местом в распределенной системе. Такой узел будет получать непропорционально большую долю запросов на хранение и извлечение данных, что снижает общую производительность системы. В результате такие узлы называют hotspots (горячие точки).
Как показано на рисунке ниже, большинство запросов обрабатываются между узлами N4 и N1. Теперь узел N1 должен обрабатывать большинство запросов по сравнению с другими узлами, и он стал "горячей точкой". Это означает, что неравномерное распределение нагрузки увеличило нагрузку на один сервер.
Примечание: Полезно подумать о возможных решениях проблемы неравномерного распределения нагрузки, прежде чем читать дальше.
Use virtual nodes - Использование виртуальных узлов
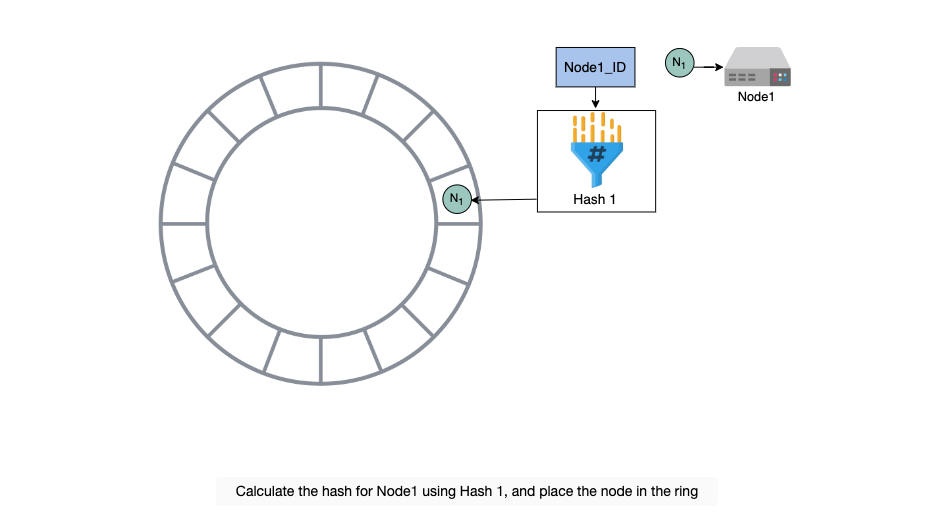
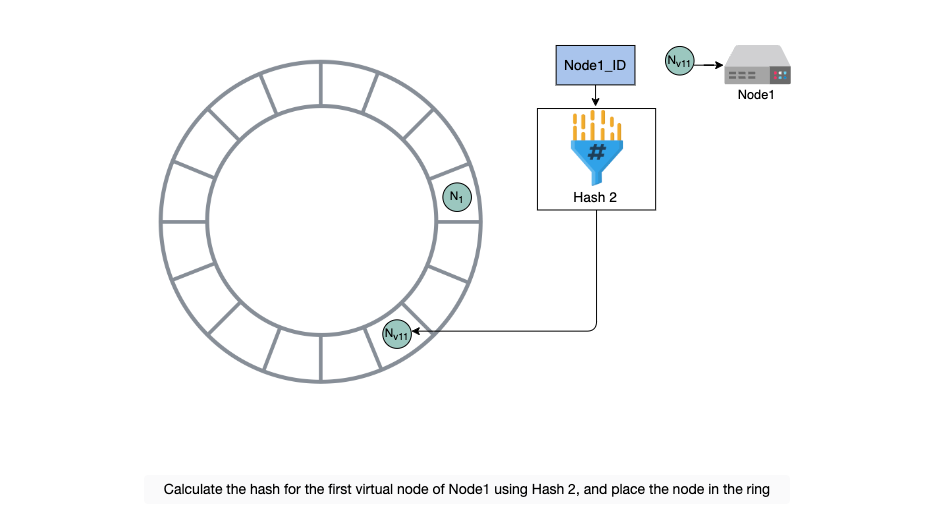
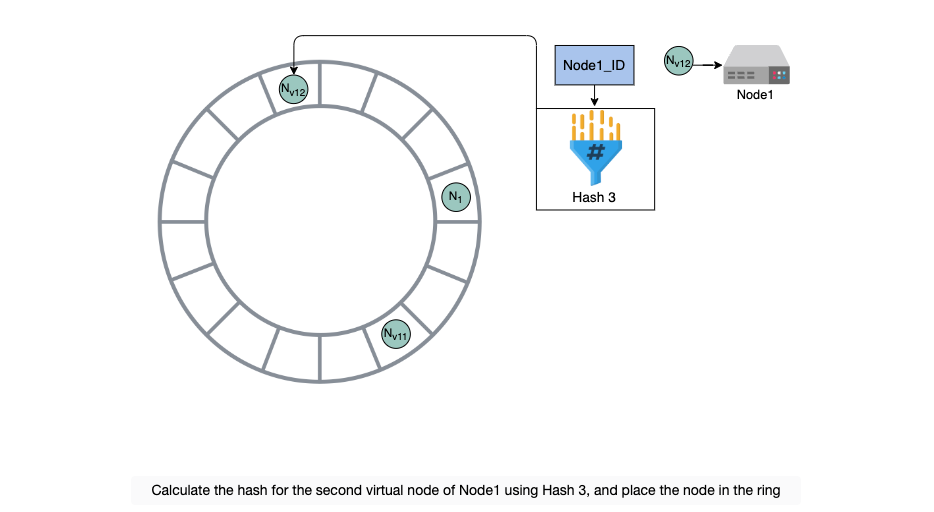
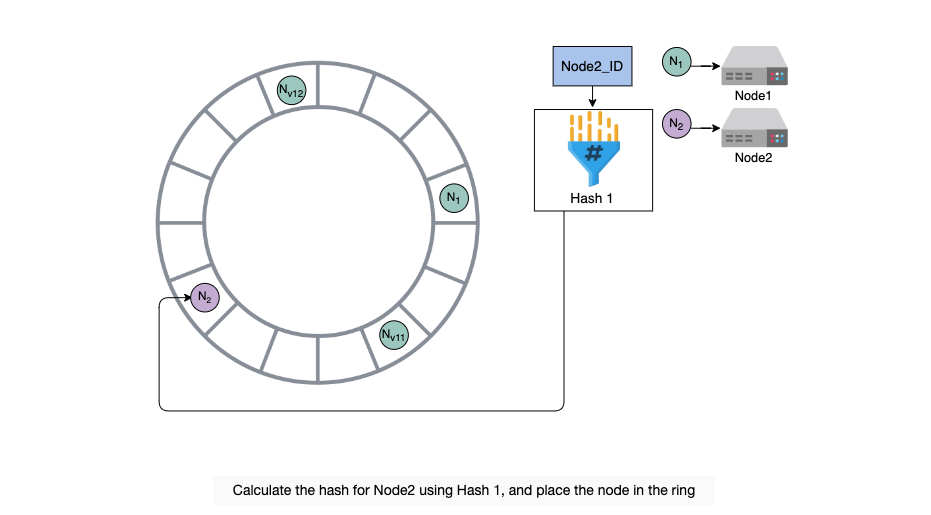
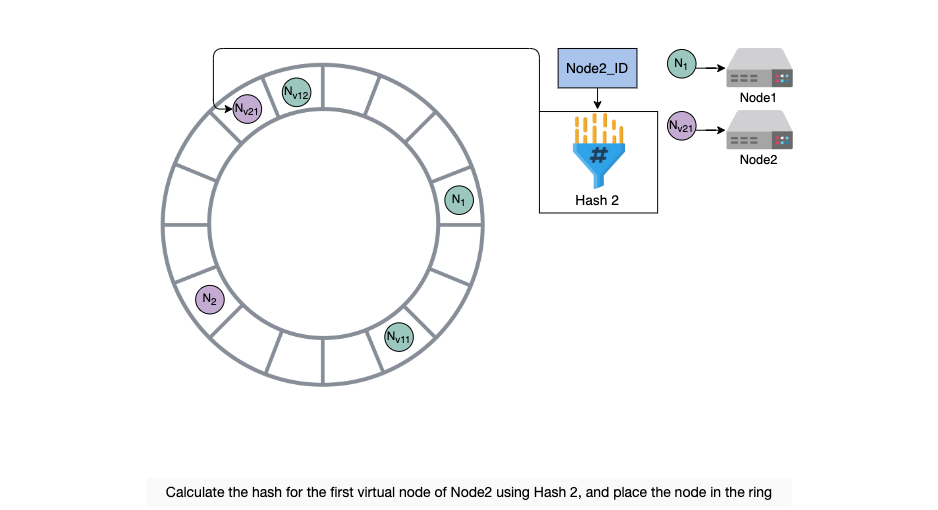
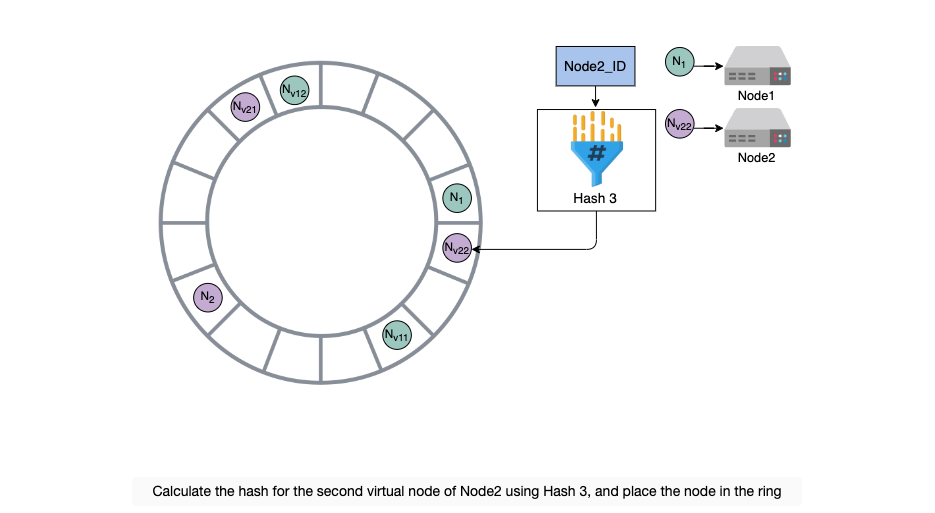
Мы будем использовать виртуальные узлы, чтобы обеспечить более равномерное распределение нагрузки между узлами. Вместо того чтобы применять одну хеш-функцию, мы применим несколько хеш-функций к одному и тому же ключу.
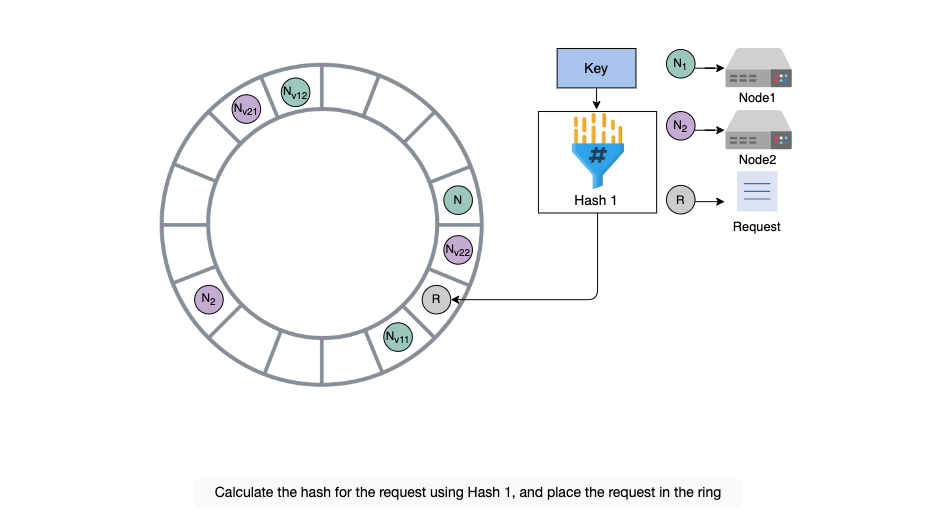
Рассмотрим пример. Предположим, у нас есть три хеш-функции. Для каждого узла мы вычисляем три хеша и размещаем их на кольце. Для запроса мы используем только одну хеш-функцию. В зависимости от того, куда запрос попадет на кольцо, он будет обработан следующим найденным узлом, двигаясь по часовой стрелке. Каждый сервер имеет три позиции, поэтому нагрузка запросов распределяется более равномерно. Более того, если узел имеет больше аппаратных ресурсов, чем другие, мы можем добавить больше виртуальных узлов, используя дополнительные хеш-функции. Таким образом, этот узел будет иметь больше позиций на кольце и обслуживать больше запросов.
Advantages of virtual nodes - Преимущества виртуальных узлов
Вот некоторые преимущества использования виртуальных узлов:
-
Равномерное распределение нагрузки: Если узел выходит из строя или проводится плановое обслуживание, нагрузка равномерно перераспределяется на другие узлы. Когда вновь доступный узел возвращается в сеть или добавляется в систему, другие узлы получают почти равную нагрузку.
-
Гетерогенность инфраструктуры: Каждый узел может самостоятельно решать, за сколько виртуальных узлов он будет отвечать, учитывая неоднородность физической инфраструктуры. Например, если у узла примерно в два раза больше вычислительных мощностей по сравнению с другими, он может брать на себя большую нагрузку.
Мы сделали предлагаемую архитектуру key-value хранилища масштабируемой. Следующая задача — сделать нашу систему высокодоступной.
Data replication - Репликация данных
Существуют различные методы репликации хранилища. Это может быть как первично-вторичная (primary-secondary) модель, так и одноранговая (peer-to-peer) модель.
Primary-secondary approach - Первично-вторичный подход
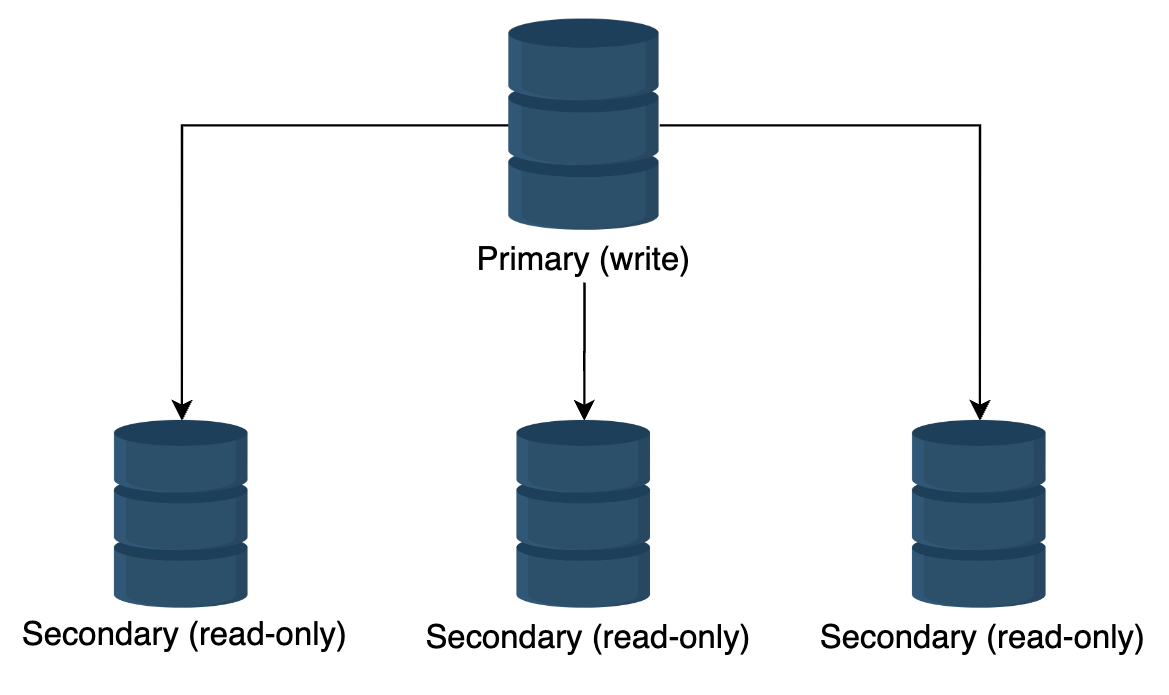
В первично-вторичном подходе одна из областей хранения является основной (primary), а остальные — вторичными (secondary). Вторичные области реплицируют свои данные с основной. Основная область обслуживает запросы на запись, в то время как вторичные области обслуживают запросы на чтение. После записи существует задержка для репликации. Кроме того, если основная область выходит из строя, запись в хранилище становится невозможной, и это создает единую точку отказа.
Does the primary-secondary approach fulfill the requirements of the key-value store that we defined in the System Design: The Key-value Store lesson?
Details
Answer
One of our requirements is that we need the ability to always write. This approach is good for the always read option. However, this approach doesn’t include the ability to always write because it will overload the primary storage. Moreover, if a primary server fails, we need to upgrade a secondary to a primary. The availability of write will suffer as we won’t allow writes during the switch-over time.Peer-to-peer approach - Одноранговый подход
В одноранговом подходе все задействованные области хранения являются первичными, и они реплицируют данные, чтобы оставаться актуальными. Чтение и запись разрешены на всех узлах. Обычно репликация на все n узлов неэффективна и затратна. Вместо этого часто выбирают репликацию на три или пять узлов.
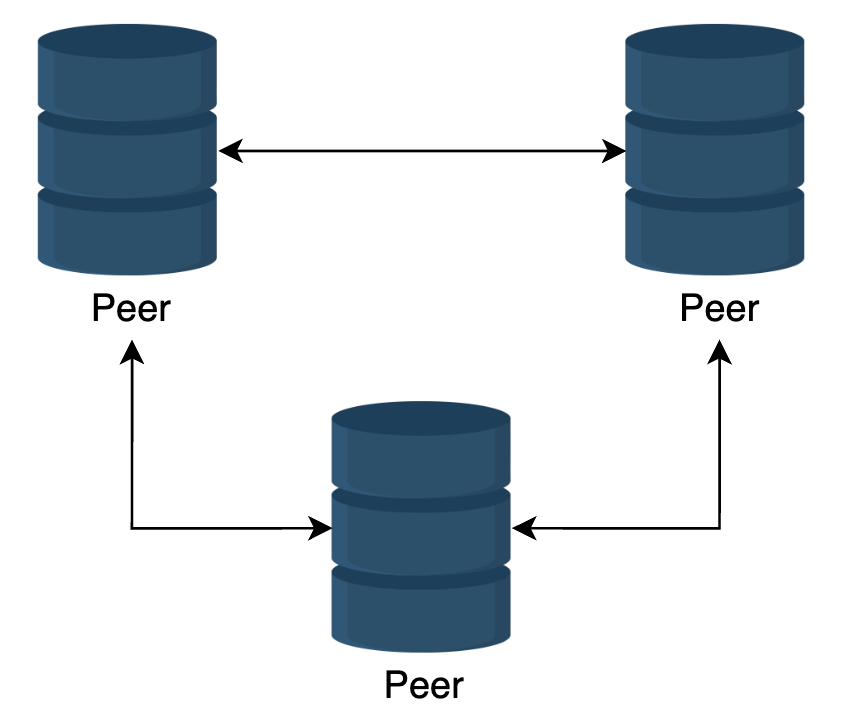
Peer-to-peer relationship - Одноранговые отношения
Мы будем использовать одноранговые отношения для репликации. Мы будем реплицировать данные на нескольких узлах для достижения долговечности и высокой доступности. Каждый элемент данных будет реплицирован на n узлах, где n — это параметр, настраиваемый для каждого экземпляра key-value хранилища. Например, если мы выберем n = 5, это значит, что наши данные будут реплицированы на пять узлов.
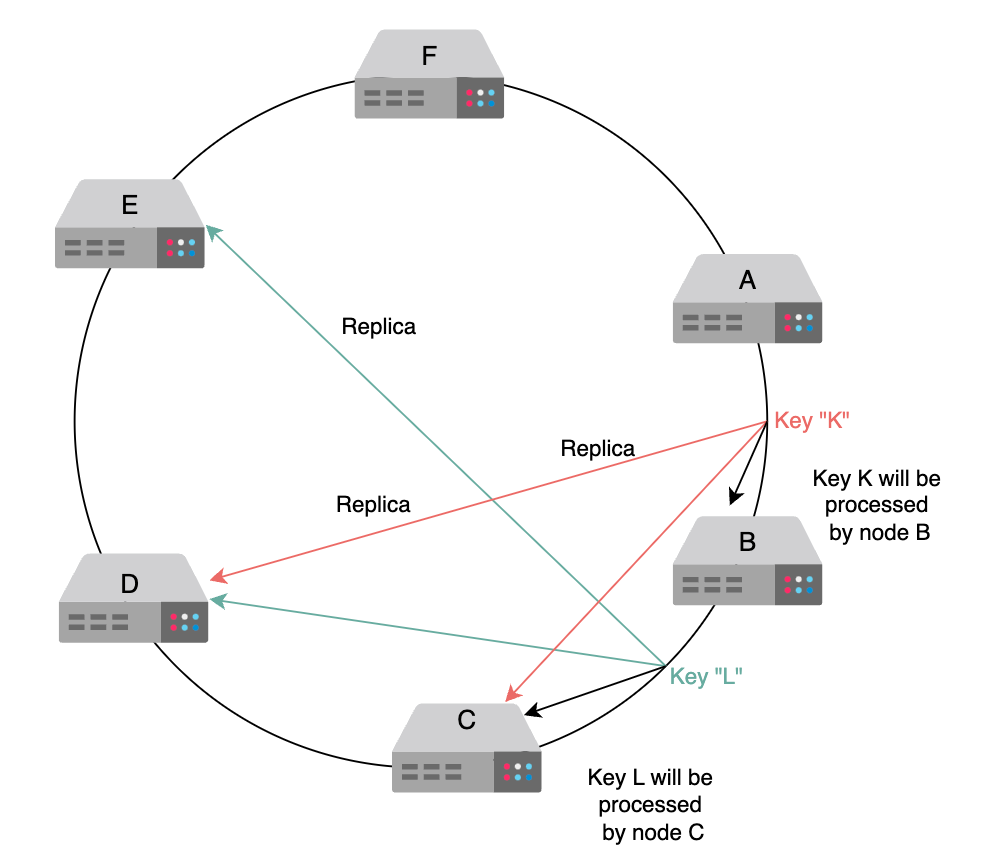
Каждый узел будет реплицировать свои данные на другие узлы. Узел, который обрабатывает операции чтения или записи, называется координатором. Он напрямую отвечает за ключи. Узел-координатору присваивается ключ “K”. Он также отвечает за репликацию ключей на n−1 последователей на кольце (по часовой стрелке). Эти списки последующих виртуальных узлов называются списками предпочтений (preference lists). Чтобы избежать размещения реплик на одних и тех же физических узлах, список предпочтений может пропускать те виртуальные узлы, физический узел которых уже находится в списке.
Рассмотрим иллюстрацию ниже. У нас установлен коэффициент репликации n = 3. Для ключа “K” репликация выполняется на следующих трех узлах: B, C и D. Аналогично, для ключа “L” репликация выполняется на узлах C, D и E.
What is the impact of synchronous or asynchronous replication?
Details
Answer
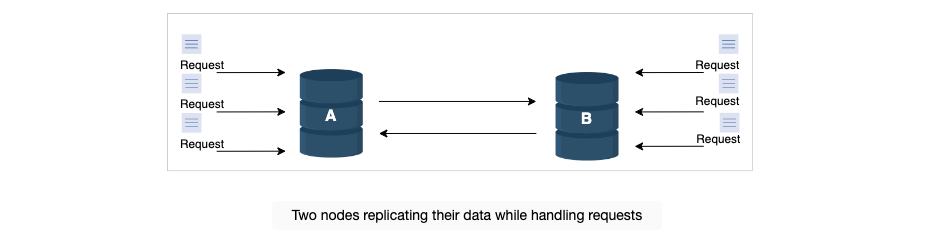
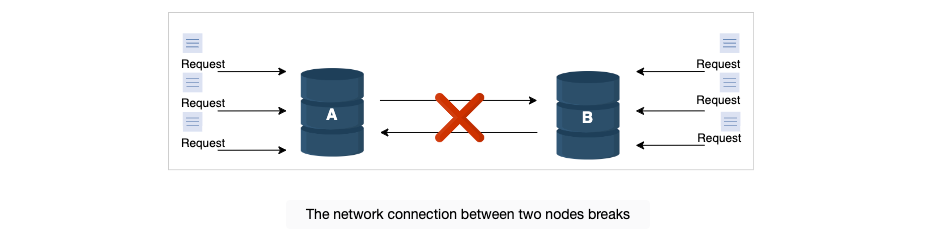
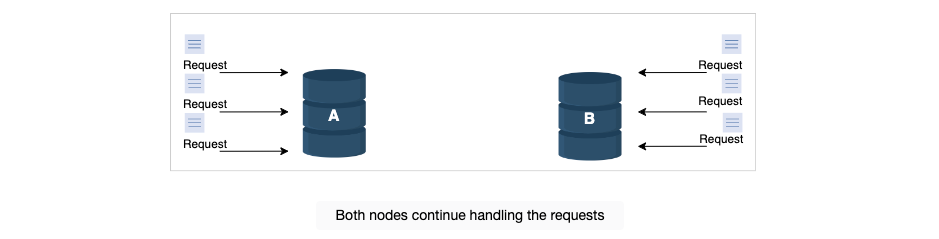
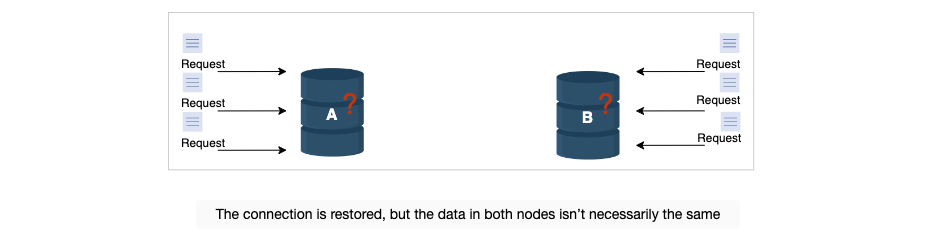
In synchronous replication, the speed of writing is slow because the data has to be replicated to all the nodes before acknowledging the user. It affects our availability, so we can’t apply it. When we opt for asynchronous replication, it allows us to do speedy writes to the nodes.В контексте теоремы CAP, key-value хранилища могут быть либо консистентными, либо доступными в случае сетевых разделений (partition). Для key-value хранилищ предпочтительнее выбирать доступность (availability) вместо консистентности (consistency). Это означает, что если два узла хранилища потеряли связь для репликации, они продолжат обрабатывать поступающие запросы, а когда соединение восстановится, они синхронизируются. В период отключения существует высокая вероятность, что данные на узлах будут неконсистентными. Поэтому нам необходимо разрешать такие конфликты. В следующем уроке мы изучим концепцию, которая поможет справляться с неконсистентностью с помощью версионирования данных.
Versioning Data and Achieving Configurability
Data versioning - Версионирование данных
Когда происходят сетевые разделения и сбои узлов во время обновления, история версий объекта может стать фрагментированной. В результате системе требуется усилие по согласованию версий. Необходимо создать механизм, который явно принимает возможность существования нескольких копий одних и тех же данных, чтобы избежать потери любых обновлений. Важно понимать, что некоторые сценарии сбоев могут привести к появлению нескольких копий одних и тех же данных в системе. Эти копии могут быть идентичными или различными. Разрешение конфликтов между этими разными версиями данных является важным и критическим шагом для обеспечения консистентности.
Handling inconsistency - Обработка неконсистентности
Чтобы справляться с неконсистентностью, необходимо поддерживать причинно-следственную связь между событиями. Один из способов сделать это — использовать метки времени и обновлять все конфликтующие значения на основе самого последнего запроса. Однако в распределенной системе время не является надежным фактором, поэтому его нельзя использовать в качестве решающего критерия.
Другой подход к поддержанию причинности — использование векторных часов (vector clocks). Векторные часы представляют собой список пар (узел, счетчик). Для каждой версии объекта существует свои векторные часы. Если два объекта имеют разные векторные часы, можно определить, связаны ли они причинно (подробнее об этом позже). Пока одно из изменений не будет согласовано, оба изменения считаются конфликтующими.
Modify the API design - Модификация дизайна API
Мы обсудили, как можно определить, связаны ли два события причинно с использованием векторных часов. Для этого нам нужна информация о том, какой узел выполнил операцию, и каково было значение его векторных часов. Это называется контекстом операции. Поэтому мы изменим дизайн нашего API следующим образом.
API вызов для получения значения должен выглядеть так:
get(key)

Мы возвращаем объект или набор конфликтующих объектов вместе с контекстом. Контекст содержит закодированные метаданные об объекте, включая такие детали, как версия объекта.
API вызов для записи значения в систему должен выглядеть так:
put(key, context, value)
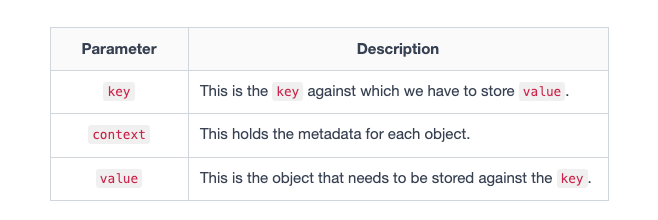
Функция находит узел, на котором должно быть размещено значение на основе ключа, и сохраняет связанное с ним значение. Контекст возвращается системой после операции get. Если в контексте есть список объектов, вызвавших конфликт, мы попросим клиента разрешить этот конфликт.
Чтобы обновить объект в key-value хранилище, клиент должен предоставить контекст. Мы определяем информацию о версии, используя векторные часы, предоставив контекст из предыдущей операции чтения. Если key-value хранилище имеет доступ к нескольким ветвям, оно предоставляет все объекты на конечных узлах дерева, вместе с соответствующей версионной информацией в контексте, при обработке запроса на чтение. Согласование различных версий и их объединение в одну новую версию рассматривается как обновление.
Примечание: Этот процесс разрешения конфликтов аналогичен тому, как это делается в Git. Если Git может объединить несколько версий в одну, слияние выполняется автоматически. Если автоматическое разрешение конфликта невозможно, клиент (разработчик) должен разрешить конфликт вручную. Аналогичным образом, наша система может попытаться выполнить автоматическое разрешение конфликта и, если это невозможно, запросить у приложения окончательное разрешенное значение.
Vector clock usage example - Пример использования векторных часов
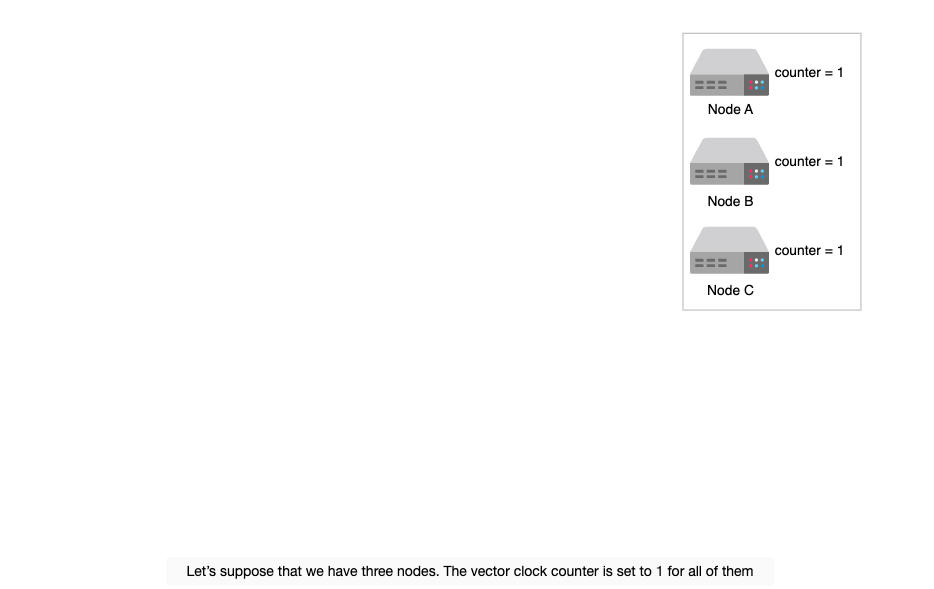
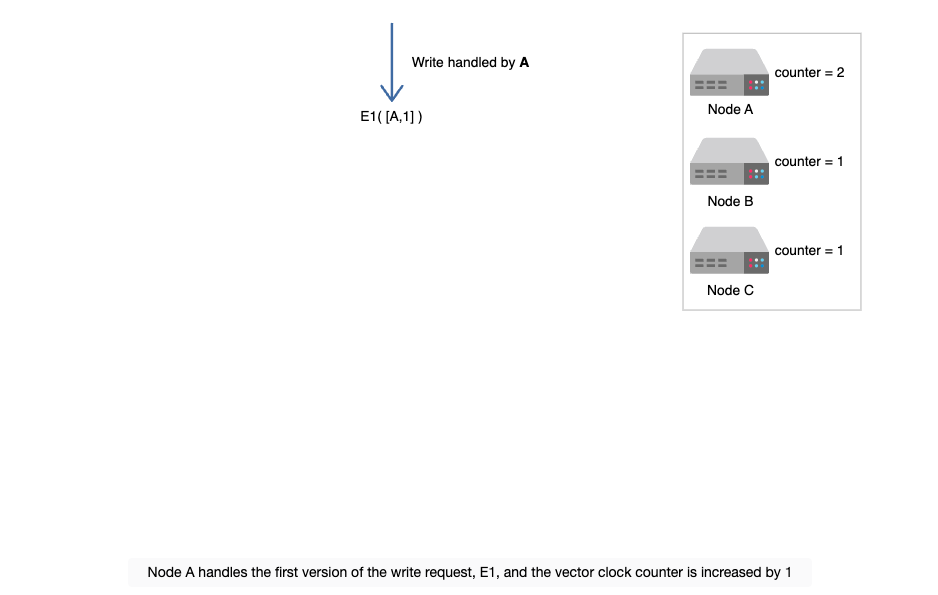
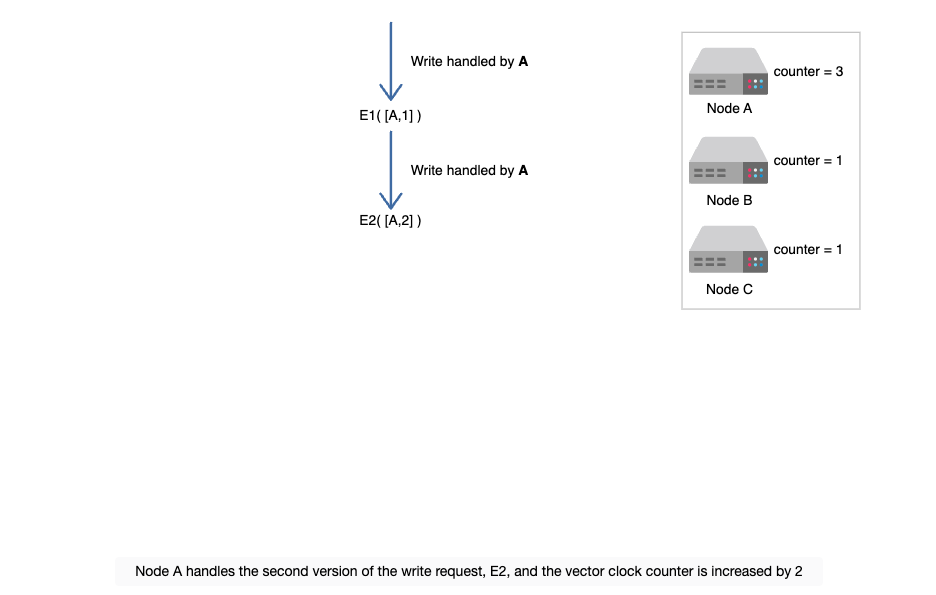
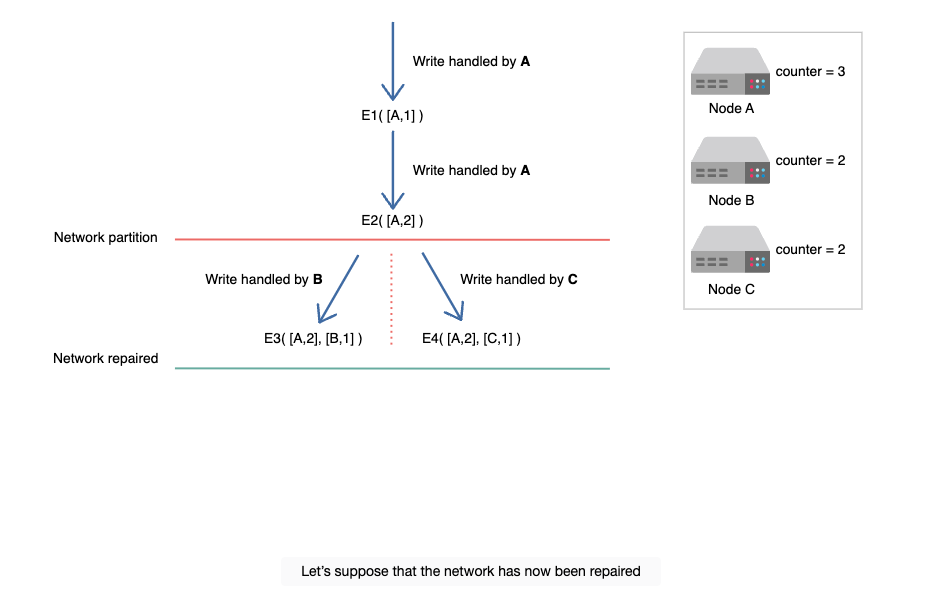
Рассмотрим пример. Предположим, у нас есть запрос на запись. Узел A обрабатывает первую версию запроса на запись, E1 (где E обозначает событие). Соответствующие векторные часы содержат информацию об узле и его счетчик — то есть [A,1]. Узел A обрабатывает еще одну запись для того же объекта, для которого была выполнена предыдущая запись. Итак, для E2 у нас есть [A,2]. E1 больше не требуется, поскольку E2 было обновлено на том же узле. E2 считывает изменения, внесенные E1, а затем вносятся новые изменения.
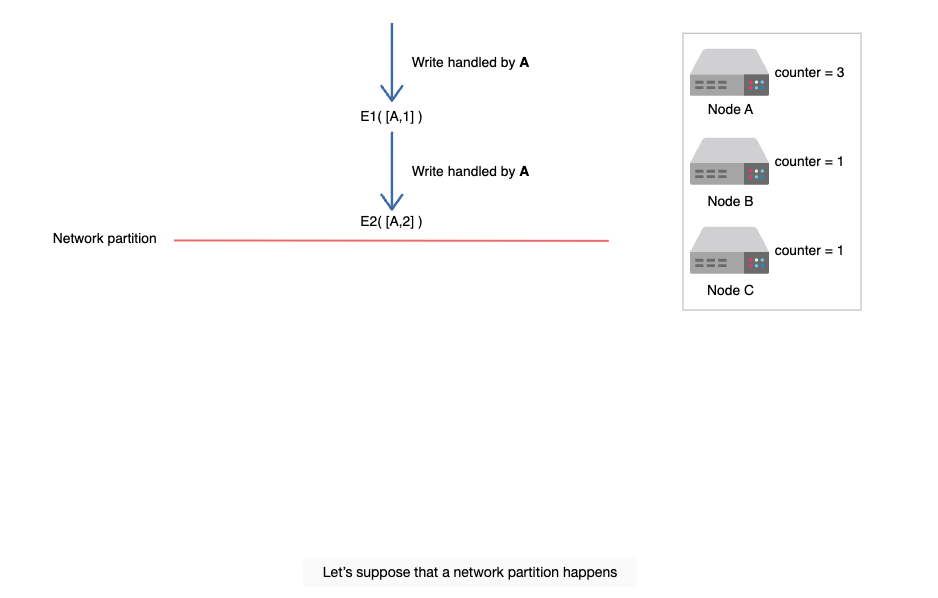
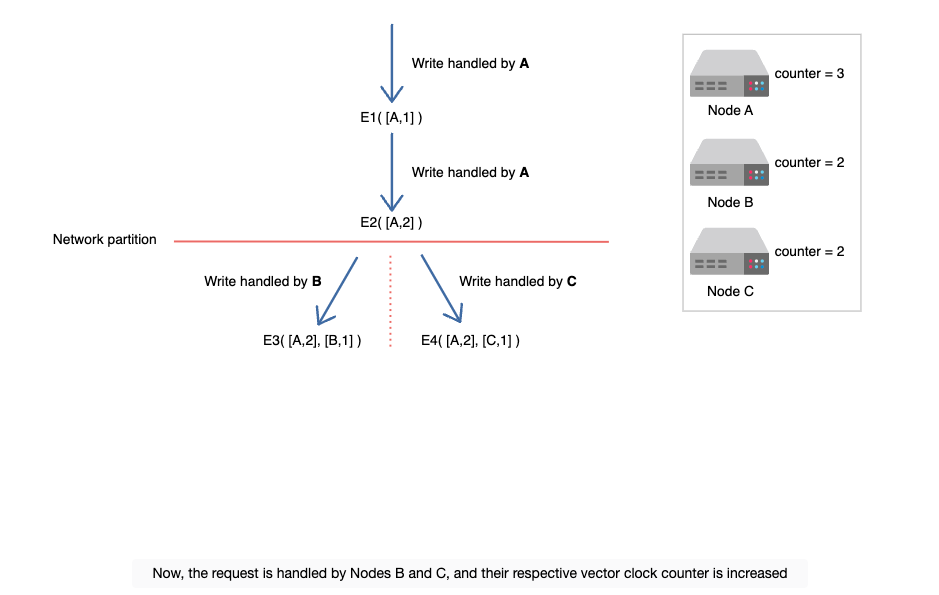
Предположим, происходит сетевое разделение. Теперь запрос обрабатывается двумя разными узлами, B и C. В системе теперь находятся контексты с обновленными версиями E3, E4 и их соответствующими часами: ([A,2],[B,1]) и ([A,2],[C,1]).
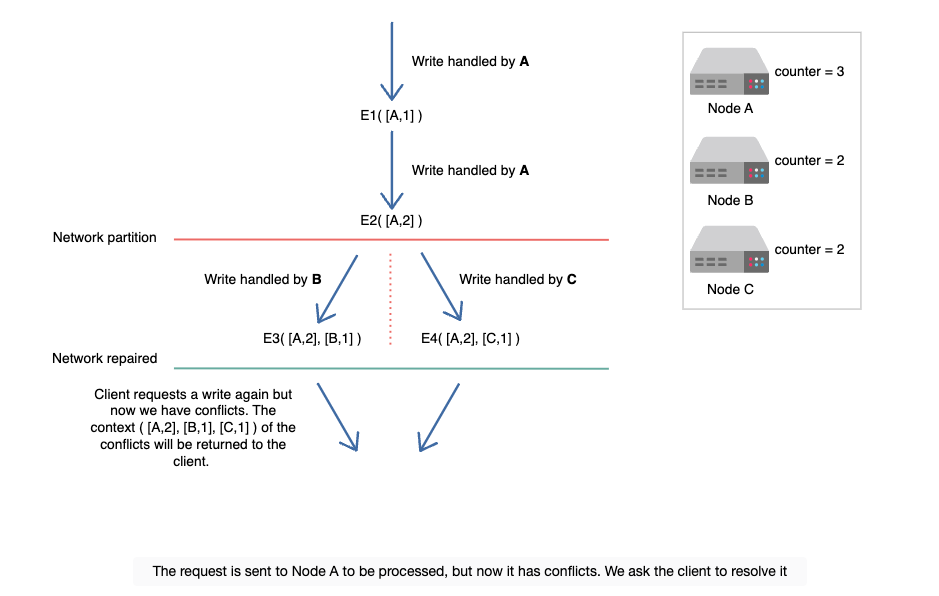
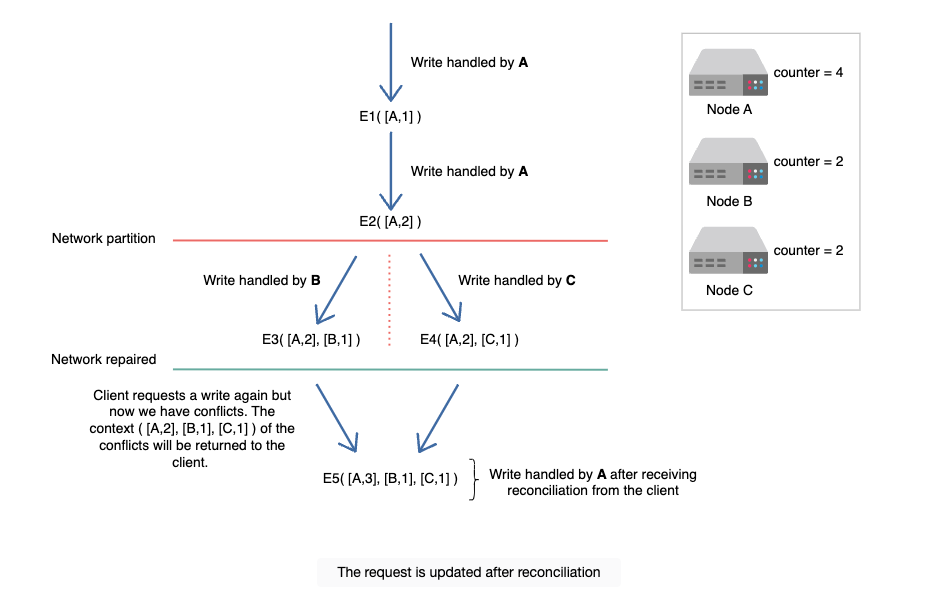
Допустим, сетевое разделение устранено, и клиент снова запрашивает запись, но теперь у нас есть конфликты. Контекст ([A,2],[B,1],[C,1]) конфликта возвращается клиенту. После того как клиент выполнит согласование, и узел A координирует запись, у нас будет E5 с часами ([A,3],[B,1],[C,1]).
Compromise with vector clocks limitations - Компромиссы с ограничениями векторных часов
Размер векторных часов может увеличиваться, если несколько серверов одновременно записывают данные в один и тот же объект. Это редко случается на практике, так как записи обычно обрабатываются одним из топовых n узлов в списке предпочтений.
Например, если произошли сетевые разделения или несколько серверов вышли из строя, запросы на запись могут быть обработаны узлами, не входящими в топ n узлов в списке предпочтений. В результате у нас может появиться длинная версия истории, например: ([A,10],[B,4],[C,1],[D,2],[E,1],[F,3],[G,5],[H,7],[I,2],[J,2],[K,1],[L,1]). Хранить и поддерживать такую длинную историю версий неудобно.
Мы можем ограничить размер векторных часов в таких ситуациях. Для этого используем стратегию усечения (truncation), чтобы хранить метку времени с каждой парой (узел, счетчик), показывая, когда узел в последний раз обновлял элемент данных. Пары в векторных часах очищаются, когда количество пар превышает заранее определенный порог (например, 10). Поскольку невозможно точно вычислить причинно-следственные связи при таком усечении, этот подход может снизить эффективность согласования версий.
The get and put operations - Операции get и put
Одно из наших функциональных требований — система должна быть конфигурируемой. Мы хотим контролировать компромиссы между доступностью, консистентностью, экономической эффективностью и производительностью. Давайте добьемся конфигурируемости, реализовав базовые функции get и put для key-value хранилища.
Каждый узел в нашей системе может обрабатывать операции get (чтение) и put (запись). Узел, обрабатывающий операцию чтения или записи, называется координатором. Координатор — это первый узел среди топ n узлов в списке предпочтений.
Есть два способа, как клиент может выбрать узел:
- Мы направляем запрос на общий балансировщик нагрузки.
- Мы используем клиентскую библиотеку, осведомленную о партициях, которая направляет запросы непосредственно на соответствующие узлы-координаторы.
Оба подхода имеют свои преимущества. В первом подходе клиент не связан с кодом, тогда как во втором достигается меньшая задержка. Задержка меньше из-за сокращенного числа переходов, поскольку клиент может напрямую обращаться к конкретному серверу.
Давайте сделаем наш сервис конфигурируемым, предоставив возможность контролировать компромиссы между доступностью, консистентностью, экономической эффективностью и производительностью. Мы можем использовать протокол консистентности, аналогичный тем, которые используются в системах кворума.
Example: Configurability with n, r, and w
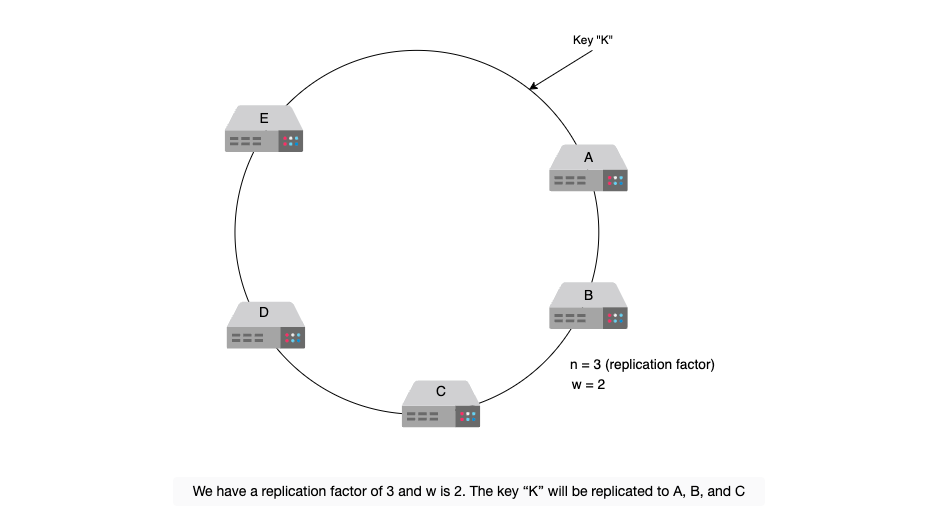
Рассмотрим пример. Пусть n в топ n списка предпочтений равно 3. Это означает, что необходимо поддерживать три копии данных. Предположим, что узлы расположены в кольце. Пусть A, B, C, D и E — это узлы, расположенные по часовой стрелке в кольце. Если функция записи выполняется на узле A, то копии этих данных будут размещены на узлах B и C. Это потому, что B и C — следующие узлы, которые мы находим, двигаясь по часовой стрелке.
Использование переменных r и w
Теперь рассмотрим две переменные, r и w. r означает минимальное количество узлов, которое должно участвовать в успешной операции чтения, а w — минимальное количество узлов, участвующих в успешной операции записи. Если r=2, это значит, что наша система будет читать данные с двух узлов, если они хранятся на трех узлах. Нам нужно выбрать значения r и w так, чтобы хотя бы один узел был общим для них. Это гарантирует, что читатели смогут получить последнее записанное значение. Для этого мы будем использовать систему, подобную кворуму, установив r+w>n.
В следующей таблице показано, как значения n, r и w влияют на скорость операций чтения и записи:
| n | r | w | Описание |
|---|---|---|---|
| 3 | 2 | 1 | Недопустимо, так как нарушает наше ограничение r + w > n. |
| 3 | 2 | 2 | Допустимо, так как выполняет ограничение. |
| 3 | 3 | 1 | Обеспечивает быструю запись и медленное чтение, так как читатели должны обращаться ко всем n репликам за значением. |
| 3 | 1 | 3 | Обеспечивает быстрое чтение с любого узла, но медленную запись, так как теперь нам нужно синхронно записывать данные на все n узлов. |
Допустим, n=3, что означает, что у нас есть три узла, на которые копируются данные. Теперь, если w=2, операция гарантирует запись на два узла для успешного выполнения запроса. Для третьего узла данные обновляются асинхронно.
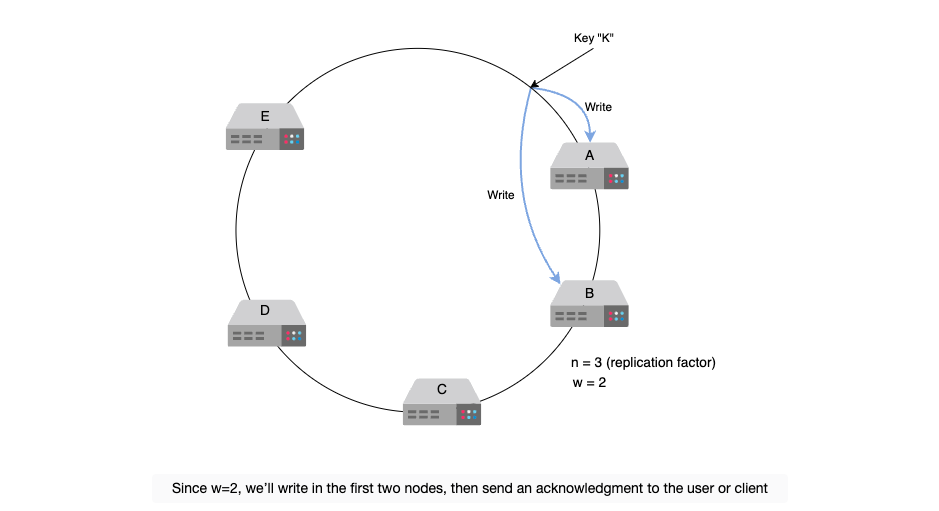
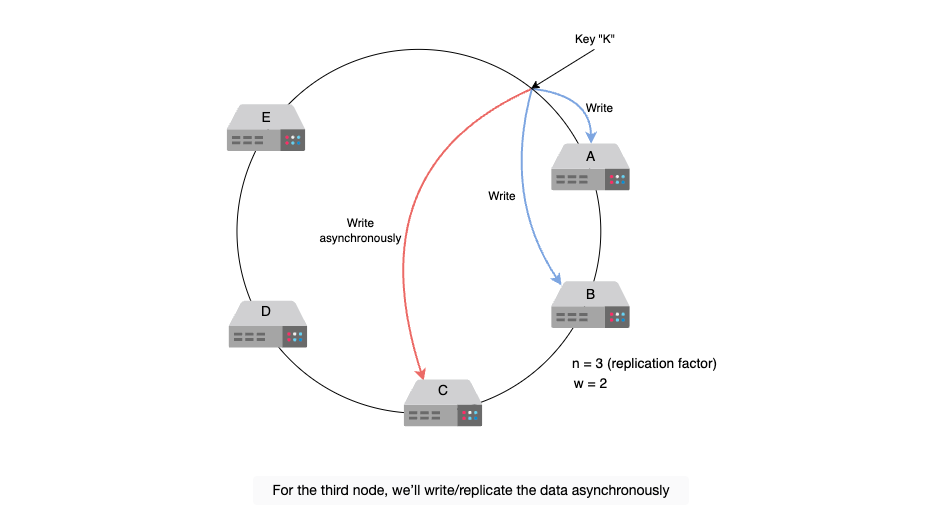
В этой модели задержка операции get определяется самым медленным из r реплик. Это происходит потому, что при большом значении r мы сосредотачиваемся больше на доступности, жертвуя консистентностью.
Координатор создает векторные часы для новой версии и записывает новую версию локально после получения запроса put() для ключа. Координатор отправляет обновленную версию и новые векторные часы на n узлов с наивысшим рейтингом. Запись считается успешной, если по крайней мере w−1 узел отвечает. Помните, что координатор сначала записывает на себя, поэтому в общей сложности у нас получается w записей.
Запросы на операцию get() отправляются на n узлов с самым высоким рейтингом, доступных в списке предпочтений для данного ключа. Они ожидают r ответов перед тем, как вернуть результаты клиенту. Координаторы возвращают все версии данных, которые они считают несвязанными (истории с расхождениями, требующие согласования), если получают несколько наборов данных из одного источника. Конфликтующие версии затем объединяются, и значение ключа перезаписывается для замены предыдущих версий.
К настоящему моменту мы выполнили требования по масштабируемости, доступности, разрешению конфликтов и конфигурируемости сервиса. Последнее требование — обеспечить отказоустойчивость системы. Давайте обсудим, как мы это достигнем в следующем уроке.
Включить отказоустойчивость и обнаружение сбоев - Enable Fault Tolerance and Failure Detection
Handle temporary failures - Обработка временных сбоев
В распределенных системах обычно используется подход на основе кворума для обработки сбоев. Кворум — это минимальное количество голосов, необходимое для выполнения распределенной транзакции. Если сервер участвует в консенсусе и выходит из строя, то мы не можем выполнить необходимую операцию, что влияет на доступность и долговечность нашей системы.
Мы будем использовать слоппи-кворум (sloppy quorum) вместо строгого членства в кворуме. Обычно лидер управляет взаимодействием между участниками консенсуса. Участники отправляют подтверждение после успешной записи. Получив эти подтверждения, лидер отвечает клиенту. Однако недостаток в том, что участники легко подвержены сетевым сбоям. Если лидер временно выходит из строя и участники не могут его достичь, они объявляют лидера мертвым. Теперь необходимо переизбрать нового лидера. Такие частые выборы негативно влияют на производительность, так как система тратит больше времени на выбор лидера, чем на выполнение реальной работы.
В слоппи-кворуме первые n здоровых узлов из списка предпочтений обрабатывают все операции чтения и записи. Эти n здоровых узлов могут не всегда быть первыми n узлами, обнаруженными при движении по часовой стрелке в кольце консистентного хеширования.
Рассмотрим следующую конфигурацию с n=3. Если узел A временно недоступен или не достижим во время операции записи, запрос отправляется на следующий здоровый узел из списка предпочтений, которым в данном случае является узел D. Это обеспечивает желаемую доступность и долговечность. После обработки запроса узел D включает подсказку о том, какой узел был предназначенным получателем (в данном случае A). Как только узел A снова станет доступным, узел D отправляет информацию о запросе на A, чтобы он мог обновить свои данные. После завершения передачи данных D удаляет этот элемент из своего локального хранилища, не влияя на общее количество реплик в системе.
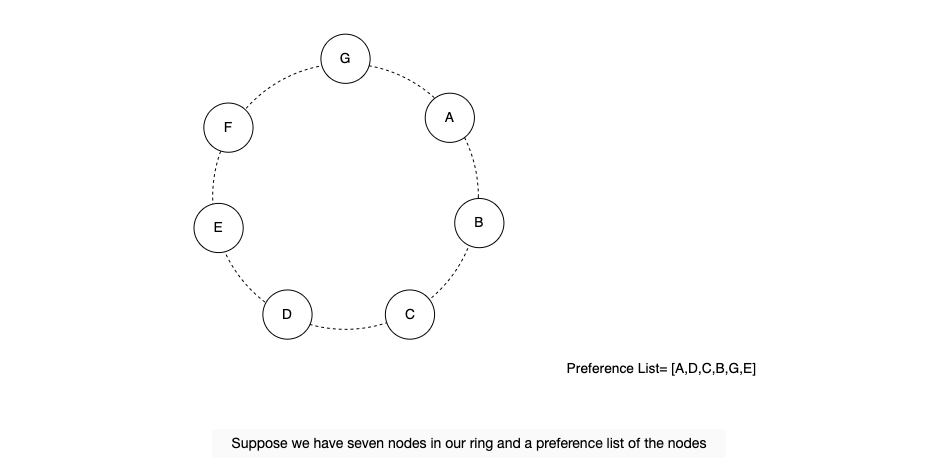
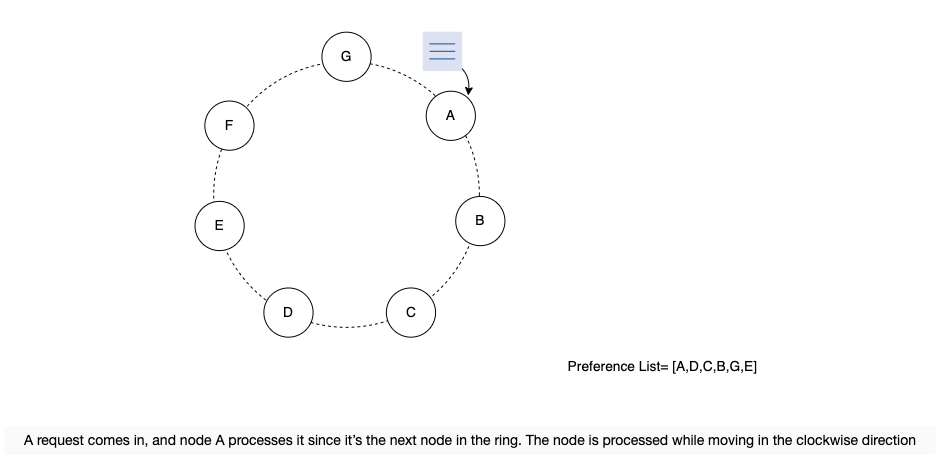
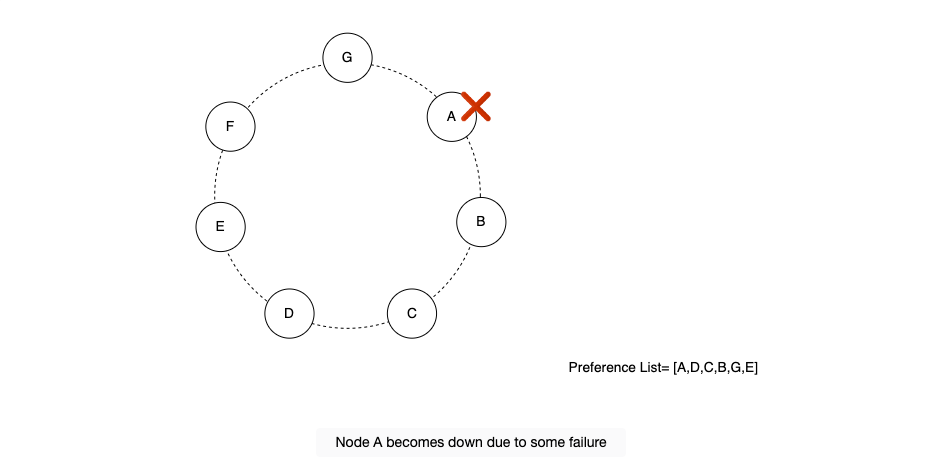
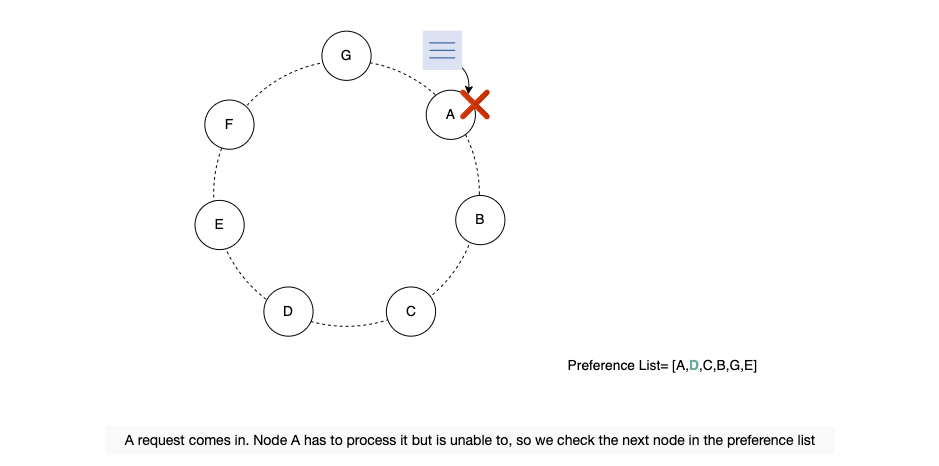
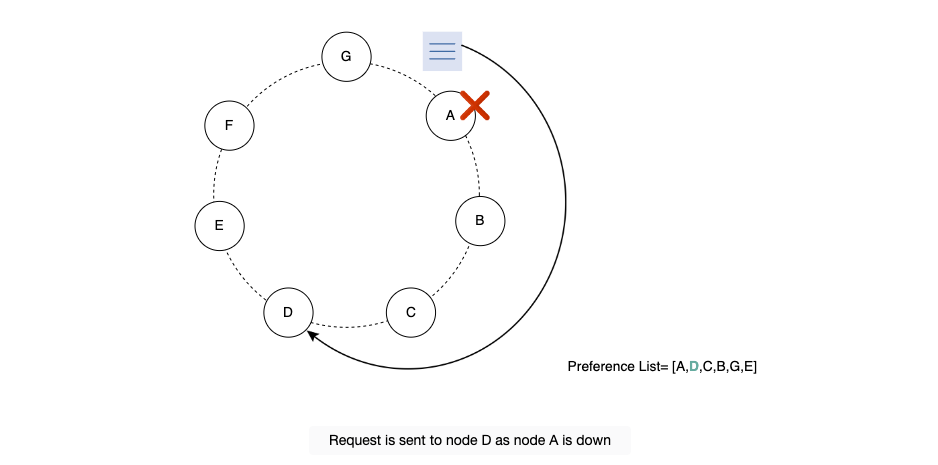
Этот подход называется hinted handoff. С его помощью мы можем гарантировать выполнение операций чтения и записи, даже если узел сталкивается с временным сбоем.
Примечание: Высокодоступная система хранения данных должна уметь справляться с отказом дата-центра из-за перебоев с электричеством, отказов систем охлаждения, сетевых сбоев или природных катастроф. Для этого необходимо обеспечить репликацию данных между дата-центрами. Таким образом, если один дата-центр выходит из строя, его данные можно восстановить из другого.
What are the limitations of using hinted handoff?
Details
Answer
A minimal churn in system membership and transient node failures are ideal for hinted handoff. However, hinted replicas may become unavailable before being restored to the originating replica node in certain circumstances.Handle permanent failures - Обработка постоянных сбоев
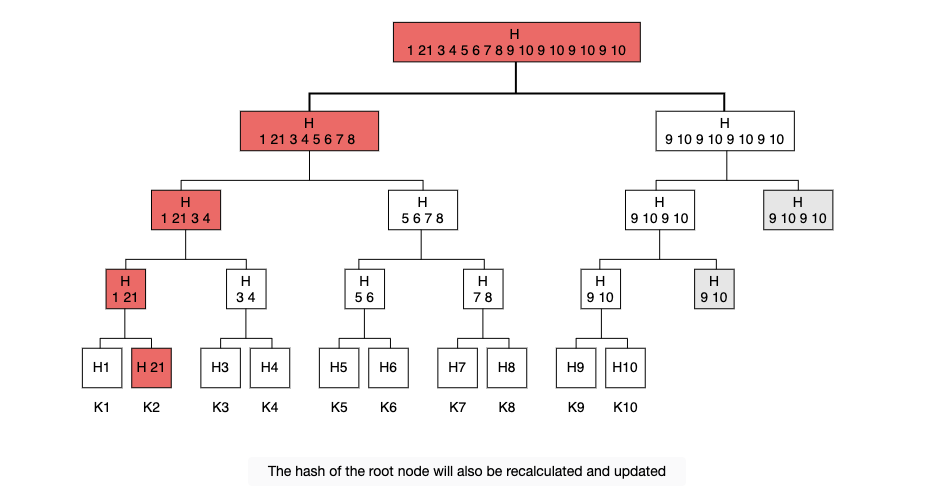
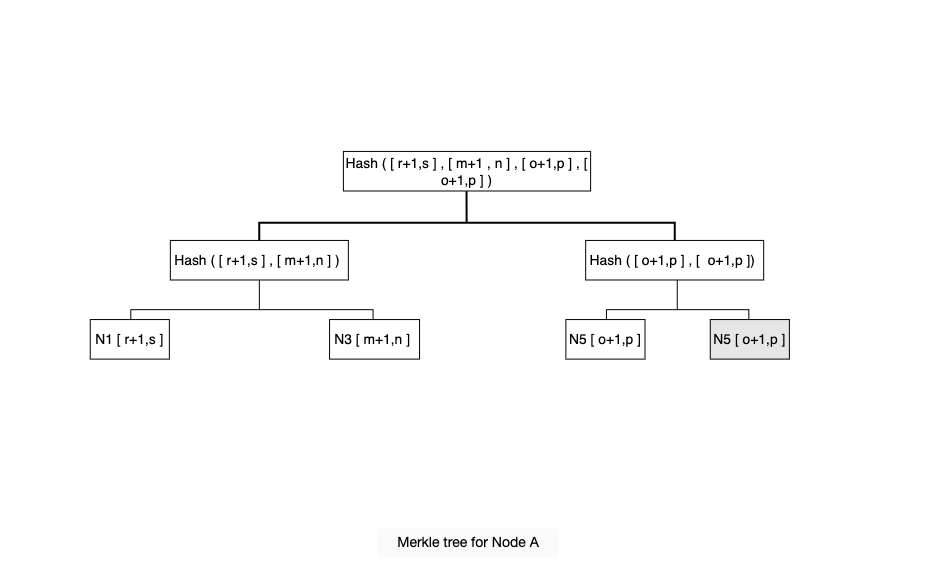
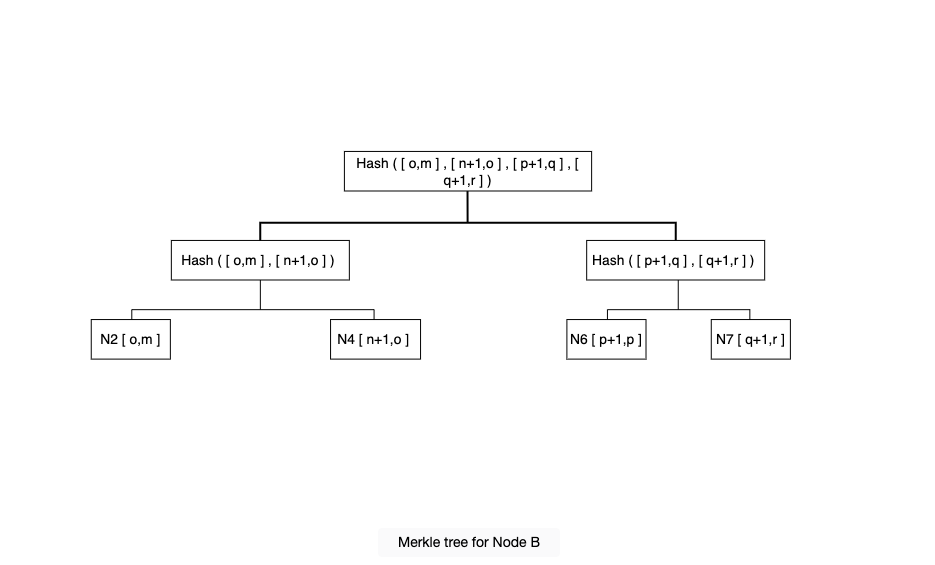
В случае постоянных сбоев узлов мы должны поддерживать синхронизацию реплик, чтобы сделать систему более надежной. Нам нужно ускорить обнаружение несоответствий между репликами и уменьшить объем передаваемых данных. Для этого мы будем использовать деревья Меркла (Merkle trees).
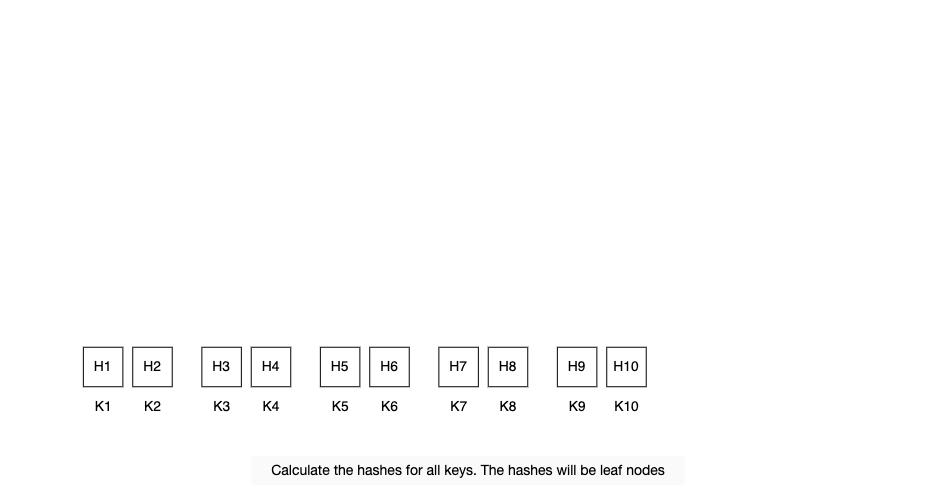
В дереве Меркла значения отдельных ключей хэшируются и используются в качестве листьев дерева. Хэши их дочерних элементов находятся в узлах-родителях, расположенных выше в дереве. Каждая ветвь дерева Меркла может быть проверена независимо, без необходимости загружать все дерево или весь набор данных. При проверке несоответствий между копиями деревья Меркла уменьшают объем данных, которые необходимо обменять. Например, синхронизация не требуется, если хэш-значения корней двух деревьев одинаковы, как и их листовые узлы. До тех пор, пока процесс не достигнет листьев дерева, узлы могут идентифицировать ключи, которые не синхронизированы, когда узлы обмениваются хэш-значениями дочерних элементов. Дерево Меркла — это механизм для реализации антиэнтропии (anti-entropy), который означает поддержание всех данных в согласованном состоянии. Оно сокращает объем данных, передаваемых для синхронизации, и количество дисков, к которым осуществляется доступ в процессе антиэнтропии.
Следующие слайды объясняют, как работают деревья Меркла:
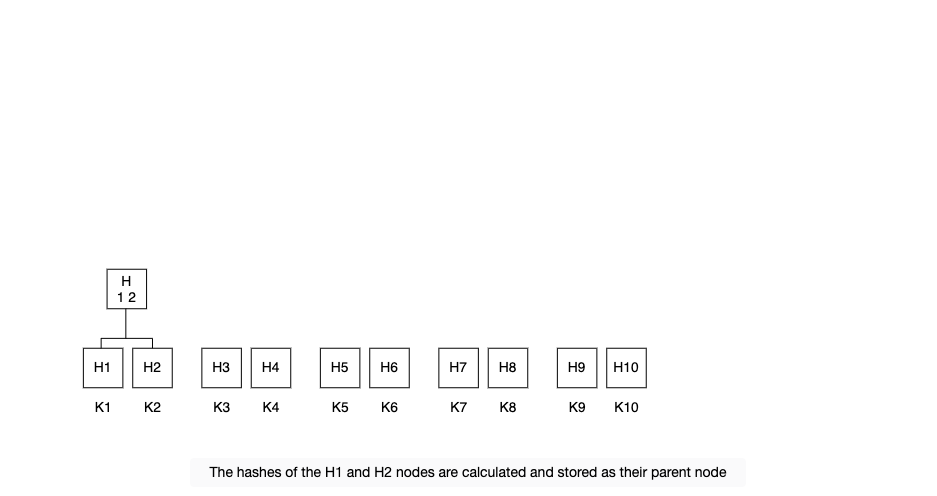
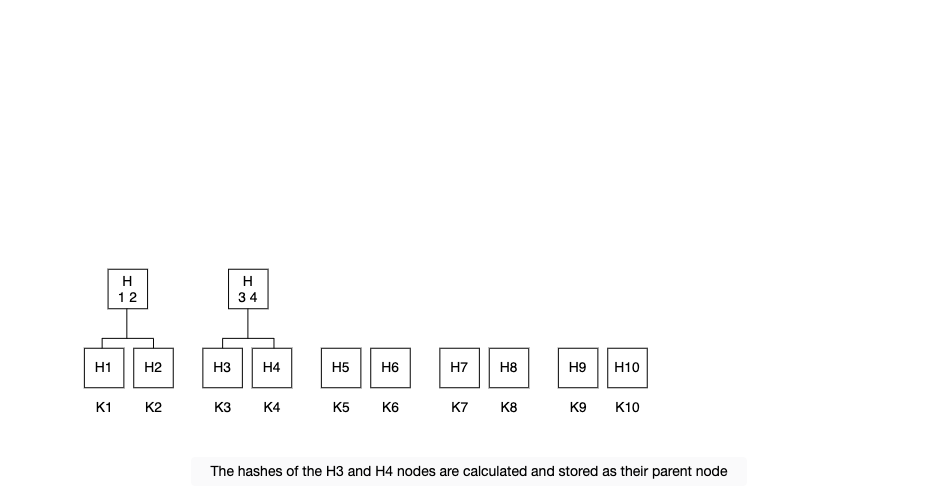
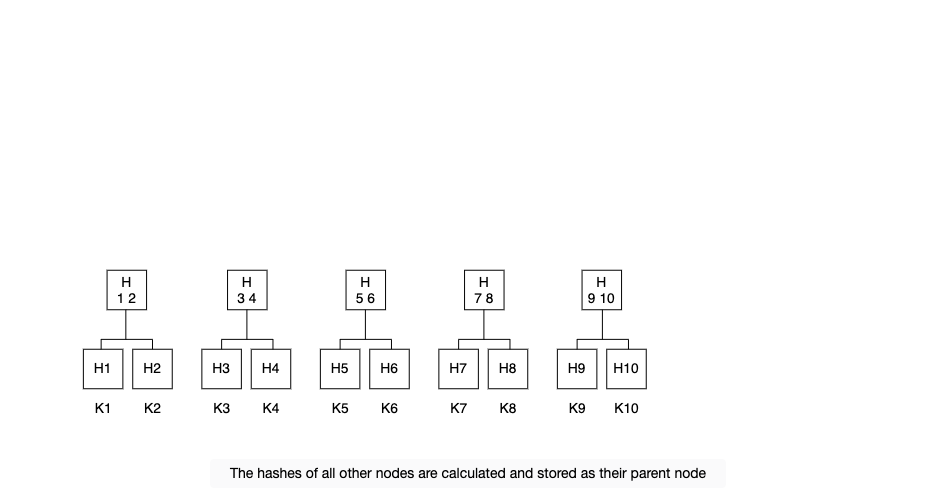
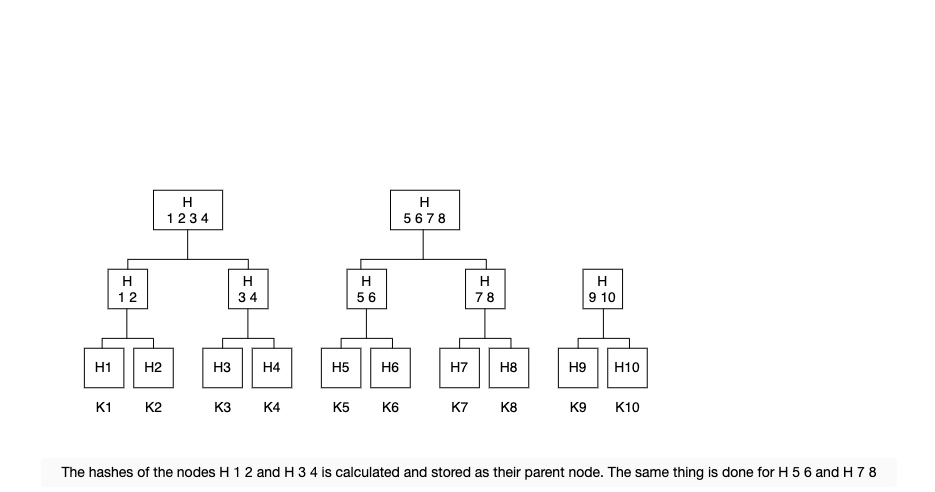
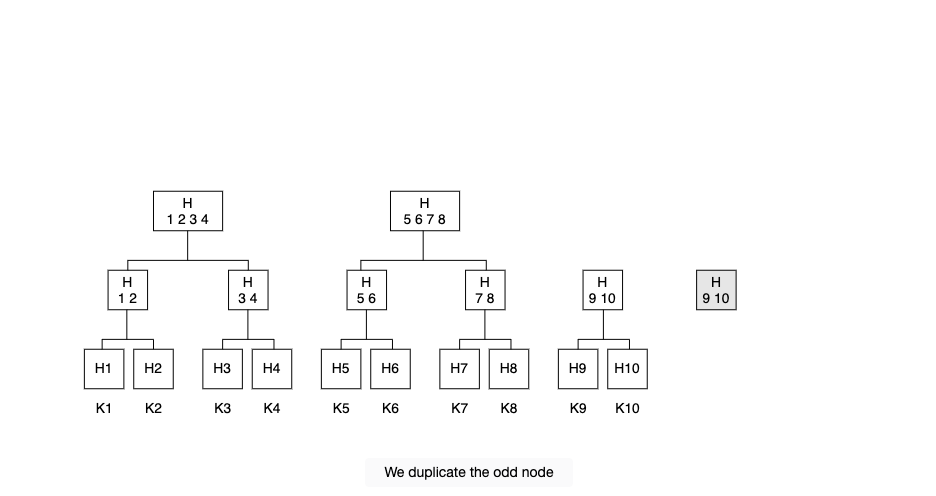
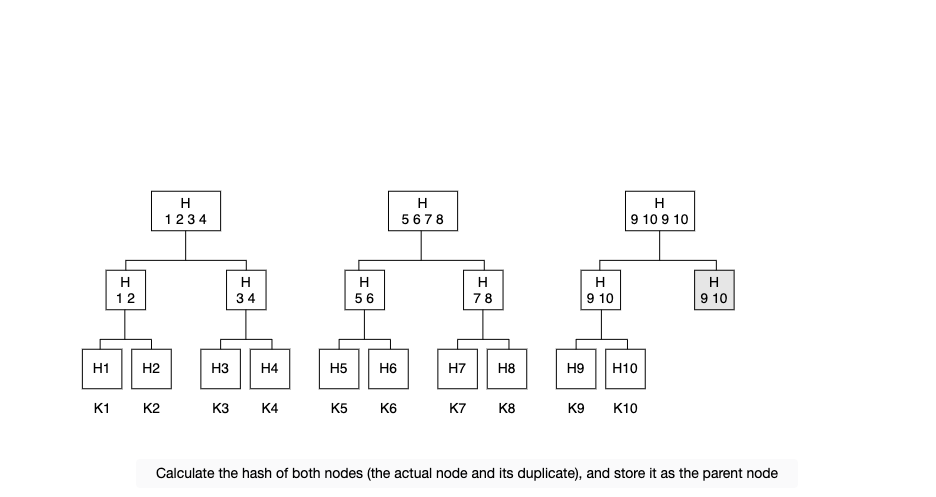
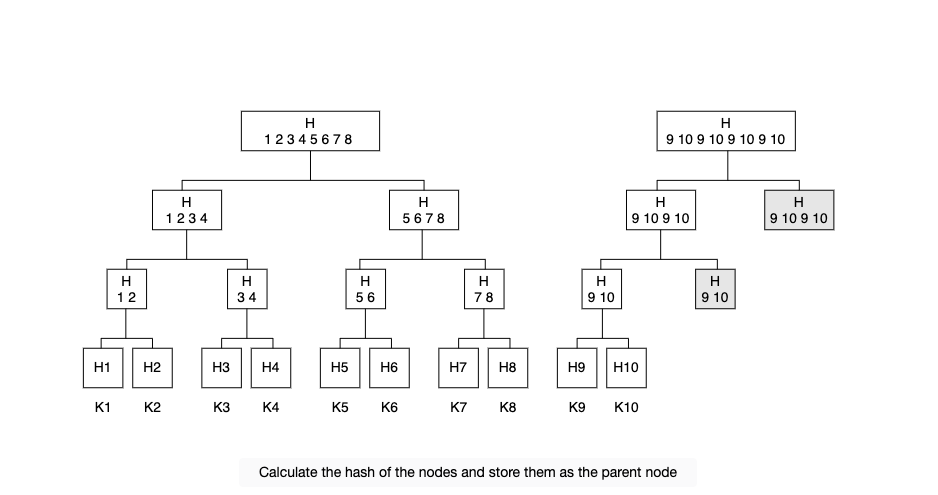
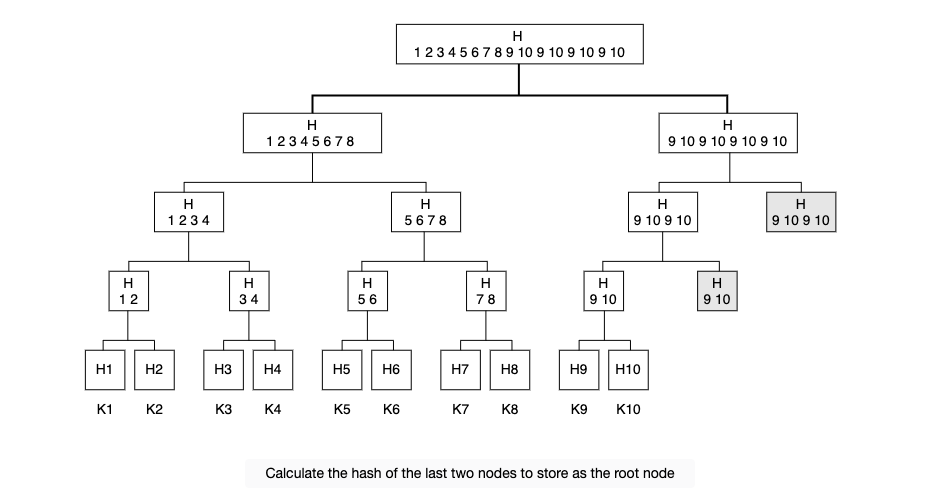
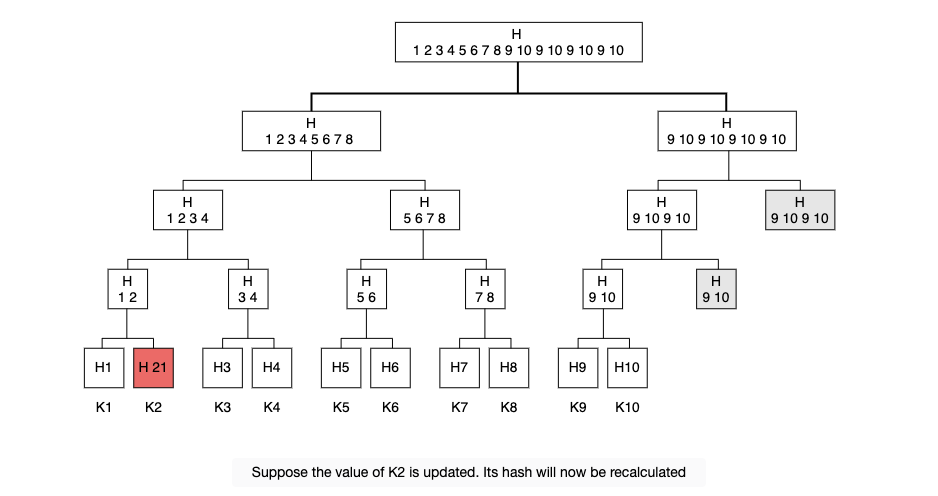
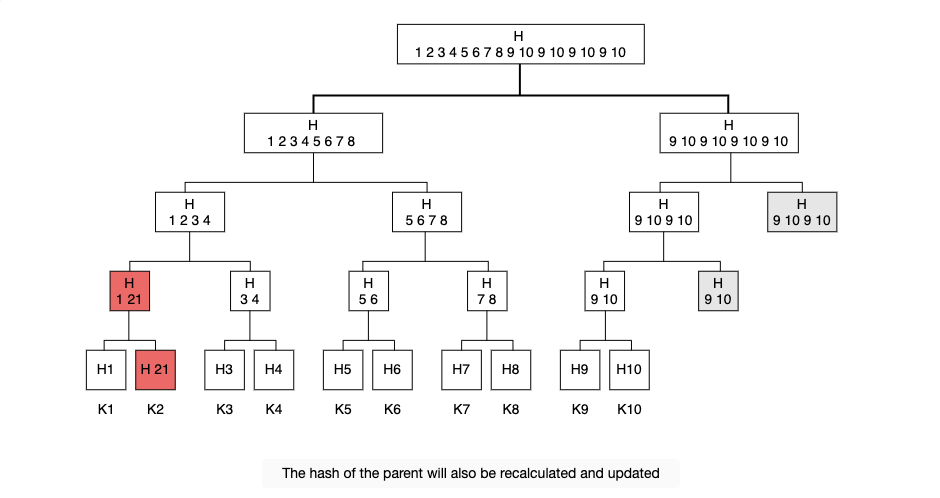
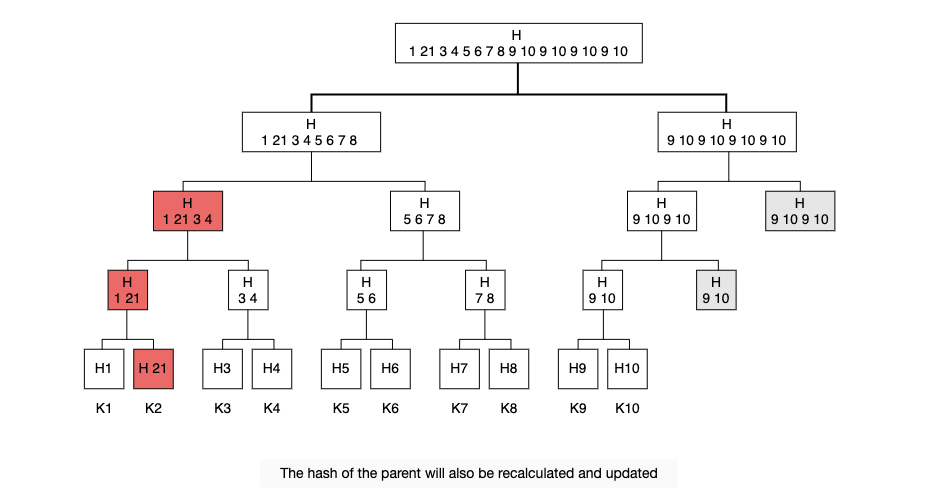
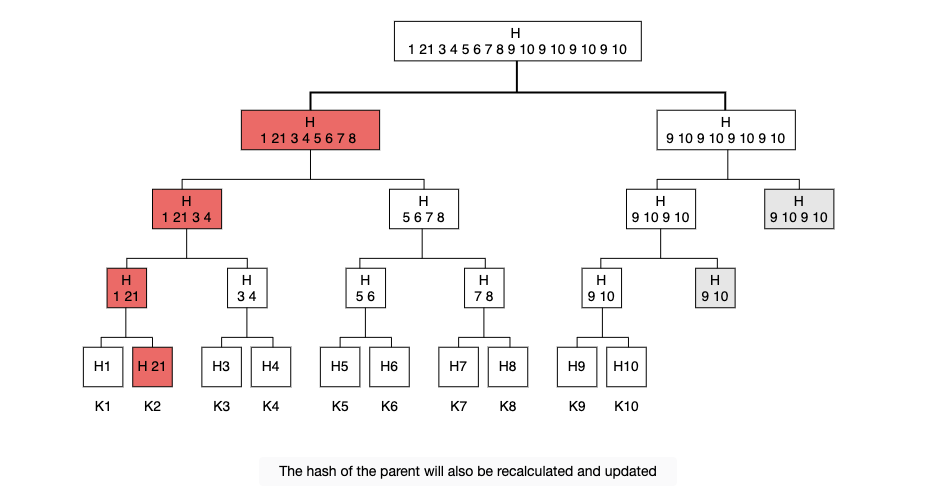
Anti-entropy with Merkle trees - Антиэнтропия с деревьями Меркла
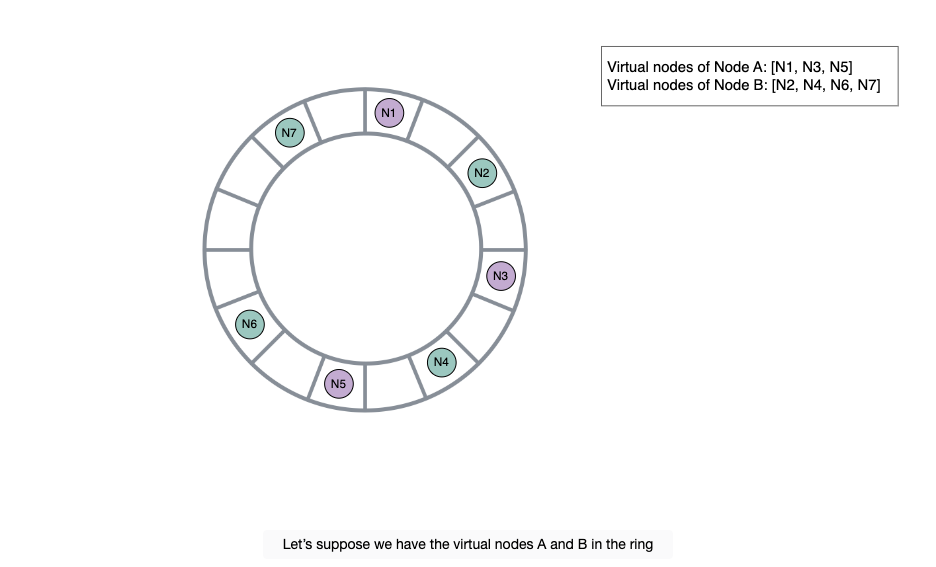
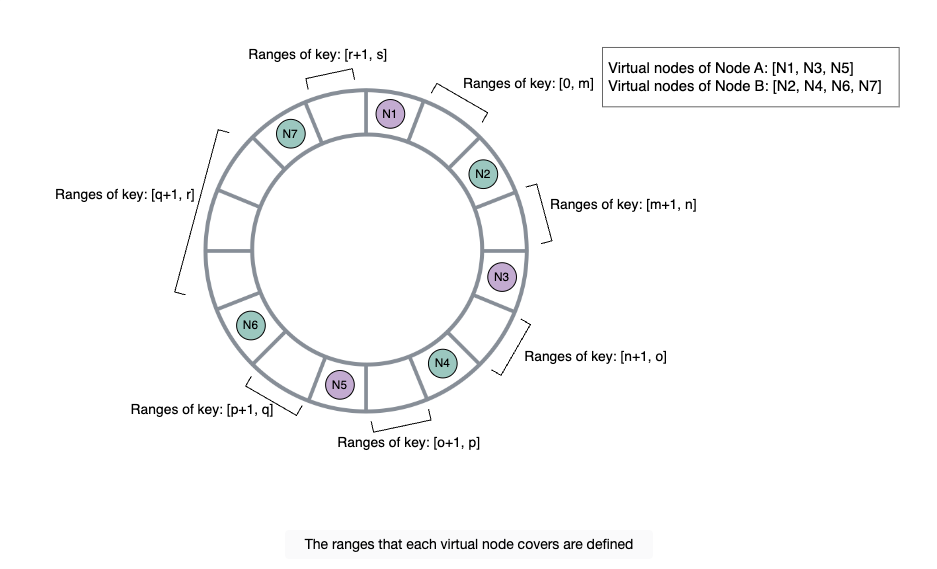
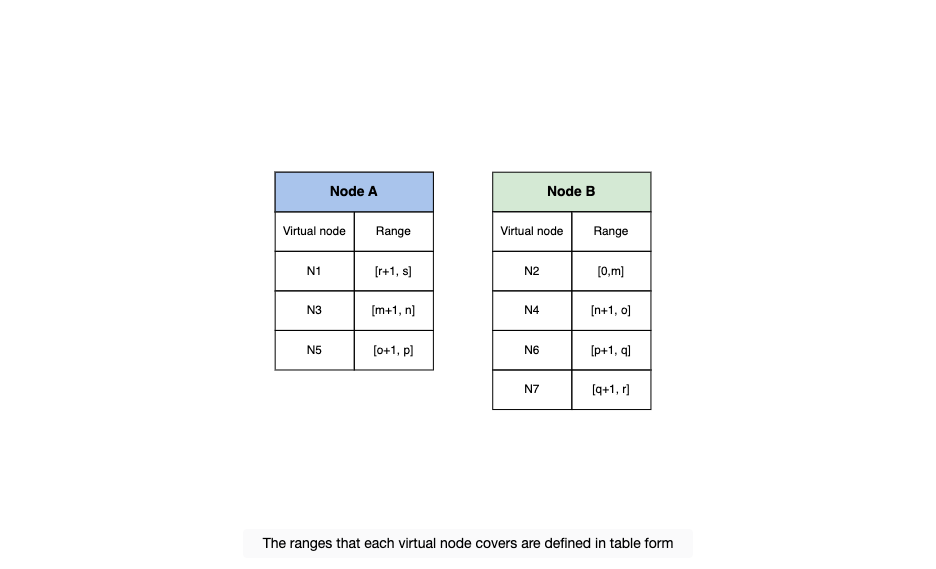
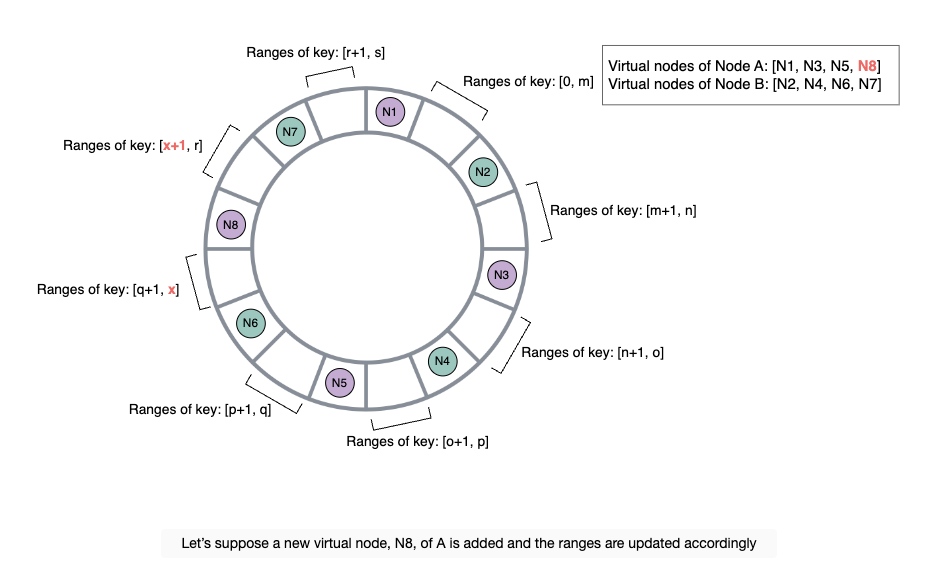
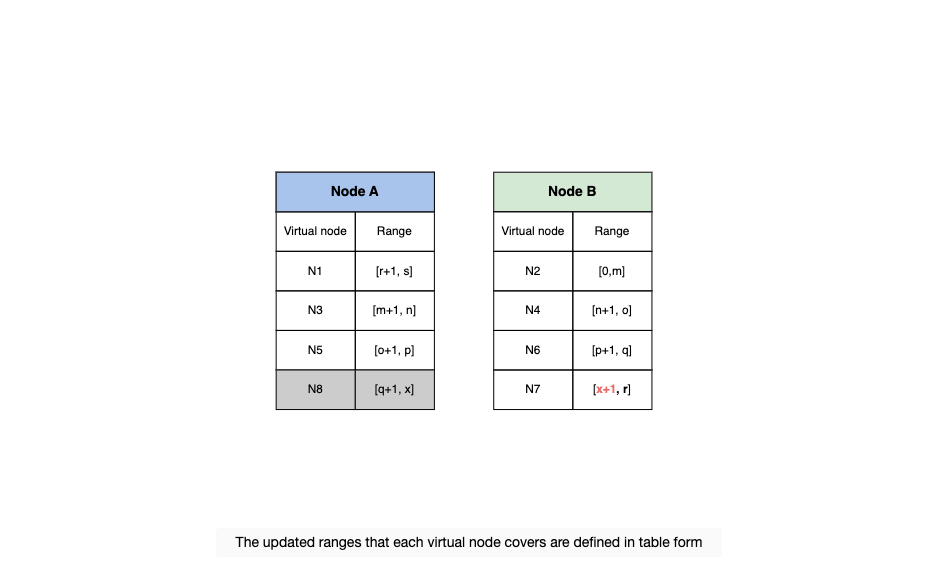
Каждый узел хранит отдельное дерево Меркла для диапазона ключей, которые он обслуживает для каждого виртуального узла. Узлы могут определить, корректны ли ключи в данном диапазоне. Корень дерева Меркла, соответствующего общим диапазонам ключей, обменивается между двумя узлами. Мы проведем следующую проверку:
-
Сравнение хэшей корневого узла деревьев Меркла.
- Если они совпадают, дальнейшие действия не требуются.
-
Рекурсивный обход дочерних узлов слева и справа.
- Узлы определяют, есть ли между ними различия, и выполняют необходимую синхронизацию.
Следующие слайды объясняют подробнее, как работают деревья Меркла.
Примечание: Предполагается, что диапазоны ключей, использованные в примере, гипотетические и предназначены только для иллюстрации.
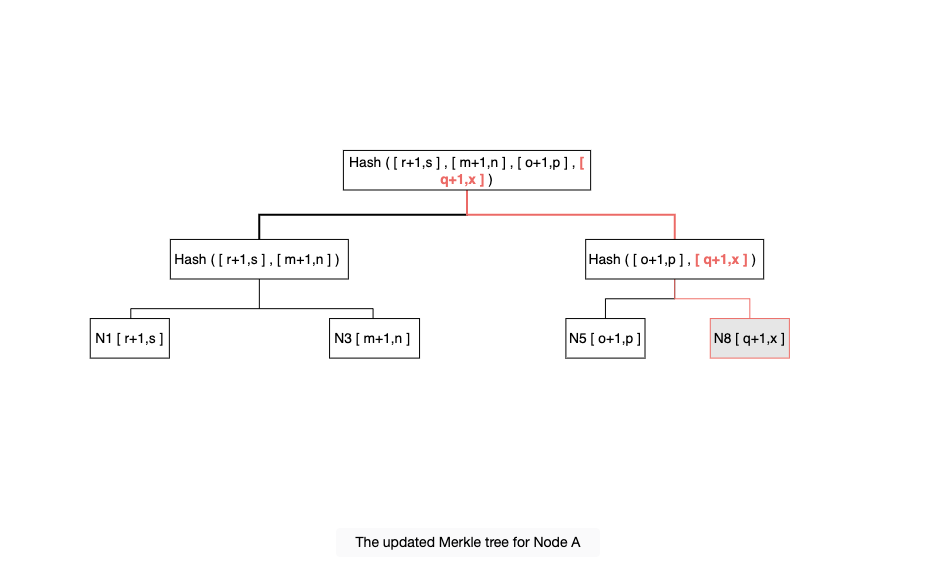
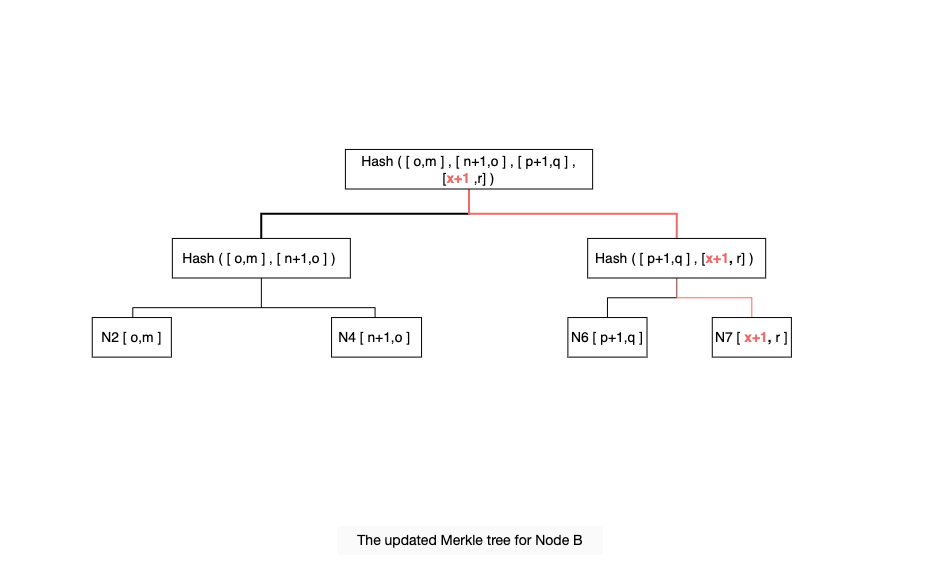
Advantages and Disadvantages of Merkle Trees - Преимущества и недостатки деревьев Меркла
Преимущества: Основное преимущество использования деревьев Меркла заключается в том, что каждую ветвь дерева можно проверить независимо, без необходимости загрузки всего дерева или полного набора данных. Это снижает объем данных, которые необходимо обменивать для синхронизации, а также количество обращений к диску, необходимых в процессе антиэнтропии.
Недостатки: Недостаток заключается в том, что при добавлении или удалении узла в системе хэши дерева необходимо пересчитывать, так как затрагиваются несколько диапазонов ключей.
Promote membership in the ring to detect failures - Обнаружение сбоев и управление членством в кольце
Мы хотим, чтобы наши узлы могли обнаруживать сбои других узлов в кольце. Рассмотрим, как добавить это в наш предложенный дизайн.
Узлы могут быть недоступны на короткие периоды, но также могут уйти в оффлайн на неопределенный срок. Мы не должны перераспределять партиции или исправлять недоступные реплики, если один узел выходит из строя, так как это редко приводит к постоянному выходу из строя. Поэтому добавление и удаление узлов из кольца должно происходить осторожно.
Плановое введение в эксплуатацию и вывод из эксплуатации узлов приводит к изменениям членства. Эти изменения формируют историю, которая записывается на постоянной основе для каждого узла и согласовывается между участниками кольца с помощью протокола gossip (распространение слухов). Протокол на основе gossip также поддерживает в конечном итоге согласованное представление о членстве. Когда два узла случайным образом выбирают друг друга в качестве партнера, оба узла могут эффективно синхронизировать свои истории членства.
Example: How Gossip-based Protocol Works - Пример работы протокола на основе gossip
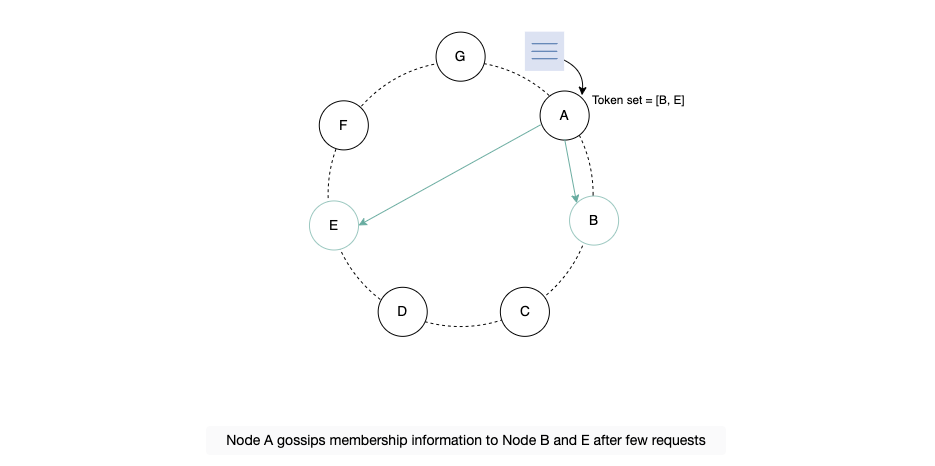
Рассмотрим следующий пример. Пусть узел A запускается впервые и случайным образом добавляет узлы B и E в свой набор токенов. Набор токенов содержит виртуальные узлы в пространстве консистентного хеширования и отображает узлы на их соответствующие наборы токенов. Эта информация хранится локально на диске узла.
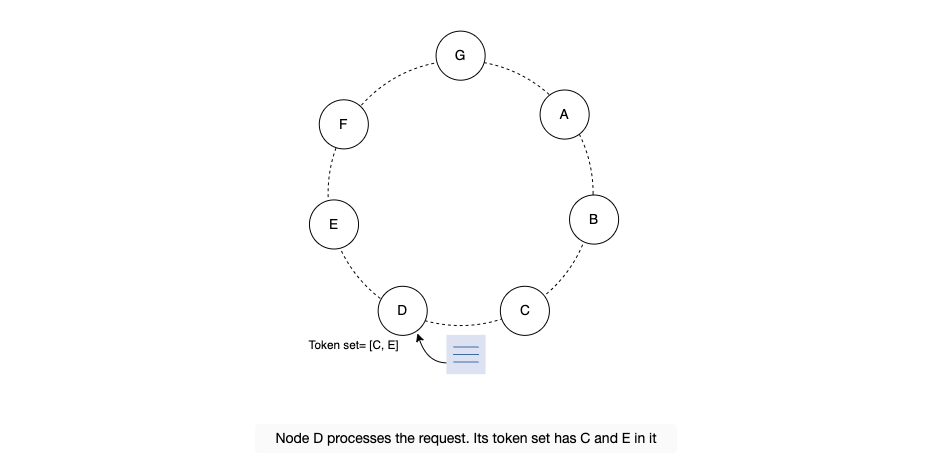
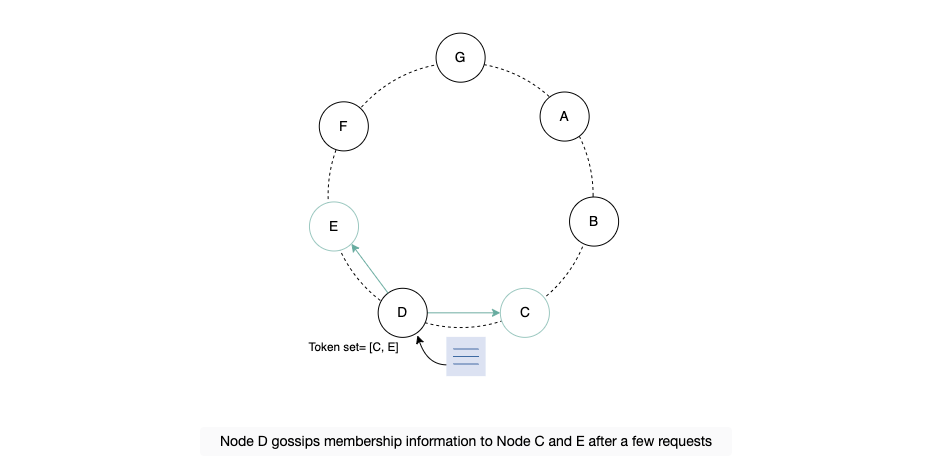
Теперь узел A обрабатывает запрос, который приводит к изменению, поэтому он сообщает об этом узлам B и E. Другой узел, D, имеет в своем наборе токенов узлы C и E. Он вносит изменение и сообщает об этом узлам C и E. Другие узлы выполняют тот же процесс. Таким образом, каждый узел в конечном итоге узнает информацию о всех других узлах. Это эффективный способ асинхронного обмена информацией, который не требует большого объема полосы пропускания.
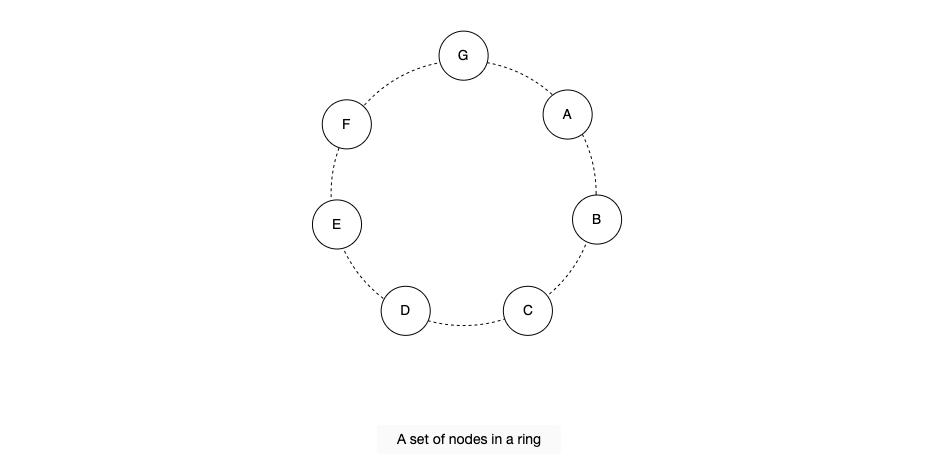
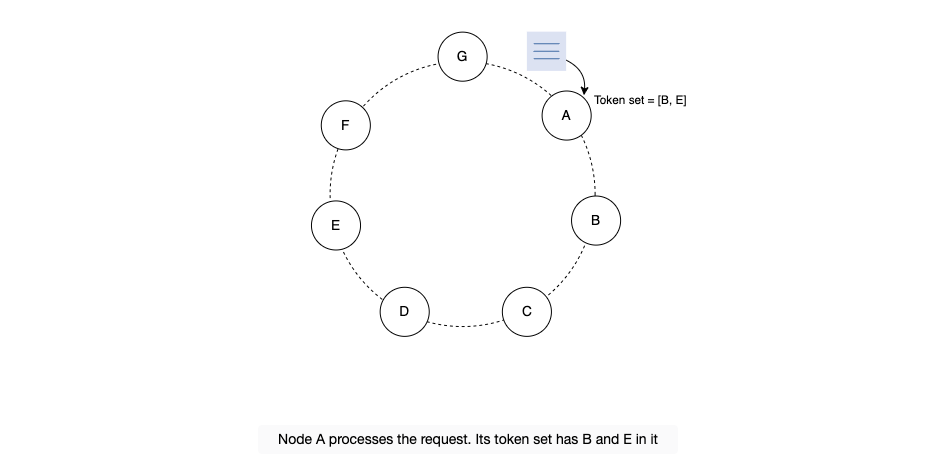
Keeping in mind our consistent hashing approach, can the gossip-based protocol fail?
Details
Answer
Да, протокол на основе gossip может потерпеть неудачу. Например, если виртуальный узелN1 узла A хочет быть добавлен в кольцо, администратор обращается к узлу N2, который также является виртуальным узлом A. В этом случае оба узла считают себя частью кольца и не осознают, что они являются частью одного и того же сервера. Если будут внесены какие-либо изменения, узел будет продолжать обновлять сам себя, что является ошибкой. Этот сценарий называется логическим разделением (logical partitioning).Протокол на основе gossip работает, когда все узлы в кольце связаны в единый граф (то есть имеют одну связанную компоненту в графе). Это подразумевает, что существует путь от любого узла к любому другому узлу (возможно, через разные промежуточные узлы). Различные проблемы, такие как высокая текучесть (частое появление и исчезновение узлов), проблемы с отображением виртуальных узлов на физические, и т.д., могут создать ситуацию, которая будет аналогична реальному сетевому разделению некоторых узлов от остальных. В таком случае обновления от одного набора узлов не будут достигать другого. Поэтому сам по себе протокол gossip недостаточен для правильного распространения информации; также необходимо поддерживать топологию сети в хорошем, связанном состоянии.
How can we prevent logical partitioning?
Details
Answer
We can make a few nodes play the role of seeds to avoid logical partitions. We can define a set of nodes as seeds via a configuration service. This set of nodes is known to all the working nodes since they can eventually reconcile their membership with a seed. So, logical partitions are pretty rare.Decentralized failure detection - Децентрализованное обнаружение сбоев
Децентрализованные протоколы обнаружения сбоев используют протокол на основе gossip, который позволяет каждому узлу узнавать о добавлении или удалении других узлов. Методы join и leave узлов, которые присоединяются или покидают сеть, явно уведомляют другие узлы о постоянных добавлениях и удалениях узлов. Отдельные узлы обнаруживают временные сбои узлов, когда не могут установить связь с другим узлом. Если узел не может установить связь с любым из узлов в своем наборе токенов в течение разрешенного времени, он сообщает администраторам, что узел вышел из строя.
Conclusion - Заключение
Key-value хранилище обеспечивает гибкость и позволяет масштабировать приложения, работающие с неструктурированными данными. Веб-приложения могут использовать key-value хранилища для хранения информации о пользовательской сессии и предпочтениях. При использовании пользовательского ключа все данные доступны, и key-value хранилища идеальны для быстрых операций чтения и записи. Key-value хранилища могут использоваться для поддержки рекомендаций и рекламы в реальном времени, поскольку они могут быстро получать доступ к данным и предоставлять свежие рекомендации.