Monitoring Client-side Errors
Client-side errors
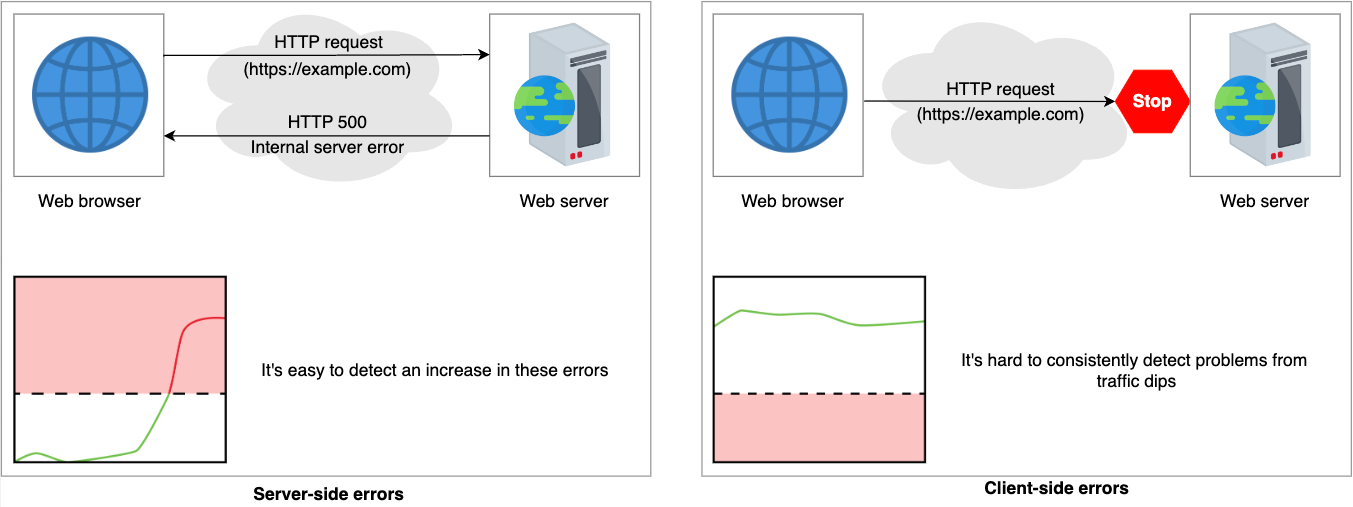
В распределенной системе клиенты часто получают доступ к сервису через HTTP-запрос. Мы можем отслеживать логи наших веб- и приложений серверов, если запрос не удается обработать. Если несколько запросов завершились с ошибкой, мы можем наблюдать всплеск внутренних ошибок (ошибка 500).
Ошибки, причиной которых является клиентская сторона, трудно устранить, так как сервис имеет мало или вообще не имеет информации о системе клиента. Мы можем попытаться найти снижение нагрузки по сравнению со средними значениями, но такой график обычно трудно интерпретировать. Он может содержать ложноположительные и ложноотрицательные результаты из-за таких факторов, как неожиданно переменная нагрузка или если затронута лишь небольшая часть клиентской популяции.
Существует множество факторов, которые могут привести к сбоям, из-за которых клиенты не могут подключиться к серверу. К ним относятся следующие:
- Сбой в разрешении DNS имени.
- Любой сбой в маршрутизации по пути от клиента к поставщику услуг.
- Любые сбои в инфраструктуре сторонних организаций, такие как промежуточные устройства и сети доставки контента (CDN).
Сбои из-за ошибки в маршрутизации
Рассмотрим пример ошибки из реального мира, которая затронула большое количество клиентов сервиса, но сам сервис не сразу был осведомлен об этом.
Один из партнерских интернет-провайдеров (ISP) Google случайно анонсировал маршруты в Интернете, которые не должен был анонсировать. В результате трафик многих клиентов Google начал маршрутизироваться через непредусмотренные интернет-провайдеры и не достигал Google из-за утечки BGP (Border Gateway Protocol); один из примеров утечки BGP показан на иллюстрации ниже. Клиенты были расстроены, так как не могли подключиться к Google, в то время как сам Google мог не сразу обнаружить такие проблемы, поскольку они не происходили в его собственной инфраструктуре.
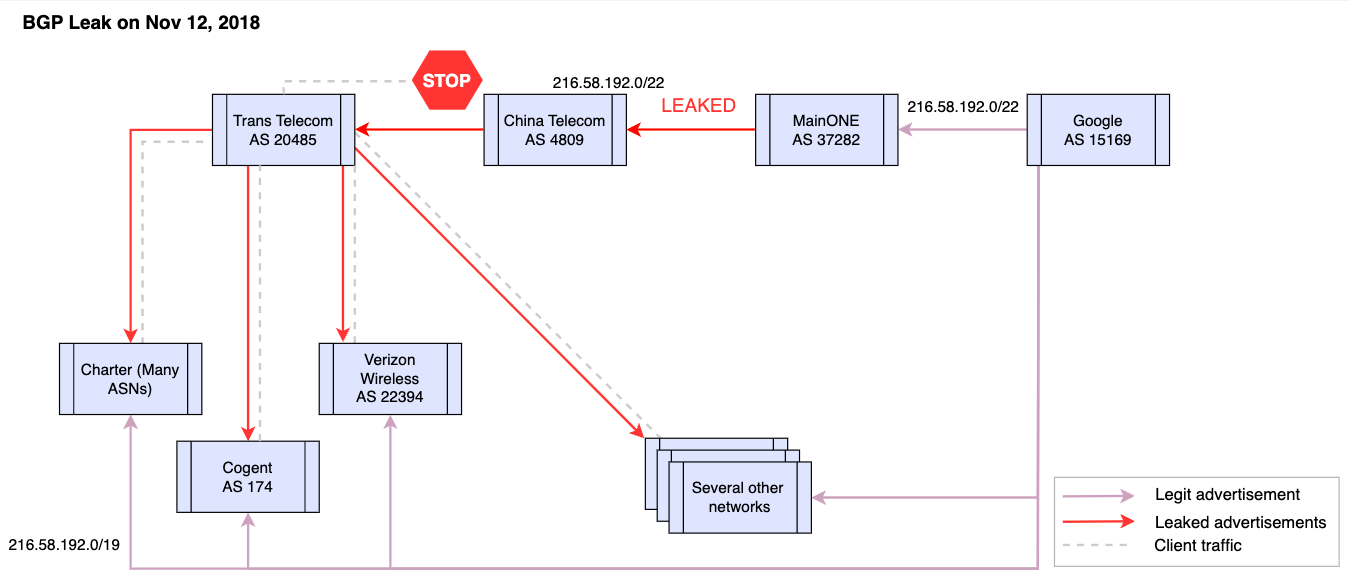
Подобная утечка не является уникальной. Подобные проблемы продолжают возникать. Еще одна такая утечка произошла 16 апреля 2021 года, когда один AS (Autonomous System) ошибочно анонсировал более 30 000 префиксов BGP. Это привело к 13-кратному всплеску входящего трафика в их сеть. Однако увеличение потока было замечено, и проблема была решена.
Системы мониторинга затронутых сервисов могут не сразу зафиксировать такие события. Мониторинг таких ситуаций имеет ключевое значение для того, чтобы приложение оставалось доступным для всех своих клиентов. Поэтому в следующих уроках мы рассмотрим методы, которые помогут нам отслеживать вышеупомянутые ситуации.
Design of a Client-side Monitoring System
Сервис не имеет видимости ошибок, которые не происходят в его инфраструктуре. Тем не менее, такие сбои одинаково расстраивают пользователей, и они могут спросить у друзей: «У тебя тоже не работает сервис X?» или зайти на сайты, такие как Downdetector, чтобы узнать, кто-нибудь еще сталкивается с той же проблемой. Они могут сообщить о проблеме через Tweet или другой канал связи. Однако все такие случаи имеют медленную обратную связь. Как поставщики услуг, мы хотим выявлять такие проблемы как можно быстрее, чтобы принимать корректирующие меры. Давайте разработаем такую систему.
Первоначальный дизайн
Чтобы убедиться, что запросы клиентов достигают сервера, мы будем действовать как клиенты и выполнять проверки доступности и здоровья (reachability and health checks). Нам понадобятся различные точки наблюдения по всему миру. Мы можем запустить сервис, назовем его prober, который периодически отправляет запросы к сервису для проверки его доступности. Таким образом, мы сможем мониторить доступность нашего сервиса из различных мест.
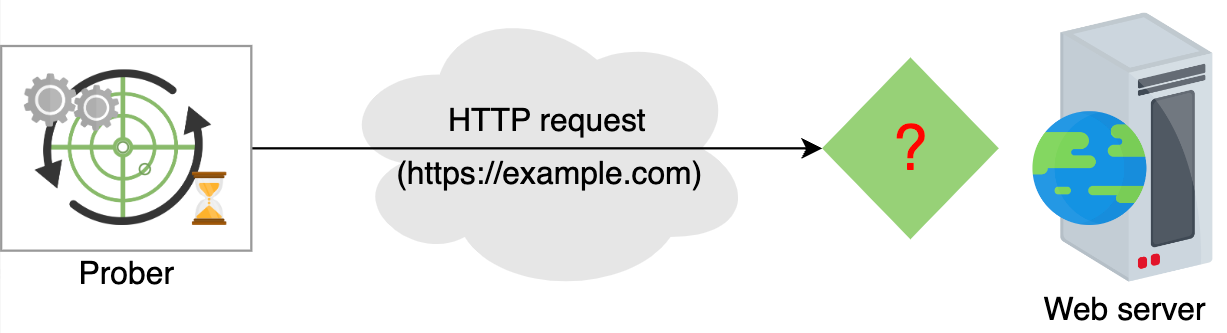
Проблемы с prober
Мы можем столкнуться со следующими проблемами:
-
Неполное покрытие: Мы можем не иметь хорошего покрытия по всем автономным системам (AS). По состоянию на март 2021 года в Интернете существует 100 000 уникальных автономных систем. Размещение такого количества проб по всему миру не является ни экономически эффективным, ни возможным. Дополнительные препятствия включают в себя страновые или ISP-специфические регулирования и необходимость периодического обслуживания.
-
Отсутствие имитации поведения пользователя: Такие пробы могут не отражать типичное поведение пользователя, чтобы объяснить, как типичный пользователь будет использовать сервис.
Примечание: начальный дизайн основан на активном зондировании (active probing).
Улучшение дизайна
Вместо использования prober в точках наблюдения, мы можем встроить их непосредственно в само приложение. У нас будут следующие два компонента:
-
Agent: Это встроенный в клиентское приложение prober, который отправляет соответствующие отчеты о сбоях в сервисе.
-
Collector: Это сборщик отчетов, независимый от основного сервиса. Он сделан независимым, чтобы избежать ситуаций, когда агенты-клиенты хотят сообщить об ошибке в неработающий сервис. Мы суммируем отчеты об ошибках от collector и отслеживаем всплески на графике ошибок, чтобы выявить проблемы на стороне клиента.
Следующая иллюстрация показывает, как агент обращается к независимому collector, когда основной сервис недоступен:
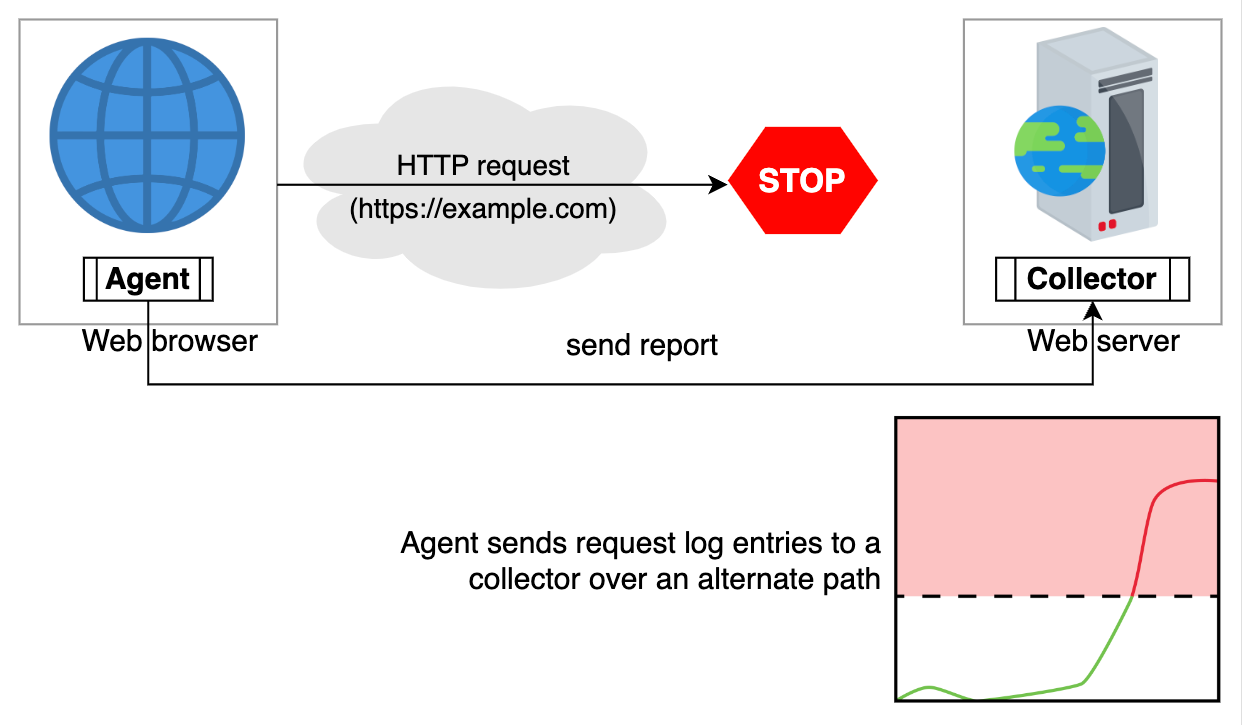
Оценка отчета агента для выявления всплеска ошибок
Эти collectors являются иерархией систем обработки больших данных. Мы можем разместить их ближе к сети клиента и со временем накапливать статистику с таких локализованных точек. Мы будем использовать системы обработки потоков данных в реальном времени, чтобы сделать такую систему почти в реальном времени. Если нас интересуют только суммарные статистические данные, наша система может допустить потерю некоторых отчетов об ошибках. Некоторые отчеты будут относиться к общей пользовательской популяции. Мы можем сказать, что 1% пользователей сервиса — это «некоторые». Если мы не хотим терять ни одного отчета, нам придется проектировать систему с большей осторожностью, что будет дороже.
Теперь мы решим следующие задачи:
- Может ли пользователь активировать и деактивировать отчеты на стороне клиента?
- Как агенты на стороне клиента будут достигать collectors при сбоях?
- Как мы будем защищать конфиденциальность пользователя?
Активация и деактивация отчетов
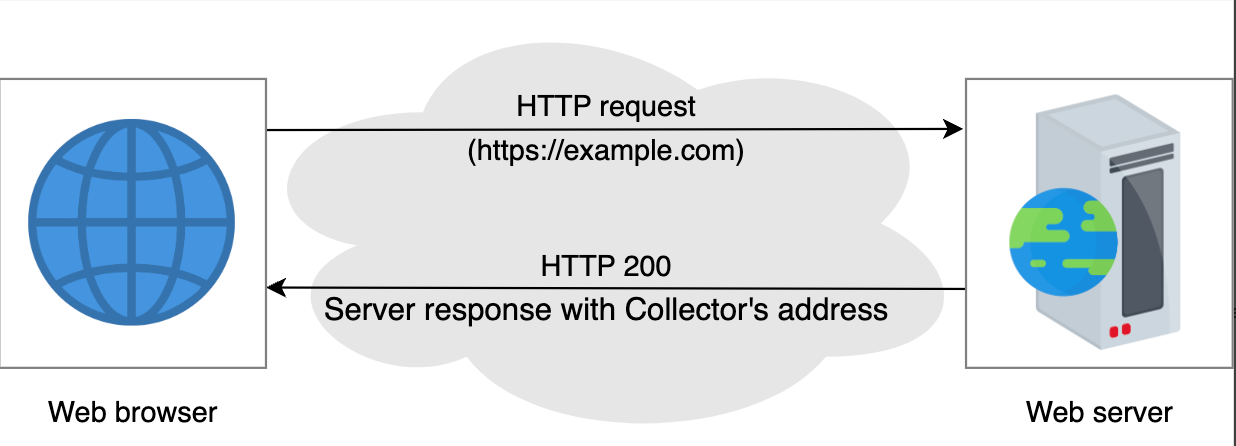
Мы будем использовать специальный HTTP-заголовок для отправки соответствующей информации в collectors. Хотя клиент получает доступ к сервису через браузер, конкретный браузер должен знать об этой функции, чтобы корректно заполнять информацию в заголовке HTTP-запросов. Для организаций, которые разрабатывают браузеры и предоставляют услуги (например, браузеры на базе Chromium), такие функции могут быть интегрированы и стандартизированы со временем.
Другим решением может быть использование клиентского приложения, которое контролирует сервис, и тогда мы сможем легко добавлять такие заголовки в HTTP-запросы.
Клиент может заполнять заголовок запроса, если он уже дал на это согласие. Сервис затем может ответить соответствующими значениями для политики и конечных точек сбора данных.
Достижение collectors при сбоях
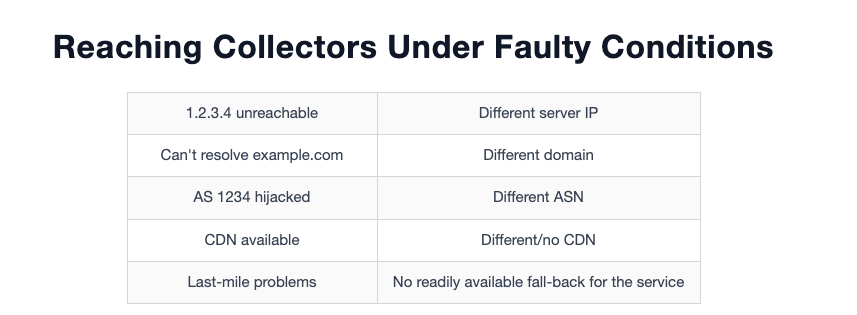
Collectors должны находиться в другой зоне отказа (failure domain), нежели веб-сервис, который мы пытаемся мониторить. Клиентская сторона может попробовать различные collectors в разных зонах отказа, пока один из них не сработает. Мы можем увидеть аналогичную схему в следующих примерах. Иногда мы называем такое явление нахождением за пределами зоны воздействия сбоя (blast radius).
- Если мы хотим проверить доступность IP, мы размещаем сервис на другом IP.
- Если мы мониторим доступность домена, мы размещаем collector на другом домене.
- Если мы хотим обнаружить, что маршрут автономной системы не был перехвачен, мы размещаем сервис в другой автономной системе.
- Хотя, для проблем последней мили (last-mile errors), мы не можем сделать много как поставщик услуг. Мы можем накапливать такие события на клиентской стороне и сообщать о них при следующем подключении. Сервис может повлиять на оставшиеся компоненты сбоев.
Защита конфиденциальности пользователя
Человек, использующий клиентское ПО, должен полностью контролировать, какие данные собираются и отправляются с каждым запросом. Пользователь также должен иметь возможность повторно активировать эту функцию в любое время. Если мы используем наше клиентское приложение (а не браузерное), у нас есть большая гибкость в том, какие диагностические данные могут быть включены в отчет. Для клиентской программы на базе браузера мы можем исключить следующую информацию:
- Мы можем избежать включения трассировки (traceroute) для просмотра пути клиента к сервису. Пользователи могут быть чувствительны к своему географическому местоположению. Это может быть аналогично сбору информации о местоположении.
- Мы можем исключить информацию о том, какой DNS-резолвер используется. Снова, детали DNS могут раскрыть некоторую информацию о местоположении.
- Мы можем избежать включения информации о времени прохождения туда и обратно (RTT) и потерях пакетов.
Примечание: В качестве основного правила, мы должны стараться собирать как можно меньше информации, и она должна использоваться только для конкретной цели, на которую пользователь дал согласие.
Идеально, для веб-клиента мы должны собирать только ту информацию, которая регистрируется в weblog, когда любой запрос был успешным.
Мы не должны использовать активное зондирование, за исключением проверки стандартной функциональности сервиса и отчетности о результатах таких зондов. Таким образом, информация о трассировке и потере пакетов исключена.
Любой посредник (например, ISP или промежуточные устройства) не может изменить, добавить или удалить механизм отчетности об ошибках благодаря шифрованию. Таким образом, designated collectors являются единственным местом, куда могут отправляться такие данные.
Заключение
В распределенной системе сложно обнаруживать и реагировать на ошибки на стороне клиента. Поэтому важно отслеживать такие события, чтобы обеспечить хороший пользовательский опыт.
Мы можем обрабатывать ошибки с помощью независимого агента, который отправляет отчеты о сбоях в сервисе collector. Такие collectors должны быть независимыми от основного сервиса с точки зрения инфраструктуры и развертывания.