Distributed Logging
Зачем нужно логирование?
Лог-файл записывает детали событий, происходящих в программном приложении. Эти детали могут включать микросервисы, транзакции, действия сервисов или любую информацию, полезную для отслеживания потока событий в системе. Логирование играет важную роль в мониторинге работы приложения.
Необходимость логирования
Логирование необходимо для понимания потока событий в распределенной системе. Это может показаться утомительной задачей, но при возникновении сбоя или угрозы безопасности логирование помогает точно определить, когда и как система вышла из строя или была скомпрометирована. Логирование также помогает выявить первопричину сбоя или нарушения безопасности, что сокращает среднее время на восстановление системы.
Почему бы нам просто не использовать вывод через стандартные операторы, чтобы понять поток приложения? Это возможно, но не идеально. Простые операторы вывода не могут отслеживать уровень важности сообщений. Вывод таких операторов обычно отображается в терминале, в то время как наша задача может требовать сохранения данных на локальном или удаленном хранилище. Более того, в системе могут быть миллионы операторов вывода, поэтому лучше структурировать и сохранять их должным образом.
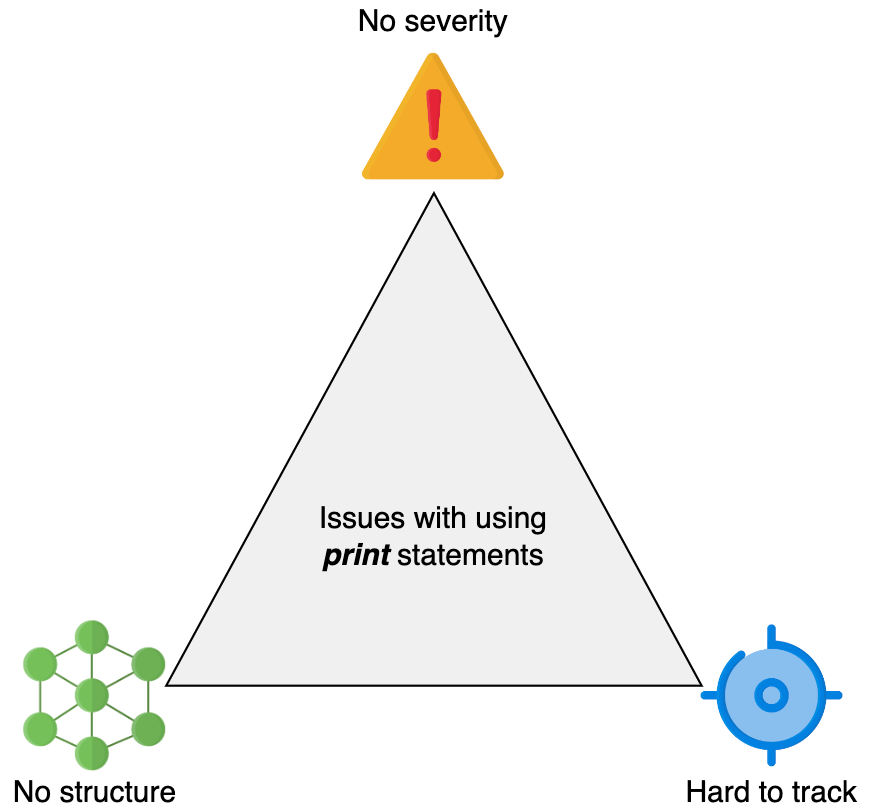
Одновременная активность службы, работающей на многих узлах, может потребовать информации о причинно-следственных связях для правильного соединения событий в один поток. Необходимо осторожно обращаться с причинно-следственными связями в распределенной системе. Мы используем сервис логирования для надлежащего управления диагностическими и исследовательскими данными нашего распределенного программного обеспечения.
Логирование позволяет нам понять наш код, обнаружить непредвиденные ошибки, исправить их и визуализировать производительность приложения. Это позволяет нам знать, как работает система в продакшене, и как выполняются процессы в системе.
Анализ логов помогает в следующих ситуациях:
- Для устранения неполадок приложений, узлов или сетевых проблем.
- Для соблюдения внутренних политик безопасности, внешних нормативных требований и стандартов.
- Для распознавания и реагирования на утечки данных и другие проблемы безопасности.
- Для понимания действий пользователей и предоставления данных в систему рекомендаций.
What are some security concerns to consider when designing a distributed logging system? How would you mitigate them?
Details
Как мы будем проектировать распределенную систему логирования?
Мы разделили проектирование распределенной системы логирования на следующие два урока:
-
Введение: Мы обсудим, как работает логирование на распределенном уровне. Мы также покажем, как можно ограничить размер лог-файлов и структурировать их. Этот урок поможет нам понять, какие требования следует учитывать при логировании информации о системе.
-
Проектирование: В этом уроке мы определим требования, API-дизайн и подробное проектирование нашей распределенной системы логирования.
Introduction to Distributed Logging
Логирование в распределенной системе
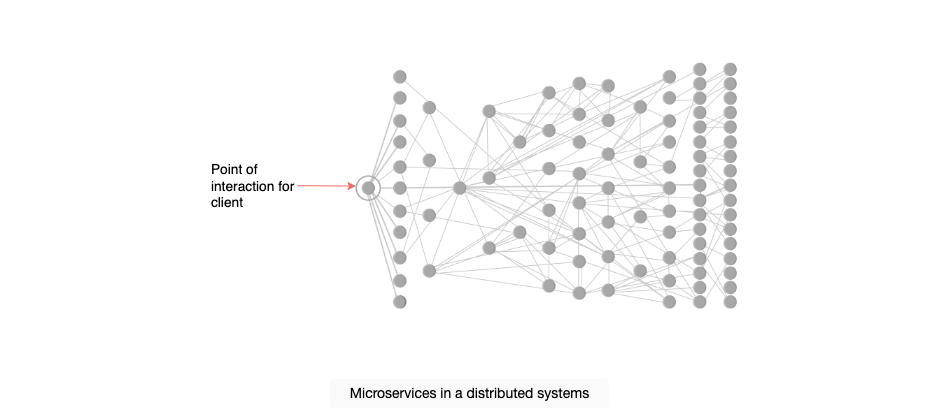
В современном мире все больше систем переходят от монолитной архитектуры к архитектуре микросервисов. В микросервисной архитектуре логи каждого микросервиса накапливаются на соответствующей машине. Если мы хотим узнать о конкретном событии, которое обрабатывалось несколькими микросервисами, трудно зайти на каждый узел, понять последовательность событий и просмотреть сообщения об ошибках. Однако, если мы можем отследить лог для конкретного потока от начала до конца, это значительно упрощает задачу.
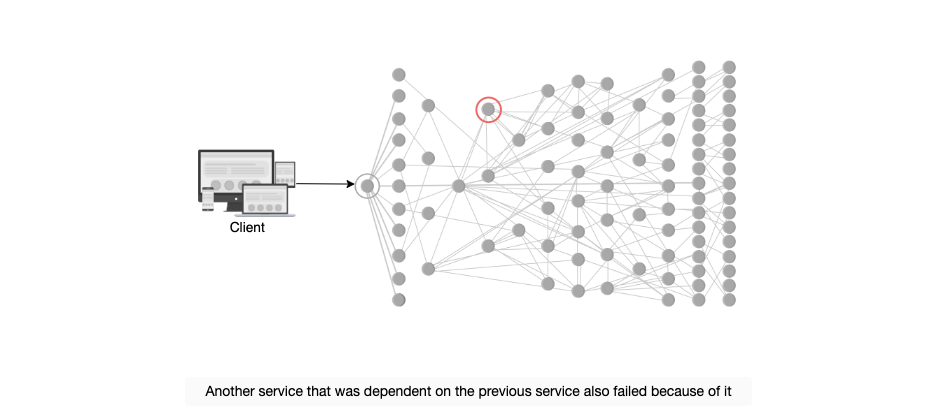
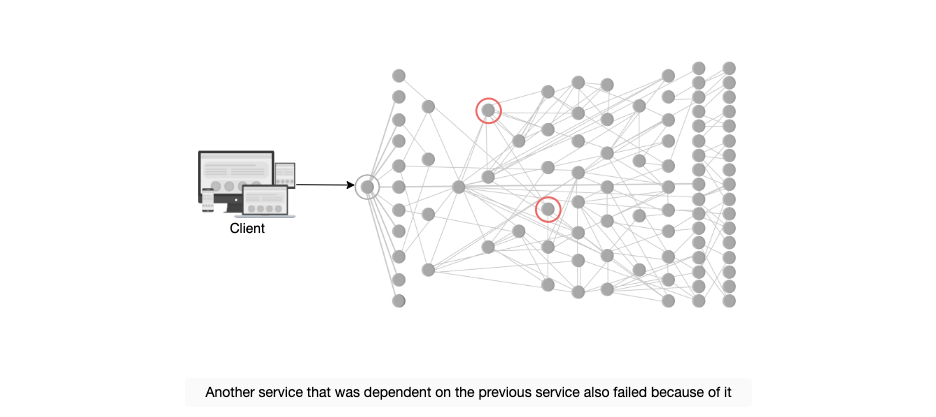
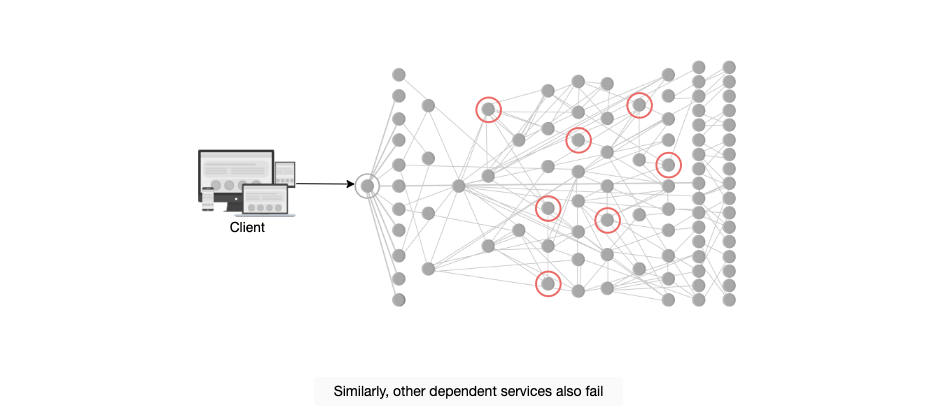
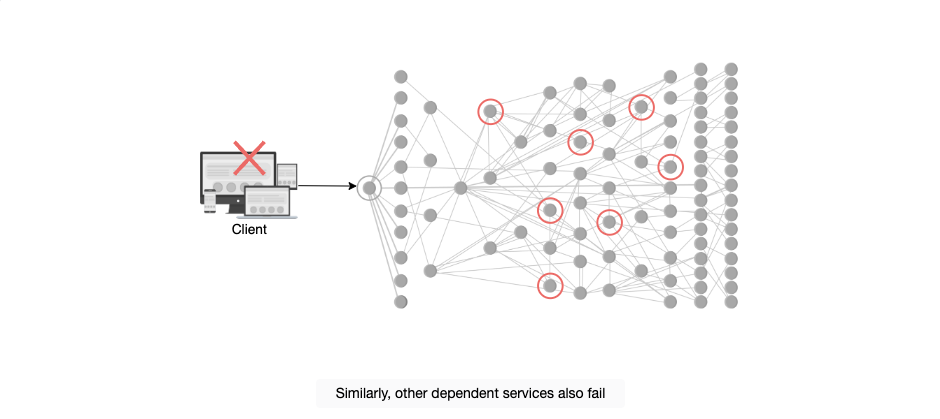
Более того, микросервис не обязательно должен быть развернут только на одном узле; он может быть развернут на тысячах узлов. Рассмотрим пример, в котором сотни микросервисов взаимозависимы, и сбой одного сервиса может привести к сбоям других. Если у нас нет логов, мы не сможем определить коренную причину сбоя. Это подчеркивает необходимость логирования.
Ограничение размера лога
Со временем количество логов увеличивается. В любой момент времени, возможно, нужно записать сотни параллельных сообщений. Но вопрос в том, все ли они настолько важны, чтобы их логировать? Чтобы решить эту проблему, логи должны быть структурированы. Мы должны решить, что логировать в системе на уровне приложения или логирования.
Использование сэмплирования
В этом подходе мы определим, какие сообщения следует логировать в системе. Рассмотрим ситуацию, когда у нас есть множество сообщений от одного и того же набора событий. Например, люди комментируют пост: сначала Персона X прокомментировал пост Персоны Y, затем Персона Z прокомментировал пост Персоны Y, и так далее. Вместо того чтобы логировать всю информацию, мы можем использовать сервис сэмплирования, который логирует только небольшой набор сообщений из большого количества данных. Таким образом, мы можем выбрать наиболее важные сообщения для логирования.
Примечание: Для больших систем, таких как Facebook, где происходят миллиарды событий в секунду, логировать все события невозможно. Необходимы подходящий порог сэмплирования и стратегия, чтобы избирательно выбирать представительный набор данных.
Мы также можем классифицировать типы сообщений и применять фильтр, который определяет важные сообщения и логирует только их.
What is a scenario where the sampling approach will not work?
Details
Let’s consider an application that processes a financial ATM transaction. It runs various services like fraud detection, expiration time checking, card validation, and many more. If we start to miss out logging of any service, we cannot identify an end-to-end flow that affects the debugging in case an error occurs. Using sampling, in this case, is not ideal and results in the loss of useful data.
Использование категоризации
Рассмотрим поддержку логирования, предоставляемую различными языками программирования, например, log4j и logging в Python. Следующие уровни серьезности обычно используются при логировании:
- DEBUG
- INFO
- WARNING
- ERROR
- FATAL/CRITICAL
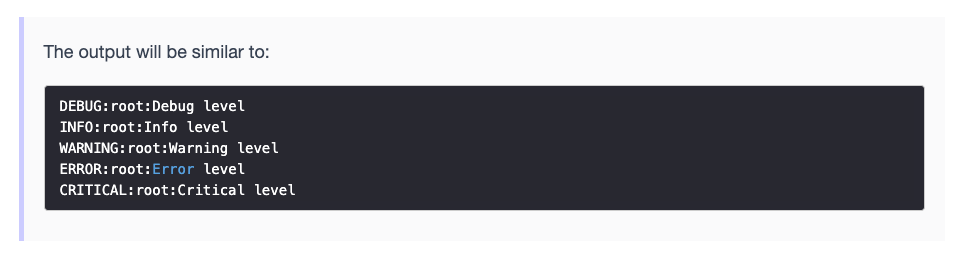
Обычно в продакшене логи настроены на вывод сообщений с уровнем WARNING и выше. Но для более детального отслеживания потока можно установить уровни серьезности на DEBUG и INFO.
import logging as log
# set the logging level to DEBUG
log.basicConfig(level=log.DEBUG)
for i in range(6):
    if i == 0:
        log.debug("Debug level")
    elif i == 1:
        log.info("Info level")
    elif i == 2:
        log.warning("Warning level")
    elif i == 3:
        log.error("Error level")
    elif i == 4:
        log.critical("Critical level")
    elif i == 5:
        print("Uncomment the following to view a system generated error:")
        #print(3/0)
Структурирование логов
Приложения могут выбирать структуру своих логов. Например, приложение может записывать логи в бинарном или текстовом формате, но часто полезно задать структуру логов. Первое преимущество структурированных логов — лучшая совместимость между генераторами логов и их обработчиками. Во-вторых, структура может облегчить работу системы обработки логов.
Примечание: Структурирование логов — это обширная тема. Для заинтересованных пользователей рекомендуем ознакомиться с диссертацией Райана Брода "Query-based debugging of distributed systems”.
Важные моменты при логировании
Следует быть осторожным при логировании. Информация в логах должна содержать только релевантные данные и не нарушать вопросы безопасности. Для защиты данных следует логировать их в зашифрованном виде. Следует учитывать следующие моменты при логировании:
- Избегайте логирования персонально идентифицируемой информации (PII), такой как имена, адреса, email и т.д.
- Избегайте логирования конфиденциальной информации, такой как номера кредитных карт, пароли и т.д.
- Избегайте избыточной информации. Логирование всей информации ненужно. Оно только занимает больше места и влияет на производительность. Логирование, будучи операцией ввода-вывода, имеет свои штрафы по производительности.
- Механизм логирования должен быть безопасным и неуязвимым, поскольку логи содержат поток выполнения приложения, и уязвимый механизм логирования подвержен взлому.
Уязвимость в инфраструктуре логирования
В ноябре 2021 года была выявлена уязвимость нулевого дня в Log4j, известной Java-библиотеке для логирования. Уязвимость, названная Log4Shell (CVE-2021-44228), присутствовала в Log4j с 2013 года. Apache присвоил Log4Shell наивысший доступный балл — 10 по шкале CVSS. Эксплуатация уязвимости проста и затрагивает сотни миллионов устройств. Эксперты по безопасности считают, что эта уязвимость может позволить проводить разрушительные кибератаки по всему миру, так как она может позволить злоумышленникам запускать вредоносный код и брать под контроль машину.
Design of a Distributed Logging Service
Теперь мы разработаем распределенную систему логирования. Наша система должна логировать все действия или сообщения (мы не будем включать возможности сэмплирования в наш дизайн).
Требования
Перечислим требования для проектирования распределенной системы логирования:
Функциональные требования
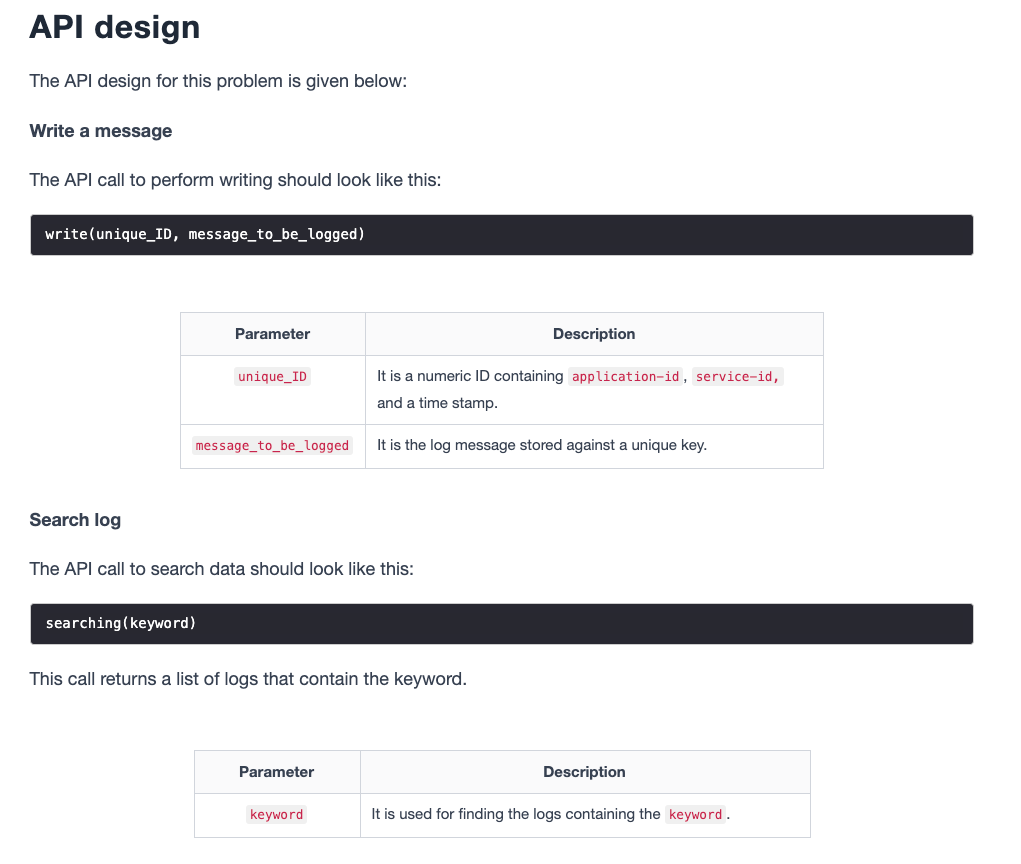
- Запись логов: Сервисы распределенной системы должны иметь возможность записывать логи в систему логирования.
- Поиск по логам: Система должна обеспечивать легкий доступ к логам для поиска. Также должен быть удобный доступ к последовательности выполнения приложений от начала до конца.
- Хранение логов: Логи должны храниться в распределенном хранилище для легкого доступа.
- Централизованный визуализатор логов: Система должна предоставлять унифицированный обзор глобально распределенных сервисов.
Нефункциональные требования
- Низкая задержка: Логирование — это операция, связанная с интенсивным вводом-выводом, которая часто намного медленнее, чем операции процессора. Необходимо спроектировать систему так, чтобы логирование не находилось на критическом пути выполнения приложений.
- Масштабируемость: Система логирования должна быть масштабируемой и справляться с увеличивающимся объемом логов и растущим числом одновременно работающих пользователей.
- Доступность: Система логирования должна быть высокодоступной для записи данных.
Строительные блоки, которые мы будем использовать
Проектирование распределенной системы логирования будет использовать следующие строительные блоки:
- Система Pub-Sub: Мы будем использовать систему pub-sub для обработки большого объема логов.
- Распределенный поиск: Мы будем использовать распределенный поиск для эффективного поиска по логам.
Первоначальный дизайн
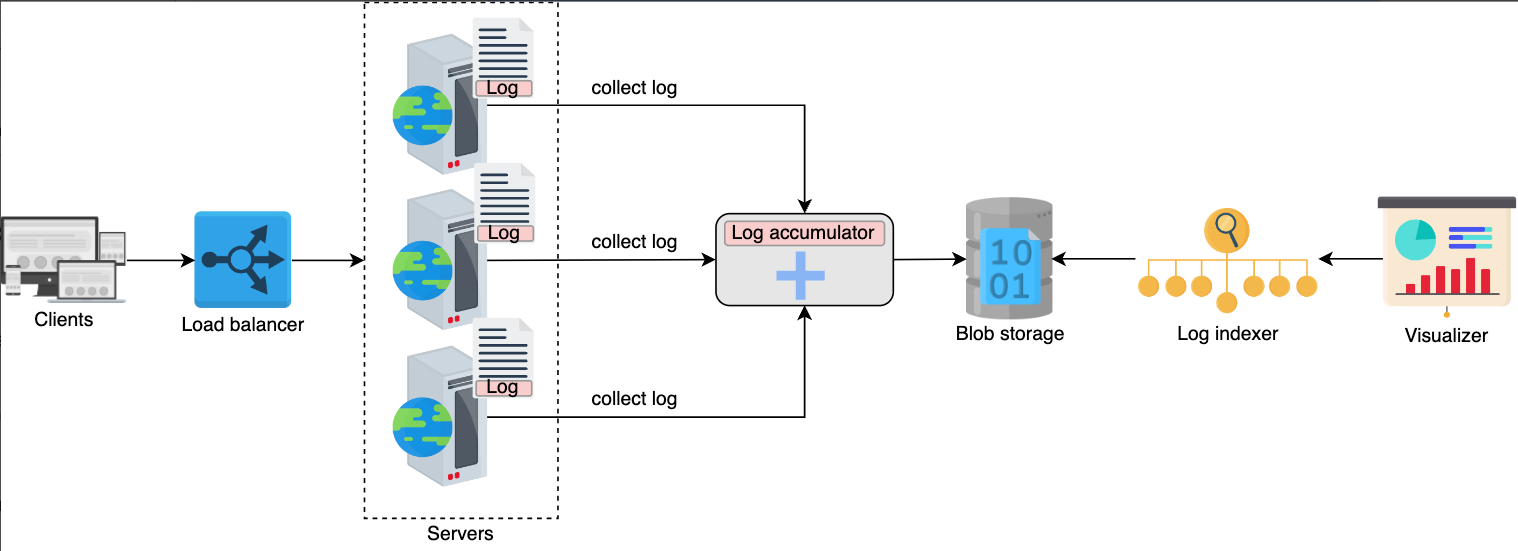
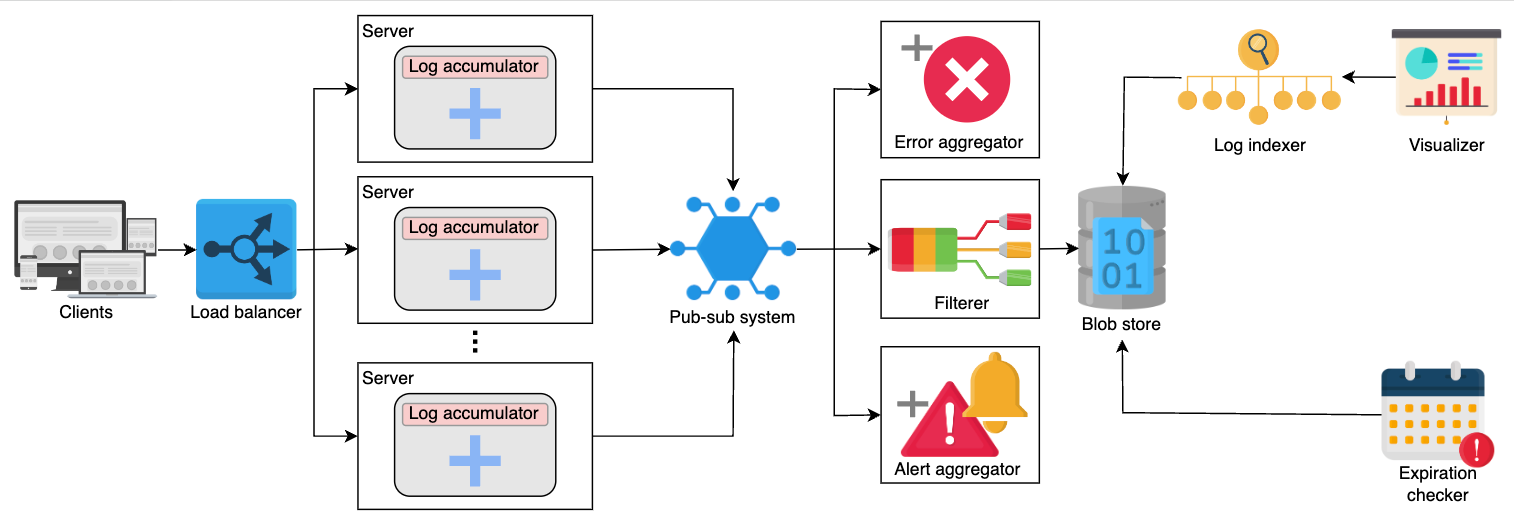
В распределенной системе клиенты по всему миру генерируют события, запрашивая услуги у различных серверных узлов. Узлы создают логи, обрабатывая каждый из запросов. Эти логи накапливаются на соответствующих узлах.
Кроме строительных блоков, давайте перечислим основные компоненты нашей системы:
- Накопитель логов: Агент, который собирает логи с каждого узла и сохраняет их в хранилище. Таким образом, если нам нужно узнать о каком-то конкретном событии, нам не нужно посещать каждый узел, и мы можем получить их из нашего хранилища.
- Хранилище: Логи необходимо где-то хранить после накопления. Мы выберем блоб-хранилище для сохранения наших логов.
- Индексатор логов: Увеличивающееся количество файлов логов влияет на способность поиска. Индексатор логов будет использовать распределенный поиск для эффективного поиска.
- Визуализатор: Визуализатор используется для предоставления унифицированного обзора всех логов.
Дизайн для этого метода выглядит следующим образом:
В распределенной системе миллионы серверов, и использование одного накопителя логов серьезно влияет на масштабируемость. Давайте рассмотрим, как мы будем масштабировать нашу систему.
Логирование на различных уровнях
Рассмотрим, как система логирования работает на различных уровнях.
На сервере
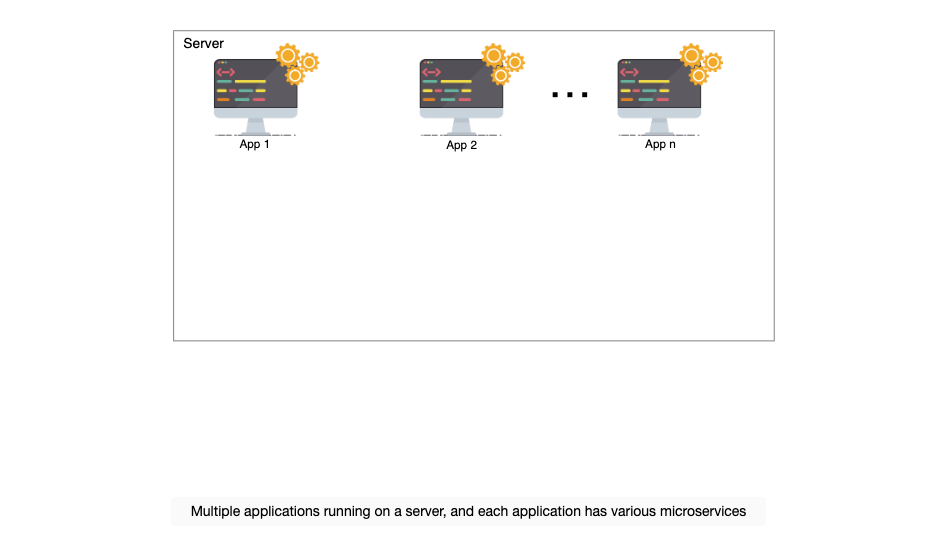
В этом разделе мы узнаем, как различные сервисы, принадлежащие различным приложениям, будут логироваться на сервере.
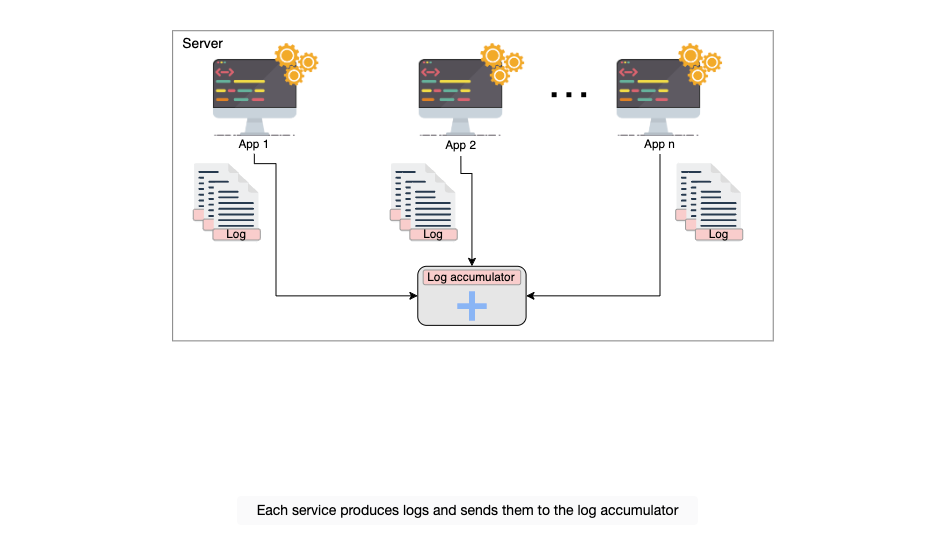
Представим ситуацию, когда у нас есть несколько разных приложений на сервере, например, Приложение 1, Приложение 2 и т.д. Каждое приложение также имеет различные микросервисы. Например, в e-commerce приложении могут одновременно работать такие сервисы, как аутентификация пользователей, получение корзины и другие. Каждый сервис создает логи. Мы используем ID с идентификатором приложения, идентификатором сервиса и меткой времени для уникальной идентификации различных сервисов множества приложений. Метки времени могут помочь нам определить причинно-следственную связь событий.
Каждый сервис будет отправлять свои данные в сервис накопителя логов, который отвечает за следующие действия:
- Прием логов.
- Хранение логов локально.
- Отправка логов в систему pub-sub.
Мы используем систему pub-sub для решения проблемы масштабируемости. Теперь каждый сервер имеет свой накопитель логов (или несколько накопителей), которые отправляют данные в pub-sub. Система pub-sub способна управлять огромным объемом логов.
Чтобы выполнить другое требование по низкой задержке, мы не хотим, чтобы логирование влияло на производительность других процессов, поэтому отправляем логи асинхронно через низкоприоритетный поток. Таким образом, наша система не мешает работе других процессов и обеспечивает доступность.
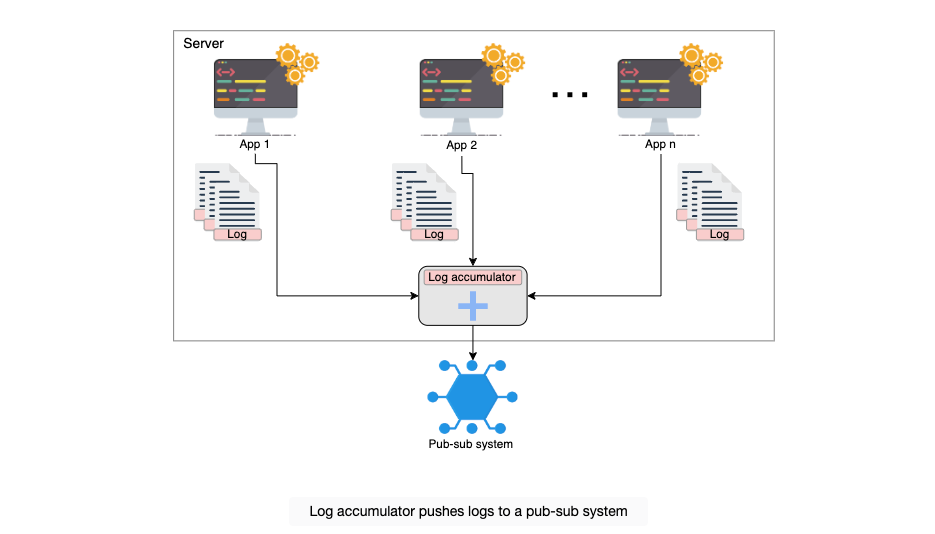
Следует помнить, что данные могут быть утеряны в процессе логирования огромного количества сообщений. Существует компромисс между задержкой, воспринимаемой пользователем, и гарантией сохранения данных логов. Для более низкой задержки лог-сервисы часто хранят данные в ОЗУ и сохраняют их асинхронно. Кроме того, мы можем минимизировать потерю данных, добавив резервные накопители логов для обработки растущего числа пользователей.
Примечание: Для таких приложений, как банковские и финансовые, логи должны быть очень безопасными, чтобы хакеры не могли украсть данные. Общепринятая практика — шифровать данные и логировать их. Таким образом, никто не сможет расшифровать информацию с помощью данных из логов.
How does logging change when we host our service on a multi-tenant cloud (like AWS) versus when an organization has exclusive control of the infrastructure (like Facebook), specifically in terms of logs?
Details
Security might be one aspect that differs between multi-tenant and single-tenant settings. When we encrypt all logs and secure a logging service end-to-end, it does not come free, and has performance penalties. Additionally, strict separation of logs is required for a multi-tenant setting, while we can improve the storage and processing utilization for a single-tenant setting.
Let’s take the example of Meta’s Facebook. They have millions of machines that generate logs, and the size of the logs can be several petabytes per hour. So, each machine pushes its logs to a pub-sub system named Scribe. Scribe retains data for a few days and various other systems process the information residing in the Scribe. They store the logs in distributed storage also. Managing the logs can be application-specific.
On the other hand, for multi-tenancy, we need a separate instance of pub-sub per tenant (or per application) for strict separation of logs.
На уровне датацентра
Все серверы в датацентре отправляют логи в систему pub-sub. Поскольку мы используем горизонтально масштабируемую систему pub-sub, можно управлять огромными объемами логов. Мы можем использовать несколько экземпляров pub-sub в каждом датацентре. Это делает нашу систему масштабируемой и помогает избежать узких мест. Затем система pub-sub отправляет данные в блоб-хранилище.
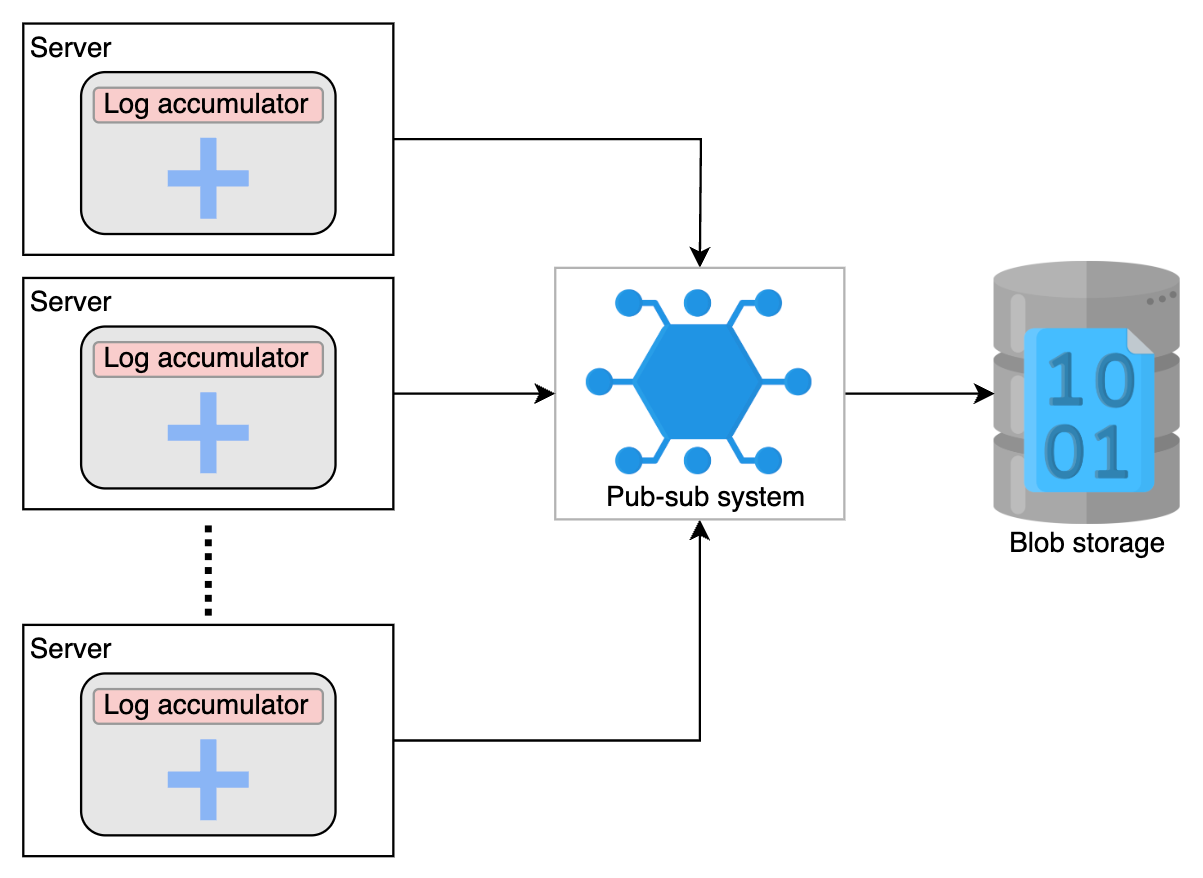
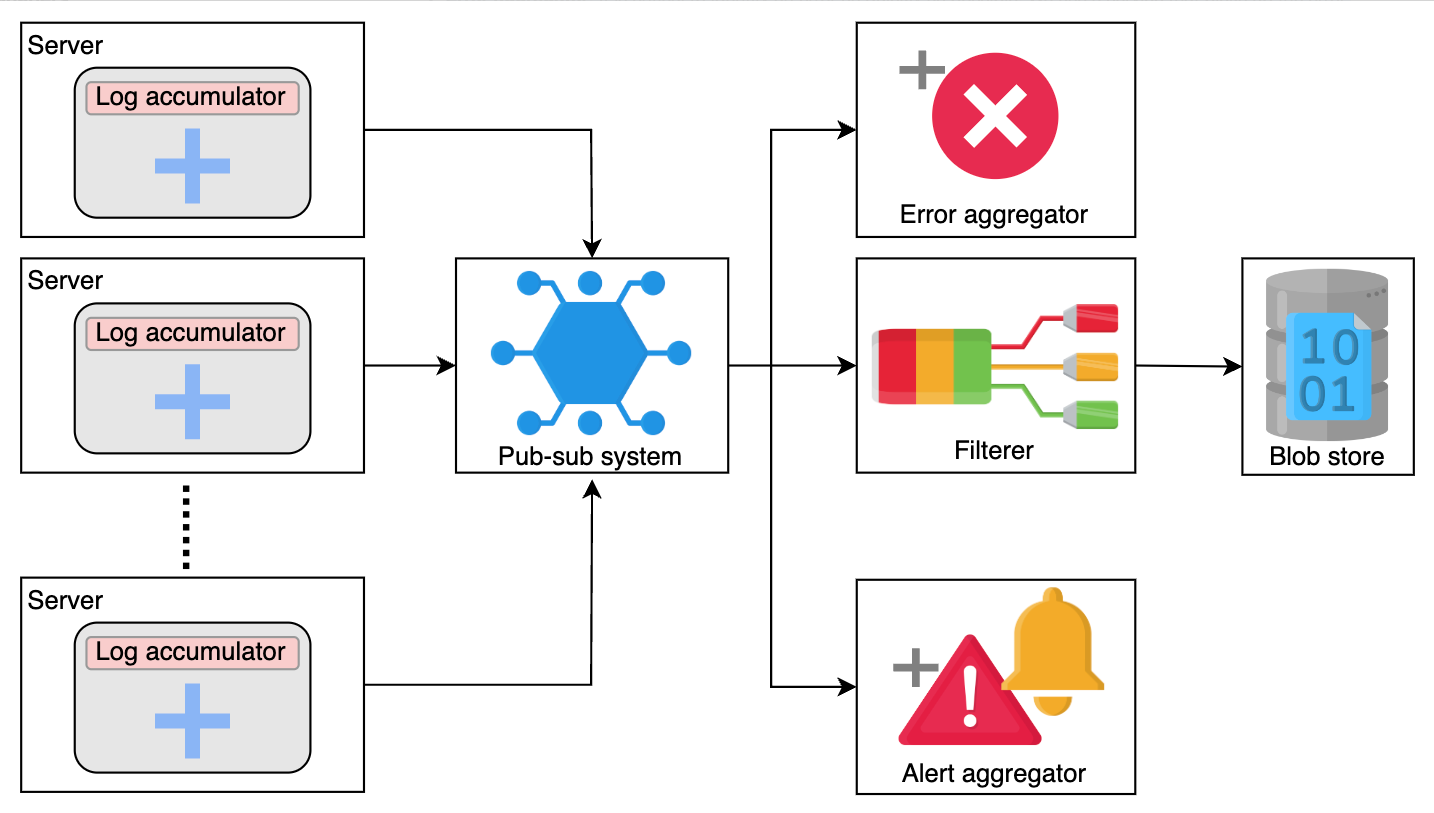
Данные не остаются в pub-sub навсегда и удаляются через несколько дней до помещения в архивное хранилище. Однако мы можем использовать данные, пока они доступны в системе pub-sub. Следующие сервисы будут работать с данными pub-sub:
- Фильтратор: Определяет приложение и сохраняет логи в блоб-хранилище, зарезервированном для этого приложения, поскольку мы не хотим смешивать логи двух разных приложений.
- Агрегатор ошибок: Критически важно быстро идентифицировать ошибки. Мы используем сервис, который подбирает сообщения об ошибках из системы pub-sub и информирует соответствующего клиента. Это избавляет нас от необходимости поиска логов.
- Агрегатор предупреждений: Предупреждения также важны, поэтому важно узнавать о них заранее. Этот сервис идентифицирует предупреждения и уведомляет соответствующих заинтересованных лиц, если обнаружена фатальная ошибка, или отправляет сообщение в инструмент мониторинга.
Обновленный дизайн представлен ниже:
Do we store the logs for a lifetime?
Details
Logs also have an expiration date. We can delete regular logs after a few days or months. Compliance logs are usually stored for up to three to five years. It depends on the requirements of the application.
В нашем дизайне мы определили еще один компонент под названием проверяющий срок действия (expiration checker). Он отвечает за следующие задачи:
- Проверка логов, которые должны быть удалены.
- Проверка логов, которые следует сохранить в холодном хранилище.
Кроме того, наши компоненты индексатор логов и визуализатор работают с блоб-хранилищем, чтобы обеспечить удобный поиск для конечного пользователя. Ниже представлена финальная схема логирования:
We learned earlier that a simple user-level API call to a large service might involve hundreds of internal microservices and thousands of nodes. How can we stitch together logs end-to-end for one request with causality intact?
Details
Most complex services use a front-end server to handle an end user’s request. On reception of a request, the front-end server can get a unique identifier using a sequencer. This unique identifier will be appended to all the fanned-out services. Each log message generated anywhere in the system also emits the unique identifier.
Later, we can filter the log (or preprocess it) based on the unique identifiers. At this step, we are able to collect all the logs across microservices against a unique request. In the Sequencer building block, we discussed that we can get unique identifiers that maintain happens-before causality. Such an identifier has the property that if ID 1 is less than ID 2, then ID 1 represents a time that occurred before ID 2. Now, each log item can use a time- stamp, and we can sort log entries for a specific request in ascending order.
Correctly ordering the log in a chronological (or causal) order simplifies log analyses.
Примечание: Windows Azure Storage System (WAS) использует обширную инфраструктуру логирования в своей разработке. Логи сохраняются на локальных дисках, и, учитывая большое количество логов, они не передаются в распределенное хранилище. Вместо этого используется утилита, похожая на grep, которая работает как распределенный поиск. Таким образом, они получают унифицированный обзор глобально распределенных данных логов.
Существует множество способов проектирования распределенной службы логирования, но это зависит исключительно от требований нашего приложения.
Заключение
Мы узнали, как логирование важно для понимания последовательности событий в распределенной системе. Оно помогает сократить среднее время ремонта (MTTR), направляя нас к коренным причинам проблем. Логирование — это операция с интенсивным вводом-выводом, которая занимает много времени и является медленной. Важно аккуратно обращаться с логированием, чтобы не повлиять на критический путь выполнения других сервисов. Логирование необходимо для мониторинга, поскольку данные, извлеченные из логов, помогают отслеживать состояние приложения. (Эту задачу выполняют агрегаторы предупреждений и ошибок.)