The Distributed Cache
Problem statement
Типичная система состоит из следующих компонентов:
- Клиент, который запрашивает услугу.
- Один или несколько серверов, которые обрабатывают запросы клиента.
- База данных, используемая сервисом для хранения данных.
При нормальных условиях эта абстракция работает хорошо. Однако, с увеличением числа пользователей, количество запросов к базе данных также увеличивается. В результате, серверы перегружаются, что приводит к замедлению производительности.
В таких случаях для предотвращения ухудшения производительности в систему добавляется кэш (cache). Кэш - это временное хранилище данных, которое может обслуживать запросы быстрее, сохраняя наиболее часто запрашиваемые данные в памяти. Когда запрос поступает на сервер, он извлекает данные из кэша (cache hit) и обслуживает пользователя. Однако, если данные недоступны в кэше (cache miss), они запрашиваются из базы данных. Также, кэш пополняется новым значением, чтобы избежать промахов кэша в следующий раз.
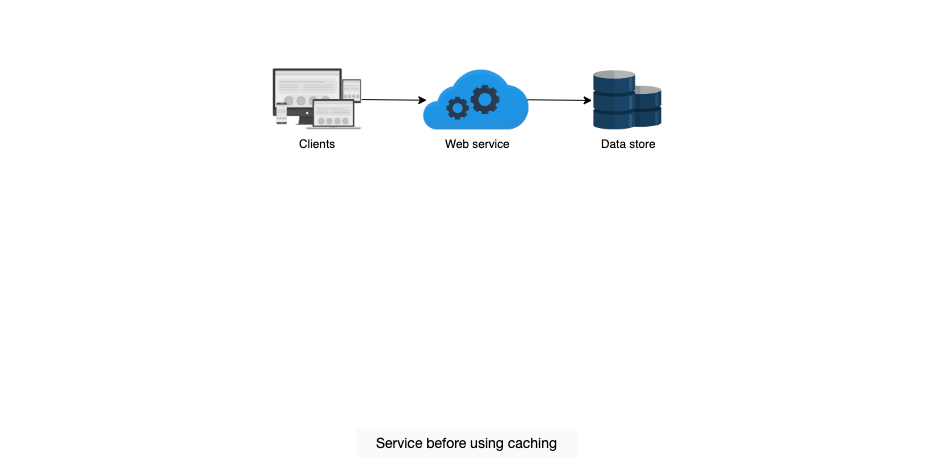
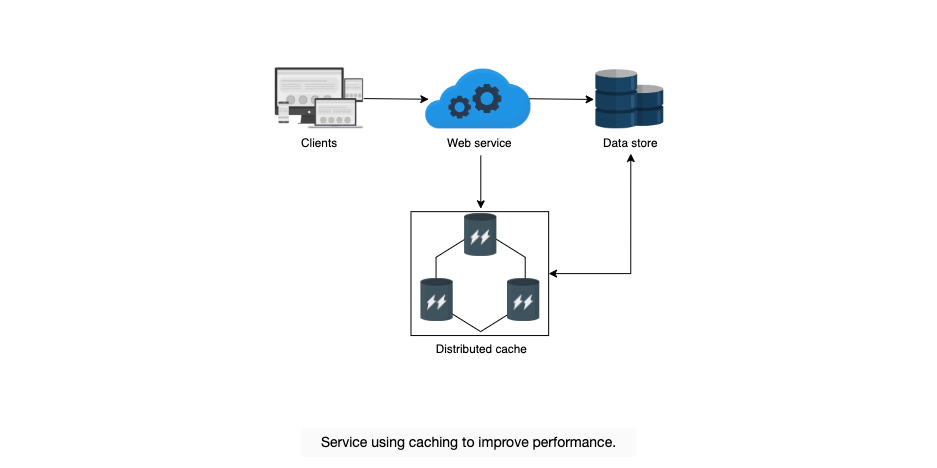
Кэш - это непостоянное хранилище, используемое для хранения данных, которые часто читаются и записываются, что обеспечивает конечному пользователю более низкую задержку. Следовательно, кэш должен предоставлять данные из компонента хранилища, который является быстрым, имеет достаточную емкость и доступен по стоимости при масштабировании сервиса кэширования.
Следующая иллюстрация подчеркивает пригодность RAM в качестве основного строительного блока для кэширования:
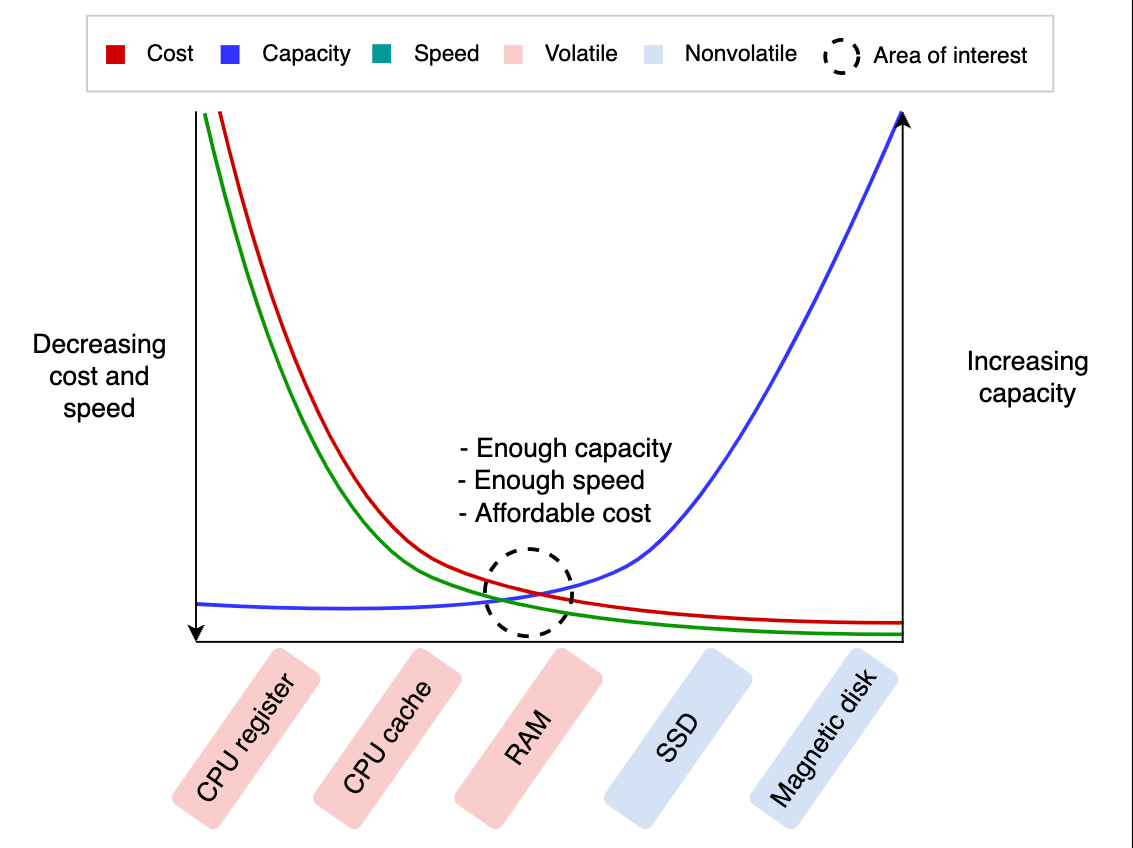
Мы понимаем необходимость использования кэша и подходящего аппаратного обеспечения для хранения, но что такое распределенный кэш (distributed cache)? Давайте обсудим это далее.
Что такое распределенный кэш?
Распределенный кэш - это система кэширования, в которой несколько серверов кэша координируют свою работу для хранения часто запрашиваемых данных. Распределенные кэши необходимы в тех случаях, когда один сервер кэша недостаточен для хранения всех данных. Такая система масштабируема и гарантирует более высокий уровень доступности.
Кэши, как правило, представляют собой небольшое, часто используемое, краткосрочное хранилище с быстрым временем чтения. Кэши используют принцип локальности ссылок (locality of reference).
В чем польза распределенных кэшей?
Распределенные кэши полезны по следующим причинам:
- Они минимизируют задержку, воспринимаемую пользователем, путем предвычисления результатов и хранения часто запрашиваемых данных.
- Они предварительно генерируют сложные запросы из базы данных.
- Они временно хранят данные сессий пользователя.
- Они предоставляют данные из временного хранилища, даже если основное хранилище временно недоступно.
- Наконец, они сокращают сетевые затраты, обслуживая данные из локальных ресурсов.
Почему распределенный кэш?
Когда объем данных, необходимых для кэширования, увеличивается, хранение всех данных в одной системе становится непрактичным по следующим трем причинам:
- Это может стать потенциальной единой точкой отказа (SPOF).
- Система спроектирована слоями, и каждый слой должен иметь свой механизм кэширования, чтобы обеспечить декуплирование чувствительных данных между различными слоями.
- Кэширование в различных точках помогает сократить задержку обслуживания на соответствующем слое.
Кэширование на разных слоях системы
В таблице ниже описано, как кэширование на различных слоях системы осуществляется с использованием различных технологий. Важно отметить, что компоненты key-value store (хранилище типа "ключ-значение") используются на различных уровнях.
| Слой системы | Используемая технология | Назначение |
|---|---|---|
| Веб | HTTP заголовки кэша, веб-ускорители, key-value store, CDN и т.д. | Ускорение получения статического веб-контента, управление сессиями |
| Приложение | Локальный кэш и key-value store | Ускорение вычислений на уровне приложения и извлечение данных |
| База данных | Кэш базы данных, буферы, и key-value store | Сокращение задержки при извлечении данных и уменьшение нагрузки на I/O базы данных |
Помимо трех вышеупомянутых слоев системы, кэширование также осуществляется на уровне DNS и клиентских технологий, таких как браузеры или конечные устройства.
Как мы будем проектировать распределенный кэш?
Мы разделим задачу проектирования и углубленного изучения основных концепций распределенного кэша на пять уроков:
- Основы распределенного кэша: Необходимо создать базовые знания, необходимые для принятия ключевых решений при проектировании распределенного кэша. Этот урок повторит некоторые базовые, но важные концепции.
- Высокоуровневое проектирование распределенного кэша: В этом уроке мы построим высокоуровневую архитектуру распределенного кэша.
- Детализированное проектирование распределенного кэша: Мы выявим некоторые ограничения нашего высокоуровневого дизайна и будем работать над созданием масштабируемого, доступного и производительного решения.
- Оценка проектирования распределенного кэша: Этот урок оценит наш проект по различным нефункциональным требованиям, таким как масштабируемость, консистентность, доступность и т.д.
- Memcached против Redis: Мы обсудим известные промышленные решения, такие как Memcached и Redis. Также рассмотрим их детали и сравним их функции, чтобы понять потенциальные сценарии использования и их связь с нашим проектом.
Как работают распределенный кеш и CDN вместе
-
Рекомендации на основе ML:
- Распределенный кеш используется для хранения результатов работы модели машинного обучения (ML), которая, например, вычислила, какие видео будут интересны конкретному пользователю или когорте пользователей. В этом случае в кеше хранится список ID рекомендованных видео.
-
Обращение к кешу:
- Когда пользователь заходит в приложение или на веб-страницу, где отображаются рекомендации, приложение сначала обращается к распределенному кешу. Кеш возвращает список ID видео, что позволяет избежать повторного вычисления рекомендаций и обеспечивает быстрое реагирование системы.
-
Поиск видео в CDN:
- После получения списка ID видео из кеша приложение начинает запрашивать сами видеофайлы. Для этого оно обращается к CDN (Content Delivery Network), где уже хранятся видео. CDN доставляет видеофайлы пользователю с ближайшего к нему сервера, что минимизирует задержку и обеспечивает высокую скорость загрузки.
Почему оба подхода важны
-
Распределенный кеш:
- Используется для хранения динамически изменяющихся данных (например, рекомендации, сессии пользователей), что ускоряет работу приложения и снижает нагрузку на базу данных.
-
CDN:
- Эффективен для доставки статического контента (например, видеофайлов, изображений) пользователям по всему миру с минимальной задержкой.
Пример процесса взаимодействия
- Пользователь открывает приложение.
- Приложение обращается к распределенному кешу, чтобы получить список рекомендованных видео.
- Приложение запрашивает первое видео из списка в CDN.
- Видео быстро доставляется с ближайшего сервера CDN и отображается пользователю.
Важность обоих инструментов
Таким образом, распределенный кеш обеспечивает быстрое получение рекомендаций и другой динамической информации, а CDN гарантирует, что сами видео или другие статические ресурсы будут доставлены пользователю с минимальной задержкой. Эти два инструмента вместе делают пользовательский опыт быстрым и персонализированным.
Background of Distributed Cache
Основная цель этой главы — спроектировать распределенный кэш. Для достижения этой цели необходимо обладать значительными знаниями о различных техниках чтения и записи данных. Этот урок поможет нам построить такую базу знаний. Давайте рассмотрим структуру этого урока в таблице ниже.
Структура урока
| Раздел | Описание |
|---|---|
| Политики записи | Данные записываются в кэш и базы данных. Порядок записи данных влияет на производительность. Мы обсудим различные политики записи, чтобы определить, какая из них будет наиболее подходящей для проектируемого распределенного кэша. |
| Политики вытеснения | Так как кэш построен на ограниченном хранилище (RAM), мы стремимся хранить в нем наиболее часто запрашиваемые данные. Поэтому мы обсудим разные политики вытеснения, чтобы заменять менее часто используемые данные на наиболее востребованные. |
| Инвалидация кэша | Некоторые кэшированные данные могут устаревать. Мы рассмотрим различные методы инвалидации, чтобы удалять устаревшие или неактуальные записи из кэша. |
| Механизм хранения | В распределенном хранилище много серверов. Мы обсудим важные проектные аспекты, такие как на каком сервере хранить ту или иную запись кэша и какую структуру данных использовать для хранения. |
| Клиент кэша | Сервер кэша хранит записи кэша, но клиент кэша обращается к серверу кэша с запросом данных. В этом разделе мы рассмотрим детали клиентской библиотеки кэша. |
Политики записи
Часто кэш хранит копию (или часть) данных, которые сохраняются в постоянном хранилище (например, в базе данных). Когда мы записываем данные в базу данных, возникают важные вопросы:
- Куда мы сначала записываем данные: в базу данных или в кэш?
- Какие последствия каждая из стратегий записи имеет для моделей консистентности?
Краткий ответ заключается в том, что это зависит от требований приложения. Рассмотрим подробнее различные политики записи, чтобы лучше понять концепцию:
-
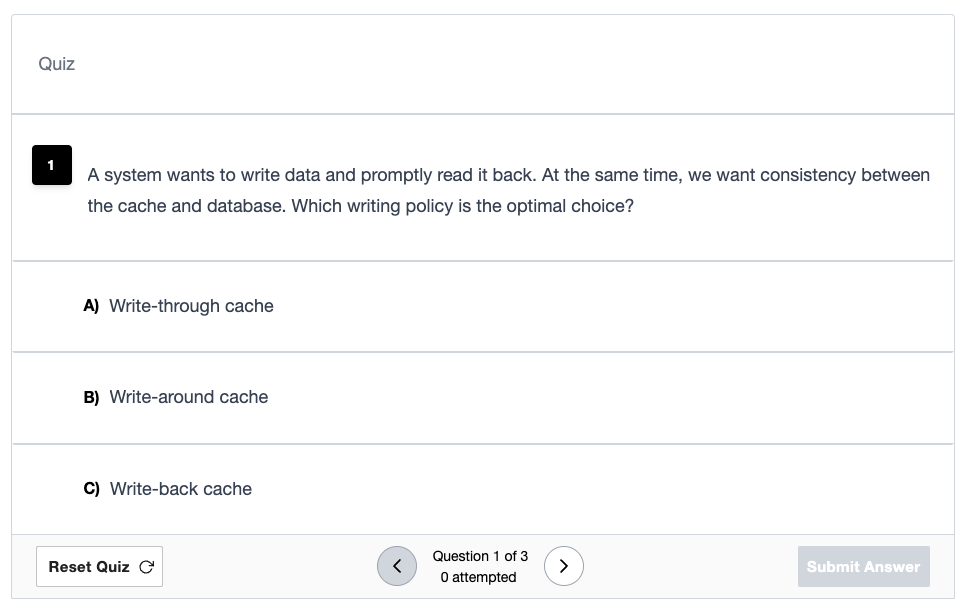
Write-through cache: В механизме write-through запись происходит как в кэш, так и в базу данных. Запись в оба хранилища может происходить одновременно или последовательно. Это увеличивает задержку записи, но обеспечивает строгую консистентность между базой данных и кэшем.
-
Write-back cache: В механизме write-back cache данные сначала записываются в кэш, а затем асинхронно записываются в базу данных. Хотя кэш содержит обновленные данные, неизбежна ситуация, когда клиент может прочитать устаревшие данные из базы данных. Однако системы, использующие эту стратегию, будут иметь минимальную задержку при записи.
-
Write-around cache: Эта стратегия предполагает запись данных только в базу данных. Позже, при запросе этих данных, они записываются в кэш после возникновения cache miss (промаха кэша). В этом случае база данных будет содержать актуальные данные, но такая стратегия не подходит для чтения недавно обновленных данных.
Политики вытеснения
Одна из главных причин высокой производительности кэшей заключается в их небольшом размере. Однако ограниченная емкость кэша требует механизма вытеснения данных, чтобы удалять менее часто запрашиваемые данные из кэша.
Существует несколько хорошо известных стратегий вытеснения данных из кэша. Среди них наиболее популярны следующие:
- Least Recently Used (LRU) — Вытесняются данные, которые не использовались дольше всех.
- Most Recently Used (MRU) — Вытесняются данные, которые использовались последними.
- Least Frequently Used (LFU) — Вытесняются данные, которые использовались наименее часто.
- Most Frequently Used (MFU) — Вытесняются данные, которые использовались наиболее часто.
Существуют также другие стратегии, такие как First In, First Out (FIFO). Выбор алгоритма зависит от системы, для которой разрабатывается кэш.
Классификация данных по частоте доступа
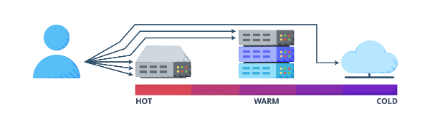
Данные могут быть классифицированы в зависимости от частоты доступа на три температурные области:
- Горячие данные (Hot): Данные, к которым часто обращаются.
- Теплые данные (Warm): Данные, к которым обращаются реже.
- Холодные данные (Cold): Данные, к которым обращаются очень редко.
Холодные данные часто вытесняются из кэша и заменяются горячими или теплыми данными.
Инвалидация кэша
Помимо вытеснения менее часто запрашиваемых данных, некоторые данные, находящиеся в кэше, могут со временем устареть. Такие записи кэша считаются неактуальными и должны быть помечены для удаления.
Возникает вопрос: как определить устаревшие записи?
Для решения этой проблемы необходимо хранить метаданные для каждой записи в кэше, в частности, поддерживать значение time-to-live (TTL), чтобы справляться с устаревшими элементами кэша.
Существуют два подхода к работе с устаревшими элементами, используя TTL:
- Активное истечение (Active expiration): Этот метод активно проверяет TTL записей в кэше через процесс или поток-демон.
- Пассивное истечение (Passive expiration): Этот метод проверяет TTL записи кэша в момент обращения к ней.
Каждый просроченный элемент удаляется из кэша при обнаружении.
Механизм хранения
Хранение данных в кэше не так просто, как кажется, особенно когда распределенный кэш имеет несколько серверов. При использовании нескольких серверов кэша необходимо ответить на следующие вопросы:
- Какие данные следует хранить на каких серверах кэша?
- Какую структуру данных использовать для хранения?
Эти вопросы важны, поскольку они будут определять производительность нашего распределенного кэша, что является нашим главным требованием. Для ответа на эти вопросы мы будем использовать следующие техники.
Хеш-функция
Возможны два сценария использования хеширования:
- Определение сервера кэша в распределенном кэше для хранения и извлечения данных.
- Поиск записей кэша внутри каждого сервера кэша.
Для первого сценария можно использовать различные алгоритмы хеширования. Однако consistent hashing или его варианты обычно хорошо работают в распределенных системах, поскольку простое хеширование не будет оптимальным в случае сбоев или масштабирования.
Во втором сценарии можно использовать типичные хеш-функции для поиска записи кэша при чтении или записи внутри сервера кэша. Однако сама по себе хеш-функция только определяет местоположение записи в кэше. Она ничего не говорит о том, как управлять данными внутри сервера кэша, например, о стратегии вытеснения менее часто используемых данных или о том, какие структуры данных используются для хранения данных на серверах кэша.
Связанный список
Мы будем использовать двусвязный список. Основная причина — его широкое применение и простота. Кроме того, добавление и удаление данных из двусвязного списка в нашем случае будет операцией с постоянным временем. Это потому, что мы либо вытесняем конкретную запись с хвоста списка, либо перемещаем запись в начало списка. Таким образом, итерации не требуются.
Примечание: Bloom filters — интересный выбор для быстрого определения, существует ли запись кэша на сервере. Они могут использоваться для определения того, что запись кэша определенно отсутствует на сервере, но вероятность её присутствия является вероятностной. Bloom filters весьма полезны в больших системах кэширования или базах данных.
Шардинг в кэш-кластерах
Чтобы избежать единой точки отказа (SPOF) и высокой нагрузки на один экземпляр кэша, мы вводим шардинг. Шардинг включает в себя разделение данных кэша между несколькими серверами кэша. Он может выполняться двумя способами:
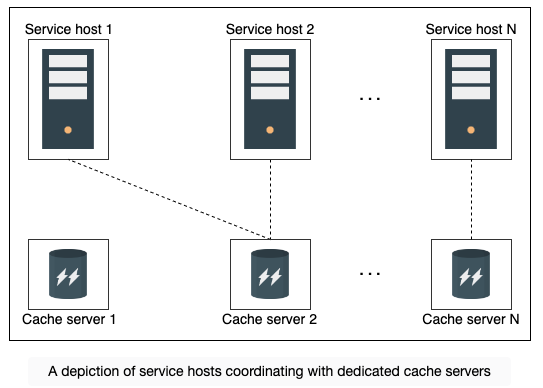
- Выделенные серверы кэша:
- В этом методе мы отделяем серверы приложений и веб-сервера от серверов кэша.
- Преимущества выделенных серверов кэша:
- Гибкость в выборе аппаратного обеспечения для каждой функции.
- Возможность масштабировать веб/приложение и серверы кэша отдельно.
- Кроме того, работа в качестве автономной службы кэширования позволяет другим микросервисам использовать её, например, кэш как услуга (Cache as a Service). В этом случае система кэширования должна быть осведомлена о разных приложениях, чтобы их данные не пересекались.
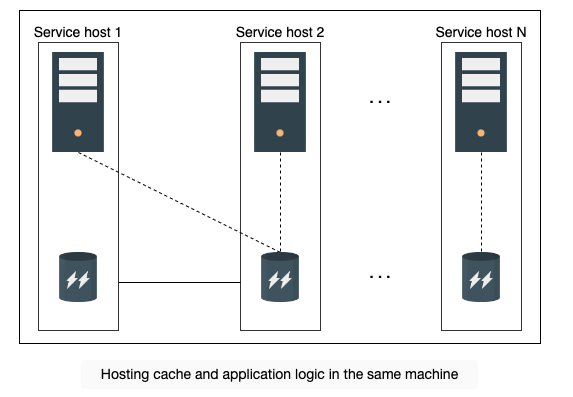
- Совместное размещение кэша (Co-located cache):
- Кэш и сервисная функциональность находятся на одном хосте.
- Преимущество этой стратегии — сокращение капитальных (CAPEX) и операционных затрат (OPEX) на дополнительное оборудование. Кроме того, при масштабировании одной службы автоматически масштабируется и другая служба. Однако сбой одной машины приведет к одновременному отключению обеих служб.
Клиент кэша
Мы обсуждали, что хеш-функции следует использовать для выбора серверов кэша. Но какой элемент выполняет эти вычисления?
Клиент кэша — это фрагмент кода, находящийся на серверах, который выполняет вычисления (хеширование) для хранения и извлечения данных на серверах кэша. Также клиенты кэша могут координировать работу с другими компонентами системы, такими как службы мониторинга и конфигурации. Все клиенты кэша запрограммированы одинаково, чтобы одни и те же операции PUT и GET от разных клиентов возвращали одинаковые результаты. Некоторые характеристики клиентов кэша:
- Каждый клиент кэша знает обо всех серверах кэша.
- Все клиенты могут использовать известные транспортные протоколы, такие как TCP или UDP, для общения с серверами кэша.
What will be the behavior of cache clients to an access request if one of the cache servers is dead?
Details
Since the data within the cache servers will no longer be available, cache clients will mark that access request as a cache miss.
High-level Design of a Distributed Cache
Требования
Начнем с понимания требований к нашему решению.
Функциональные требования
Следующие требования относятся к функциональным:
- Вставка данных: Пользователь распределенной системы кэширования должен иметь возможность добавлять запись в кэш.
- Извлечение данных: Пользователь должен иметь возможность извлекать данные, соответствующие определенному ключу.
Нефункциональные требования
Мы будем учитывать следующие нефункциональные требования:
-
Высокая производительность: Основная причина использования кэша — это обеспечение быстрого доступа к данным. Следовательно, операции вставки и извлечения должны быть быстрыми.
-
Масштабируемость: Система кэширования должна масштабироваться горизонтально без узких мест при увеличении числа запросов.
-
Высокая доступность: Недоступность кэша увеличит нагрузку на серверы баз данных, которые также могут выйти из строя в периоды пиковых нагрузок. Наша система должна выдерживать случайные отказы компонентов и сети, а также отключения электропитания.
-
Консистентность: Данные, хранящиеся на серверах кэша, должны быть консистентными. Например, разные клиенты кэша, извлекающие одни и те же данные с разных серверов кэша (основного или вторичного), должны получать актуальные данные.
-
Доступность по цене: Идеально, чтобы система кэширования была разработана на основе стандартного оборудования, а не дорогих компонентов, используемых в архитектуре системы.
Дизайн API
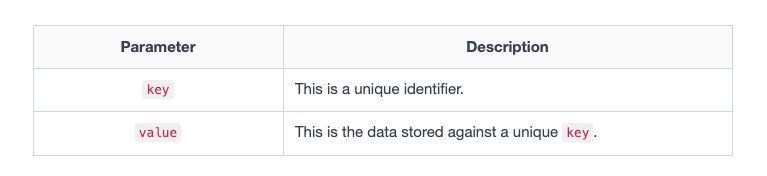
Дизайн API для этой задачи достаточно прост, так как существует только две базовые операции.
Вставка
API вызов для выполнения вставки должен выглядеть следующим образом:
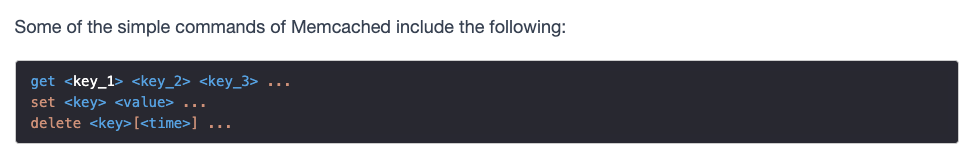
insert(key, value);
Retrieval
The API call to retrieve data from the cache should look like this:
retrieve(key);

The API design of the distributed cache looks exactly like the key-value store. What are the possible differences between a key-value store and a distributed cache?
Details
Some of the key differences are the following:
- Key-value stores need to durably store data (persistence). A cache is used in addition to persistent storage to increase reading performance.
- A cache serves data from the RAM. A key-value store writes data to non-volatile storage.
- Key-value stores are robust and should survive failures. However, caches can crash and be populated from scratch after recovery.
Design considerations
Прежде чем приступить к проектированию распределенной системы кэширования, важно учесть некоторые ключевые аспекты дизайна. Каждое из этих решений будет основано исключительно на требованиях нашего приложения. Однако можно выделить некоторые важные различия:
Аппаратное обеспечение для хранения данных
Если наши данные имеют большой объем, нам может потребоваться шардинг и использование серверов-шардов для разделения кэша. Стоит ли использовать специализированное или стандартное оборудование для серверов-шардов? Специализированное оборудование будет обладать хорошей производительностью и емкостью хранения, но обойдется дороже. Альтернативой может быть построение крупного кэша на основе стандартных серверов. В общем, количество серверов-шардов будет зависеть от размера кэша и частоты доступа к нему.
Кроме того, можно рассмотреть возможность хранения данных на вторичном хранилище этих серверов для обеспечения устойчивости, при этом данные будут обслуживаться из RAM. Вторичное хранилище может использоваться в случаях перезагрузки системы, когда восстановление кэша занимает много времени. Однако устойчивость может не являться требованием для системы кэширования, если существует выделенный слой устойчивости, например, база данных.
Структуры данных
Ключевая часть дизайна — скорость доступа к данным. Хеш-таблицы — это структуры данных, которые в среднем обеспечивают постоянное время для хранения и извлечения данных. Кроме того, нам потребуется другая структура данных для реализации алгоритма вытеснения кэшированных данных. В частности, связанные списки являются хорошим вариантом (как обсуждалось в предыдущем уроке).
Также важно понять, какие структуры данных может хранить кэш. Хотя в разделе по дизайну API мы обсуждали использование строк для упрощения, возможно хранение различных структур данных или форматов, таких как хеш-мапы, массивы, множества и т.д. В следующем уроке мы рассмотрим практический пример такого кэша.
Клиент кэша
Клиент кэша — это процесс или библиотека, которые инициируют вызовы для вставки и извлечения данных. Местоположение клиентского процесса — важный аспект дизайна. Например, возможно размещение клиента кэша внутри обслуживающего хоста, если кэш предназначен только для внутреннего использования. В противном случае, если система кэширования предоставляется как услуга для внешнего использования, выделенный клиент кэша может отправлять запросы пользователей на серверы кэша.
Политика записи
Стратегия записи в кэш и базу данных имеет важное значение для обеспечения консистентности данных. В общем случае не существует оптимального выбора, но предпочтение той или иной политики записи зависит от нашего приложения.
Политика вытеснения
Кэш по своему дизайну обеспечивает низкую задержку при чтении и записи данных. Для достижения этого данные обычно обслуживаются из памяти RAM. Как правило, невозможно хранить все данные в кэше из-за его ограниченного размера по сравнению с полным набором данных. Поэтому необходимо тщательно выбирать, какие данные должны оставаться в кэше, а также как освобождать место для новых записей.
С добавлением новых данных некоторые существующие данные могут быть вытеснены из кэша. Однако выбор записи-жертвы зависит от политики вытеснения. Существует множество политик вытеснения, но выбор опять-таки зависит от используемого приложения. Например, Least Recently Used (LRU) может быть хорошим выбором для социальных сетей, где недавно загруженный контент, вероятно, получит больше всего просмотров.
Кроме того, оптимизация значения time-to-live (TTL) может сыграть важную роль в уменьшении количества промахов кэша.
Высокоуровневый дизайн
Следующая схема изображает наш высокоуровневый дизайн:
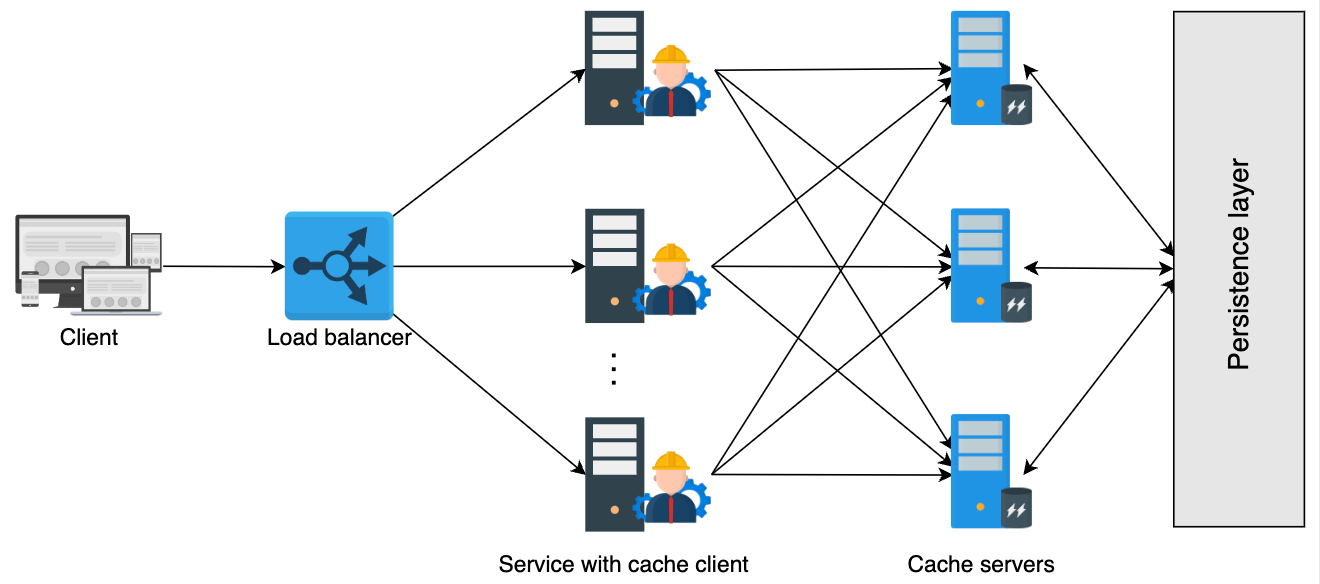
Основные компоненты в этом высокоуровневом дизайне
Клиент кэша
Клиент кэша — это библиотека, которая находится на сервере приложений. Она содержит всю информацию о серверах кэша. Клиент кэша будет выбирать один из серверов кэша с помощью алгоритмов хеширования и поиска для каждого входящего запроса на вставку или извлечение данных. Все клиенты кэша должны иметь согласованное представление обо всех серверах кэша. Также техника разрешения для перемещения данных на серверы кэша и с них должна быть одинаковой. В противном случае разные клиенты будут обращаться к разным серверам за одними и теми же данными.
Серверы кэша
Серверы кэша поддерживают кэш данных. Каждый сервер кэша доступен всем клиентам кэша. Каждый сервер подключен к базе данных для хранения или извлечения данных. Клиенты кэша используют протоколы TCP или UDP для выполнения передачи данных на серверы кэша или с них. Однако, если какой-либо сервер кэша выходит из строя, запросы к этим серверам рассматриваются клиентами кэша как cache miss (промах кэша).
Detailed Design of a Distributed Cache
Найти и устранить ограничения
Прежде чем перейти к детализированному проектированию, необходимо понять и преодолеть некоторые вызовы:
Ограничения текущего решения
-
Отсутствие механизма обнаружения изменения серверов кэша:
- В текущем решении нет способа для клиента кэша узнать о добавлении нового сервера кэша или о выходе из строя существующего сервера.
-
Проблема единой точки отказа (SPOF):
- Существует риск единой точки отказа, поскольку для каждого набора данных кэша используется один сервер кэша. Кроме того, если некоторые данные на сервере кэша часто запрашиваются (это обычно называется проблемой hotkey), производительность системы может снизиться.
-
Недостаточная проработка внутренних аспектов серверов кэша:
- Текущее решение не раскрывает внутреннюю реализацию серверов кэша, включая используемые структуры данных и политику вытеснения.
Поддержка списка серверов кэша
Начнем с решения первой проблемы. Мы будем поэтапно двигаться к наилучшему возможному решению. Рассмотрим следующие шаги, чтобы понять каждое из предложенных решений:
-
Поддержка динамического обновления списка серверов:
- Необходимо разработать механизм, который позволит клиентам кэша динамически узнавать о добавлении или удалении серверов кэша. Это можно реализовать с помощью распределенной системы мониторинга или координации, например, Zookeeper или Consul.
-
Репликация и распределение данных:
- Чтобы устранить SPOF и улучшить производительность при доступе к горячим данным, можно использовать репликацию данных на несколько серверов кэша и внедрить алгоритмы балансировки нагрузки.
-
Оптимизация внутренних механизмов серверов кэша:
- Важно проработать детали реализации серверов кэша, включая выбор структуры данных (например, хеш-таблиц, двусвязных списков) и политики вытеснения (например, LRU, LFU) для эффективного управления кэшем.
Продолжим работу над улучшением нашего решения, рассматривая возможные подходы к реализации указанных улучшений.
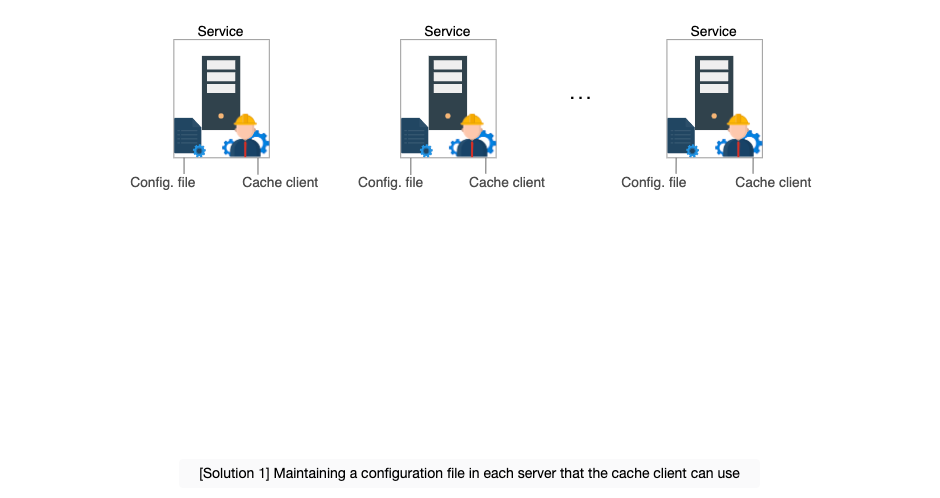
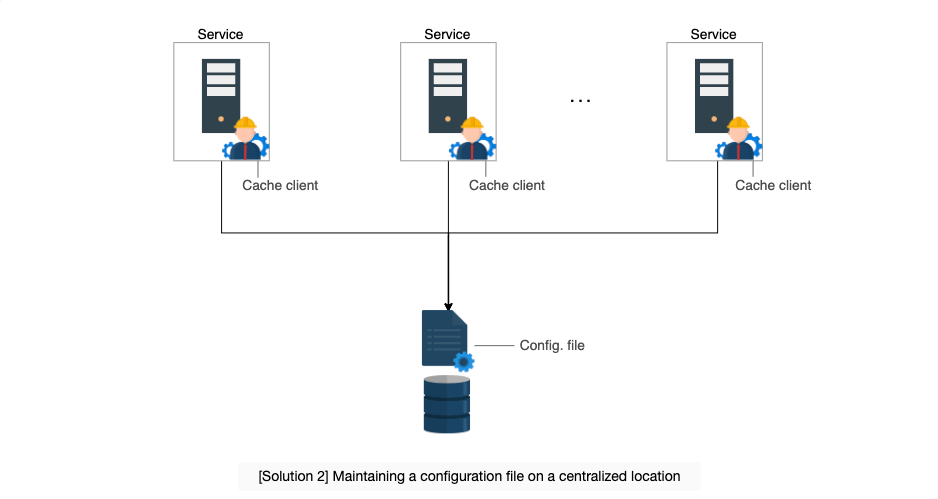
Решение 1: Конфигурационный файл на каждом сервисном хосте
В каждом из сервисных хостов, где находятся клиенты кэша, можно использовать конфигурационный файл. Этот файл будет содержать обновленную информацию о состоянии и метаданные, необходимые для эффективного использования серверов кэша клиентами. Каждая копия конфигурационного файла может обновляться с помощью push-сервиса через любой DevOps инструмент.
Проблема: Основной недостаток этой стратегии заключается в том, что конфигурационный файл необходимо вручную обновлять и развертывать с помощью DevOps инструментов.
Решение 2: Центральное хранилище конфигурации
Мы можем хранить конфигурационный файл в центральном хранилище, откуда клиенты кэша смогут получать обновленную информацию о серверах кэша. Это решает проблему развертывания, но по-прежнему требует ручного обновления конфигурационного файла и мониторинга состояния каждого сервера.
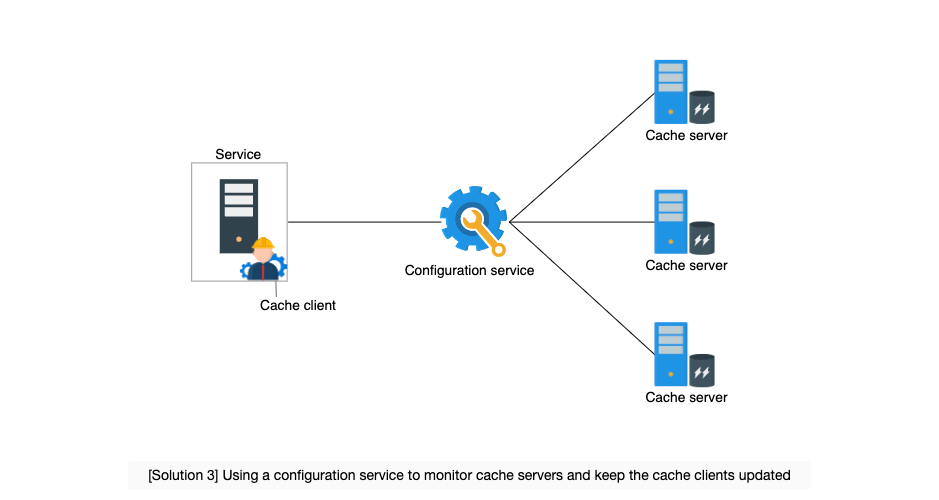
Решение 3: Автоматическая система конфигурации
Автоматизированное решение — использование службы конфигурации, которая непрерывно отслеживает состояние серверов кэша. Клиенты кэша будут получать уведомления о добавлении нового сервера кэша в кластер. При использовании этой стратегии не требуется человеческое вмешательство или мониторинг в случае отказов или добавления новых узлов. Наконец, клиенты кэша будут получать список серверов кэша от службы конфигурации.
Преимущества:
- Служба конфигурации обеспечивает максимальную устойчивость среди всех предложенных решений.
- Клиенты кэша автоматически обновляются, что снижает риск ошибок и увеличивает надежность системы.
Недостатки:
- Высокие операционные расходы.
- Сложность реализации.
Повышение доступности
Вторая проблема связана с недоступностью кэша в случае отказа серверов кэша. Простое решение — добавление реплик узлов. Можно начать с добавления одного основного и двух резервных узлов в каждом шарде кэша.
Проблемы консистентности:
- Реплики могут вызывать проблемы консистентности. Если реплики расположены близко друг к другу, записи на них выполняются синхронно, чтобы избежать несоответствий между репликами шарда.
Преимущества:
- Повышенная доступность в случае отказов.
- Возможность распределения чтений между основными и вторичными узлами в горячих шардах.
Результат:
- Улучшение как доступности, так и производительности системы.
Внутренняя структура сервера кэша
Каждый клиент кэша должен использовать три механизма для хранения и вытеснения записей на серверах кэша:
-
Хеш-таблица:
- Сервер кэша использует хеш-таблицу для хранения или поиска различных записей внутри RAM. Эта структура данных обеспечивает быстрый доступ к данным.
-
Двусвязный список:
- Если необходимо вытеснить данные из кэша, используется двусвязный список, который позволяет упорядочить записи по частоте их доступа. Данная структура помогает эффективно управлять процессом вытеснения.
-
Политика вытеснения:
- Политика вытеснения выбирается в зависимости от требований приложения. В данном случае используется политика Least Recently Used (LRU).
Шардинг и структура данных узлов
На следующем изображении представлена схема шардированного кластера с указанием структуры данных узлов:
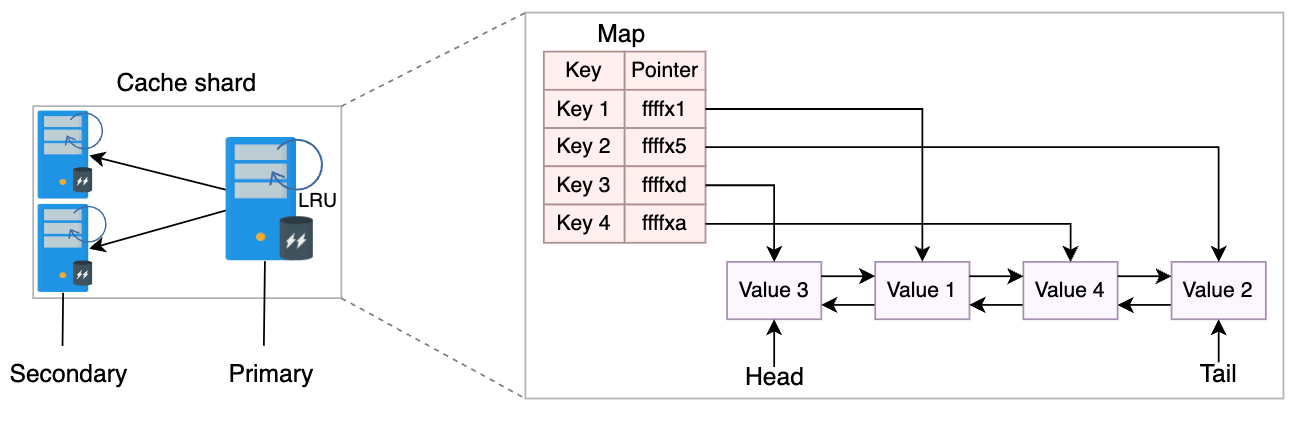
Отсутствие API для удаления
Из предыдущего объяснения становится ясно, что в нашем дизайне не предусмотрен API для удаления. Это связано с тем, что вытеснение данных (с помощью алгоритма вытеснения) и удаление просроченных записей (через TTL) выполняются локально на серверах кэша. Однако могут возникнуть ситуации, когда API для удаления может понадобиться. Например, когда недавно добавленная запись удаляется из базы данных, соответствующий элемент должен быть удален из кэша для обеспечения консистентности данных.
Необходимость в API для удаления
- Консистентность данных: Если элемент удаляется из базы данных, его удаление из кэша также становится критически важным для поддержания консистентности. В противном случае, кэшированные данные могут стать устаревшими, что приведет к тому, что клиенты кэша будут получать неверные данные.
Решение
- API для удаления: Следует разработать и внедрить API для удаления, который позволит удалять определенные записи из кэша. Этот API должен быть интегрирован с операциями в базе данных, чтобы гарантировать синхронизацию удаления данных между базой данных и кэшем.
Пример сценария использования
- Удаление записи из базы данных: Пользователь удаляет определенную запись из базы данных.
- Удаление записи из кэша: API для удаления автоматически вызывается для удаления соответствующей записи из кэша.
- Обновление консистентности: После удаления из кэша клиент будет вынужден получить обновленные данные из базы данных при следующем запросе.
Заключение
Включение API для удаления в дизайн распределенного кэша поможет поддерживать актуальность данных и их согласованность между кэшем и базой данных, что особенно важно в критически важных приложениях.
Детализированный дизайн
После устранения трех ранее обозначенных проблем мы готовы формализовать детализированный дизайн. Ниже приведен его обзор:
Ключевые аспекты детализированного дизайна
-
Запросы клиентов:
- Запросы клиентов поступают на серверы приложений через балансировщики нагрузки, где расположены клиенты кэша.
-
Консистентное хеширование:
- Каждый клиент кэша использует механизм консистентного хеширования для определения сервера кэша, который обслуживает определенный шард. Далее клиент кэша перенаправляет запрос на сервер кэша, который управляет конкретным шардом.
-
Первичные и резервные серверы:
- Каждый сервер кэша имеет основный (primary) и резервные (replica) сервера. Внутри каждого сервера используются одни и те же механизмы для хранения и вытеснения записей кэша.
-
Служба конфигурации:
- Служба конфигурации обеспечивает, чтобы все клиенты видели актуальное и согласованное состояние серверов кэша.
-
Служба мониторинга:
- Дополнительно можно использовать службы мониторинга для ведения журналов и отчётности по различным метрикам системы кэширования.
Основные особенности дизайна
- Использование RAM:
- Важным аспектом дизайна является то, что записи кэша хранятся и извлекаются из RAM. Мы обсуждали пригодность RAM для проектирования системы кэширования в предыдущем уроке. RAM обеспечивает быструю скорость доступа, что критически важно для производительности кэша.
Резюме
- Запросы клиентов обрабатываются через балансировщики нагрузки и направляются к клиентам кэша на сервере приложений.
- Консистентное хеширование позволяет клиентам кэша точно определять сервер, который обслуживает нужный шард данных.
- Сервера кэша используют репликацию для повышения отказоустойчивости и производительности.
- Служба конфигурации поддерживает актуальность и согласованность информации о серверах кэша для всех клиентов.
- Мониторинг позволяет следить за производительностью и стабильностью системы кэширования.
Этот детализированный дизайн обеспечивает масштабируемость, высокую доступность и производительность распределенной системы кэширования.
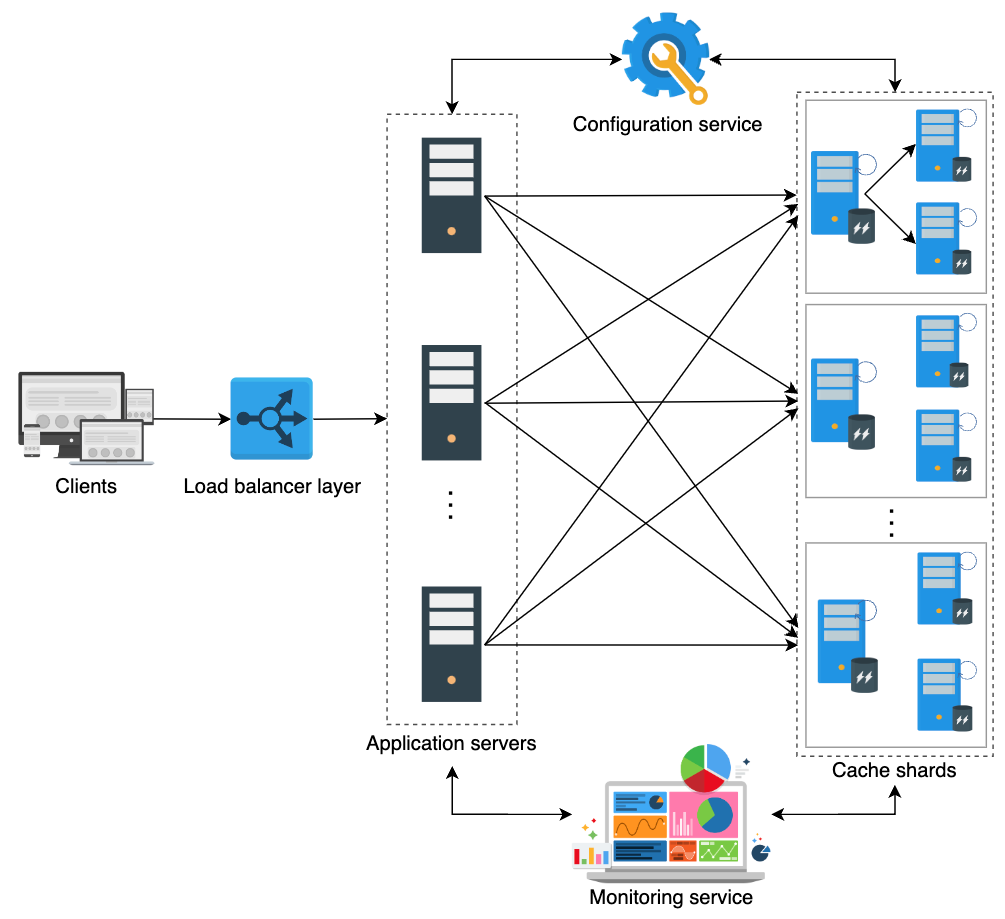
Сводка предложенного детализированного дизайна
-
Запросы клиентов:
- Запросы клиентов поступают на серверы приложений через балансировщики нагрузки, где находятся клиенты кэша.
-
Консистентное хеширование:
- Каждый клиент кэша использует консистентное хеширование для определения сервера кэша, который обслуживает определенный шард. Затем клиент кэша перенаправляет запрос на соответствующий сервер кэша.
-
Основные и резервные серверы:
- Каждый сервер кэша имеет основной сервер и один или несколько резервных серверов. Внутри каждого сервера используются одинаковые механизмы для хранения и вытеснения записей кэша.
-
Служба конфигурации:
- Служба конфигурации гарантирует, что все клиенты видят актуальную и согласованную информацию о серверах кэша.
-
Служба мониторинга:
- Дополнительно могут использоваться службы мониторинга для ведения журналов и отчетности по различным метрикам системы кэширования.
Примечание: Важным аспектом дизайна является то, что записи кэша хранятся и извлекаются из RAM. Мы обсуждали пригодность RAM для проектирования системы кэширования в предыдущем уроке.
While consistent hashing is a good choice, it may result in unequal distribution of data, and certain servers may get overloaded. How do we resolve this problem?
Details
A number of consistent hashing algorithms’ flavors have been suggested over time. We can use one such flavor (used here) that distributes load uniformly and even makes multiple copies of the same data on different cache servers. Each cache server can have virtual servers inside it, and the number of virtual servers in a machine depends on the machine’s capability. This results in a finer control on the amount of load on a cache server. At the same time, it improves availability.
Evaluation of a Distributed Cache's Design
Высокая производительность
Вот некоторые решения в дизайне, которые способствуют общей хорошей производительности:
-
Консистентное хеширование:
- Поиск ключа с использованием этого алгоритма требует временной сложности O(log(N)), где N — количество шардов кэша.
-
Хеш-таблицы внутри сервера кэша:
- Ключи внутри сервера кэша находятся с использованием хеш-таблиц, что в среднем требует постоянного времени.
-
Алгоритм вытеснения LRU:
- Использование алгоритма вытеснения LRU обеспечивает доступ и обновление записей в двусвязном списке за постоянное время.
-
Быстрая коммуникация:
- Взаимодействие между клиентами и серверами кэша осуществляется через протоколы TCP и UDP, что также обеспечивает высокую скорость передачи данных.
-
Репликация:
- Добавление реплик позволяет снизить потери в производительности при высоких нагрузках на одну машину.
-
Использование RAM:
- Критической особенностью дизайна является хранение, извлечение и обслуживание данных из RAM. Поэтому задержка при выполнении этих операций очень низкая.
Примечание: Ключевым параметром для обеспечения высокой производительности является выбор алгоритма вытеснения, так как от него зависит количество попаданий и промахов кэша. Чем выше процент попаданий, тем лучше производительность.
Пример: Важность алгоритма вытеснения
Рассмотрим следующие условия:
- Время обслуживания при попадании в кэш (99.9-й перцентиль): 5 мс
- Время обслуживания при промахе кэша (99.9-й перцентиль): 30 мс (включает время получения данных из базы данных и их запись в кэш)
Предположим, что при использовании алгоритма MFU (Most Frequently Used) у нас наблюдается 10% промахов кэша, а при использовании LRU (Least Recently Used) — 5% промахов кэша. Тогда мы можем использовать следующую формулу:
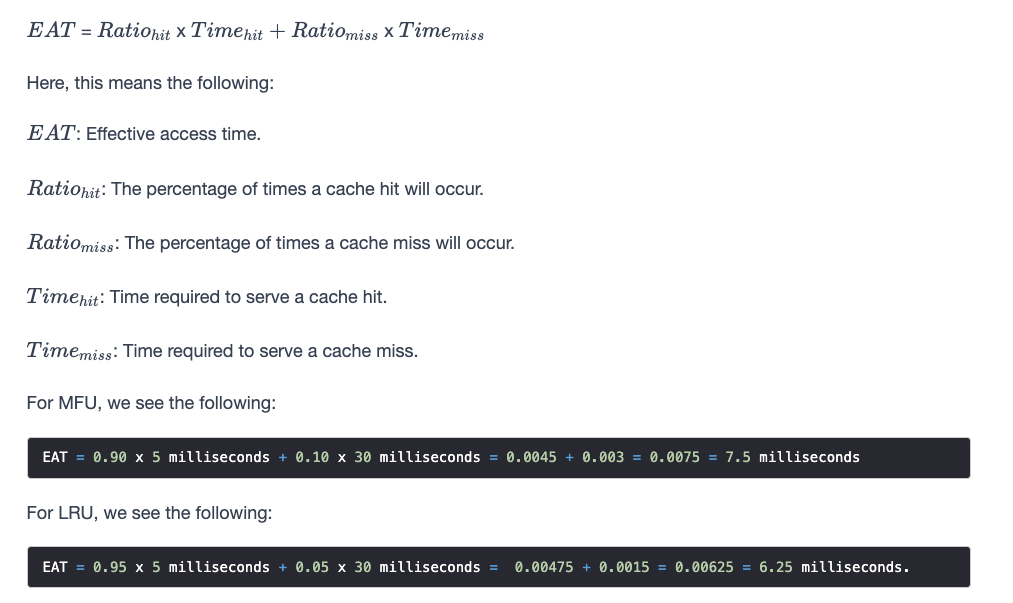 Как видно из расчетов, использование алгоритма LRU приводит к более низкому эффективному времени доступа по сравнению с MFU, что демонстрирует важность выбора подходящего алгоритма вытеснения для достижения высокой производительности.
Масштабируемость
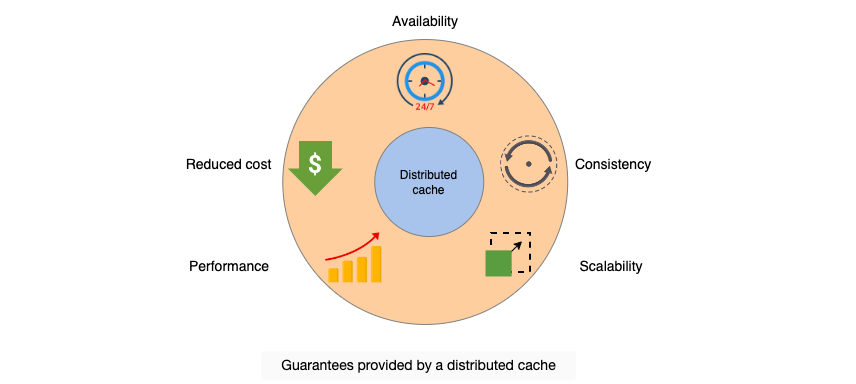
Мы можем создавать шарды в зависимости от требований и изменения нагрузки на серверы. При добавлении новых серверов кэша в кластер потребуется провести ограниченное количество пересчетов хешей благодаря консистентному хешированию.
Добавление реплик
Добавление реплик снижает нагрузку на горячие шарды. Еще один способ решения проблемы hotkeys — дальнейшее шардирование в диапазоне этих ключей. Хотя сценарий, в котором один ключ становится горячим, встречается редко, клиент кэша может разрабатывать решения для избежания проблемы конкуренции за один горячий ключ. Например:
- Интеллектуальное управление: Клиенты кэша могут избегать ситуации, при которой один ключ становится узким местом.
- Динамическая репликация: Для конкретных ключей можно использовать динамическую репликацию, чтобы распределить нагрузку.
Тем не менее, такие решения сложны и выходят за рамки данного урока. Важно отметить, что использование этих методов может значительно улучшить масштабируемость системы, предотвращая перегрузки и обеспечивая стабильную работу даже при увеличении числа запросов.
Высокая доступность
Мы повысили доступность за счет добавления избыточных серверов кэша. Избыточность добавляет уровень надежности и отказоустойчивости в наш дизайн. Мы также использовали алгоритм лидер-последователь для удобного управления шардами в кластере. Однако, мы пока не достигли высокой доступности, так как у нас есть две реплики шарда, и в данный момент мы предполагаем, что реплики находятся внутри одного дата-центра.
Достижение высокой доступности
Для достижения более высокой доступности можно разделить серверы лидера и последователя по разным дата-центрам. Однако такая высокая доступность имеет свою цену в виде понижения консистентности. Мы предполагаем синхронные записи в пределах одного дата-центра, что обеспечивает сильную консистентность. Однако синхронная запись между различными дата-центрами может иметь серьезные последствия для производительности, что не приветствуется в системах кэширования. Поэтому обычно используется асинхронная репликация между дата-центрами.
Консистентность внутри дата-центра
При репликации внутри одного дата-центра мы можем добиться сильной консистентности с хорошей производительностью. Однако для репликации между дата-центрами можно пожертвовать сильной консистентностью в пользу лучшей доступности (см. теоремы CAP и PACELC).
Консистентность
Запись данных на серверы кэша может выполняться в синхронном или асинхронном режиме. В случае кэширования предпочтителен асинхронный режим для улучшения производительности. Соответственно, наша система кэширования сталкивается с проблемами консистентности. В противовес этому, сильная консистентность достигается за счет синхронной записи, но это увеличивает общую задержку, что негативно сказывается на производительности.
Проблемы с консистентностью
Неполадки с конфигурационными файлами и сервисами также могут привести к несогласованности данных. Например, представим ситуацию, когда сервер кэша выходит из строя во время операции записи, а операция чтения выполняется сразу после его восстановления. Чтобы избежать таких ситуаций, сервер, который только что присоединился или переподключился, не должен обслуживать запросы, пока он не убедится, что его данные актуальны.
Доступность по цене
Предложенный нами дизайн имеет низкую стоимость, так как его реализация с использованием стандартного оборудования является выполнимой и практичной. Использование стандартного оборудования снижает расходы и делает систему доступной для широкого круга приложений.
What happens if the leader node fails in the leader-follower protocol?
Two possible solutions can be used in that case:
- Use the leader election algorithm to elect a new leader among the set of available followers.
- Use a separate distributed configuration management service to monitor and select leaders.
Is it a good idea to introduce synchronous replication to cache servers?
Synchronous replication on the cache clusters will introduce a performance penalty because it takes time to replicate the same data to all the cache servers. Therefore, there’s a trade-off between performance and consistency in the usage of asynchronous versus synchronous replication, respectively.
The answer depends on the use case. In case of cache servers, synchronous replication is a good choice if the replicated servers are within close proximity of the primary server.
Assume that a large number of concurrent requests are forwarded to a single shard server. If the server uses the LRU algorithm, some of the requests will result in a cache miss and write a new entry to the cache, while some will result in a cache hit and end up reading from the server. These concurrent requests may compete with each other. Therefore, some locking mechanisms may be required. However, locking an entire data structure for all the reading and writing operations will heavily reduce the performance. How do you think such a problem will be dealt with?
Generally, for concurrent access to shared data, some locking mechanisms like Semaphore, Monitors, Mutex locks, and others are good choices. But as the number of users (readers in case of cache hit or writers in case of a cache miss) grows, locking the entire data structure isn’t a suitable solution. In that case, we can consider the following options:
- Limited locking: In this strategy, only specific sections of the entire data structure will be locked. While some threads or processes can read from the data structure simultaneously, some threads may temporarily block access to specific sections of the data structure.
- Offline eviction: Offline eviction may be a possibility where instead of making actual changes to the data structure, only the required changes will be recorded while performing different operations until it’s necessary to commit the changes. This solution is desirable and easy if the cache hit rate is high because a change to the data structure will likely be required when a cache miss occurs.
- Lock-free implementation: Multiple solutions have been proposed which suggest that simultaneous reading and writing over doubly linked list is feasible to support large number of concurrent reading and writing.
Memcached versus Redis
Введение
В этом уроке мы рассмотрим некоторые широко применяемые реализаций распределенного кэша в реальных условиях. Наше внимание будет сосредоточено на двух известных open-source фреймворках: Memcached и Redis. Оба они представляют собой высокомасштабируемые, высокопроизводительные и надежные инструменты кэширования. Оба этих решения следуют клиент-серверной модели и достигают задержки менее миллисекунды. Давайте рассмотрим каждое из них, а затем сравним их полезность.
Memcached
Memcached был представлен в 2003 году. Это распределенный кэш на основе хранилища пар ключ-значение, предназначенный для быстрого хранения объектов. Memcached хранит данные в виде пары ключ-значение, где и ключ, и значение представляют собой строки. Это означает, что любые данные, которые хранятся в Memcached, должны быть сериализованы. Таким образом, Memcached не поддерживает и не может манипулировать различными структурами данных.
Memcached состоит из двух компонентов: клиентского и серверного, и каждый из них необходим для работы системы. Система спроектирована таким образом, что половина логики сосредоточена на сервере, а другая половина — на клиенте. Тем не менее, каждый сервер следует архитектуре shared-nothing. В этой архитектуре серверы не осведомлены друг о друге, и между ними нет синхронизации, обмена данными и связи.
Благодаря такой разобщенной архитектуре Memcached способен обеспечивать почти детерминированную скорость запросов O(1), обслуживая миллионы ключей в секунду на высокопроизводительной системе. Поэтому Memcached предлагает высокую пропускную способность и низкую задержку.
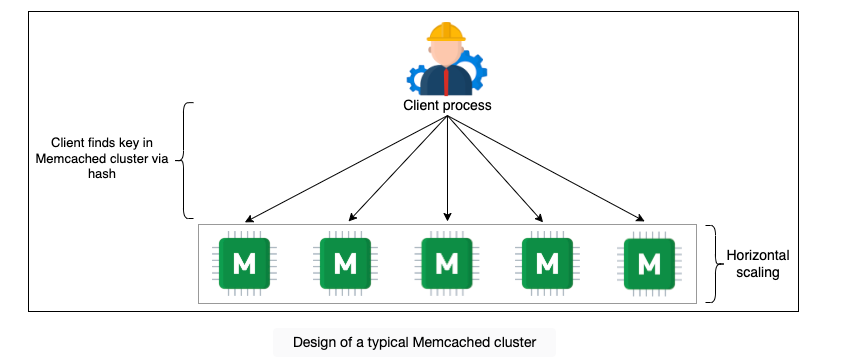
Как видно из дизайна типичного кластера Memcached, этот инструмент хорошо масштабируется по горизонтали. Клиентский процесс обычно поддерживается на сервере приложений, который также взаимодействует с авторитетным хранилищем данных (базой данных).
Facebook и Memcached
Facebook нуждается в частых операциях чтения и обновления данных, так как представления для пользователей формируются динамически, а не заранее. Благодаря своей простоте, Memcached стал очевидным выбором для решения этих задач. Memcached начал развиваться в 2003 году, а Facebook был запущен в 2004 году. Фактически, в некоторых случаях команды Facebook и Memcached работали вместе над поиском решений.
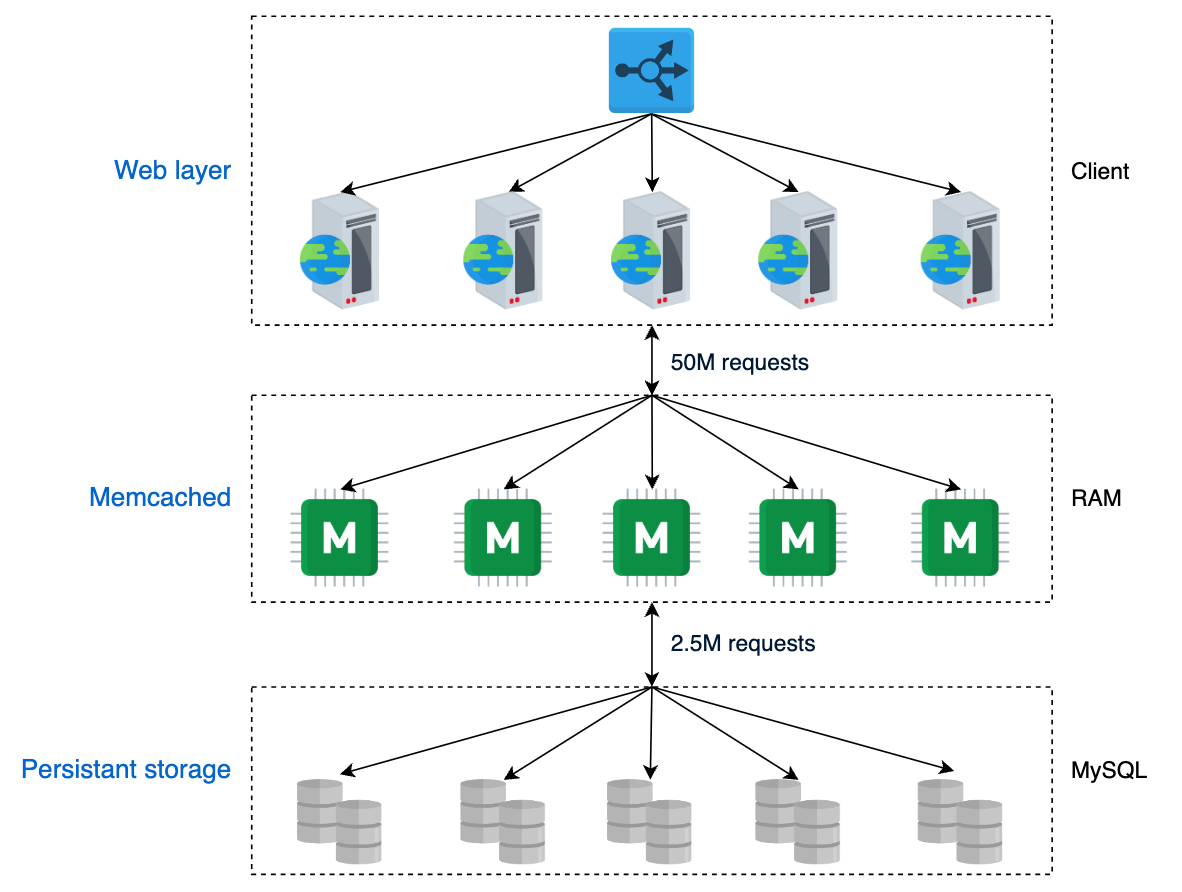
 В Facebook Memcached расположен между базой данных MySQL и веб-слоем, используя примерно 28 Терабайт RAM, распределенных более чем на 800 серверов (по состоянию на 2013 год). Используя приблизительное соблюдение политики вытеснения Least Recently Used (LRU), Facebook достигает уровня попаданий в кэш в 95%.
Следующая иллюстрация показывает высокоуровневый дизайн архитектуры кэширования в Facebook. Как видно, из 50 миллионов запросов, отправляемых веб-слоем, только 2,5 миллиона запросов доходят до уровня постоянного хранения данных.
Redis
Redis — это хранилище структур данных, которое может использоваться как кэш, база данных и брокер сообщений. Он предлагает богатый функционал, который сопровождается дополнительной сложностью. Основные особенности Redis включают:
Хранилище структур данных
- Хранилище структур данных: Redis понимает различные структуры данных, которые он хранит. Нет необходимости извлекать данные, манипулировать ими и снова сохранять. Мы можем выполнять изменения на месте, что экономит время и усилия.
База данных
- База данных: Redis может сохранять все данные, находящиеся в оперативной памяти, на вторичное хранилище, обеспечивая устойчивость данных.
Брокер сообщений
- Брокер сообщений: Асинхронная связь является важным требованием в распределенных системах. Redis способен обрабатывать миллионы сообщений в секунду, передавая их от одного компонента к другому в системе.
Дополнительные особенности Redis
-
Репликация и отказоустойчивость: Redis предоставляет встроенный механизм репликации, автоматическое переключение при сбоях и различные уровни сохранения данных.
-
Совместимость с Memcached: Redis поддерживает протоколы Memcached, поэтому решения, использующие Memcached, могут быть легко перенесены на Redis.
-
Разделение доступа к данным и управления кластером: Redis разделяет плоскость управления и плоскость данных, что повышает надежность и производительность системы.
-
Отсутствие строгой консистентности: Из-за использования асинхронной репликации Redis не обеспечивает строгую консистентность данных.
Redis предлагает мощные возможности для кэширования и обработки данных, но с более сложной архитектурой по сравнению с Memcached, что дает гибкость в использовании в различных сценариях.
Redis Cluster
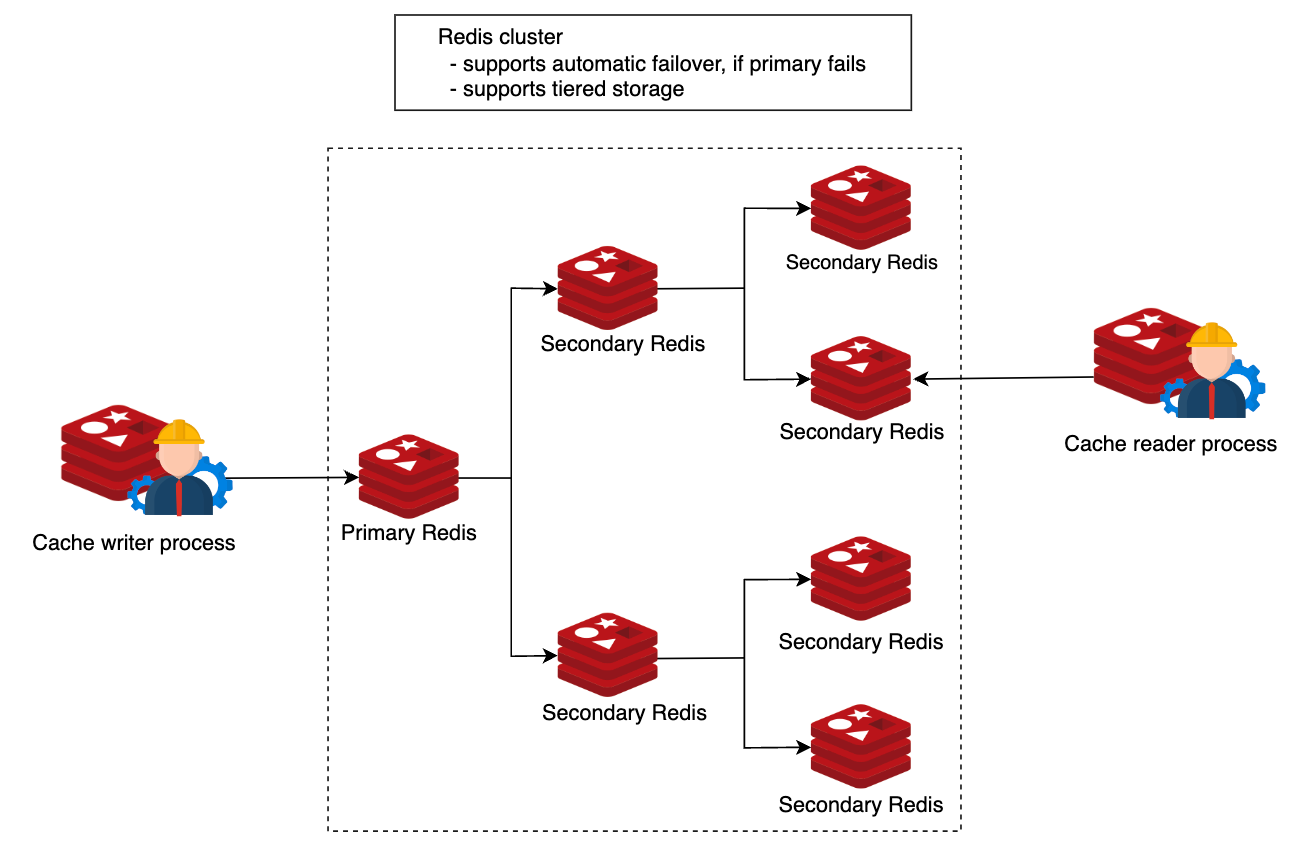
Redis имеет встроенную поддержку кластеров, которая обеспечивает высокую доступность. Этот механизм называется Redis Sentinel.
Основные компоненты Redis Cluster
-
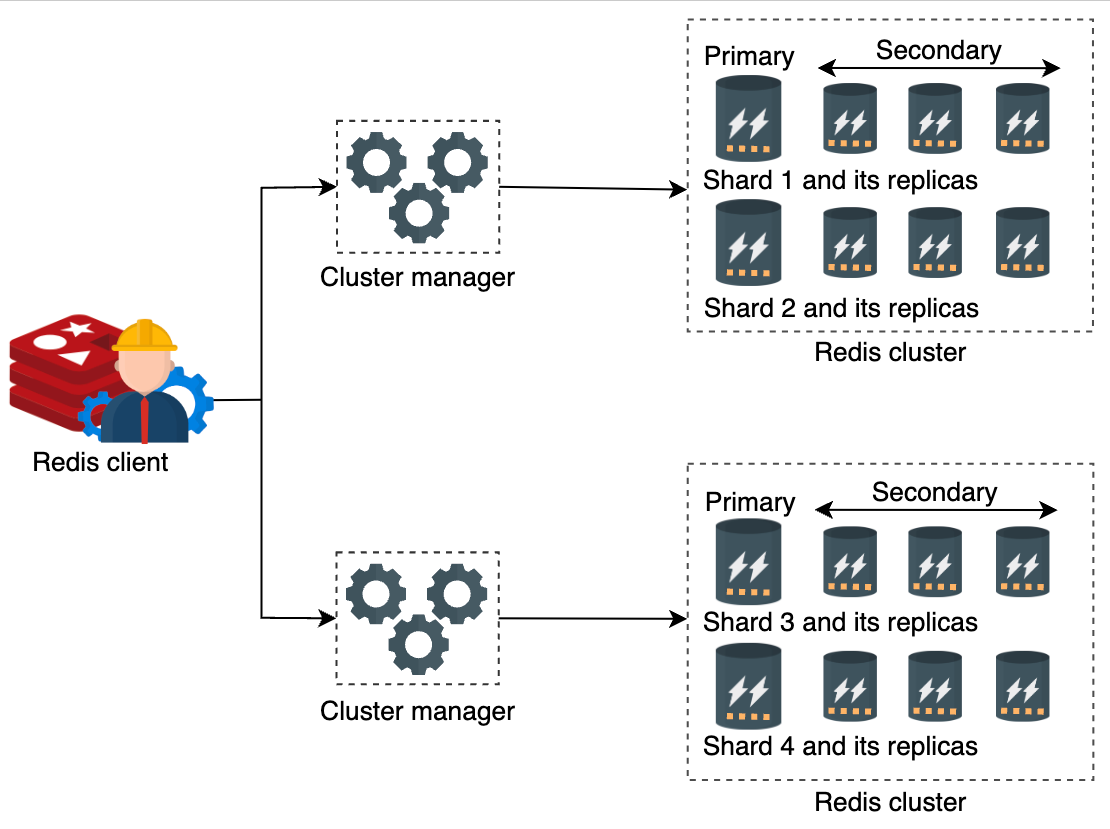
Кластерная архитектура: Redis Cluster включает в себя один или несколько Redis баз данных, к которым обращаются через многопоточные прокси-серверы. Redis Cluster выполняет автоматическое шардирование, при котором каждый шард имеет основной и вторичный узлы. Однако количество шардов в базе данных или узле можно настраивать в соответствии с требованиями и ожиданиями приложения.
-
Управление кластером: Каждый Redis Cluster управляется менеджером кластера, который отвечает за обнаружение сбоев и автоматическое переключение на резервные узлы (failover).
Управляющий слой Redis Cluster
- Мониторинг и конфигурация: Управляющий слой состоит из программных компонентов для мониторинга и конфигурации, которые обеспечивают бесперебойную работу и высокую доступность кластера.
Redis Cluster предоставляет мощные средства для управления распределенной системой с автоматическим шардированием, высокой доступностью и отказоустойчивостью, что делает его подходящим для приложений с высокими требованиями к масштабируемости и надежности.
Pipelining в Redis
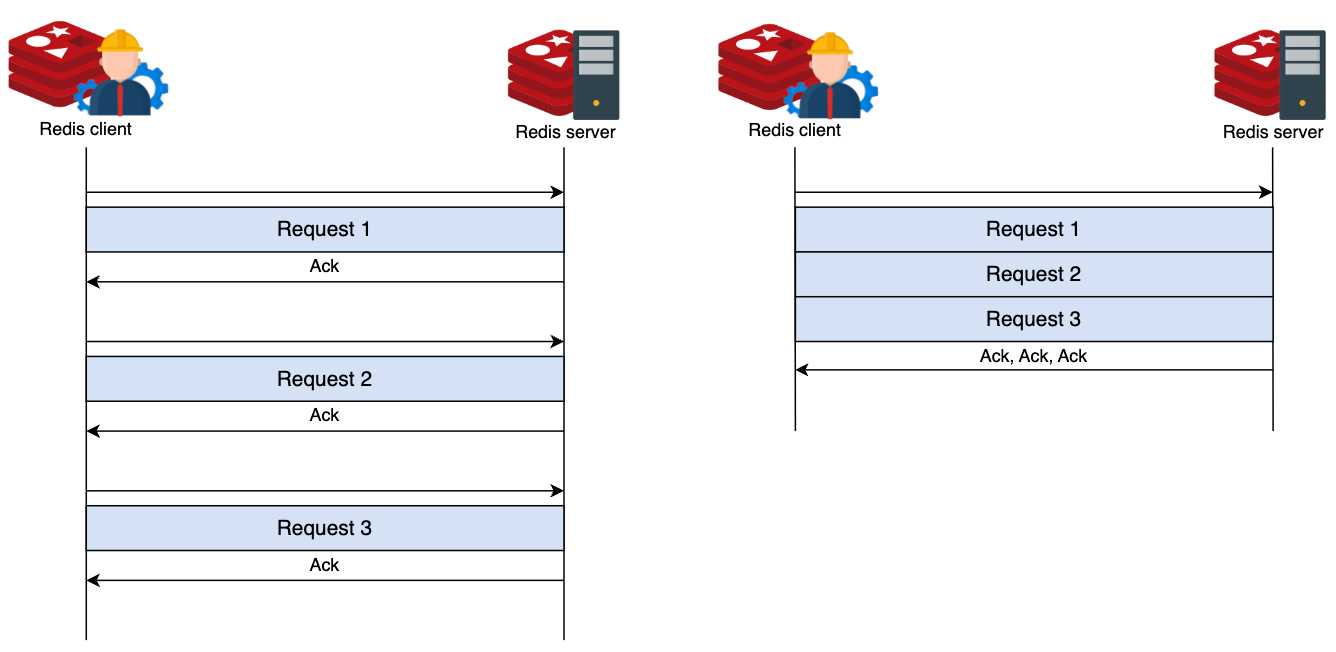
Так как Redis использует модель клиент-сервер, каждый запрос блокирует клиента до тех пор, пока сервер не вернет результат. Клиент Redis, который хочет отправить последующие запросы, вынужден ждать ответа от сервера на первый запрос, что увеличивает общую задержку.
Pipelining для ускорения процессов
Pipelining — это процесс объединения нескольких запросов на стороне клиента без ожидания ответа от сервера. Благодаря этому уменьшается количество раунд-трипов (RTT) для множества запросов.
Преимущества Pipelining
-
Снижение задержки: Pipelining позволяет клиенту отправить несколько запросов подряд, не дожидаясь ответа на каждый из них. Это существенно снижает общую задержку при выполнении множества операций.
-
Увеличение пропускной способности: Объединяя запросы, pipelining позволяет более эффективно использовать сетевые ресурсы, что приводит к увеличению пропускной способности.
Pipelining делает взаимодействие с Redis более эффективным, особенно в сценариях, где необходимо выполнить множество запросов за короткий промежуток времени.
Pipelining в Redis
Процесс pipelining снижает задержку благодаря уменьшению количества раунд-трипов (RTT) и времени, затрачиваемого на операции ввода-вывода на уровне сокетов. Кроме того, переключение режимов через системные вызовы в операционной системе — это дорогостоящая операция, которая значительно сокращается с помощью pipelining. Важно отметить, что pipelining команд на стороне клиента не влияет на то, как сервер обрабатывает эти запросы.
Пример работы Pipelining
Например, два запроса, объединенные клиентом с помощью pipelining, достигают сервера, и сервер не может выполнить второй запрос. В этом случае сервер возвращает результат для первого запроса и ошибку для второго. Клиент сам решает, как группировать похожие команды для достижения максимальной пропускной способности.
Примечание: Pipelining улучшает задержку как минимум в пять раз, если клиент и сервер находятся на одной машине, и запрос отправляется на loopback-адрес (127.0.0.1). Настоящая мощь pipelining проявляется в системах, где запросы отправляются на удаленные машины.
Сравнение Memcached и Redis
Несмотря на то, что Memcached и Redis принадлежат к семейству NoSQL, существуют тонкие различия, которые их отличают:
Основные различия:
-
Простота: Memcached прост, но управление кластерами в основном возлагается на разработчиков. Это дает больший контроль над Memcached, но требует дополнительных усилий. Redis, наоборот, автоматизирует большинство задач по масштабированию и разделению данных.
-
Устойчивость данных: Redis поддерживает устойчивость данных с помощью функций, таких как Append Only File (AOF) и Redis Database (RDB). В Memcached нет встроенной поддержки устойчивости, но можно использовать сторонние инструменты.
-
Типы данных: Memcached хранит объекты в виде пар ключ-значение, где и ключ, и значение — строки. Redis поддерживает строки, отсортированные множества, хеш-таблицы, битовые карты и гиперлоги. Максимальный размер ключа или значения в Redis настраивается.
-
Использование памяти: Оба инструмента позволяют установить максимальный размер памяти для кэширования. Memcached использует метод slab allocation для уменьшения фрагментации, но может возникнуть проблема с потерей памяти при обновлении записей или хранении множества небольших объектов. Для этого существуют конфигурационные решения.
-
Многопоточность: Redis работает как один процесс, используя одно ядро, тогда как Memcached эффективно использует многопоточные системы с несколькими ядрами. Хотя Redis изначально был разработан как однопоточный процесс для снижения сложности, можно запустить несколько процессов Redis для обеспечения конкурентности. Со временем Redis улучшил свою производительность и может эффективно хранить небольшие данные. Memcached лучше подходит для файлов размером более 100 КБ.
-
Репликация: Redis автоматизирует процесс репликации с помощью нескольких команд, в то время как в Memcached для этого требуются сторонние инструменты. В архитектурном плане Memcached хорошо масштабируется по горизонтали благодаря своей простоте. Redis обеспечивает масштабируемость через кластеризацию, что значительно сложнее.
Основные различия и общие черты Memcached и Redis:
| Функция | Memcached | Redis |
|---|---|---|
| Низкая задержка | Да | Да |
| Устойчивость данных | Возможно через сторонние средства | Несколько вариантов |
| Поддержка многих языков | Да | Да |
| Шардирование данных | Возможно через сторонние средства | Встроенное решение |
| Простота использования | Да | Да |
| Поддержка многопоточности | Да | Нет |
| Поддержка структур данных | Объекты | Множество структур данных |
| Поддержка транзакций | Нет | Да |
| Политика вытеснения | LRU | Несколько алгоритмов |
| Поддержка Lua-скриптов | Нет | Да |
| Геопространственная поддержка | Нет | Да |
Резюме
Memcached предпочтителен для небольших, простых систем, ориентированных на чтение, в то время как Redis подходит для сложных систем, ориентированных как на чтение, так и на запись.
Based on the implementation details, which of the two frameworks (Memcached or Redis) has a striking similarity with the distributed cache that we designed in the previous lesson?
Details
The answer is Memcached. The reasons are as follows:
- Client software chooses which cache server to use with a hashing algorithm.
- Server software stores the values against each key using an internal hash table.
- Least recently used (LRU) is used as the eviction policy.
- There’s no communication between different cache servers.
Why do third-party tools exist for persisting Memcached data?
Details
It’s because a lot of data is read and written to cache servers, and they may occasionally crash for whatever reason. After restarting, building a cache from scratch can take up to hours in specific scenarios, and that ultimately reduces system performance. Therefore, cache data may be persisted to disk to be loaded on a restart.
What is the advantage of storing different data structures as compared to strings only?
Details
The main advantage is that Redis can modify data in place without wasting network bandwidth by downloading and uploading. It saves network bandwidth, but it also saves time and effort by avoiding the serialization and deserialization of data.