A Blob Store
Что такое Blob Store?
Blob store — это решение для хранения неструктурированных данных. В нем можно хранить фотографии, аудио, видео, исполняемые двоичные файлы и другие мультимедийные элементы. Все типы данных хранятся в виде "blob" (бинарных больших объектов). Blob store использует плоскую организацию данных, в которой отсутствуют иерархии, такие как директории, поддиректории и т. д.
Чаще всего blob store используется приложениями с бизнес-требованиями, известными как "записать один раз, читать много раз" (write once, read many, WORM), что означает, что данные можно записать только один раз, и никто не может их изменить. Например, в Microsoft Azure blobs создаются один раз и читаются многократно. Кроме того, эти blobs нельзя удалить до истечения указанного интервала времени, а также нельзя модифицировать, чтобы защитить критические данные.
Пример использования Blob Store
Blob store используется для хранения и потоковой передачи больших неструктурированных файлов, таких как аудио, видео, изображения и документы.
Примечание: Не все приложения обязательно должны иметь требование WORM. Однако мы предполагаем, что blobs, которые записаны, не могут быть изменены. Вместо изменения можно загрузить новую версию blob, если это необходимо.
Почему мы используем Blob Store?
Blob store является важным компонентом многих приложений, работающих с большими объемами данных, таких как YouTube, Netflix, Facebook и т. д. Эти приложения ежедневно генерируют огромное количество неструктурированных данных и требуют решения для хранения, которое легко масштабируется, надежно и высокодоступно, чтобы сохранять большие медиафайлы. Поскольку объем данных постоянно увеличивается, этим приложениям необходимо хранить неограниченное количество blobs. По некоторым оценкам, YouTube требуется более одного петабайта дополнительного хранилища в день. В таких системах, как YouTube, видео хранится в нескольких разрешениях. Кроме того, видео во всех разрешениях многократно реплицируется в разных дата-центрах и регионах для обеспечения доступности. Поэтому общий объем хранения на одно видео превышает размер загруженного видео.
| Система | Blob Store |
|---|---|
| Netflix | S3 |
| YouTube | Google Cloud Storage |
| Tectonic |
Как разработать систему Blob Store?
Мы разделили разработку Blob Store на пять уроков и тест.
- Требования: В этом уроке мы определим функциональные и нефункциональные требования к Blob Store. Мы также оценим ресурсы, необходимые для нашей системы Blob Store.
- Проектирование: Этот урок представляет высокоуровневый дизайн, API-дизайн и детализированный дизайн Blob Store, объясняя детали всех компонентов и рабочий процесс.
- Соображения по проектированию: В этом уроке мы обсудим важные аспекты проектирования. Например, мы рассмотрим схему базы данных, стратегию разбиения, индексирование blob, пагинацию и репликацию.
- Оценка: В этом уроке мы оценим наш Blob Store на основе требований.
- Тест: В этом уроке мы проверим понимание дизайна Blob Store.
Начнем с рассмотрения требований к системе Blob Store.
Requirements of a Blob Store's Design
Требования
Давайте разберем функциональные и нефункциональные требования ниже:
Функциональные требования
Вот функциональные требования для дизайна blob store:
-
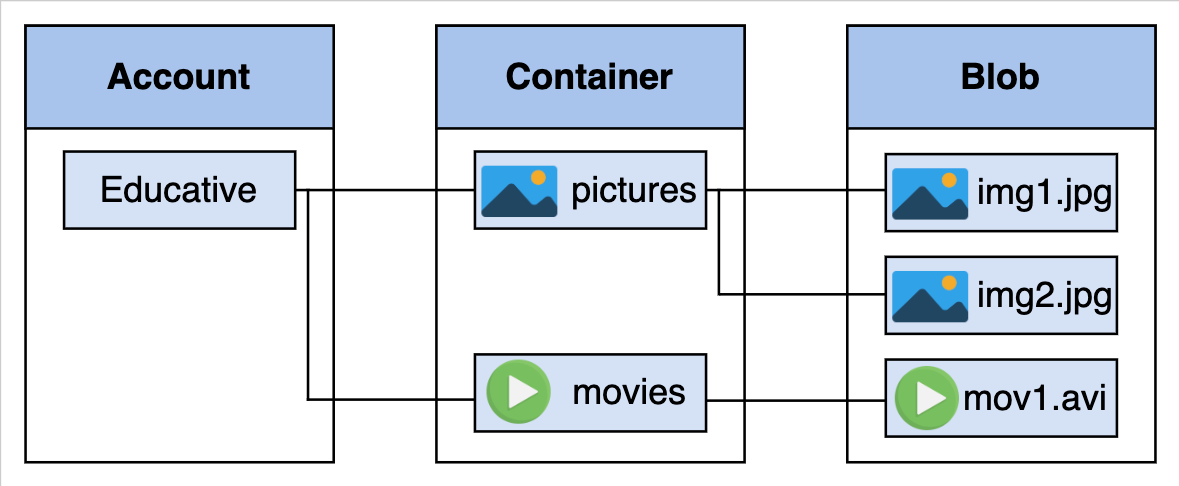
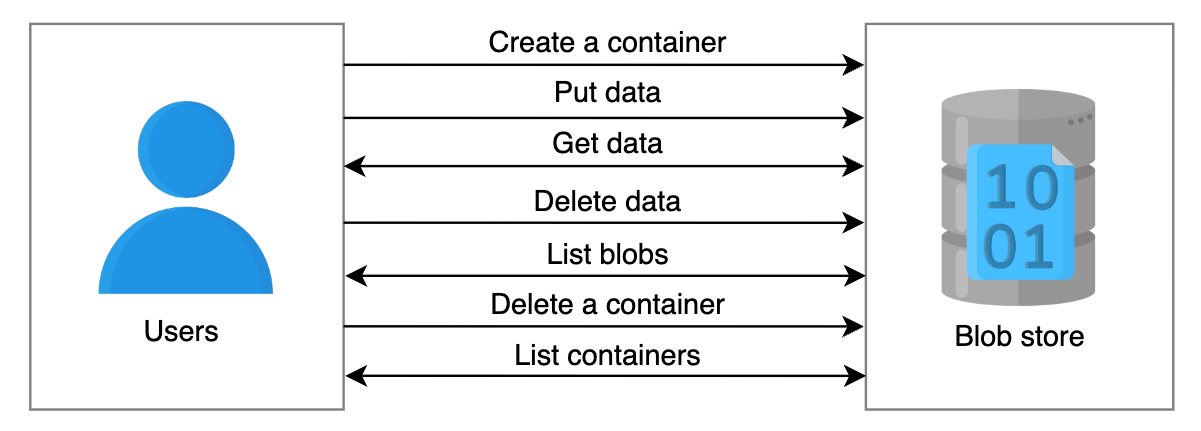
Создание контейнера: Пользователи должны иметь возможность создавать контейнеры для группировки blob-объектов. Например, если приложение хочет хранить данные, специфичные для пользователя, оно должно иметь возможность хранить blob-объекты для разных учетных записей пользователей в разных контейнерах. Кроме того, пользователь может захотеть сгруппировать видеоблобы и отделить их от группы изображений. Один пользователь blob store может создать много контейнеров, и каждый контейнер может иметь много blob-объектов, как показано на следующей иллюстрации. Для простоты предполагается, что мы не можем создать контейнер внутри контейнера.
-
Загрузка данных: Blob store должен позволять пользователям загружать blob-объекты в созданные контейнеры.
-
Получение данных: Система должна генерировать URL для загруженного blob-объекта, чтобы пользователь мог получить доступ к этому объекту позже через этот URL.
-
Удаление данных: Пользователи должны иметь возможность удалять blob-объекты. Если пользователь хочет сохранить данные на определенный период времени (время хранения), наша система должна поддерживать эту функцию.
-
Список blob-объектов: Пользователь должен иметь возможность получить список blob-объектов внутри определенного контейнера.
-
Удаление контейнера: Пользователи должны иметь возможность удалять контейнер и все blob-объекты внутри него.
-
Список контейнеров: Система должна позволять пользователям просматривать все контейнеры под конкретной учетной записью.
Нефункциональные требования
Вот нефункциональные требования к системе blob store:
-
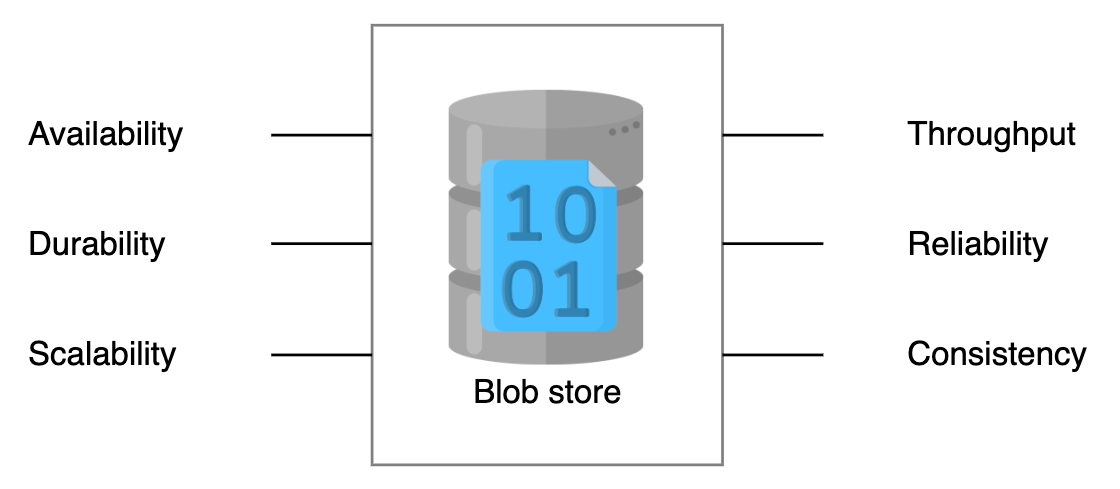
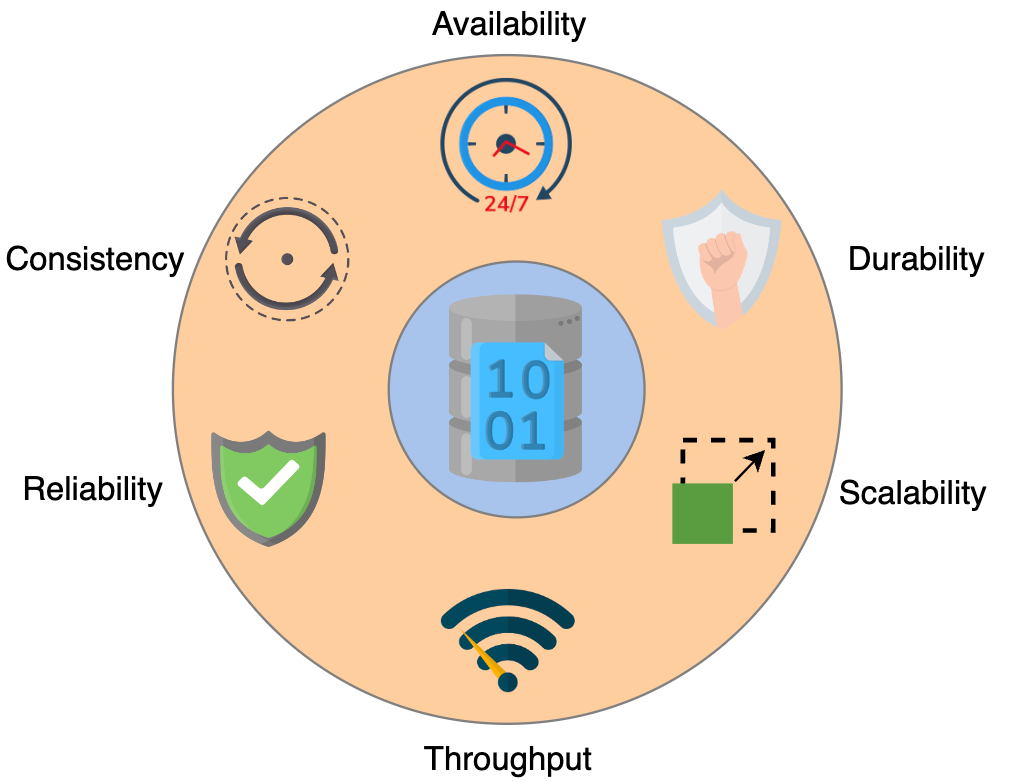
Доступность: Наша система должна быть высокодоступной.
-
Долговечность: Данные, как только загружены, не должны теряться, если пользователи явно не удалят эти данные.
-
Масштабируемость: Система должна быть способна обрабатывать миллиарды blob-объектов.
-
Пропускная способность: Для передачи гигабайт данных мы должны обеспечить высокую пропускную способность данных.
-
Надежность: Поскольку сбои являются нормой в распределенных системах, наш дизайн должен быстро обнаруживать и восстанавливаться после сбоев.
-
Согласованность: Система должна быть строго согласованной. Разные пользователи должны видеть одну и ту же версию blob-объекта.
Explain the concept of eventual consistency in the context of blob stores. Provide a scenario where it might be acceptable in the widget below.
Details
Eventual Consistency refers to the concept where updates might not be immediately reflected across all replicas in a distributed system, such as a blob store. An example scenario where this might be acceptable is in the case of a user’s profile picture update. A temporary delay in updates being reflected across regions might be tolerable.
Оценка ресурсов
Давайте оценим общее количество серверов, хранилища и пропускную способность, необходимые для системы blob store. Поскольку blobs могут содержать все виды данных, упоминание всех этих типов данных в наших оценках может быть непрактичным. Поэтому мы используем YouTube в качестве примера, который хранит видео и миниатюры в blob store. Кроме того, мы сделаем следующие допущения для завершения наших расчетов.
Допущения:
- Количество активных пользователей в день, загружающих или просматривающих видео, составляет пять миллионов.
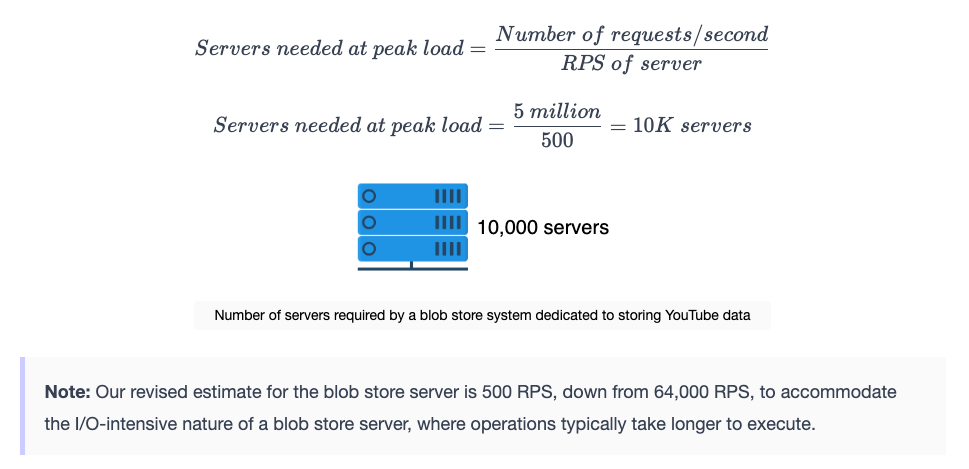
- Количество запросов в секунду, которые один сервер blob store может обработать, составляет 500.
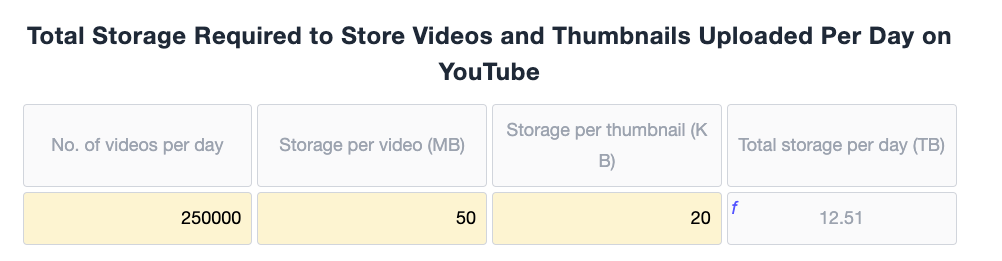
- Средний размер видео составляет 50 МБ.
- Средний размер миниатюры составляет 20 КБ.
- Количество загружаемых видео в день составляет 250 000.
- Количество запросов на чтение от одного пользователя в день составляет 20.
Оценка количества серверов
Учитывая наше предположение об использовании ежедневных активных пользователей в качестве прокси для количества запросов в секунду в пиковые часы нагрузки, мы получаем 5 миллионов запросов в секунду. Количество серверов, которые нам нужны, учитывая 500 RPS для сервера blob store, рассчитывается по формуле ниже:
Оценка хранилища
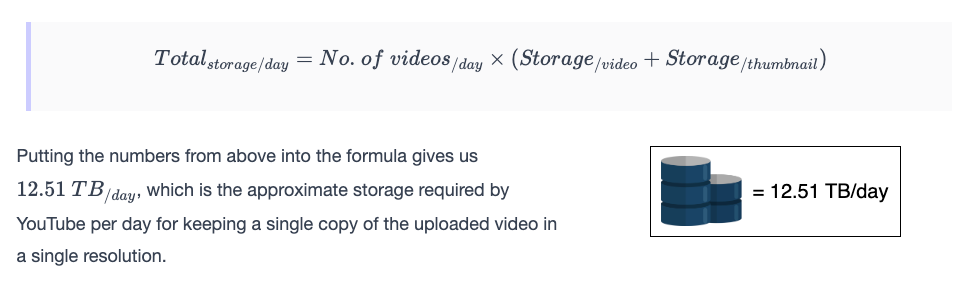
Учитывая приведенные выше предположения, мы используем формулу ниже для расчета общего объема хранилища, необходимого YouTube за один день:
Оценка пропускной способности
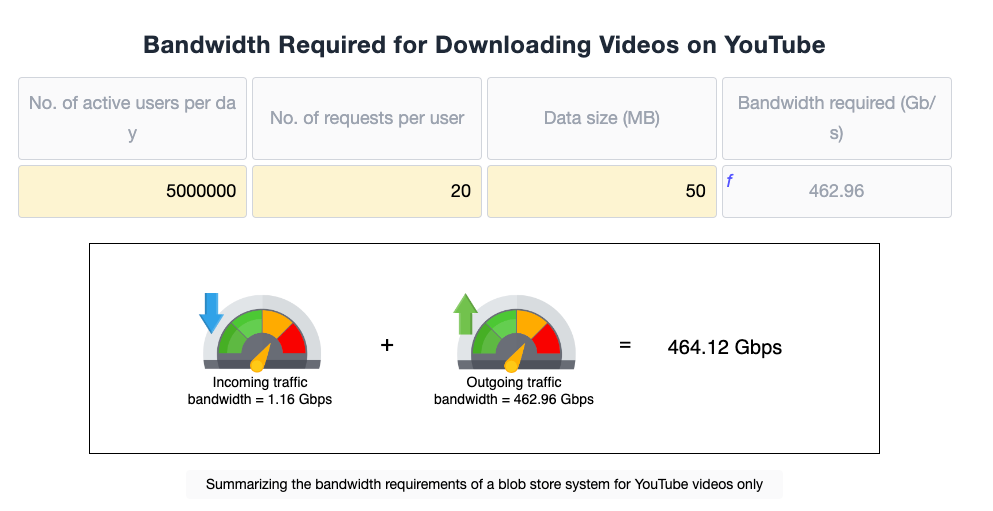
Давайте оценим пропускную способность, необходимую для загрузки данных и их извлечения из blob store.
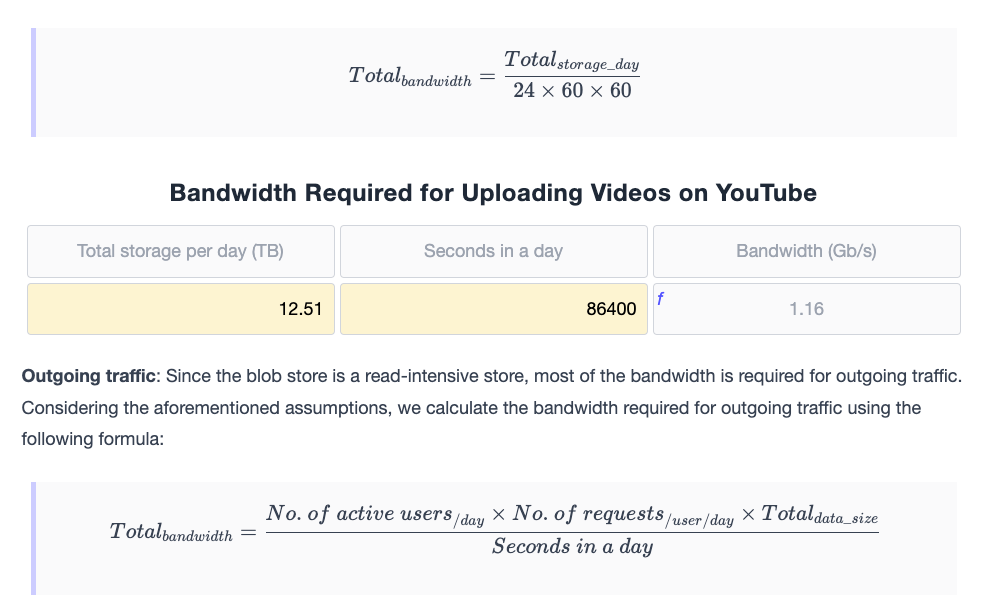
Входящий трафик: Чтобы оценить пропускную способность, необходимую для входящего трафика, мы учитываем общий объем данных, загружаемых в день, что косвенно означает общий объем хранилища, необходимый в день, который мы рассчитали выше. Количество данных, передаваемых на серверы в секунду, можно рассчитать по следующей формуле:
Design of a Blob Store
Высокоуровневый дизайн
Давайте определим и соединим компоненты системы Blob Store. На высоком уровне компоненты включают клиентов, фронтенд-серверы и диски хранения.
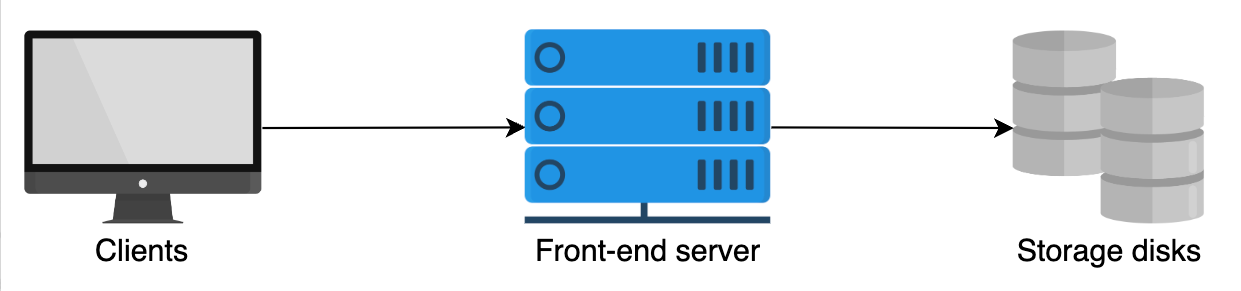
Запросы клиентов принимаются фронтенд-серверами, которые обрабатывают запрос. Фронтенд-серверы сохраняют blob-объект клиента на подключенные к ним диски хранения.
Дизайн API
Рассмотрим дизайн API для blob store. Все функции ниже могут выполняться только зарегистрированным и аутентифицированным пользователем. Для краткости мы не включаем такие функции, как регистрация и аутентификация пользователей.
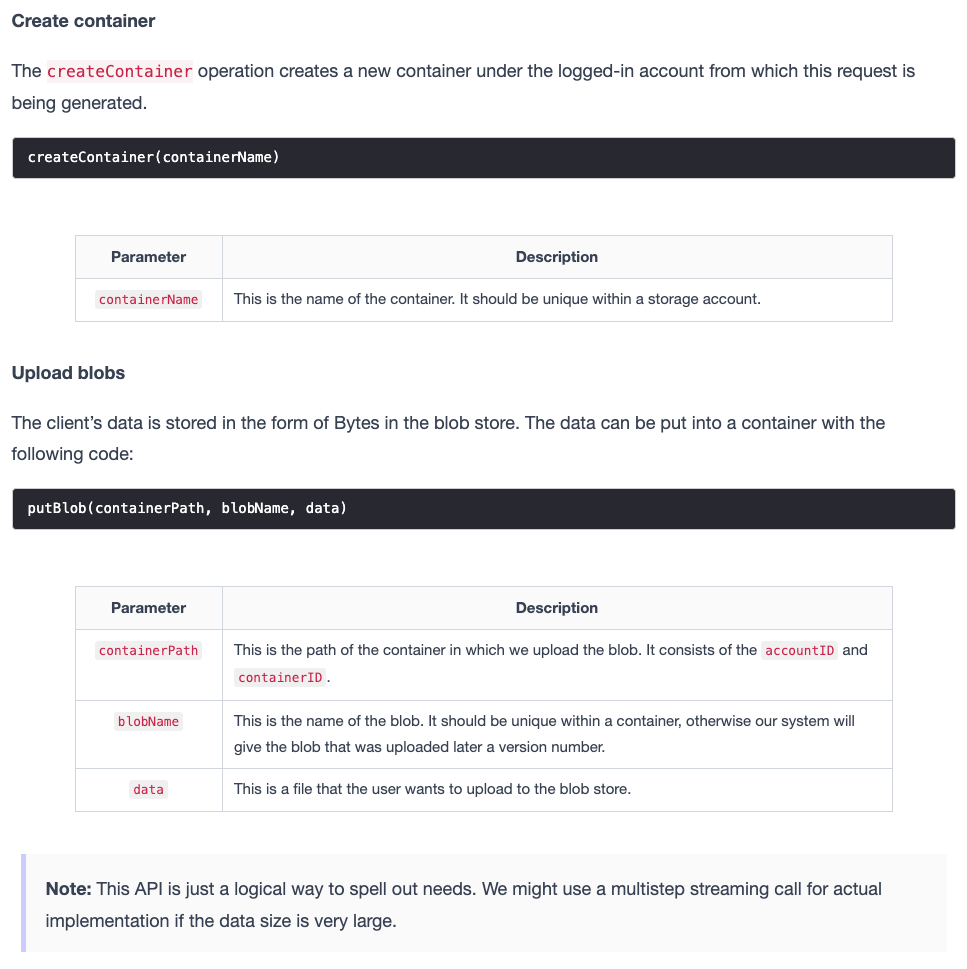
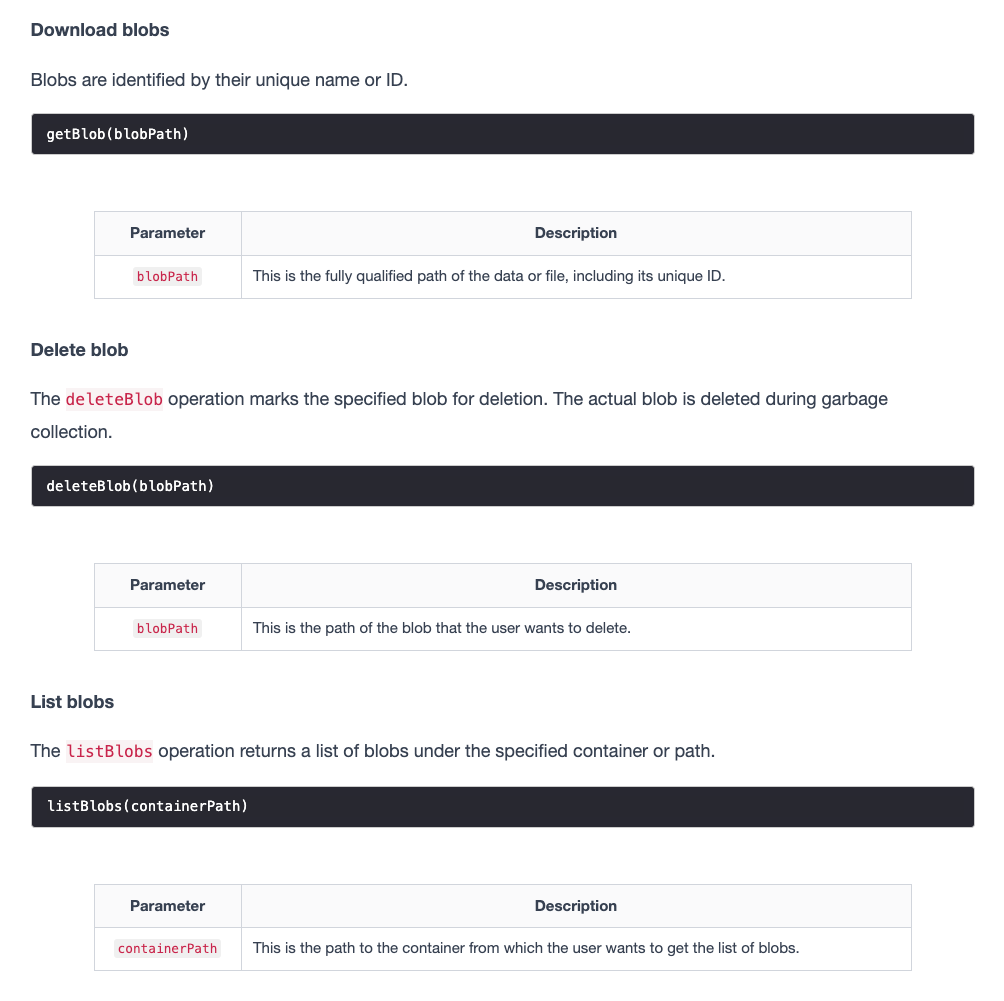
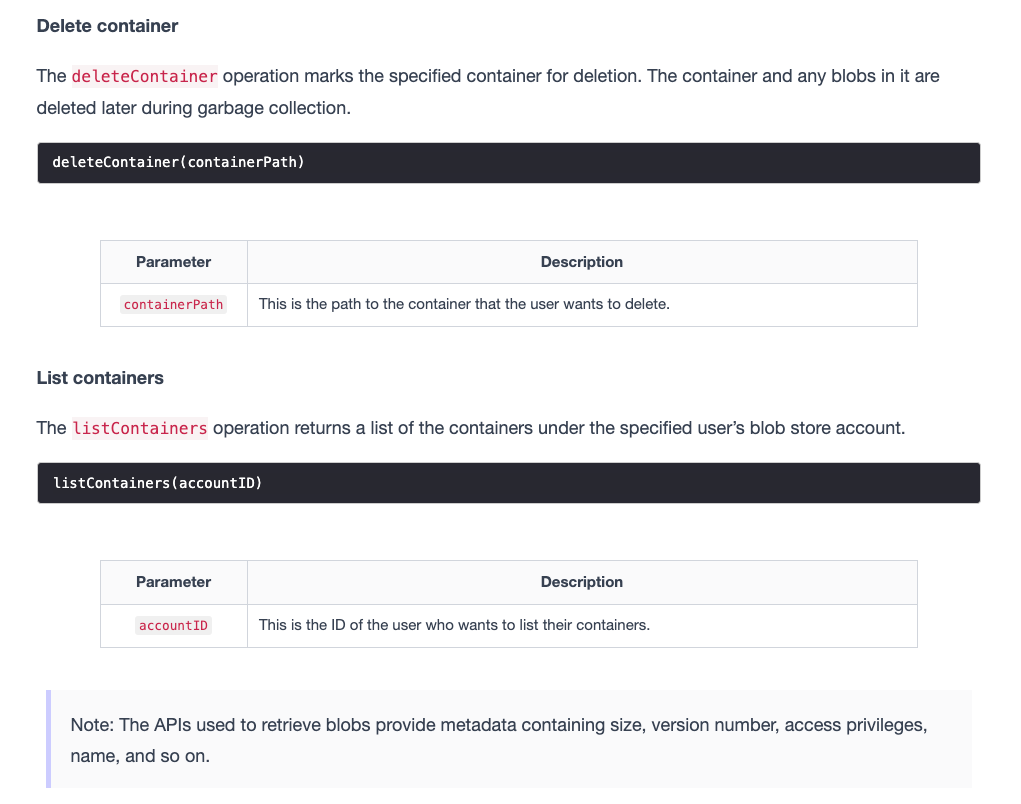
Детальный дизайн
Мы начнем с идентификации ключевых компонентов, которые необходимы для завершения дизайна Blob Store. Затем рассмотрим, как эти компоненты связаны для выполнения наших функциональных требований.
Компоненты
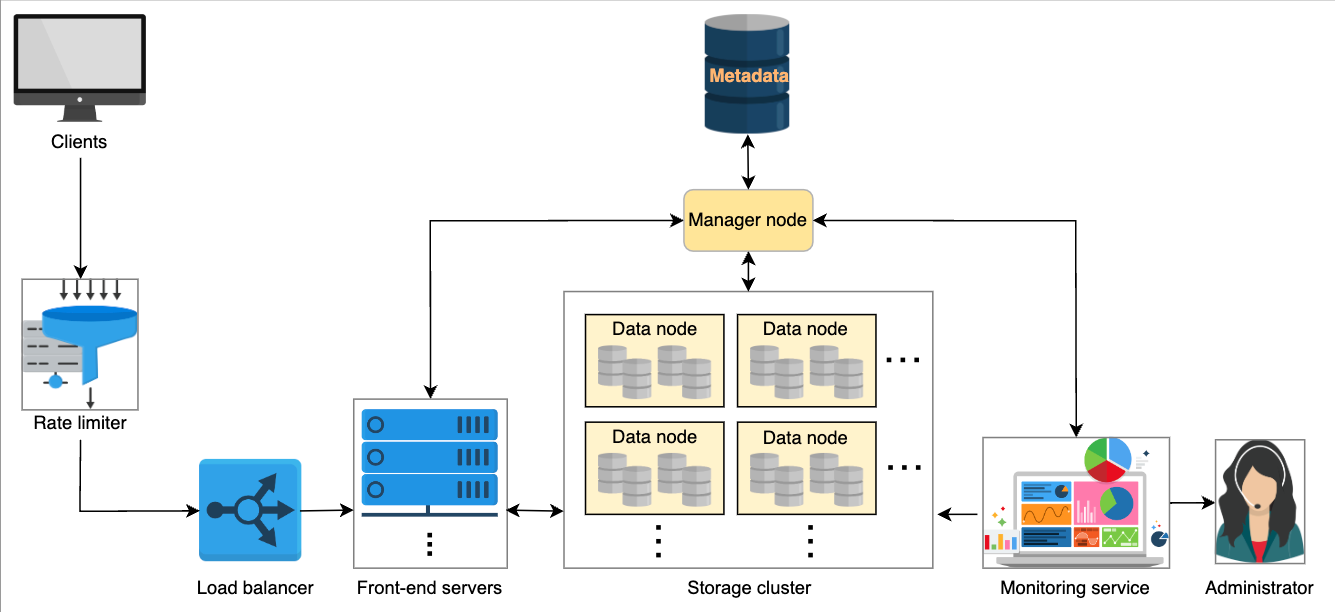
Вот список компонентов, используемых в дизайне Blob Store:
- Клиент: Это пользователь или программа, выполняющая любые из указанных функций API.
- Ограничитель скорости (Rate limiter): Ограничивает количество запросов на основе подписки пользователя или ограничивает количество запросов с одного IP-адреса в одно и то же время. Он не позволяет пользователям превышать заранее установленный лимит.
- Балансировщик нагрузки (Load balancer): Распределяет входящий сетевой трафик среди группы серверов. Также используется для перенаправления запросов в разные регионы в зависимости от местоположения пользователя, в разные дата-центры в пределах одного региона или на разные серверы в одном дата-центре. DNS-балансировка нагрузки может быть использована для перенаправления запросов между разными регионами в зависимости от местоположения пользователя.
- Фронтенд-серверы (Front-end servers): Фронтенд-серверы перенаправляют запросы пользователей на добавление или удаление данных к соответствующим серверам хранения.
- Узлы данных (Data nodes): Узлы данных содержат фактические данные blob. Также возможно, что они содержат часть данных blob. Blob-объекты разделены на маленькие фиксированные части, называемые чанками. Узел данных может содержать все чанки blob или хотя бы некоторые из них.
- Управляющий узел (Manager node): Управляющий узел — это основной компонент, который управляет всеми узлами данных. Он хранит информацию о путях хранения и привилегиях доступа к blob-объектам. Существуют два типа привилегий доступа: частный и публичный. Частная привилегия доступа означает, что blob доступен только для учетной записи, содержащей этот blob. Публичная привилегия доступа означает, что любой может получить доступ к этому blob.
- Примечание: Каждый из узлов данных в кластере регулярно отправляет управляющему узлу сигнал о состоянии (heartbeat) и отчет о чанках. Наличие heartbeat означает, что узел данных работает. Отчет о чанках перечисляет все чанки на узле данных. Если узел данных не отправляет heartbeat, управляющий узел считает этот узел мертвым и затем обрабатывает запросы пользователей на репликах. Управляющий узел поддерживает журнал ожидающих операций, которые должны быть выполнены на мертвом узле данных, когда он восстановится.
- Хранилище метаданных (Metadata storage): Хранилище метаданных — это распределенная база данных, которая используется управляющим узлом для хранения всех метаданных. Метаданные состоят из метаданных учетной записи, метаданных контейнера и метаданных blob.
- Метаданные учетной записи содержат информацию об учетной записи для каждого пользователя и контейнеры, принадлежащие каждой учетной записи.
- Метаданные контейнера состоят из списка blob-объектов в каждом контейнере.
- Метаданные blob содержат информацию о том, где хранится каждый blob. Метаданные blob будут подробно обсуждаться в следующем уроке.
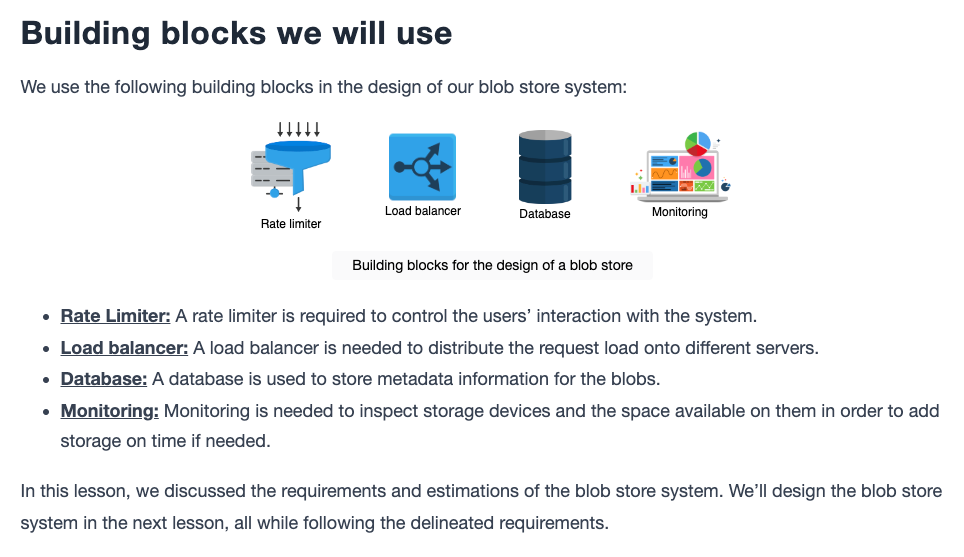
- Служба мониторинга (Monitoring service): Служба мониторинга контролирует узлы данных и управляющий узел. Она предупреждает администратора в случае отказов дисков, требующих вмешательства человека. Также служба получает информацию о доступном свободном пространстве на дисках, чтобы предупредить администраторов о необходимости добавления новых дисков.
- Администратор (Administrator): Администратор отвечает за обработку уведомлений от служб мониторинга и проведение регулярных проверок всей службы для обеспечения надежности.
Архитектура взаимосвязи этих компонентов показана на диаграмме ниже:
Рабочий процесс
Мы описываем рабочий процесс на основе базовых операций, которые можно выполнить в blob store. Предполагается, что пользователь успешно вошел в систему и контейнер уже создан. Уникальный идентификатор присваивается каждому пользователю и контейнеру. Пользователь выполняет следующие операции в конкретном контейнере.
Запись blob
- Клиент генерирует запрос на загрузку blob. Если запрос клиента успешно проходит через ограничитель скорости, балансировщик нагрузки перенаправляет запрос клиента на один из фронтенд-серверов. Затем фронтенд-сервер запрашивает у управляющего узла данные о том, какие узлы данных нужно использовать для хранения blob.
- Управляющий узел присваивает blob уникальный идентификатор, используя систему генерации уникальных идентификаторов. Затем он разделяет большой blob на более мелкие фиксированные чанки и назначает каждому чанк узел данных, на котором этот чанк будет храниться. Управляющий узел определяет доступное пространство на узлах данных с помощью системы управления свободным пространством.
- После определения соответствия чанков узлам данных фронтенд-серверы записывают чанки на назначенные узлы данных.
- Каждый чанк реплицируется для обеспечения избыточности. Все решения, касающиеся репликации чанков, принимаются на управляющем узле. Следовательно, управляющий узел также выделяет хранилище и узлы данных для хранения реплик.
- Управляющий узел сохраняет метаданные blob в хранилище метаданных. Мы подробно обсудим схему метаданных blob в следующем уроке.
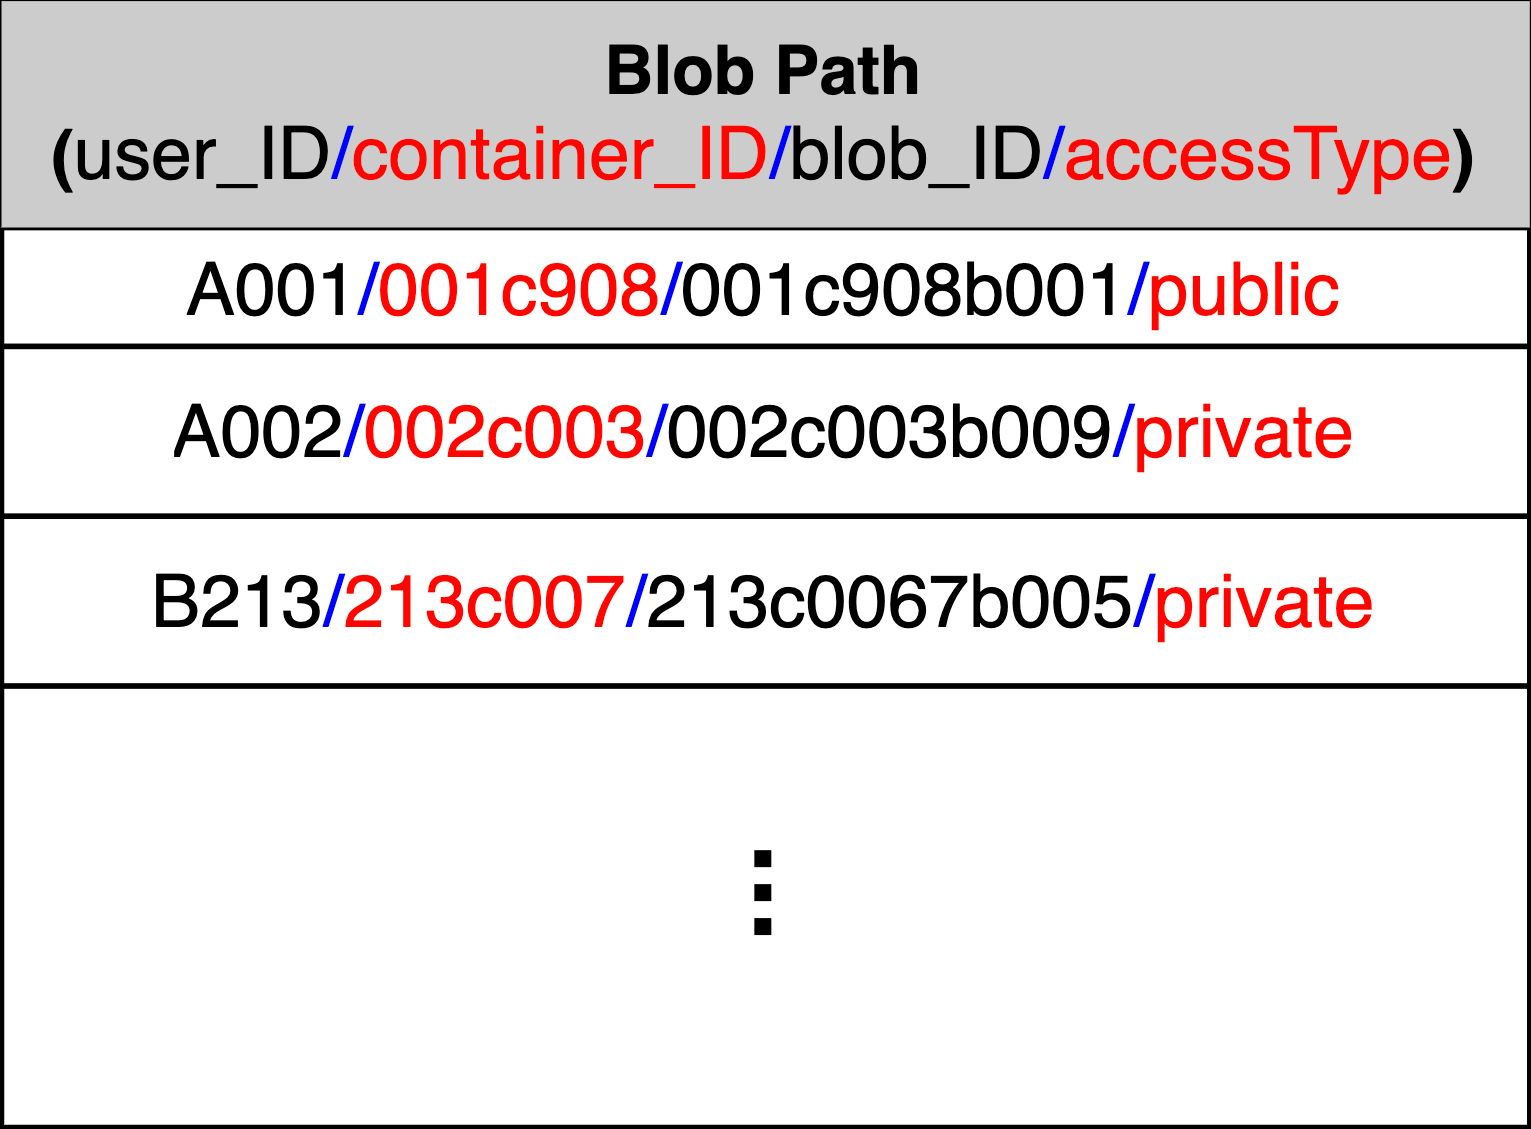
- После записи blob клиенту возвращается полный путь к blob. Путь включает идентификатор пользователя, идентификатор контейнера, в который добавлен blob, идентификатор blob и уровень доступа к blob.
What does the manager node do if a user concurrently writes two blobs with the same name inside the same container?
Details
The manager node serializes such operations and assigns a version number to the blob that’s uploaded later.
Чтение blob
- Когда запрос на чтение blob достигает фронтенд-сервера, он запрашивает метаданные blob у управляющего узла.
- Управляющий узел сначала проверяет, является ли blob частным или публичным, на основе пути к blob и того, авторизованы ли мы на передачу этого blob.
- После авторизации blob управляющий узел ищет чанки для этого blob в метаданных и их соответствие узлам данных. Управляющий узел возвращает клиенту чанки и их соответствие (узлы данных).
- Клиент затем считывает данные чанков с узлов данных.
- Примечание: Информация о метаданных для чтения blob кэшируется на клиентском устройстве, чтобы в следующий раз, когда клиент захочет прочитать тот же blob, не нужно было нагружать управляющий узел. Кроме того, операция чтения на стороне клиента будет быстрее в следующий раз.
Suppose the manager node moves data from one data node to another because of an impending disk failure. The user will now have stale information if they use the cached metadata to access the data. How do we handle such situations?
Details
In such cases, the client calls fail. The client then flushes the cache and fetches new metadata information from the manager node.
Deleting a blob Upon receiving a delete blob request, the manager node marks that blob as deleted in the metadata, and frees up the space later using a garbage collector. We learn more about garbage collectors in the next lesson.
Can the manager node be considered a single point of failure? If yes, then how can we cope with this problem?
Details
Yes, because the manager node is the central point of a blob store and is a single point of failure. Therefore, we have to have a backup or shadow server in place of a manager node.
The technique that we use for this is called checkpointing, meaning we take snapshots of the data at different time intervals. A snapshot captures the state, data, hardware configuration of the running manager node, and messages in transit between the manager and data nodes. It maintains the operation log in an external storage area or snapshot repository. If the manager node fails, an automated system or the administrator uses the snapshot to restart that manager node from the state it failed at and replays the operation log.
Design Considerations of a Blob Store
Хотя в предыдущем уроке мы подробно обсудили дизайн системы хранилища блобов и его основные компоненты, осталось несколько интересных вопросов, требующих ответа. Например, как хранить большие блобы? Сохраняем ли мы их на одном диске, на одной машине, или делим блобы на чанки? Сколько реплик блоба нужно создать, чтобы обеспечить надежность и доступность? Как быстро искать и извлекать блобы? Это лишь некоторые из вопросов, которые могут возникнуть.
Этот урок отвечает на эти важные вопросы дизайна. В таблице ниже приведены цели этого урока.
Резюме урока
| Раздел | Назначение |
|---|---|
| Метаданные блобов | Это метаданные, которые поддерживаются для обеспечения эффективного хранения и извлечения блобов. |
| Разбиение на части | Определяет, как блобы делятся на части между разными узлами данных. |
| Индексация блобов | Показывает, как эффективно искать блобы. |
| Пагинация | Учит нас, как реализовать метод для извлечения ограниченного количества блобов для улучшения удобочитаемости и времени загрузки. |
| Репликация | Учит нас, как реплицировать блобы и сколько копий следует поддерживать для улучшения доступности. |
| Сборка мусора | Учит нас, как удалять блобы, не жертвуя производительностью. |
| Стриминг | Учит нас, как передавать большие файлы по частям для обеспечения интерактивности пользователей. |
| Кэширование | Показывает, как улучшить время отклика и пропускную способность. |
Прежде чем ответить на вышеуказанные вопросы, давайте рассмотрим, как мы создаем слои абстракции для пользователя, чтобы скрыть внутреннюю сложность хранилища блобов. Эти слои абстракции также помогают нам принимать решения, связанные с дизайном.
Слои абстракции
Существует три слоя абстракции:
- Учетная запись пользователя: Пользователи идентифицируются на этом уровне через свой
account_ID. Блобы, загруженные пользователями, хранятся в их контейнерах. - Контейнер: У каждого пользователя есть набор контейнеров, каждый из которых уникально идентифицируется через
container_ID. Эти контейнеры содержат блобы. - Блоб: Этот слой содержит информацию о блобах, которые уникально идентифицируются через
blob_ID. Этот слой поддерживает информацию о метаданных блобов, которая важна для обеспечения доступности и надежности системы.
На основе этих слоев мы можем принимать решения по маршрутизации, хранению и шардированию. В таблице ниже обобщены эти слои.
| Уровень | Уникально идентифицируется через | Информация | Шардирование по | Соответствие |
|---|---|---|---|---|
| Учетная запись пользователя | account_ID | список значений container_ID | account_ID | Учетная запись -> список контейнеров |
| Контейнер | container_ID | список значений blob_ID | container_ID | Контейнер -> список блобов |
| Блоб | blob_ID | список чанков, информация о чанках: ID узлов данных,.. | blob_ID | Блоб -> список чанков |
Примечание: Мы генерируем уникальные ID для учетных записей пользователей, контейнеров и блобов с помощью системы генерации уникальных ID.
Кроме хранения фактических данных блобов, мы должны поддерживать некоторые метаданные для управления хранилищем блобов. Давайте рассмотрим, что это за данные.
Метаданные блоба
Когда пользователь загружает блоб, он разбивается на небольшие чанки, чтобы можно было поддерживать хранение больших файлов, которые не могут поместиться в одном непрерывном месте, на одном узле данных или в одном блоке диска, связанном с этим узлом данных. Чанки для одного блоба затем хранятся на разных узлах данных, на которых доступно достаточно места для их хранения. Есть миллиарды блобов, которые хранятся в хранилище. Узел-менеджер должен хранить всю информацию о чанках блоба и их местоположении, чтобы можно было их извлечь при чтении. Узел-менеджер присваивает ID каждому чанку.
Информация о блобе включает ID чанков и имя назначенного узла данных для каждого чанка. Мы делим блобы на чанки одинакового размера. Чанки реплицируются для обеспечения их устойчивости к сбоям узлов данных. Следовательно, мы также храним ID реплик для каждого чанка. У нас есть доступ ко всей этой информации, относящейся к каждому блобу.
Предположим, у нас есть блоб размером 128 МБ, и мы делим его на два чанка по 64 МБ каждый. Метаданные для этого блоба показаны в следующей таблице:
| Чанк | ID узла данных | ID Реплики 1 | ID Реплики 2 | ID Реплики 3 |
|---|---|---|---|---|
| 1 | d1b1 | r1b1 | r2b1 | r3b1 |
| 2 | d1b2 | r1b2 | r2b2 | r3b2 |
Примечание: Как дизайнеры, мы должны выбрать разумный размер чанка данных блоба. Мы можем решить сохранить выбранный размер чанка фиксированным для всего хранилища блобов (что означает, что мы не хотим позволять приложениям использовать разные размеры чанков для разных файлов, чтобы уменьшить сложность реализации). Если мы сделаем размер чанка слишком маленьким, это увеличит размер метаданных (часто на каждый чанк), что неблагоприятно для нашего дизайна на основе единого менеджера. Если же мы выберем слишком большой размер чанка, диски могут не быть способны записывать данные в непрерывные места, и мы можем получить более низкую производительность чтения/записи. Поэтому нам нужно выбрать разумный размер чанка, который удовлетворяет потребности наших приложений и может обеспечить хорошую производительность на основе аппаратного обеспечения. Есть несколько переменных, которые могут влиять на производительность чтения/записи, таких как размер чанка, тип используемого хранилища (вращающиеся диски или флеш-диски), характеристики нагрузки (последовательное чтение/запись или случайное чтение/запись, полные блоки данных против потоковой записи/чтения и так далее).
Мы поддерживаем три реплики для каждого блока. При записи блоба узел-менеджер идентифицирует данные и узлы реплик с помощью своей системы управления свободным пространством. Кроме того, что узлы реплик помогают в случае сбоя узла данных, они также используются для обслуживания запросов на чтение/запись, чтобы основной узел не был перегружен.
What if the blob size isn’t a multiple of our configured chunk size? How does the manager node know how many Bytes to read for the last chunk?
Details
If the blob size isn’t a multiple of the chunk size, the last chunk won’t be full.
The manager node also keeps the size of each blob to determine the number of Bytes to read for the last chunk.
Разбиение данных
Мы говорили о разных уровнях абстракции в хранилище блобов — уровне учетной записи, уровне контейнера и уровне блоба. Хранятся и читаются миллиарды блобов. Существует большое количество узлов данных, на которых мы храним эти блобы. Если мы будем искать узлы данных, содержащие конкретные блобы среди всех узлов данных, это будет очень медленный процесс. Вместо этого мы можем сгруппировать узлы данных и назвать каждую группу партицией. Мы поддерживаем таблицу карты партиций, которая содержит список всех блобов в каждой партиции. Если мы будем распределять блобы по разным партициям независимо от их container_ID и account_ID, мы столкнемся с проблемой, как показано на следующей иллюстрации:
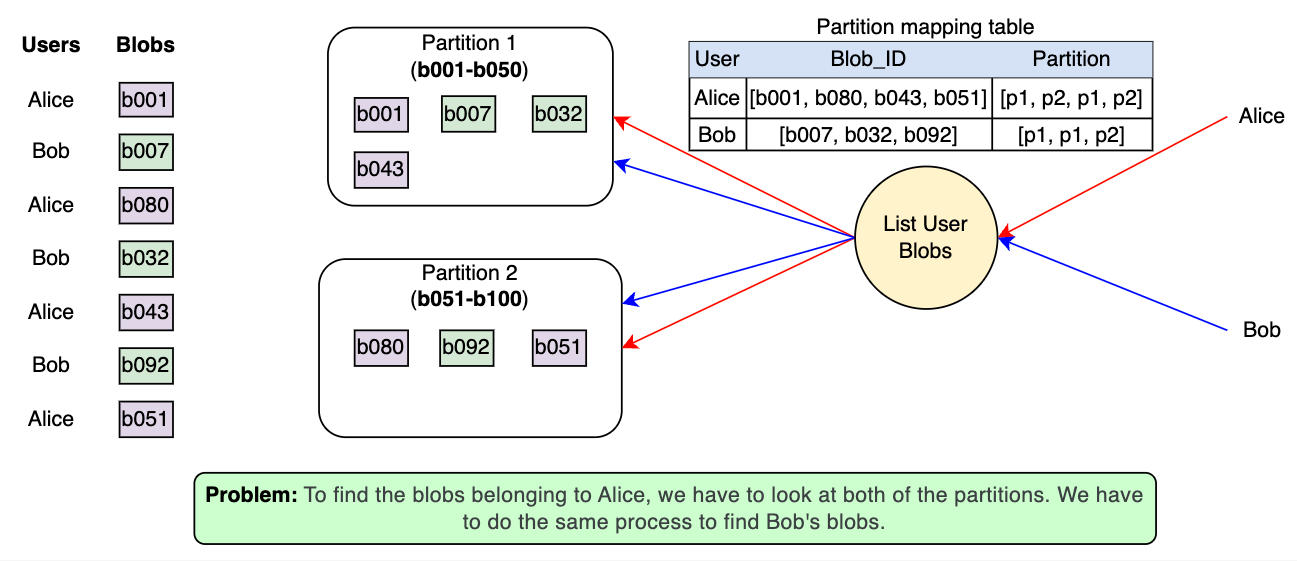
Партиционирование на основе blob_ID вызывает определенные проблемы. Например, блобы под определенным контейнером или учетной записью могут находиться в разных партициях, что добавляет дополнительную нагрузку при чтении или перечислении блобов, связанных с конкретной учетной записью или конкретным контейнером.
Чтобы преодолеть вышеописанную проблему, мы можем партиционировать блобы на основе полного пути блоба. Ключ партиции здесь представляет собой комбинацию account_ID, container_ID и blob_ID. Это помогает сосредоточить блобы для одного пользователя на одном сервере партиции, что улучшает производительность.
Примечание: Карты партиций поддерживаются узлом-менеджером, и эти карты хранятся в распределенном хранилище метаданных.
Индексация блобов
Поиск конкретных блобов в море блобов становится более сложным и требует больше времени с увеличением числа блобов, загружаемых в хранилище. Индекс блобов решает проблему управления блобами и их запроса.
Для заполнения индекса блобов мы определяем атрибуты ключ-значение (теги) для блобов при их загрузке. Мы используем несколько тегов, таких как имя контейнера, имя блоба, дата и время загрузки и некоторые другие категории, например, блобы изображений или видео и так далее.
Как показано на следующей иллюстрации, индексирующий движок блобов читает новые теги, индексирует их и предоставляет доступ к поисковому индексу блобов:
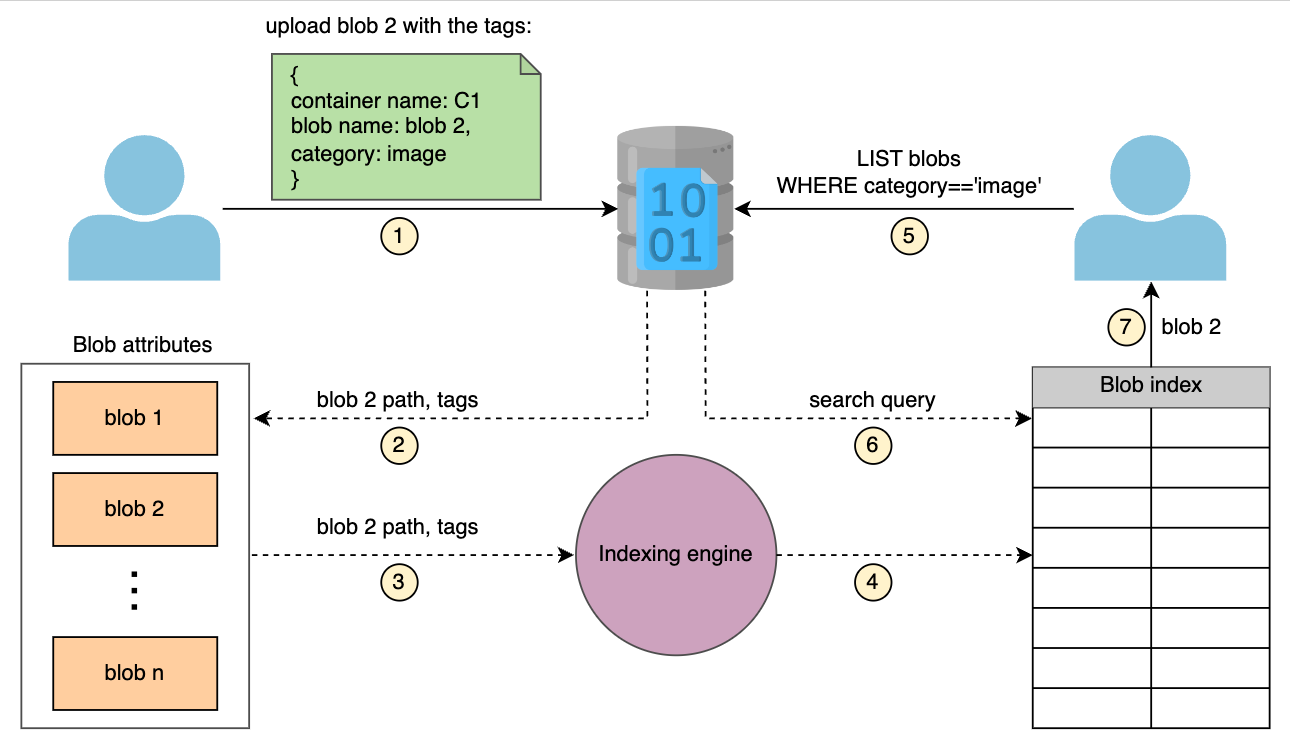
Мы можем категоризировать блобы, а также сортировать их с помощью индексации. Давайте посмотрим, как мы используем индексацию при пагинации.
Пагинация для перечисления
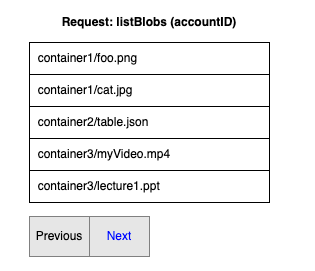
Перечисление — это возвращение списка блобов пользователю в зависимости от введенного пользователем префикса. Префикс — это символ или строка, которая возвращает блобы, имя которых начинается с этого конкретного символа или строки.
Пользователи могут захотеть перечислить все блобы, связанные с их учетной записью, все блобы, находящиеся внутри определенного контейнера, или они могут захотеть перечислить некоторые публичные блобы на основе префикса. Проблема в том, что этот список может быть очень длинным. Мы не можем вернуть весь список пользователю за один раз. Поэтому мы должны возвращать список блобов частями.
Предположим, что пользователь хочет получить список блобов, связанных с его учетной записью, и всего с этой учетной записью связано 2000 блобов. Поиск, возвращение и загрузка слишком большого количества блобов сразу влияет на производительность. Здесь становится важна пагинация. Мы можем вернуть первые пять результатов и предоставить пользователям кнопку "далее". При каждом нажатии на кнопку "далее" возвращаются следующие пять результатов. Это называется пагинацией.
How do we decide which five blobs to return first out of the 2,000 blobs total?
Details
Here, we utilize indexing to sort and categorize the blobs. We should do this beforehand, while we store the blobs. Otherwise, it becomes challenging at the time of returning the list to the user. There could be millions or billions of blobs and we can’t sort them quickly when the list request is received.
Владельцы приложений устанавливают количество возвращаемых результатов в зависимости от следующих факторов:
- Сколько времени они считают приемлемым для ожидания ответа на запрос.
- Сколько результатов они могут вернуть за это время. Мы показали пять результатов на страницу, что является очень маленьким числом. Мы используем это число только для визуализации.
Для пагинации нам нужен токен продолжения в качестве отправной точки для следующей части списка, который будет возвращен. Токен продолжения — это строковый токен, включаемый в ответ на запрос, если общее количество запрошенных результатов превышает максимальное количество результатов, которые мы можем вернуть за один раз. Таким образом, он служит указателем, позволяя повторному запросу продолжить с того места, на котором остановились.
Репликация
Репликация выполняется на двух уровнях для обеспечения доступности и сильной согласованности. Чтобы поддерживать данные сильно согласованными, мы синхронно реплицируем данные между узлами, которые используются для обслуживания запросов на чтение, сразу после выполнения операции записи. Для достижения доступности мы можем реплицировать данные в разные регионы или дата-центры после выполнения операции записи. Мы не обслуживаем запросы на чтение из других дата-центров или регионов до тех пор, пока данные не будут реплицированы.
Это два уровня репликации:
- Синхронная репликация внутри кластера хранилища.
- Асинхронная репликация между дата-центрами и регионами.
Синхронная репликация внутри кластера хранилища
Кластер хранилища состоит из нескольких стоек узлов хранения, каждая из которых настроена как отказоустойчивый домен с избыточным сетевым и энергетическим обеспечением.
Мы гарантируем, что все данные, записанные в кластер хранилища, сохраняются устойчивыми внутри этого кластера хранилища. Узел-менеджер поддерживает достаточное количество реплик данных по узлам в разных отказоустойчивых доменах, чтобы обеспечить устойчивость данных внутри кластера в случае сбоя диска, узла или стойки.
Примечание: Эта внутрикластерная репликация выполняется на критическом пути запросов на запись клиента.
Успешный ответ может быть возвращен клиенту после того, как запись будет синхронно реплицирована внутри этого кластера хранилища. Это позволяет ускорить запись, так как:
- Мы реплицируем данные внутри кластера хранилища, где все узлы находятся рядом, что снижает задержку.
- Мы используем встроенное копирование данных, где используются избыточные сетевые пути для параллельного копирования данных на все реплики.
Эта техника репликации помогает поддерживать согласованность данных и доступность внутри кластера хранилища.
Асинхронная репликация между дата-центрами и регионами
Дата-центры blob store находятся в разных регионах, например, Азиатско-Тихоокеанский регион, Европа, восточная часть США и другие. В каждом регионе у нас есть более одного дата-центра, расположенного в разных местах, чтобы в случае выхода одного дата-центра из строя у нас были другие дата-центры в том же регионе, которые могли бы обрабатывать запросы пользователей. В каждом регионе имеется минимум три дата-центра, каждый из которых расположен на определенном расстоянии друг от друга, чтобы защититься от локальных событий, таких как пожары, наводнения и так далее.
Количество копий блоба называется коэффициентом репликации. В большинстве случаев коэффициента репликации, равного трем, достаточно.
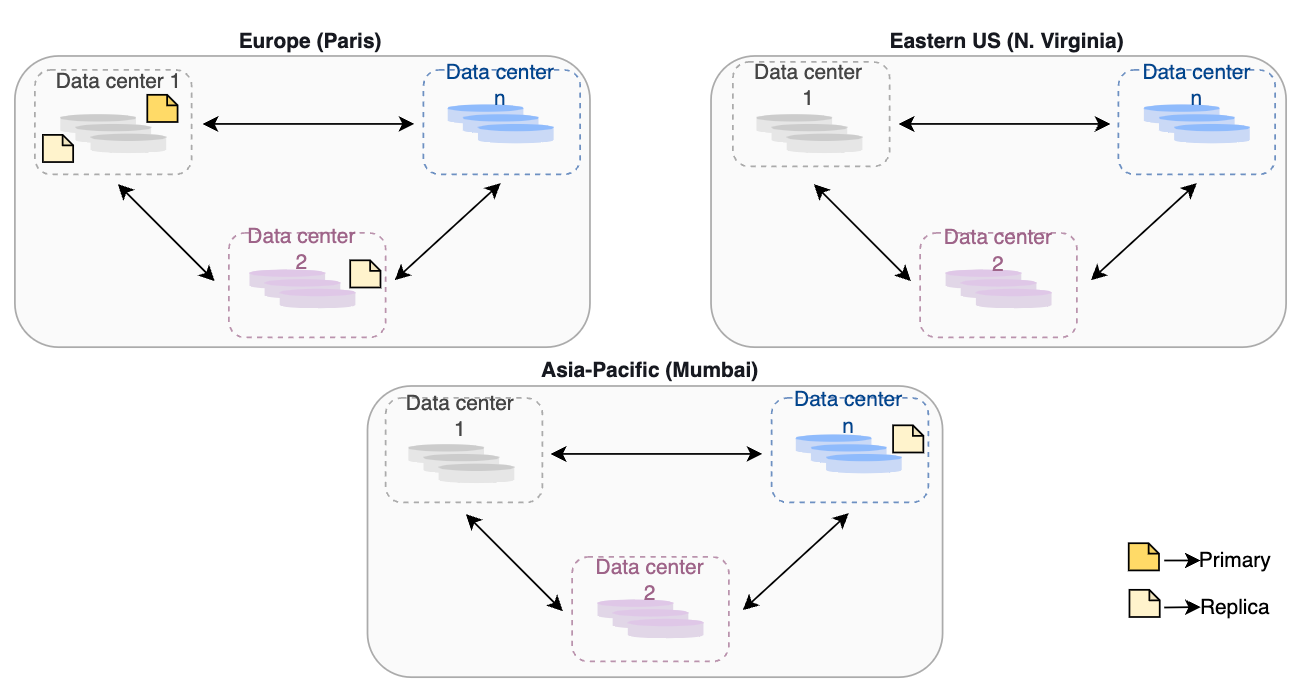
Мы сохраняем три копии блоба. Одна — это локальная копия внутри дата-центра в основном регионе для защиты от сбоев серверных стоек и дисков. Вторая копия блоба размещается в другом дата-центре в том же регионе для защиты от пожара или наводнения в дата-центре. Третья копия размещается в дата-центре в другом регионе для защиты от региональных катастроф.
Сборка мусора при удалении блоба
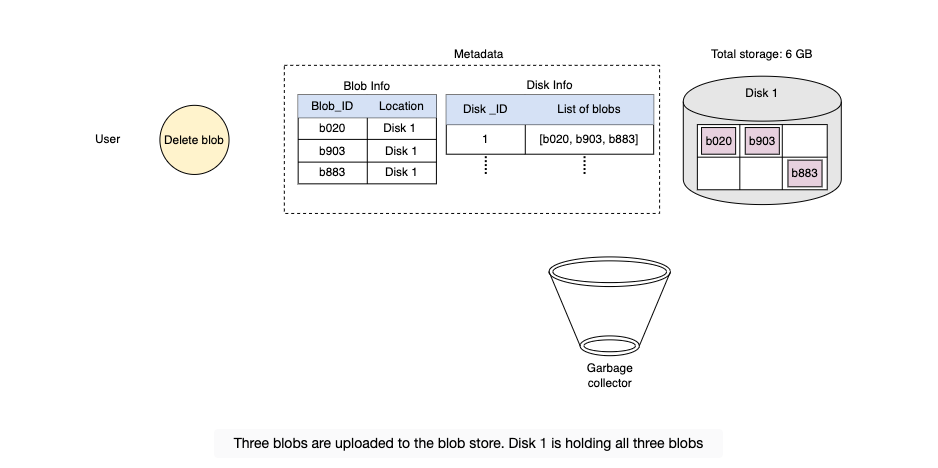
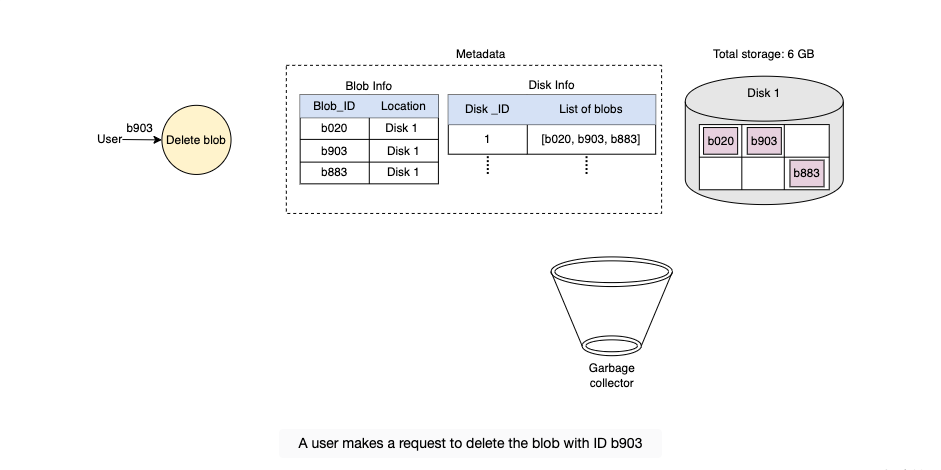
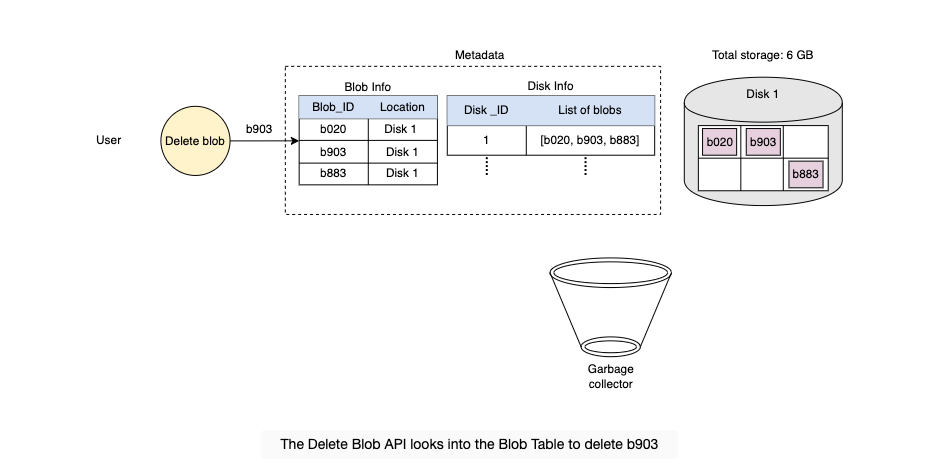
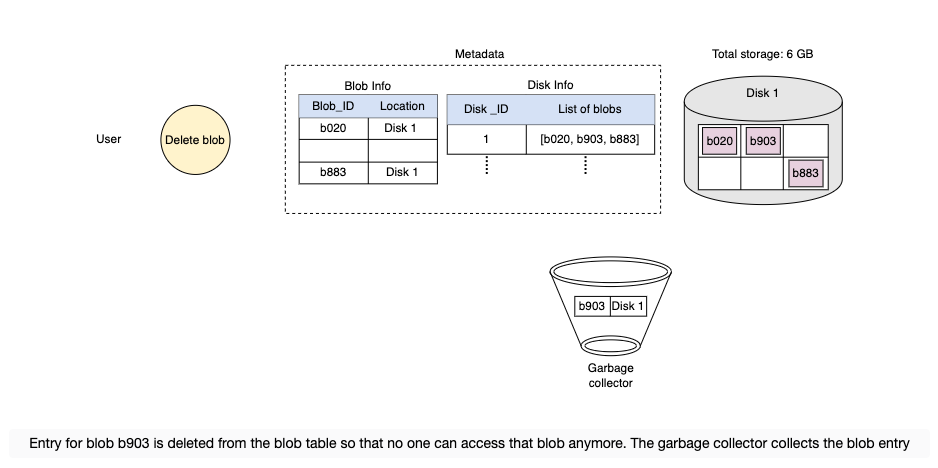
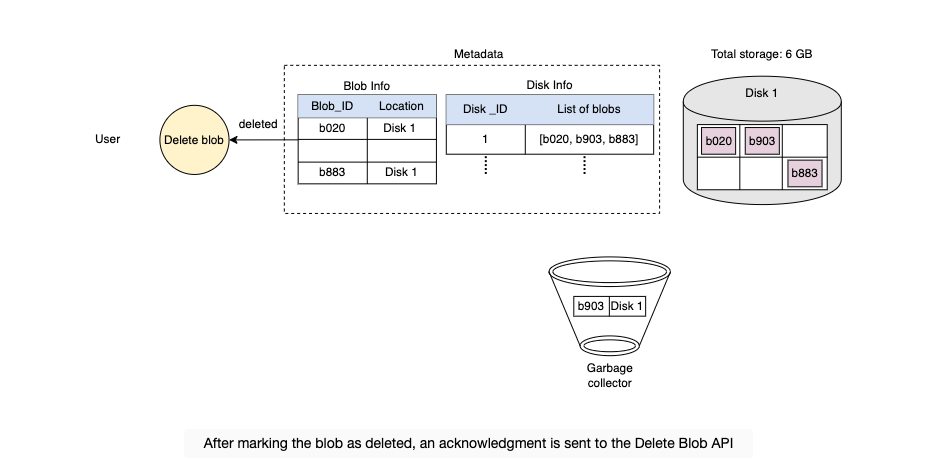
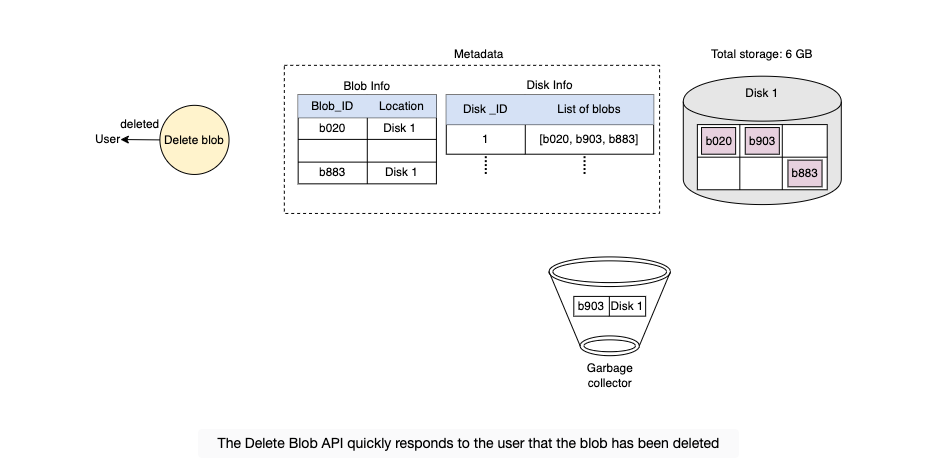
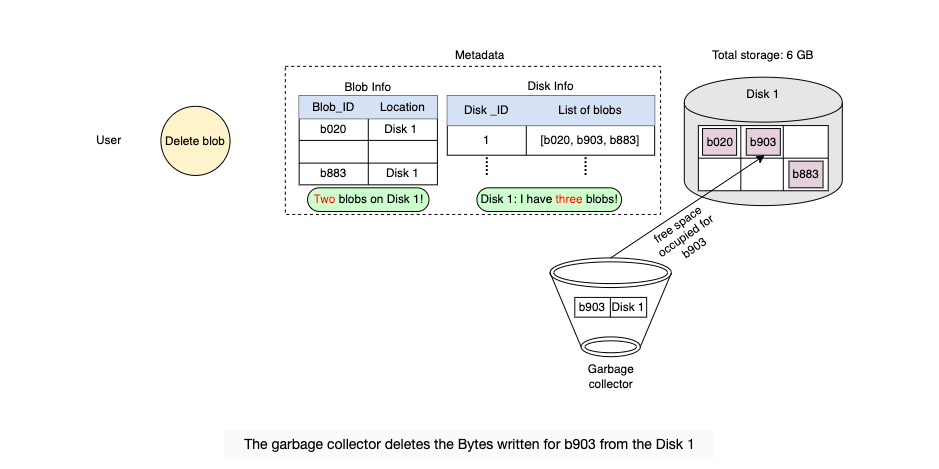
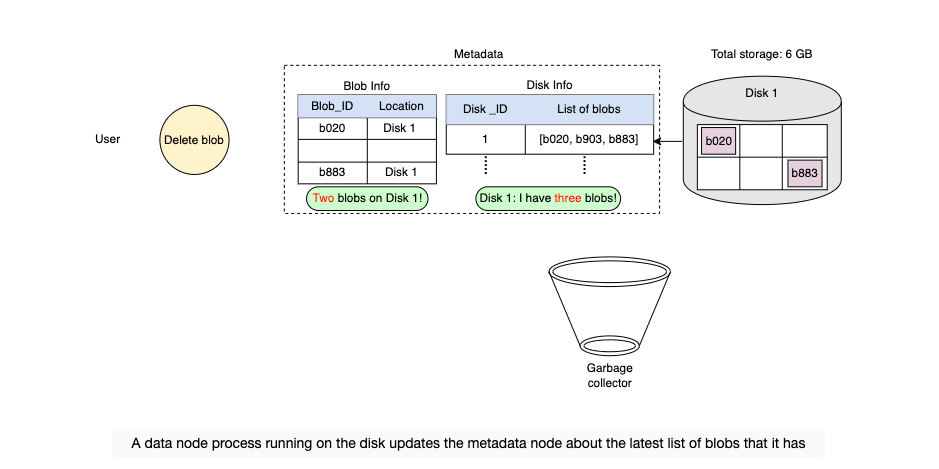
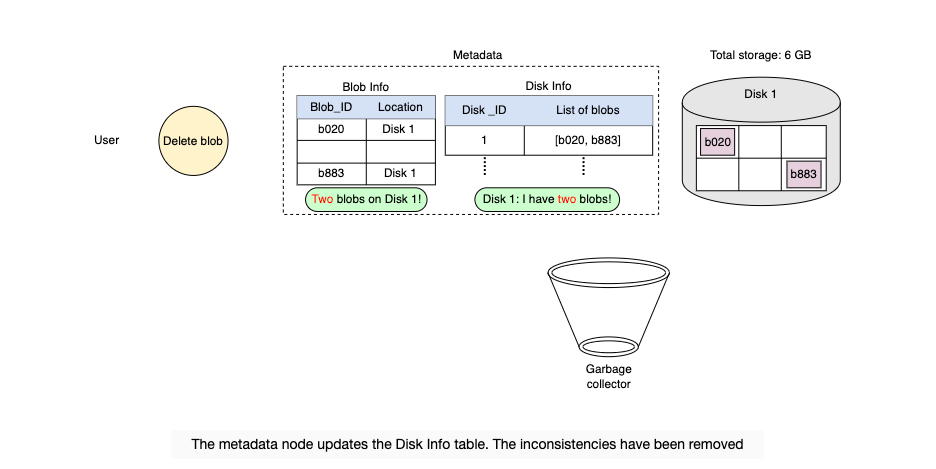
Поскольку чанки блоба размещены на разных узлах данных, их удаление с разных узлов занимает время, и ожидание клиента до завершения этого процесса не является жизнеспособным вариантом. В связи с оптимизацией времени задержки в реальном времени, мы не удаляем блоб из хранилища блобов в ответ на запрос на удаление. Вместо этого мы просто помечаем блоб как "УДАЛЕННЫЙ" в метаданных, чтобы сделать его недоступным для пользователя. Блоб удаляется позже после того, как будет отправлен ответ на запрос пользователя об удалении.
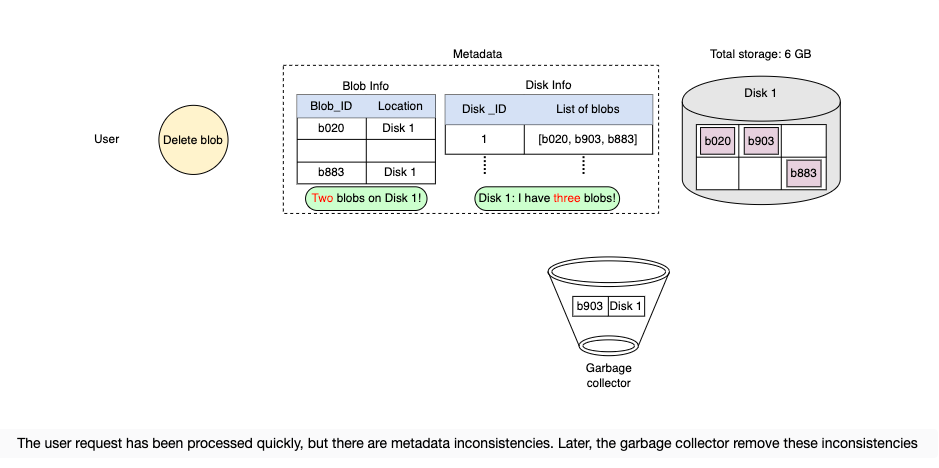
Пометка блоба как удаленного, но не его фактическое удаление в данный момент, вызывает внутренние несоответствия в метаданных, что означает, что хранилище продолжает занимать место, которое должно быть освобождено. Эти несоответствия в метаданных не оказывают влияния на пользователя. Например, для блоба, помеченного как удаленный в метаданных, у нас все еще есть записи о чанках этого блоба в метаданных. Узлы данных продолжают удерживать чанки этого блоба. Поэтому у нас есть служба, называемая сборщиком мусора, которая позже очищает несоответствия в метаданных. Удаление блоба вызывает освобождение чанков, связанных с этим блобом. Однако между моментом удаления блоба пользователем и моментом соответствующего увеличения свободного пространства в хранилище блобов может пройти значительное время. Мы можем принять эту задержку во времени, так как в обмен на это мы получаем выгоду от быстрого ответа на запрос пользователя об удалении блоба в реальном времени.
Стриминг файла
Для стриминга файла нам нужно определить, сколько байтов можно прочитать за один раз. Допустим, мы читаем X байтов за раз. В первый раз мы читаем первые X байтов, начиная с 0-го байта (0 до X-1), а в следующий раз читаем следующие X байтов (X до 2X-1).
How do we know which Bytes we have read first and which Bytes we have to read next?
Details
We can use an offset value to keep track of the Byte from which we need to start reading again.
Кэширование в хранилище блобов
Кэширование может происходить на нескольких уровнях. Ниже приведены некоторые примеры:
- Метаданные чанков блоба кэшируются на стороне клиента при первом чтении. Клиент может напрямую обращаться к узлам данных, не связываясь с узлом-менеджером, чтобы прочитать тот же блоб во второй раз.
- На фронтенд-серверах мы кэшируем карту партиций и используем ее для определения того, на какой сервер партиции перенаправить каждый запрос.
- Часто используемые чанки кэшируются на узле-менеджере, что помогает нам эффективно стримить большие объекты. Это также снижает количество операций ввода-вывода на диске.
Примечание: Кэширование в хранилище блобов обычно осуществляется с использованием CDN. Сервис Azure Blob Store кэширует общедоступные блобы в Azure Content Delivery Network до истечения срока их действия (TTL). Исходный сервер определяет TTL, а CDN определяет его из заголовка Cache-Control в HTTP-ответе от исходного сервера.
Мы рассмотрели факторы дизайна, которые следует учитывать при проектировании хранилища блобов. Теперь мы оценим, что мы спроектировали.
Evaluation of a Blob Store's Design
Доступность
Часть нашего дизайна, связанная с репликацией, обеспечивает доступность системы. Для чтения данных мы сохраняем четыре реплики для каждого блоба. Наличие реплик позволяет распределять нагрузку запросов. Если один узел выходит из строя, другой узел-реплика может обслуживать запрос. Более того, наша стратегия размещения реплик справляется с отказом целого дата-центра и даже может справиться с недоступностью региона из-за природных катастроф. Мы обеспечиваем наличие достаточного количества реплик в любое время с помощью службы мониторинга, которая своевременно создает копию данных, если количество вышедших из строя реплик превышает установленный порог.
Для запросов на запись мы реплицируем данные внутри кластера отказоустойчивым способом и быстро отвечаем пользователю, обеспечивая доступность системы для запросов на запись.
Чтобы поддерживать доступность узла-менеджера, мы сохраняем резервную копию его состояния. В случае сбоя узла-менеджера мы запускаем новый экземпляр узла-менеджера, инициализируя его из сохраненного состояния.
Долговечность
Репликация и службы мониторинга обеспечивают долговечность данных. Данные, после загрузки, синхронно реплицируются внутри кластера хранилища. Если на одном узле происходит потеря данных, мы можем восстановить данные с других узлов. Служба мониторинга контролирует диски хранения. Если какой-либо диск выходит из строя, служба мониторинга оповещает администраторов о необходимости замены диска и отправляет сообщения узлу-менеджеру, чтобы скопировать содержимое этого диска на другой доступный диск или на вновь добавленный диск. Узел-менеджер затем обновляет соответствие данных.
Масштабируемость
Разделение и разбиение блобов на мелкие чанки помогает нам масштабировать обработку миллиардов запросов к блобам. Блобы разделяются на отдельные диапазоны и обслуживаются различными серверами партиций. Таблицы соответствий партиций указывают, какой сервер партиций будет обслуживать запросы на определенные диапазоны блобов. Партиционирование также обеспечивает автоматическое балансирование нагрузки между серверами партиций для удовлетворения потребностей в трафике блобов.
Наша система горизонтально масштабируема для хранения данных. По мере увеличения потребности в хранилище мы добавляем больше узлов данных. Однако в какой-то момент узел-менеджер может стать узким местом. Один узел-менеджер может обрабатывать до 10,000 запросов в секунду (QPS).
Пропускная способность
Мы сохраняем чанки блоба на различных узлах данных, что позволяет распределять запросы к блобу по нескольким машинам. Параллельное получение чанков с нескольких узлов данных помогает нам достичь высокой пропускной способности.
Кроме того, кэширование на разных уровнях — на стороне клиента, на фронтенд-серверах и на узле-менеджере — улучшает нашу пропускную способность и снижает задержку.
Надежность
Мы достигаем надежности с помощью наших техник мониторинга. Например, протокол heartbeat (проверка состояния) держит узел-менеджер в курсе состояния узлов данных. Это позволяет узлу-менеджеру запрашивать данные только с надежных узлов. Более того, в случае сбоя узла узел-менеджер принимает необходимые меры, например, запрашивает добавление нового узла-реплики.
Службы мониторинга также уведомляют администраторов о необходимости замены неисправного оборудования, такого как вышедшие из строя диски или поврежденные сетевые соединения или коммутаторы. Чтобы обеспечить надежность обслуживания, узел-менеджер отслеживает доступное пространство на диске. Если оставшееся доступное пространство достигает определенного порога, администраторам отправляется уведомление о необходимости добавления новых дисков.
Согласованность
Мы синхронно реплицируем блоки данных на диске внутри кластера хранилища при запросе на запись, обеспечивая сильную согласованность данных внутри кластера хранилища. Это выполняется на критическом пути пользователя. Мы обслуживаем последующие запросы на чтение этих данных из того же кластера хранилища до тех пор, пока не реплицируем эти данные в другой дата-центр или другие кластеры хранилища.
How can we further scale when our manager server hits its limits and we can’t improve its computational abilities by vertical scaling?
Details
We can make two independent instances of our system. Each instance will have its own manager node and a set of data nodes. Deployment of a system similar to ours has been shown to scale up to a few petabytes. Therefore, making additional instances can help us scale further.
For further scaling inside a single instance, we need a new, more complicated design.
После ответа на запрос на запись и репликации данных внутри кластера хранилища, мы асинхронно реплицируем блобы в дата-центры, расположенные в других регионах, для обеспечения доступности.
We haven’t discussed security as a nonfunctional requirement for the blob store. Now, it’s your turn to think about how we can implement security to keep the data at rest and in transit safe.
What techniques would you use to make the blob store secure? Write your answer in the widget below.
Details
For ensuring the security of a blob store, you would use AES (Advanced Encryption Standard) to encrypt data at rest, making it unreadable without the decryption key. For data in transit, HTTPS (Hypertext Transfer Protocol Secure) should be used, as it encrypts communication between clients and the blob store, safeguarding against unauthorized access and ensuring data confidentiality and integrity. Role-based access control (RBAC) is important for regulating user permissions and restricting access to sensitive data. Additionally, implementing data integrity checks, like checksums or hash functions, helps ensure data remains unchanged and uncorrupted during storage and transmission.
Заключение
Мы рассмотрели проектирование системы хранения блобов для хранения больших и неструктурированных данных. Хранилище блобов помогает приложениям сохранять изображения, видео, аудио и другие типы данных. В настоящее время оно используется многими приложениями, такими как YouTube, Facebook, Instagram, Twitter и другие. Мы спроектировали систему, в которой пользователи могут выполнять основные функции хранилища блобов. Наконец, мы оценили наш дизайн на основе наших нефункциональных требований.