Non-functional characteristics
Availability - Доступность
What is availability?
Availability is the percentage of time that some service or infrastructure is accessible to clients and is operated upon under normal conditions. For example, if a service has 100% availability, it means that the said service functions and responds as intended (operates normally) all the time.

We measure availability as a number of nines. The following table shows how much downtime is permitted when we’re using a given number of nines.
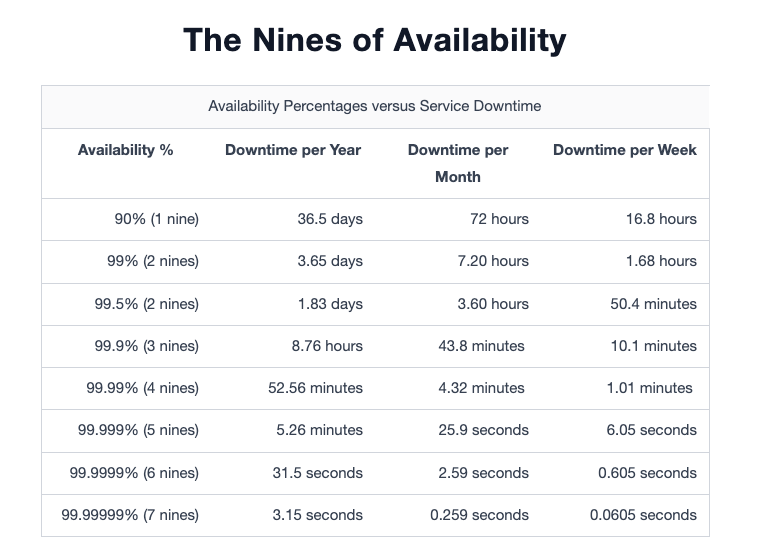
Каждый поставщик услуг может начать измерять доступность в разные моменты времени. Некоторые поставщики облачных услуг начинают измерять ее, когда впервые предлагают услугу, в то время как некоторые измеряют ее для определенных клиентов, когда они начинают пользоваться услугой. Некоторые поставщики могут не уменьшать свои сообщаемые показатели доступности, если их услуга не была отключена для всех клиентов. Плановые простои исключены. Простои из-за кибератак могут не быть включены в расчет доступности. Поэтому мы должны тщательно разобраться, как конкретный поставщик рассчитывает свои показатели доступности.
Еще раз
Когда в системном дизайне говорят о доступности (availability), речь идет о том, насколько часто и стабильно система, сервис или приложение доступны для пользователей. Это включает в себя доступность как серверов, на которых работают приложения, так и самого приложения для конечных пользователей.
Доступность сервера подразумевает, что физический сервер или инфраструктура, на которой размещено приложение, функционирует и доступна для работы.
Доступность приложения означает, что само приложение (сервис) работает корректно и отвечает на запросы пользователей в соответствии с ожиданиями.
Доступность обычно измеряется в процентах или в виде числа «девяток» (например, 99.9% или 99.999%), что указывает на количество времени, в течение которого система должна быть доступна и работоспособна. Чем больше число «девяток», тем меньше допустимое время простоя.
В контексте доступности важно учитывать, как она рассчитывается, включая исключения для плановых простоев или инцидентов, связанных с кибератаками.
Reliability - Надежность
What is reliability?
Reliability, R, is the probability that the service will perform its functions for a specified time. R measures how the service performs under varying operating conditions.
We often use mean time between failures (MTBF) and mean time to repair (MTTR) as metrics to measure R.
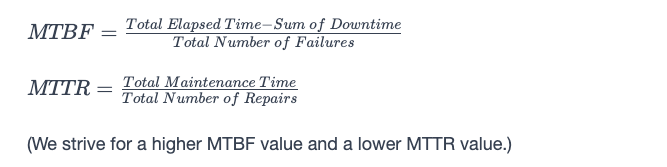
Мы стремимся к тому, чтобы значение MTBF было выше, а MTTR — ниже.
Надежность (Reliability, R) — это вероятность того, что сервис будет выполнять свои функции в течение заданного времени. Надежность измеряет, насколько стабильно сервис работает в различных условиях эксплуатации.
Связь надежности и доступности
Надежность (R) и доступность (A) — это два разных, но связанных между собой понятия. Математически доступность (A) является функцией от надежности (R). Это значит, что значение надежности может изменяться независимо, а доступность зависит от надежности.
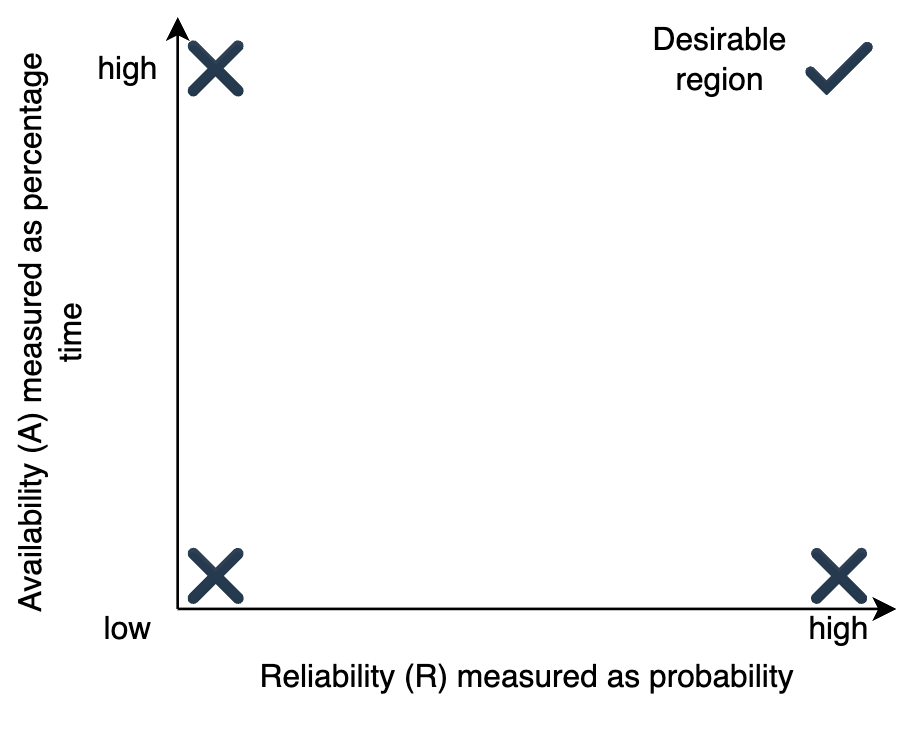
Поэтому возможны следующие сценарии:
- низкая доступность, низкая надежность,
- низкая доступность, высокая надежность,
- высокая доступность, низкая надежность,
- высокая доступность, высокая надежность (желательный вариант).
Примечание по поводу MTBF
Существует несколько вариаций показателя MTBF, таких как среднее время до отказа (MTTF). Обычно используется MTTF в тех случаях, когда вышедший из строя компонент заменяется, так как его невозможно починить. Примером могут быть сломанный диск или перегоревшая лампочка, которые требуют замены.
Объясни будто мне 10 лет
Представь, что у тебя есть игрушечный автомобиль.
Что такое надежность?
Надежность — это то, как часто этот автомобиль ломается. Если он редко ломается и ты можешь долго играть с ним без проблем, то автомобиль очень надежный. Если он ломается часто, значит, он ненадежный.
Что такое доступность?
Доступность — это то, как часто ты можешь играть с этим автомобилем. Например, если автомобиль сломался, и ты не можешь с ним играть, он недоступен. Если он работает и ты можешь играть с ним всегда, когда захочешь, значит, автомобиль доступен.
В чем разница?
- Надежность — это о том, как часто что-то ломается.
- Доступность — о том, как часто ты можешь использовать эту вещь.
Как они связаны?
Представь, что твой автомобиль ломается нечасто, но починка занимает много времени. Значит, даже если автомобиль надежный (ломается редко), доступность будет низкой, потому что ты не можешь с ним играть, пока он чинится.
С другой стороны, если автомобиль ломается часто, но ты быстро его чинишь, он может быть доступен почти всё время, даже если он не очень надежный.
Примеры:
-
Низкая надежность и низкая доступность: Автомобиль часто ломается, и его долго чинят. Ты редко можешь с ним играть.
-
Низкая надежность и высокая доступность: Автомобиль часто ломается, но его быстро чинят. Ты всё равно можешь играть с ним почти всегда.
-
Высокая надежность и низкая доступность: Автомобиль редко ломается, но если это случается, его долго чинят. Ты редко не можешь с ним играть, но если это происходит, это надолго.
-
Высокая надежность и высокая доступность: Автомобиль редко ломается и его быстро чинят. Ты можешь играть с ним почти всё время. Это идеальный вариант!
Для взрослого
Надежность измеряет, насколько хорошо система выполняет свои предназначенные операции (функциональные требования). Для этого используются средние значения, такие как среднее время до отказа (MTTF) или среднее время на восстановление (MTTR).
Доступность измеряет процент времени, в течение которого система принимает запросы и отвечает клиентам.
Пример 1:
Некоторая система может быть доступна в 90% времени, но только в 80% случаев надежна. Это значит, что система может работать и принимать запросы в 90% времени, но при этом корректно выполнять свои функции только в 80% случаев.
Пример 2:
Представь, что мы рассматриваем "систему" как все, что находится внутри дата-центра (оборудование + программное обеспечение). Допустим, что этот дата-центр сталкивается с сетевой проблемой, из-за которой трафик не поступает извне и не выходит наружу. В этом случае мгновенная доступность может быть равна нулю (так как клиенты не могут достичь сервиса), даже если внутри дата-центра все системы работают идеально (мгновенная надежность 100%).
Мы используем оба этих показателя (надежность и доступность) в разных контекстах. Например, поставщики хранилищ часто указывают MTTF для своих дисков. Большинство онлайн-сервисов используют время безотказной работы (как меру доступности) в своих соглашениях об уровне обслуживания (SLA). Например, время безотказной работы виртуальных машин EC2 составляет 99,95%.
Объяснение
-
Надежность показывает, как часто система работает так, как ожидается, без сбоев. Это означает, что система может быть надежной, если она редко ломается и выполняет все свои функции корректно.
-
Доступность показывает, насколько часто система доступна для использования. Это означает, что система может быть доступной, если она принимает запросы и отвечает на них, даже если она не всегда выполняет эти запросы правильно.
Эти два показателя могут не совпадать. Например, система может быть всегда доступна (например, сервер работает и отвечает на запросы), но при этом она может часто давать сбои, выполняя эти запросы (то есть быть ненадежной). В другом примере, система внутри дата-центра может работать идеально (надежно), но если сеть не работает, клиенты не смогут к ней подключиться, и доступность будет нулевой.
Поэтому важно учитывать оба показателя, когда оцениваешь систему: насколько она надежна (частота сбоев) и насколько она доступна (частота ответов на запросы).
Scalability - Масштабируемость
What is scalability?
Scalability is the ability of a system to handle an increasing amount of workload without compromising performance. A search engine, for example, must accommodate increasing numbers of users, as well as the amount of data it indexes.
The workload can be of different types, including the following:
- Request workload: This is the number of requests served by the system.
- Data/storage workload: This is the amount of data stored by the system.
Dimensions
Here are the different dimensions of scalability:
- Size scalability: A system is scalable in size if we can simply add additional users and resources to it.
- Administrative scalability: This is the capacity for a growing number of organizations or users to share a single distributed system with ease.
- Geographical scalability: This relates to how easily the program can cater to other regions while maintaining acceptable performance constraints. In other words, the system can readily service a broad geographical region, as well as a smaller one.
Different approaches of scalability
Here are the different ways to implement scalability.
Vertical scalability—scaling up
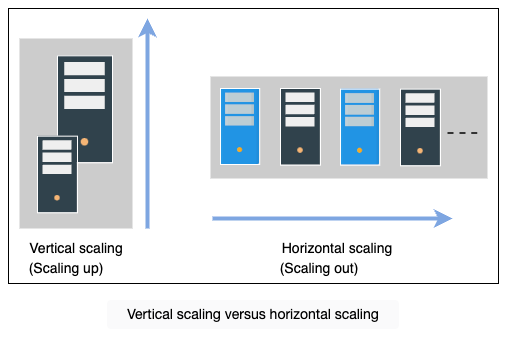
Vertical scaling, also known as “scaling up,” refers to scaling by providing additional capabilities (for example, additional CPUs or RAM) to an existing device. Vertical scaling allows us to expand our present hardware or software capacity, but we can only grow it to the limitations of our server. The dollar cost of vertical scaling is usually high because we might need exotic components to scale up.
Horizontal scalability—scaling out
Horizontal scaling, also known as “scaling out,” refers to increasing the number of machines in the network. We use commodity nodes for this purpose because of their attractive dollar-cost benefits. The catch here is that we need to build a system such that many nodes could collectively work as if we had a single, huge server.
Что такое масштабируемость?
Масштабируемость — это способность системы обрабатывать увеличивающийся объем рабочей нагрузки без ухудшения производительности. Например, поисковая система должна справляться с увеличением числа пользователей, а также с ростом объема данных, которые она индексирует.
Рабочая нагрузка может быть разных типов, включая следующие:
- Запросы: Это количество запросов, обслуживаемых системой.
- Данные/хранилище: Это объем данных, хранящихся в системе.
Измерения масштабируемости
Вот различные измерения масштабируемости:
- Масштабируемость по размеру: Система является масштабируемой по размеру, если мы можем просто добавлять к ней дополнительных пользователей и ресурсы.
- Административная масштабируемость: Это способность растущего числа организаций или пользователей легко использовать единую распределенную систему.
- Географическая масштабируемость: Это способность программы обслуживать другие регионы, сохраняя приемлемую производительность. Иными словами, система может легко обслуживать как широкую географическую область, так и меньшую.
Разные подходы к масштабируемости
Вот различные способы реализации масштабируемости.
Вертикальная масштабируемость — увеличение ресурсов
Вертикальная масштабируемость, также известная как "масштабирование вверх" (scaling up), относится к увеличению ресурсов, таких как дополнительные процессоры (CPU) или оперативная память (RAM), на существующем устройстве. Вертикальная масштабируемость позволяет нам расширять текущую аппаратную или программную мощность, но она ограничена возможностями нашего сервера. Стоимость вертикального масштабирования обычно высокая, так как могут потребоваться дорогие компоненты для увеличения мощности.
Горизонтальная масштабируемость — увеличение количества узлов
Горизонтальная масштабируемость, также известная как "масштабирование вширь" (scaling out), относится к увеличению числа машин в сети. Для этого используются стандартные узлы (commodity nodes) из-за их привлекательных экономических преимуществ. Основная задача заключается в том, чтобы создать систему, в которой многие узлы могли бы совместно работать так, как если бы у нас был один большой сервер.
Как лучше масштабироваться?
Выбор между вертикальной и горизонтальной масштабируемостью зависит от конкретных требований, бюджета и долгосрочных целей вашей системы. Давайте рассмотрим плюсы и минусы каждого подхода, чтобы понять, когда лучше использовать каждый из них.
Вертикальная масштабируемость (Scaling Up)
Плюсы:
- Простота: Легче внедрить, так как нужно просто добавить больше ресурсов (например, процессоров или памяти) в уже существующий сервер.
- Отсутствие сложных изменений: Не нужно вносить изменения в архитектуру системы. Всё остаётся таким же, только с большими мощностями.
Минусы:
- Ограничения по мощности: Вы ограничены пределами вашего оборудования. Нельзя бесконечно добавлять процессоры или память.
- Высокая стоимость: Как правило, высокопроизводительное оборудование дорогое, и чем больше ресурсов вы добавляете, тем выше стоимость.
- Единая точка отказа: Если сервер выйдет из строя, вся система может перестать работать.
Когда использовать:
- Когда система не требует огромных мощностей и простота масштабирования важнее.
- Когда ваше приложение имеет узкие места, которые можно устранить увеличением ресурсов на сервере.
Горизонтальная масштабируемость (Scaling Out)
Плюсы:
- Неограниченное расширение: Вы можете добавлять столько серверов, сколько необходимо, обеспечивая практически неограниченный рост.
- Экономическая эффективность: Можно использовать стандартные, недорогие серверы, что снижает затраты на масштабирование.
- Высокая отказоустойчивость: При выходе из строя одного из серверов другие могут продолжать работать, что улучшает общую надежность системы.
Минусы:
- Сложность архитектуры: Требуются архитектурные изменения, чтобы система могла работать с распределенными узлами (например, нужно управлять нагрузкой между серверами).
- Задержки: Могут возникнуть задержки при координации работы множества серверов, особенно если они находятся в разных регионах.
Когда использовать:
- Когда ваша система требует масштабирования до очень большого числа пользователей или данных.
- Когда вы хотите повысить отказоустойчивость и не зависеть от одного сервера.
- Когда важно обеспечить географическую масштабируемость, чтобы обслуживать пользователей по всему миру.
Резюме
- Вертикальная масштабируемость хороша для простых и небольших систем, где увеличение мощностей одного сервера может решить проблемы с производительностью.
- Горизонтальная масштабируемость предпочтительна для больших систем с потенциально высоким ростом, где важны отказоустойчивость и возможность расширения без серьёзных ограничений.
Если бюджет позволяет и есть возможность разработки более сложной архитектуры, горизонтальная масштабируемость будет более гибким и долгосрочным решением. В противном случае, вертикальная масштабируемость может быть начальным шагом, пока система не достигнет своих пределов.
Maintainability - поддерживаемость
Что такое поддерживаемость?
После создания системы одной из основных задач является обеспечение её бесперебойной работы: поиск и исправление ошибок, добавление новых функций, обновление платформы и поддержание стабильной работы системы. Одной из ключевых характеристик, определяющих такие требования к проектированию системы, является поддерживаемость. Мы можем разделить концепцию поддерживаемости на три основные аспекта:
- Оперативность (Operability): Это простота, с которой мы можем обеспечить бесперебойную работу системы в нормальных условиях и восстановление нормального состояния при возникновении сбоев.
- Простота (Lucidity): Это простота кода. Чем проще кодовая база, тем легче её понять и поддерживать, и наоборот.
- Модифицируемость (Modifiability): Это способность системы интегрировать модифицированные, новые и непредвиденные функции без особых трудностей.
Измерение поддерживаемости
Поддерживаемость (Maintainability, M) — это вероятность того, что сервис восстановит свои функции в течение определённого времени после возникновения сбоя. Поддерживаемость измеряет, насколько удобно и быстро сервис возвращается к нормальным условиям работы.
Например, если для компонента определено значение поддерживаемости 95% в течение получаса, это означает, что вероятность восстановления компонента до его полностью активного состояния в течение получаса составляет 0,95.
Примечание
Поддерживаемость даёт нам представление о способности системы проходить ремонт и модификации, оставаясь при этом в рабочем состоянии.
Мы используем среднее время на восстановление (MTTR) как показатель для измерения поддерживаемости.

Другими словами, MTTR — это среднее время, необходимое для ремонта и восстановления вышедшего из строя компонента. Наша цель — минимизировать значение MTTR.
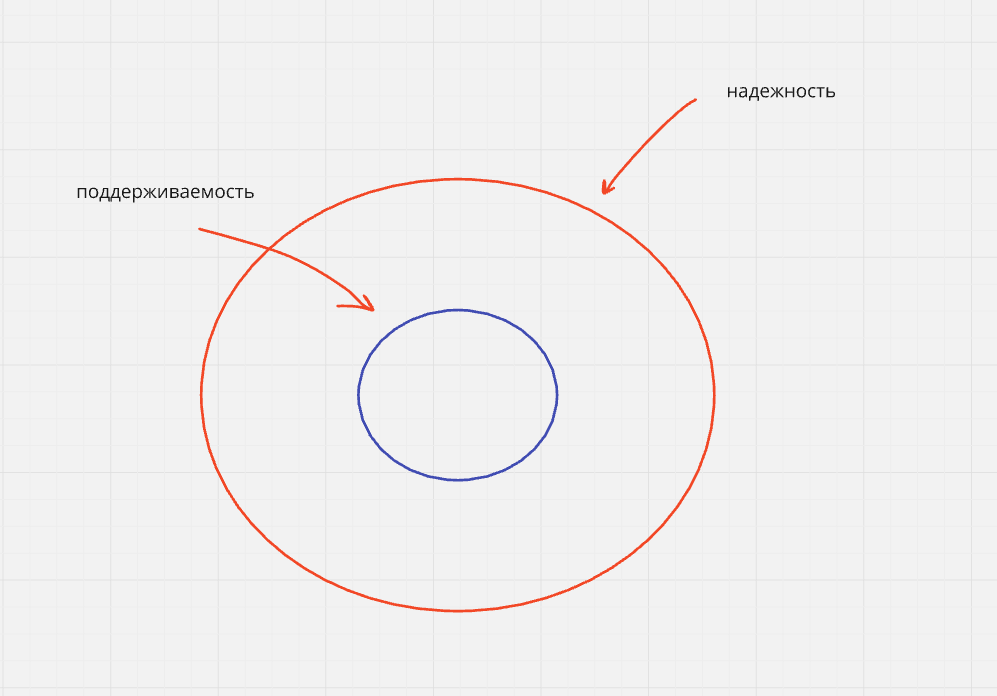
Поддерживаемость и надёжность
Поддерживаемость может быть более чётко определена в тесной связи с надёжностью. Единственное различие между ними заключается в переменной интереса. Поддерживаемость относится ко времени на ремонт, тогда как надёжность учитывает как время на ремонт, так и время до отказа. Совмещение анализа поддерживаемости и надёжности может помочь нам получить представление о доступности, времени простоя и времени безотказной работы системы.
Fault Tolerance - Отказаустойчивость
Что такое отказоустойчивость (Fault Tolerance)?
Реальные крупномасштабные приложения работают на сотнях серверов и баз данных, чтобы обрабатывать миллиарды запросов пользователей и хранить значительные объемы данных. Эти приложения нуждаются в механизме, который обеспечивает сохранность данных и избегает необходимости перерасчета ресурсоемких задач, избегая единой точки отказа (single point of failure).
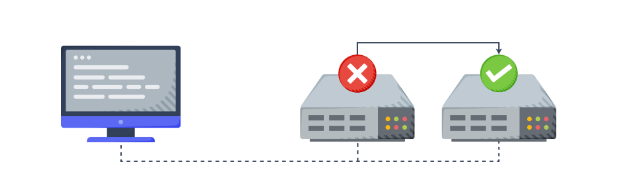
Отказоустойчивость (Fault Tolerance) — это способность системы продолжать работу, даже если один или несколько её компонентов выходят из строя. Под компонентами могут подразумеваться как программное обеспечение, так и оборудование. Создание системы, которая на 100% отказоустойчива, практически очень сложно.
Важные аспекты, требующие отказоустойчивости
- Доступность (Availability): Ориентирована на обеспечение получения каждого клиентского запроса путем обеспечения доступности системы 24/7.
- Надежность (Reliability): Ориентирована на корректную обработку каждого клиентского запроса.
Техники отказоустойчивости (Fault Tolerance Techniques)
Сбой может произойти на уровне оборудования или программного обеспечения, что в конечном итоге влияет на данные. Отказоустойчивость может быть достигнута разными подходами, в зависимости от структуры системы. Рассмотрим техники, которые являются важными и подходящими для большинства дизайнов.
Репликация (Replication)
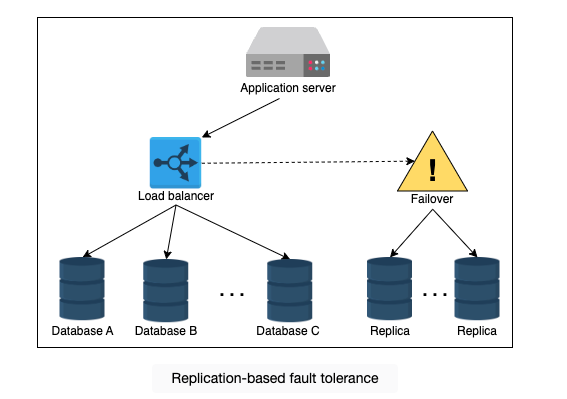
Одна из наиболее широко используемых техник — отказоустойчивость на основе репликации (Replication-based Fault Tolerance). С этой техникой можно реплицировать как сервисы, так и данные. Мы можем заменить вышедшие из строя узлы на работоспособные и заменить вышедшее из строя хранилище данных на его реплику. Большой сервис может сделать это прозрачно, не влияя на конечных пользователей.
Мы создаем несколько копий наших данных в отдельных хранилищах. Все копии нужно регулярно обновлять для поддержания согласованности (consistency), когда в данных происходят изменения. Обновление данных в репликах — это сложная задача. Когда система требует строгой согласованности (strong consistency), мы можем синхронно (synchronously) обновлять данные в репликах. Однако это снижает доступность системы. Мы также можем асинхронно (asynchronously) обновлять данные в репликах, когда можем допустить eventual consistency (постепенную согласованность), что может привести к устаревшим данным, пока все реплики не синхронизируются. Таким образом, существует компромисс между двумя подходами к согласованности. Мы жертвуем либо доступностью, либо согласованностью при сбоях, что описывается в теореме CAP.
Контрольные точки (Checkpointing)
Контрольные точки (Checkpointing) — это техника, которая сохраняет состояние системы в устойчивом хранилище для последующего восстановления в случае сбоев из-за ошибок или перебоев в работе сервиса. Контрольные точки выполняются на разных этапах и в разные моменты времени. Когда распределенная система выходит из строя, мы можем восстановить последние вычисленные данные из предыдущей контрольной точки и продолжить работу с этого места.
Контрольные точки выполняются для различных индивидуальных процессов в системе таким образом, чтобы они представляли глобальное состояние фактического выполнения системы. В зависимости от состояния, контрольные точки можно разделить на два типа:
-
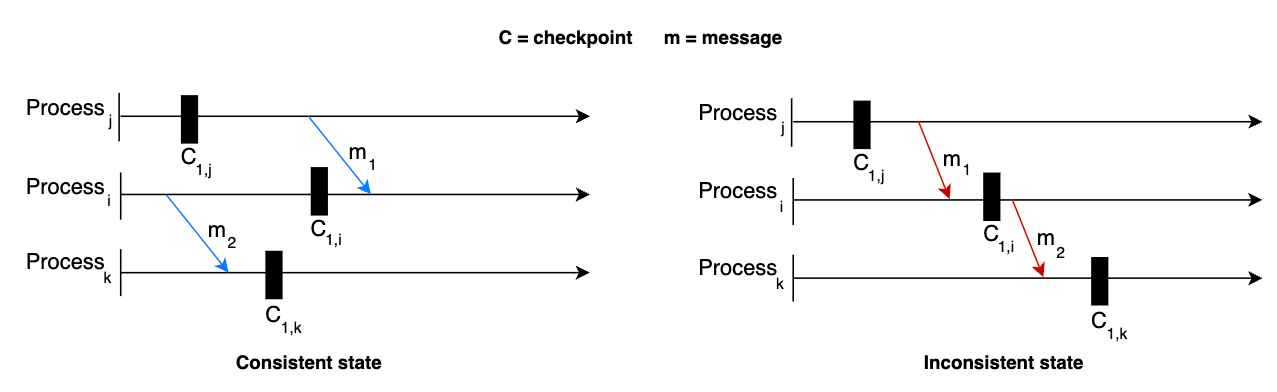
Согласованное состояние (Consistent state): Состояние является согласованным, если все индивидуальные процессы системы имеют единое представление о совместном состоянии или последовательности событий, произошедших в системе. Снимки (snapshots), сделанные в согласованном состоянии, содержат данные в согласованном виде, представляя возможное состояние системы.
-
Несогласованное состояние (Inconsistent state): Это состояние, в котором имеются несоответствия в сохраненном состоянии различных процессов системы. Иными словами, контрольные точки для различных процессов не согласованы и не скоординированы.
Контрольные точки помогают обеспечить отказоустойчивость системы, позволяя восстановить её до последнего известного согласованного состояния в случае сбоя.
Объяснение примера согласованных и несогласованных состояний
На изображении рассматривается пример, который помогает лучше понять разницу между согласованными и несогласованными состояниями.
Контекст:
У нас есть три процесса, обозначенные как i, j и k. Между этими процессами передаются два сообщения m₁ и m₂. Также для каждого процесса сохранена одна контрольная точка/снимок (checkpoint), обозначенная как C₁,i, C₁,j и C₁,k, где 1 обозначает номер контрольной точки для процесса, а маленькая буква — сам процесс.
Левый пример — Согласованное состояние:
В левом примере первый снимок в процессах j и i согласован, потому что сообщение m₁ было отправлено и получено после того, как были сделаны контрольные точки. То есть, оба процесса фиксируют одно и то же состояние системы на момент создания контрольной точки. Такое состояние называется согласованным, потому что все процессы имеют одно и то же представление о состоянии системы.
Правый пример — Несогласованное состояние:
В правом примере первый снимок в процессе j не знает о сообщении m₁, в то время как первый снимок в процессе i зафиксировал получение сообщения m₁. Это приводит к несогласованному состоянию, поскольку разные процессы имеют разные представления о состоянии системы.
Дополнительное объяснение:
Левая иллюстрация также представляет собой согласованное состояние, потому что никакой коммуникации между процессами не происходит во время создания контрольных точек. На правой стороне видно, что процессы продолжают обмениваться сообщениями во время создания контрольных точек, что и приводит к несогласованности.
Таким образом, для достижения согласованного состояния все процессы должны либо завершить обмен сообщениями перед созданием контрольных точек, либо контрольные точки должны захватывать полный контекст обмена сообщениями.
Tasks
Cloud-based file store
You are leading a team developing a cloud-based file-sharing platform for a multinational corporation. You’re tasked with ensuring that the platform has the following attributes:
- Depending on the time and need, the platform is able to handle an increasing number of requests arriving from different parts of the world.
- The users of the platform have worldwide 24/7 access to its files.
Keeping these requirements in view, state two of the most important and relevant nonfunctional requirements from the list provided below such that their inclusion in the design will enable us to achieve the scenario mentioned above.
- Maintainability
- Scalability
- Fault tolerance
- Reliability
- Availability
Financial trading platform
Imagine a banking application for financial transactions and buying online products. This platform allows users to obtain their account status, transfer money, pay utility bills, and generate bank statements.
List the following non-functional requirements in the correct order, starting from the most important non-functional requirement to the least important non-functional requirement:
- Low latency
- Consistency
- Security
Spacecraft operations
A space agency relies on critical systems to operate spacecraft, conduct space missions, and gather valuable data for scientific research. Imagine a scenario where a spacecraft is on a mission to explore a distant planet, and it encounters a hardware malfunction or a communication disruption with the control center on Earth.
State one of the most important and relevant non-functional requirements from the list provided below such that its inclusion in the design would enable us to recover from the scenario mentioned above. Please also provide proper reasoning behind your decision:
- Reliability
- Maintainability
- Consistency
- Fault tolerance
- Availability
- Scalability
Note: You must provide reasoning along with the name of the non-functional requirement in your answer.
Twitter
Consider a scenario for Twitter’s recently introduced feature allowing users to stream live video directly within their tweets. As a result, the number of users streaming live video has surged exponentially. Users are consequently experiencing delays, and the system struggles to handle the increased load.
State one of the most important and relevant non-functional requirements from the list provided below such that its inclusion in the design would enable us to handle the scenario mentioned above.
- Reliability
- Maintainability
- Consistency
- Fault tolerance
- Availability
- Scalability