Sequencer - генератор уникальных идентификаторов
Motivation - Мотивация
В крупной распределенной системе может происходить миллионы событий в секунду. Комментирование поста на Facebook, публикация твита и размещение фотографии в Instagram — это лишь несколько примеров таких событий. Нам необходим механизм для различения этих событий друг от друга. Одним из таких механизмов является присвоение каждому из этих событий глобально уникальных идентификаторов (ID).
Назначение первичного ключа записи в базе данных — еще один пример использования уникального идентификатора. Обычно эту задачу выполняет функция автоинкремента в базах данных. Однако эта функция не будет работать в распределенной базе данных, где разные узлы независимо генерируют идентификаторы. Для этого случая нам нужен генератор уникальных идентификаторов, который действует как первичный ключ в распределенной среде — например, в горизонтально шардированной таблице.
Уникальный ID помогает нам отслеживать ход события в журналах и полезен для отладки. Примером использования уникальных идентификаторов в реальном мире является система трассировки и анализа производительности end-to-end, используемая Facebook, под названием Canopy. Canopy использует TraceID для уникальной идентификации события по всему пути выполнения, который может включать выполнение сотен микросервисов для обработки одного запроса пользователя.
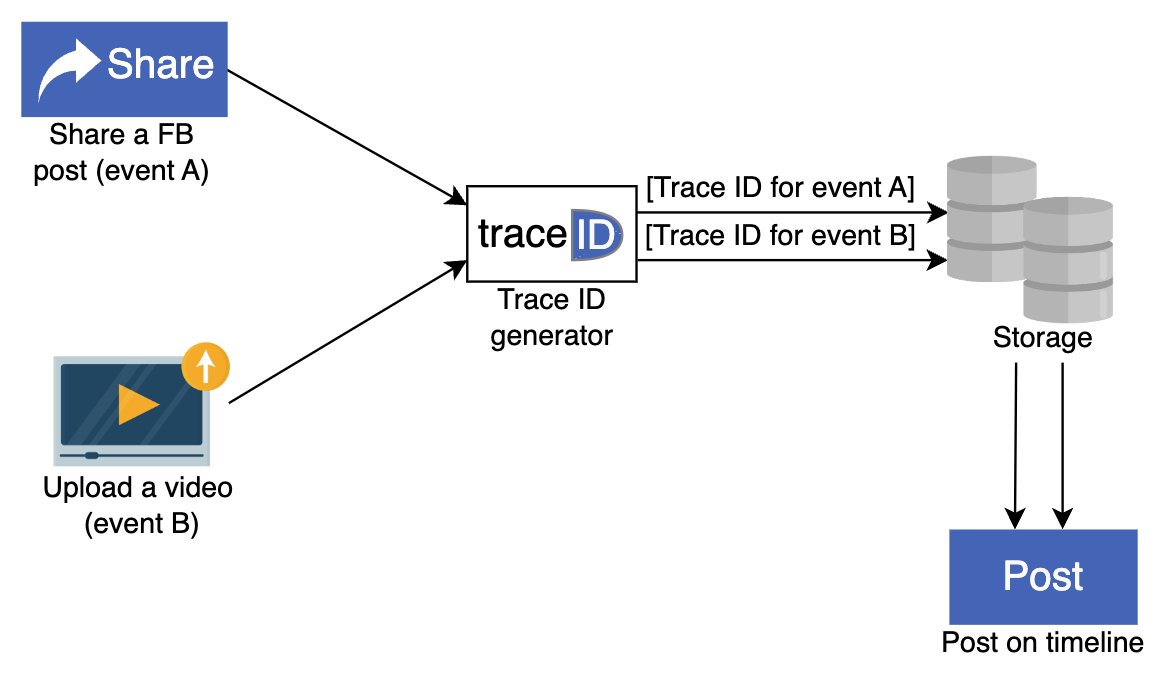
How do we design a sequencer? - Как спроектировать последовательный генератор ID?
Мы разделили подробное проектирование генератора последовательных идентификаторов на два следующих урока:
-
Design of a Unique ID Generator - Проектирование генератора уникальных идентификаторов: После перечисления требований к проектированию мы обсудим три способа генерации уникальных идентификаторов: с использованием UUID, с использованием базы данных и с использованием обработчика диапазонов.
-
Unique IDs with Causality - Уникальные идентификаторы с учетом причинно-следственной связи: В этом уроке мы включаем дополнительный фактор времени в процесс генерации идентификаторов и объясняем процесс с учетом причинно-следственных связей.
Уникальные идентификаторы важны для идентификации событий и объектов в распределенной системе. Однако проектирование генератора уникальных идентификаторов в распределенной системе представляет собой сложную задачу. В следующем уроке мы рассмотрим требования к системе генерации уникальных идентификаторов в распределенной среде.
Design of a Unique ID Generator
Requirements for Unique Identifiers - Требования к уникальным идентификаторам
В предыдущем уроке мы выяснили, что для различных случаев использования, таких как идентификация объектов (например, твитов, загруженных видео и т.д.) и отслеживание потока выполнения в сложной сети сервисов, нам нужны уникальные идентификаторы. Теперь мы формализуем требования к уникальному идентификатору и обсудим три прогрессивно улучшающиеся дизайна для удовлетворения наших требований.
Требования к системе:
-
Уникальность: Необходимо назначать уникальные идентификаторы для различных событий в целях их идентификации.
-
Масштабируемость: Система генерации идентификаторов должна генерировать как минимум миллиард уникальных идентификаторов в день.
-
Доступность: Поскольку несколько событий происходят даже на уровне наносекунд, наша система должна генерировать идентификаторы для всех происходящих событий.
-
64-битный числовой идентификатор: Мы ограничиваем длину до 64 бит, поскольку этого размера достаточно на многие годы вперед. Давайте рассчитаем, через сколько лет диапазон наших идентификаторов завершится.
- Общее количество доступных чисел = 2^64 = 1.8446744 x 10^19
- Оценочное количество событий в день = 1 миллиард = 10^9
- Количество событий в год = 365 миллиардов = 365×10^9
- Количество лет до исчерпания диапазона идентификаторов = 2^64 / (365×10^9) = 50,539,024.8595 лет
64 бита должно быть достаточно для длины уникального идентификатора, учитывая эти расчеты.
Первое решение: UUID
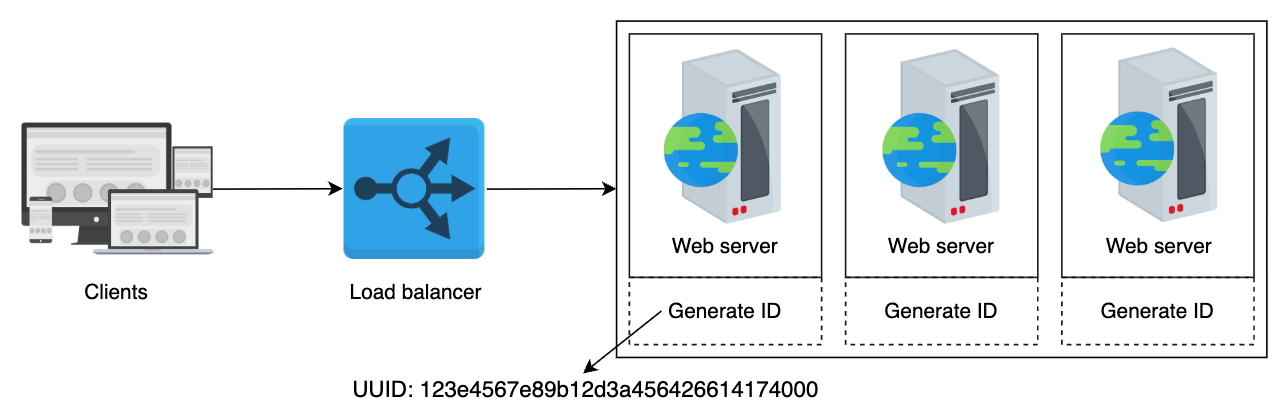
Первым простым решением для нашего дизайна является использование UUID (универсально уникальных идентификаторов). Это 128-битное число, которое выглядит как 123e4567e89b12d3a456426614174000 в шестнадцатеричном формате. Оно предоставляет около 10^38 чисел. UUID имеют разные версии, и мы выбираем версию 4, которая генерирует псевдослучайное число.
Каждый сервер может генерировать свой собственный идентификатор и назначать его соответствующему событию. Координация для UUID не требуется, так как он независим от сервера. Масштабирование вверх и вниз легко осуществимо с UUID, и эта система также обладает высокой доступностью. Кроме того, вероятность коллизий очень мала. Дизайн для этого подхода представлен ниже:
Cons - Недостатки
Использование 128-битных чисел в качестве первичных ключей замедляет индексацию первичных ключей, что приводит к замедлению вставок. Обходным путем может быть интерпретация идентификатора как шестнадцатеричной строки, а не числа. Однако нечисловые идентификаторы могут не подходить для многих случаев использования. Идентификатор не имеет размер 64 бита. Кроме того, существует вероятность дублирования. Хотя эта вероятность минимальна, мы не можем утверждать, что UUID является детерминированно уникальным. Кроме того, UUID, выданные клиентам со временем, могут не быть монотонно возрастающими. В следующей таблице подведены итоги требований, выполненных с использованием UUID:
| Требования | Выполнено с UUID |
|---|---|
| Уникальность | ✖️ |
| Масштабируемость | ✔️ |
| Доступность | ✔️ |
| 64-битный числовой идентификатор | ✖️ |
Second solution: Using a Database - Второе решение: Использование базы данных
Попробуем имитировать функцию автоинкремента базы данных. Рассмотрим центральную базу данных, которая предоставляет текущий идентификатор, а затем увеличивает значение на единицу. Мы можем использовать текущий идентификатор как уникальный идентификатор для наших событий.
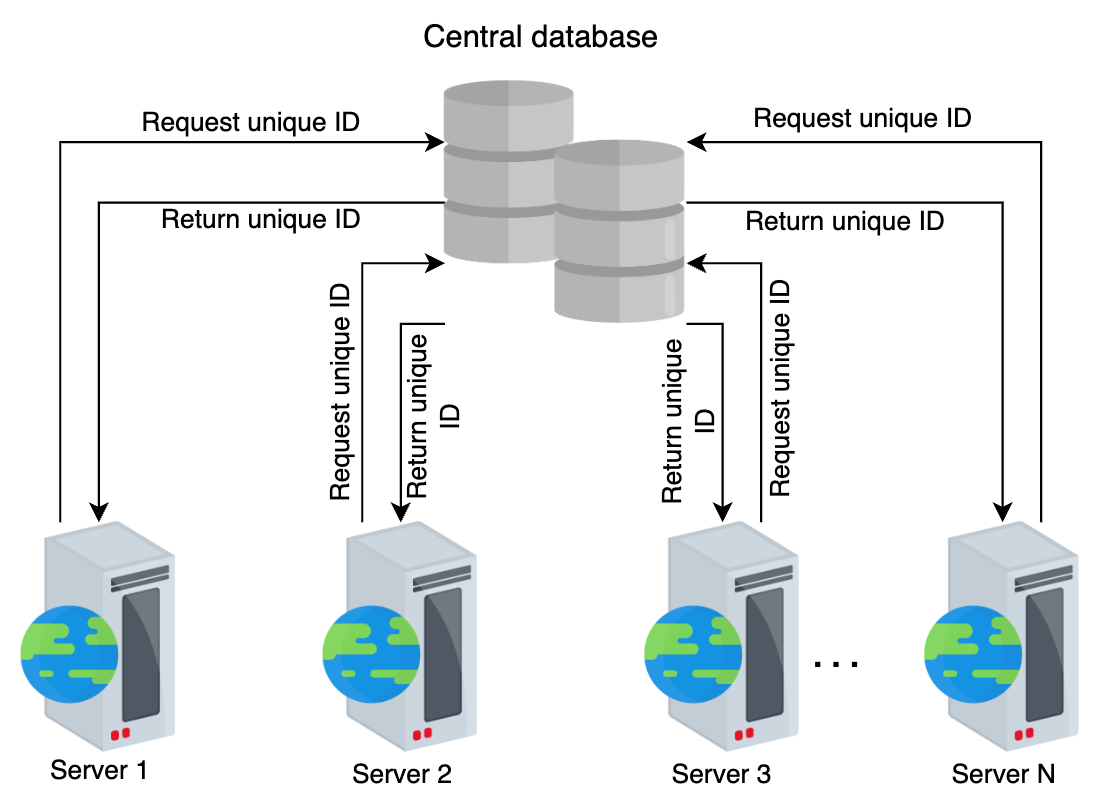
What can be a potential problem of using a central database?
Details
Answer
This design has a considerable problem: a single point of failure. Reliance on one database can severely affect a system. The entire system will stop working if the central database goes down.Improved Database Solution - Улучшенное решение с использованием базы данных
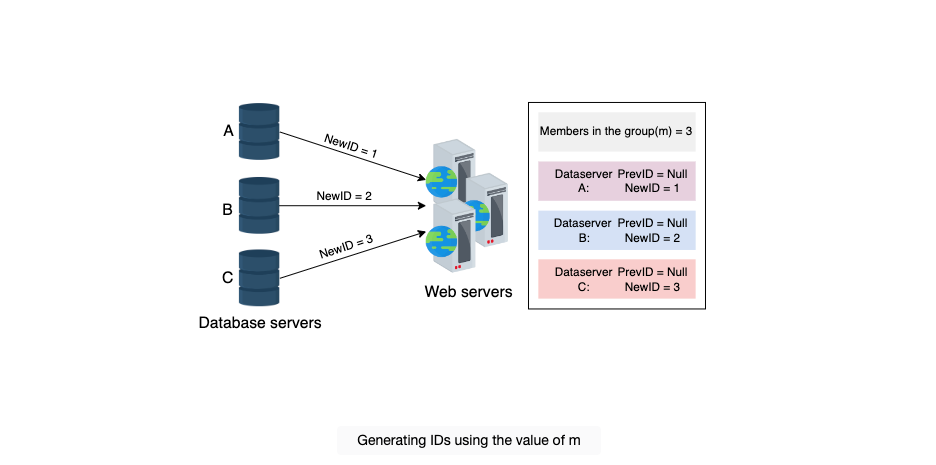
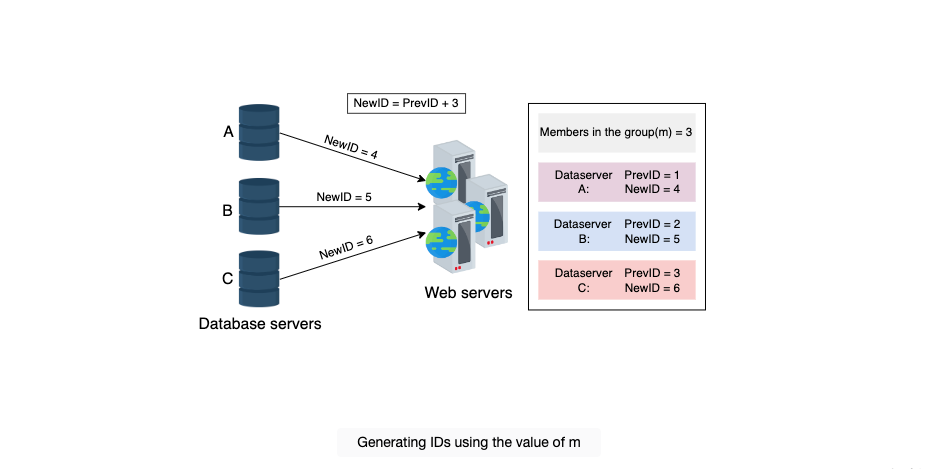
Чтобы устранить проблему единой точки отказа, мы модифицируем традиционную функцию автоинкремента, которая увеличивает значение на единицу. Вместо инкрементации на один, давайте будем использовать значение m, где m равно количеству серверов базы данных, которые у нас есть. Каждый сервер генерирует идентификатор, и следующий идентификатор увеличивает предыдущее значение на m. Этот метод масштабируем и предотвращает дублирование идентификаторов.
Пример генерации уникального идентификатора с использованием базы данных:
- Предположим, что у нас есть три сервера (m=3).
- Сервер 1 генерирует идентификатор 1.
- Сервер 2 генерирует идентификатор 2.
- Сервер 3 генерирует идентификатор 3.
- Следующий идентификатор на сервере 1 будет 4 (1 + m).
- Следующий идентификатор на сервере 2 будет 5 (2 + m).
- Следующий идентификатор на сервере 3 будет 6 (3 + m).
Этот подход решает проблемы масштабируемости и дублирования идентификаторов, обеспечивая равномерное распределение генерации ID между серверами, что минимизирует риск единой точки отказа.
Пример визуализации:
- Сервер 1: 1, 4, 7, 10...
- Сервер 2: 2, 5, 8, 11...
- Сервер 3: 3, 6, 9, 12...
Таким образом, каждый сервер в кластере генерирует уникальные идентификаторы без пересечений с другими серверами.
Pros - Преимущества
- Масштабируемость: Этот подход масштабируем. Мы можем добавлять больше серверов, и значение
mбудет обновлено соответствующим образом.
Cons - Недостатки
- Трудности масштабирования для нескольких дата-центров: Хотя этот метод является масштабируемым, масштабирование для нескольких дата-центров может быть сложным. Добавление и удаление сервера может привести к дублированию идентификаторов. Например, если
m=3, и сервер A генерирует уникальные идентификаторы 1, 4, и 7, сервер B генерирует идентификаторы 2, 5, и 8, а сервер C генерирует идентификаторы 3, 6, и 9. Если сервер B выходит из строя, значениеmобновляется до 2. Сервер A генерирует 9 в качестве следующего уникального идентификатора, но этот идентификатор уже был сгенерирован сервером C. Таким образом, идентификаторы больше не уникальны.
Таблица ограничений решений
| Требования | Использование UUID | Использование серверов базы данных |
|---|---|---|
| Уникальность | ✖️ | ✖️ |
| Масштабируемость | ✔️ | ✔️ |
| Доступность | ✔️ | ✔️ |
| 64-битный числовой ID | ✖️ | ✔️ |
Third Solution: Using a Range Handler - Третье решение: Использование обработчика диапазонов
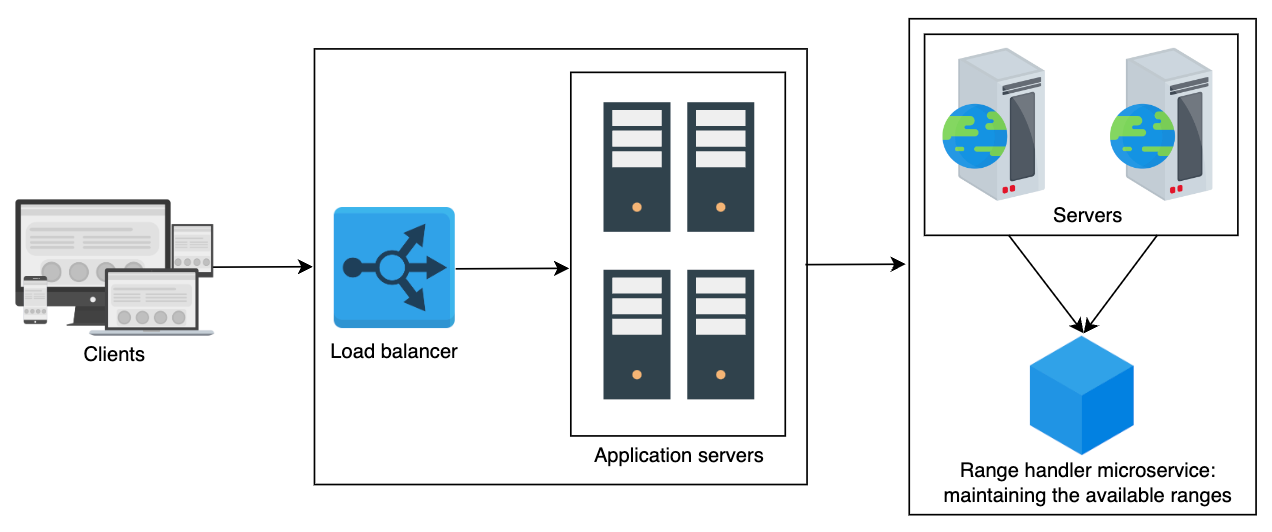
Попробуем преодолеть проблемы, выявленные в предыдущих методах. Мы можем использовать диапазоны на центральном сервере. Предположим, у нас есть несколько диапазонов от одного до двух миллиардов, например, от 1 до 1,000,000; от 1,000,001 до 2,000,000 и так далее. В таком случае центральный микросервис может предоставить серверу диапазон по запросу.
Любой сервер может запросить диапазон, когда ему нужно сгенерировать идентификатор впервые или если у него заканчивается диапазон. Предположим, сервер получил диапазон и сохраняет начало диапазона в локальной переменной. Всякий раз, когда поступает запрос на идентификатор, сервер предоставляет значение локальной переменной запрашивающему и увеличивает это значение на единицу.
Например, сервер 1 запрашивает диапазон чисел от 300,001 до 400,000. После запроса диапазона, идентификатор пользователя 300,001 присваивается первому запросу. Затем сервер возвращает 300,002 следующему пользователю, увеличивая свое текущее положение в пределах диапазона. Это продолжается до тех пор, пока сервер не достигнет идентификатора 400,000. После этого приложение сервер запрашивает центральный сервер о следующем доступном диапазоне и повторяет этот процесс.
Этот метод решает проблему дублирования идентификаторов. Каждый сервер приложения может одновременно отвечать на запросы. Мы можем добавить балансировщик нагрузки поверх набора серверов, чтобы распределить нагрузку запросов.
Мы используем микросервис, называемый обработчиком диапазонов, который ведет учет всех занятых и доступных диапазонов. Статус каждого диапазона может определить, доступен ли он или нет. Состояние, то есть какой сервер имеет какой диапазон, может быть сохранено в реплицированном хранилище.
Этот микросервис может стать единой точкой отказа, но резервный сервер действует как спаситель в этом случае. Резервный сервер выдает диапазоны, когда основной сервер не работает. Мы можем восстановить состояние доступных и недоступных диапазонов из последней контрольной точки реплицированного хранилища.
Imagine a scenario where you’re planning to bring a new data center online to accommodate increasing user requests. How would you modify your range allocation strategy to accommodate this change?
Details
Answer
To accommodate the new data center and manage the increasing user requests efficiently, you would modify your range allocation strategy by implementing Geographic Sharding. This approach involves allocating ranges based on the data center location, ensuring that servers within the same geographic location access the same range handler. This method helps in optimizing the system’s performance and scalability by minimizing latency and balancing the load effectively across different data centers.Pros - Преимущества
Эта система масштабируема, доступна и обеспечивает уникальные идентификаторы пользователей без дублирования. Более того, мы можем поддерживать этот диапазон в 64 битах, что является числовым значением.
Cons - Недостатки
Мы теряем значительный диапазон идентификаторов, когда сервер выходит из строя, и можем выделить новый диапазон только после восстановления сервера. Мы можем преодолеть этот недостаток, выделяя серверам более короткие диапазоны, хотя диапазоны должны быть достаточно большими, чтобы обеспечить идентификаторы на некоторое время.
Таблица выполнения требований
| Требования | Использование UUID | Использование серверов базы данных | Использование обработчика диапазонов |
|---|---|---|---|
| Уникальность | ✖️ | ✖️ | ✔️ |
| Масштабируемость | ✔️ | ✖️ | ✔️ |
| Доступность | ✔️ | ✔️ | ✔️ |
| 64-битный числовой ID | ✖️ | ✔️ | ✔️ |
Мы разработали решение, которое обеспечивает уникальный идентификатор, который можно назначить различным событиям и использовать в качестве первичного ключа. Но что, если мы добавим требование, чтобы идентификатор также сортировался по времени?
Unique IDs with Causality
Causality - Причинно-следственная связь
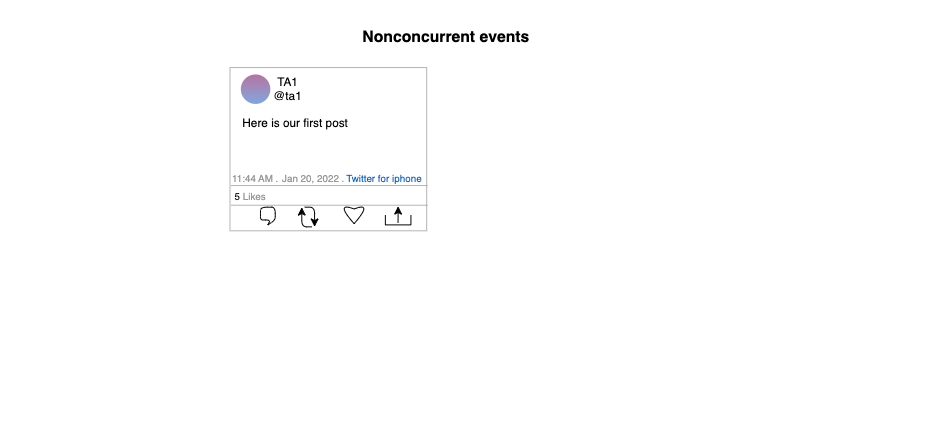
В предыдущем уроке мы генерировали уникальные идентификаторы для различения различных событий. Помимо наличия уникальных идентификаторов для событий, нас также интересует нахождение последовательности этих событий. Рассмотрим пример, в котором Питер и Джон — два пользователя Twitter. Джон оставляет комментарий (событие A), и Питер отвечает на комментарий Джона (событие B). Событие B зависит от события A и не может произойти раньше него. Здесь события не являются параллельными.
Также возможны параллельные события — то есть два события, которые происходят независимо друг от друга. Например, если Питер и Джон комментируют два разных твита, между ними нет отношения «произошло раньше» или причинно-следственной связи. Важно выявить зависимость одного события от другого, но не в случае параллельных событий.
Примечание:
Описанный выше сценарий также можно обработать путем назначения уникального идентификатора и кодирования зависимости событий с использованием социальной графической структуры. Мы также можем использовать отдельную структуру данных времени и простой уникальный идентификатор. Однако мы хотим, чтобы уникальный идентификатор выполнял двойную функцию — обеспечивал уникальную идентификацию и помогал с причинно-следственной связью событий.
Следующие слайды предоставляют визуализацию параллельных и непараллельных событий.
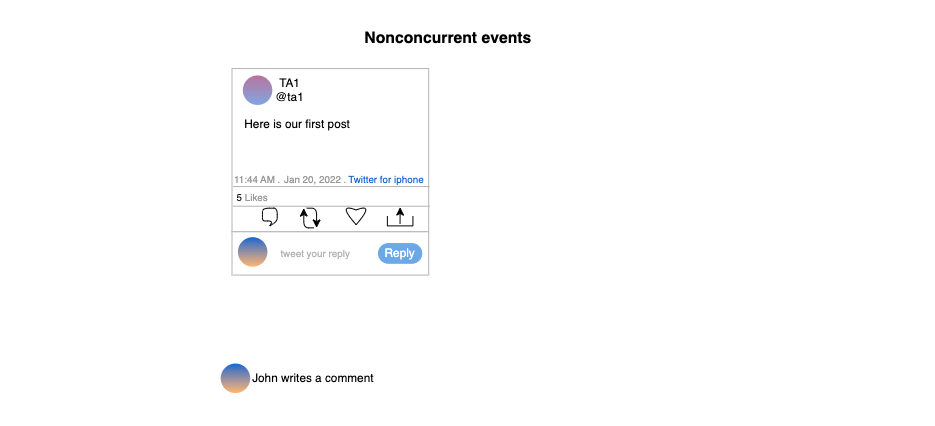
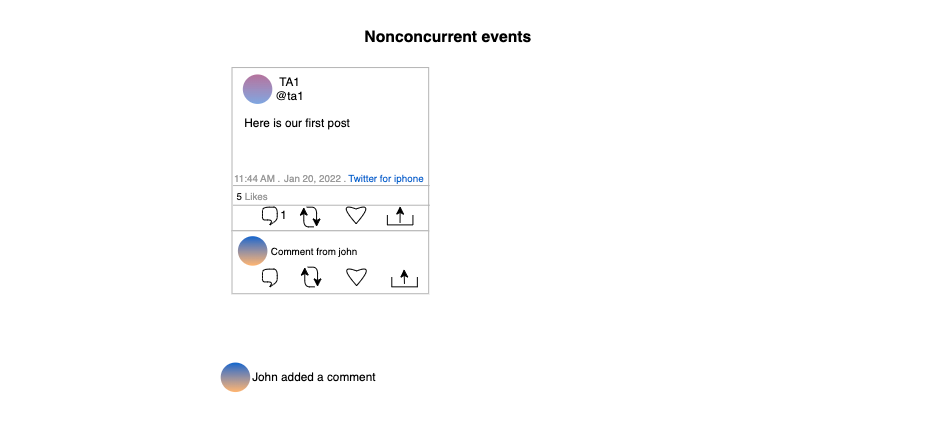
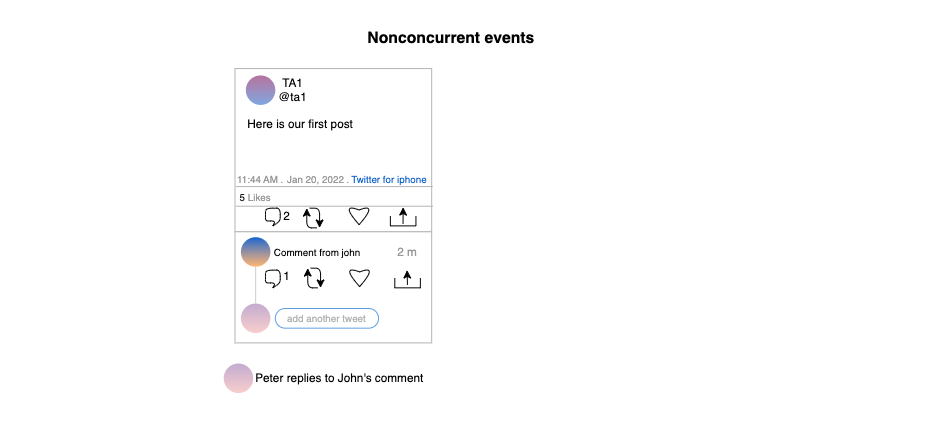
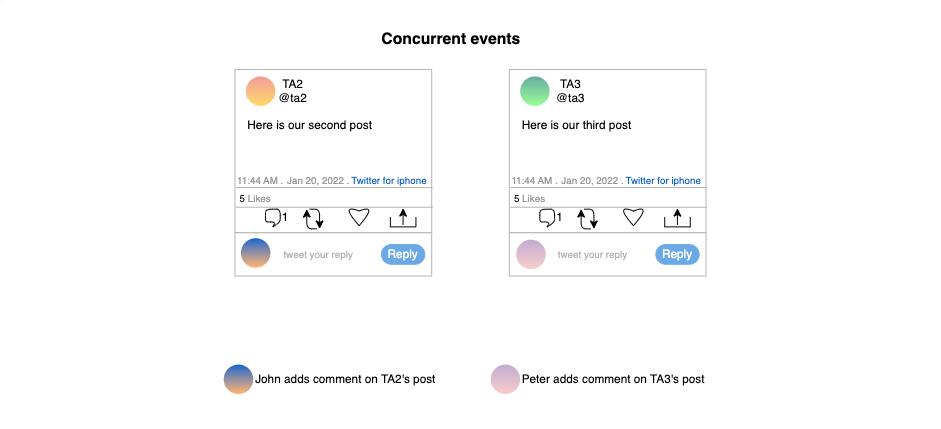
Causality and Time Stamps - Причинно-следственная связь и временные метки
Некоторым приложениям требуется, чтобы события имели уникальные идентификаторы и содержали любую соответствующую информацию о причинно-следственной связи. Примером может служить присвоение идентификатора параллельным записям ключа в key-value хранилище для реализации стратегии «последняя запись побеждает» (last-write-wins).
Мы можем использовать логические или физические часы для вывода причинно-следственной связи. В некоторых системах есть дополнительные требования, когда мы хотим, чтобы причинно-следственная связь идентификаторов событий отображала время на настенных часах. Примером может служить финансовое приложение, соответствующее европейским нормам MiFID. MiFID требует, чтобы часы были синхронизированы в пределах 100 микросекунд с UTC для обнаружения аномалий во время высокоскоростных и высокообъемных торгов на рынке.
Примечание:
Существует множество нюансов, связанных с логическими или физическими часами. Мы можем обратиться к тексту ниже, озаглавленному «Время в распределенной системе», чтобы освежить наши концепции времени.
Мы используем время для определения последовательности событий в нашей жизни. Например, если Сэм принял ванну в 6 утра, а позавтракал в 7 утра, мы можем определить, что Сэм принял ванну до завтрака, по временным меткам каждого события. Временные метки, таким образом, могут использоваться для поддержания причинно-следственной связи.
Physical Clocks - Физические часы
В компьютере часто доступны два типа физических часов: часы реального времени и монотонные счетчики.
Часы реального времени
- Обычно имеют более низкое разрешение по сравнению с монотонными счетчиками.
- Network Time Protocol (NTP) может сдвигать часы вперед или назад, поэтому они не всегда монотонны.
- Могут или не могут учитывать добавочные секунды (leap seconds).
Монотонные счетчики
- Обычно имеют более высокое разрешение, чем часы реального времени.
- Должны использоваться для измерения продолжительности между двумя событиями, а не для указания времени.
- Не имеют смысла между разными узлами. Например, даже на одном сервере с несколькими процессорами может быть разный счетчик на каждом процессоре. Приложение должно быть осторожным при использовании счетчиков с разных процессоров.
- NTP может корректировать их, не нарушая монотонности.
- NTP может ускорить или замедлить скорость изменения счетчика до 0,05%.
Причины дрейфа часов
Физические часы со временем смещаются из-за различных причин:
- Различия в температуре
- Возраст оборудования
- Производственные дефекты
- Виртуализированные часы
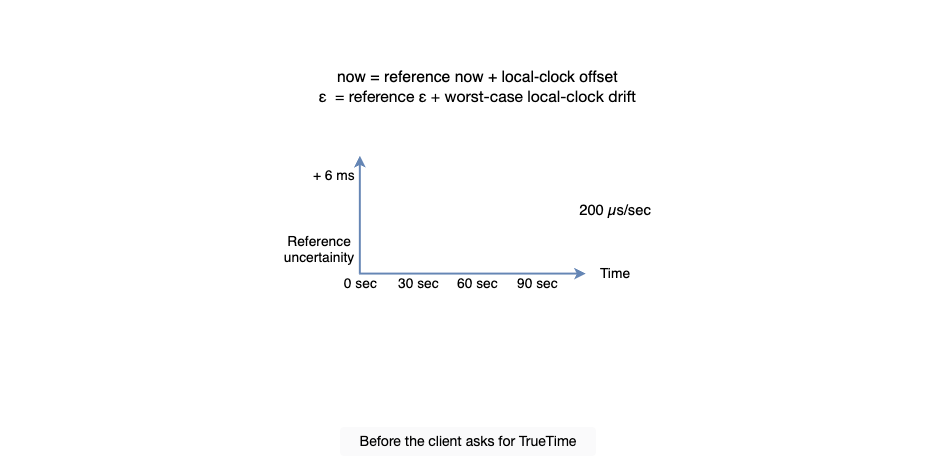
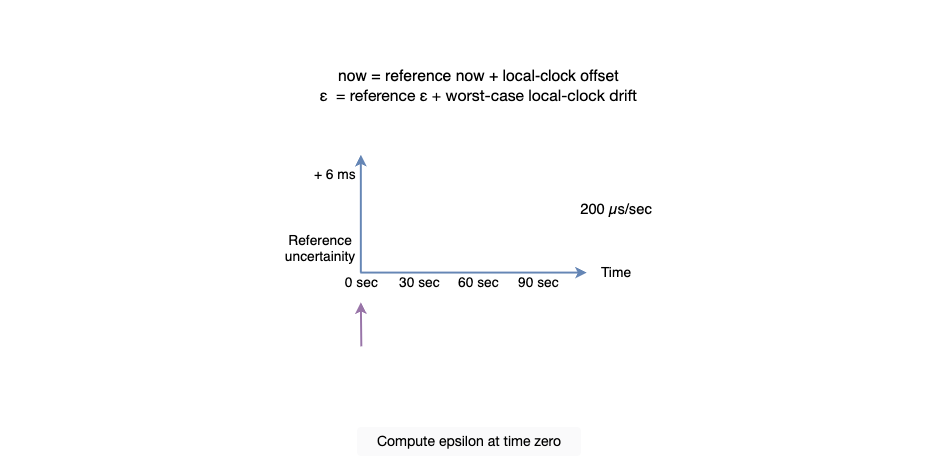
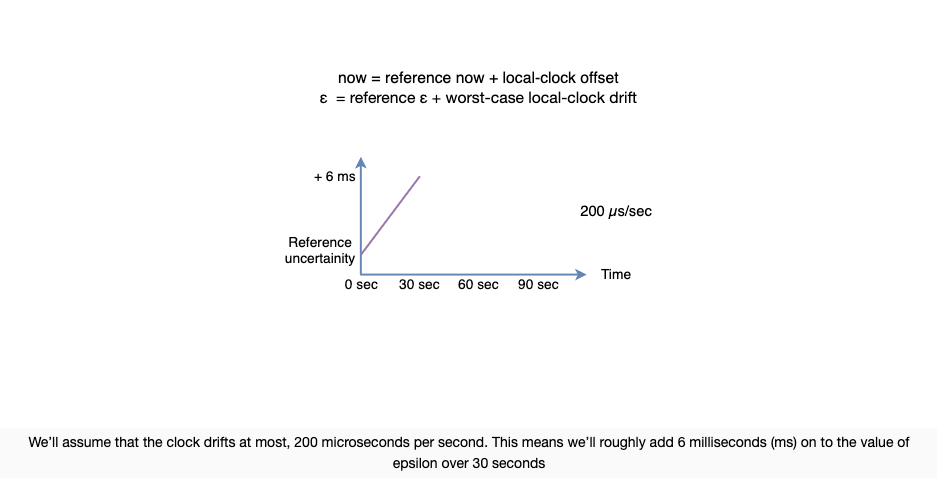
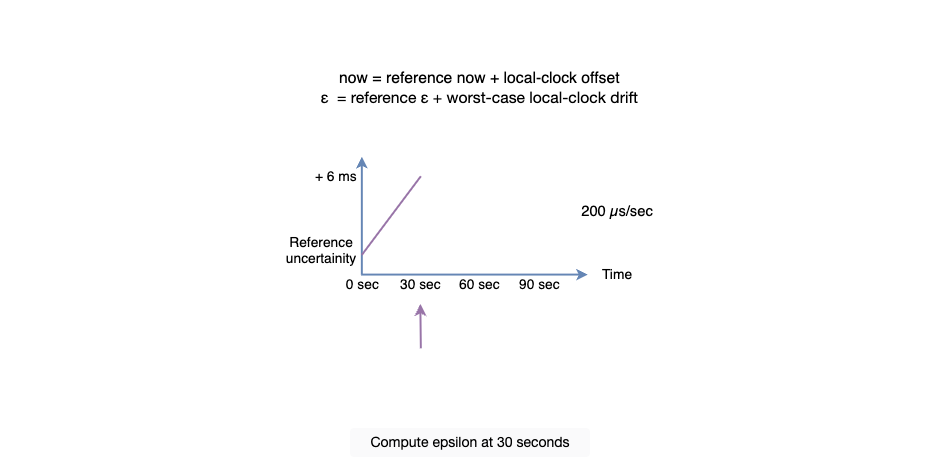
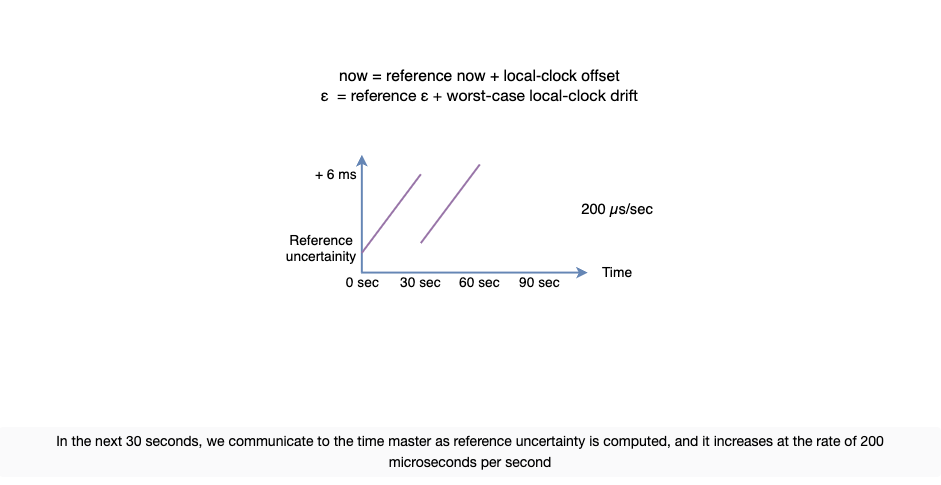
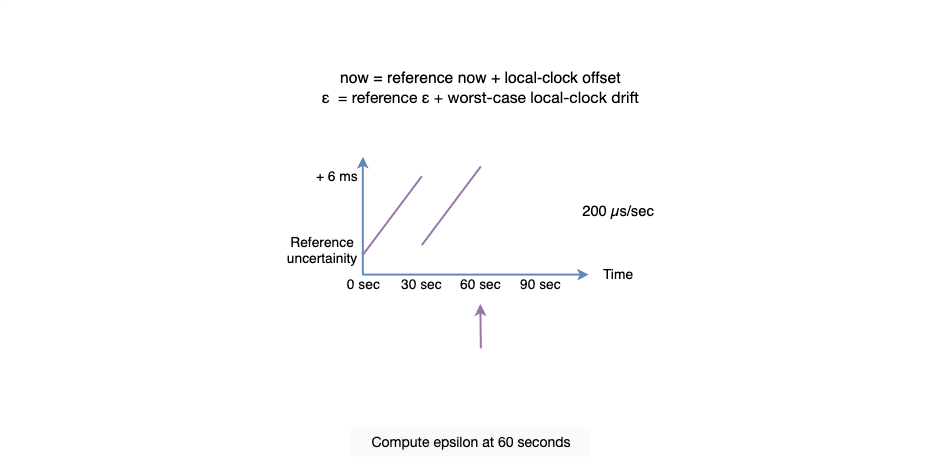
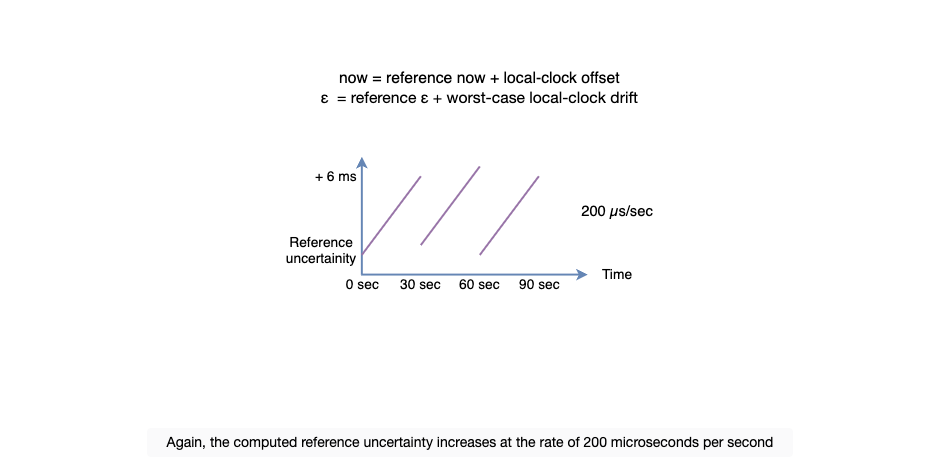
Например, сервер с дрейфом часов 200 частей на миллион означает дрейф в 6 миллисекунд при синхронизации каждые 30 секунд или дрейф в 17 секунд при повторной синхронизации каждые 24 часа.
Исследование показало, что на публичном Интернете NTP не может достичь точности часов лучше 35 мс, и она может достигать одной секунды, когда на сети возникают перегрузки. В противном случае, NTP использует несколько серверов времени и отбрасывает выбросы.
Компромисс: сложность и стоимость против точности часов
Можно поддерживать дрейф часов на минимальном уровне с использованием GPS и атомных часов, аккуратного развертывания и мониторинга. Однако такая система влечет за собой дополнительные денежные затраты, а также увеличивает сложность системы.
Logical Clocks - Логические часы
Lamport Clocks - Часы Лампорта
- Часы Лампорта предоставляют нам отношения «произошло раньше». Если событие A происходит перед событием B, то значение часов A будет меньше, чем значение часов B.
- Важный момент: сравнивая значения часов двух событий с разных серверов, нельзя определить отношение «произошло раньше», так как эти события могут быть параллельными (не иметь причинно-следственной связи).
Vector Clocks - Векторные часы
- Мы можем использовать векторные часы, чтобы выводить отношения «произошло раньше» на основе значений часов. Для этого нам понадобится счетчик для каждого участвующего объекта в векторе.
- Следует отметить, что «произошло раньше» не обязательно означает, что два события связаны причинно-следственно. Может оказаться, что одно событие просто произошло раньше другого. Обычно для определения реальной причинно-следственной связи требуется контекст уровня приложения поверх механизма «произошло раньше».
Использование UNIX временных меток - Use UNIX Time Stamps
UNIX временные метки имеют точность до миллисекунды и могут использоваться для различения различных событий. У нас есть сервер, генерирующий уникальные идентификаторы, который может генерировать один идентификатор за одну миллисекунду. Любой запрос на создание уникального идентификатора направляется на этот сервер, который возвращает временную метку, а затем уникальный идентификатор. Способность генерировать идентификатор за миллисекунду позволяет нам создавать тысячу идентификаторов в секунду. Это означает, что мы можем получить:
24 (часа) ∗ 60 (мин/час) ∗ 60 (сек/мин) ∗ 1000 (ID/сек) = 86400000 ID в день.
Это меньше миллиарда в день.
Примечание:
Подключитесь к следующему терминалу, чтобы увидеть временную метку UNIX в миллисекундах.
Решение проблемы с единичной точкой отказа (SPOF) - Handling Single Point of Failure (SPOF)
Наша система хорошо справляется с генерацией идентификаторов, но она представляет собой критическую проблему — сервер генерации идентификаторов является единственной точкой отказа (SPOF). Нам нужно решить эту проблему. Чтобы справиться с единичной точкой отказа, мы можем добавить больше серверов. Каждый сервер генерирует уникальный идентификатор для каждой миллисекунды. Чтобы сделать общий идентификатор уникальным по всей системе, мы прикрепляем ID сервера к временной метке UNIX. Затем мы добавляем балансировщик нагрузки для более эффективного распределения трафика.
Дизайн генератора уникальных идентификаторов с использованием временных меток UNIX выглядит следующим образом:
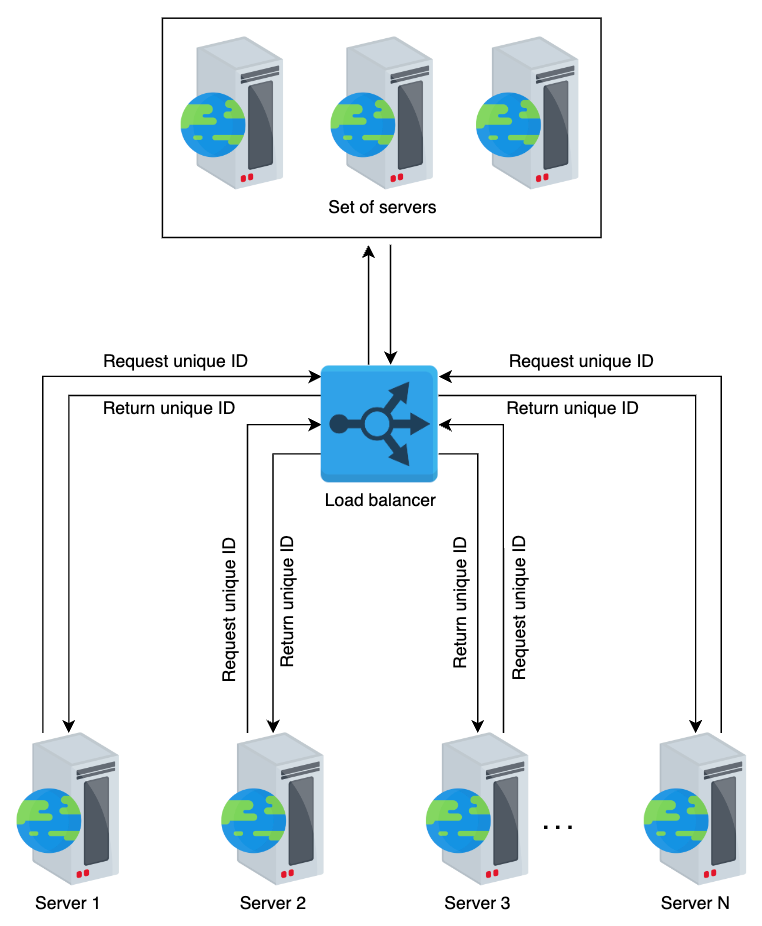
- Добавление дополнительных серверов: Для устранения SPOF добавляются дополнительные сервера, каждый из которых генерирует уникальные идентификаторы независимо.
- Прикрепление ID сервера: К каждому сгенерированному идентификатору добавляется уникальный ID сервера, что обеспечивает уникальность идентификаторов в масштабах всей системы.
- Использование балансировщика нагрузки: Балансировщик нагрузки распределяет входящие запросы между доступными серверами, что помогает избежать перегрузки и обеспечивает высокую доступность системы.
Преимущества и недостатки подхода с временными метками UNIX - Pros and Cons of Using UNIX Time Stamps
Преимущества
- Этот подход прост, масштабируем и легко реализуем.
- Он позволяет нескольким серверам обрабатывать параллельные запросы.
Недостатки
- Для двух параллельных событий возвращается одинаковая временная метка, и им может быть присвоен одинаковый идентификатор. В результате идентификаторы больше не являются уникальными.
Удовлетворение требований различными подходами
| Подход | Уникальность | Масштабируемость | Доступность | 64-битный числовой ID | Сохранение причинности |
|---|---|---|---|---|---|
| Использование UUID | ✖️ | ✔️ | ✔️ | ✖️ | ✖️ |
| Использование базы данных | ✖️ | ✖️ | ✔️ | ✔️ | ✖️ |
| Использование range handler | ✔️ | ✔️ | ✔️ | ✔️ | ✖️ |
| Использование временных меток UNIX | ✖️ | слабо | ✔️ | ✔️ | слабо |
Twitter Snowflake
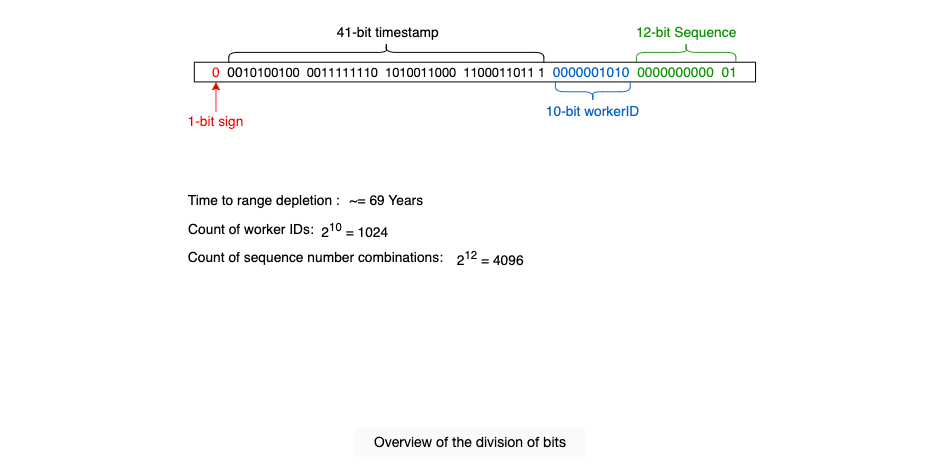
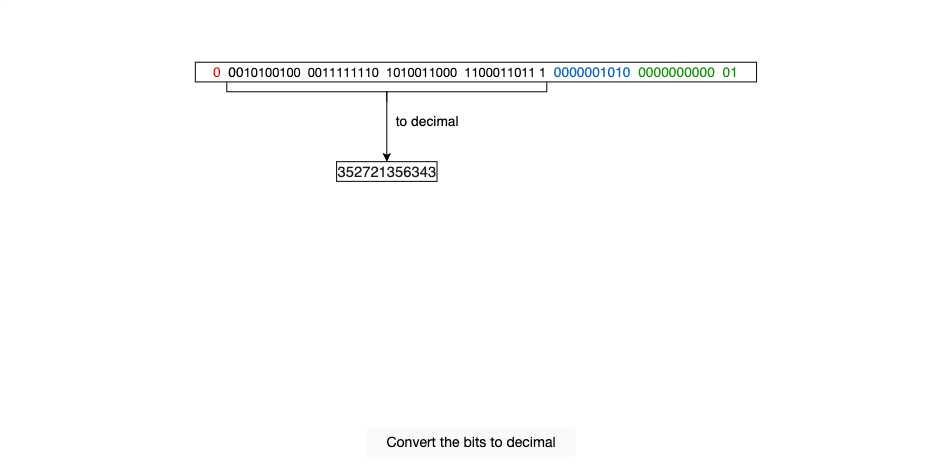
Попробуем более эффективно использовать время. Мы можем использовать часть битов из наших целевых 64 бит для хранения времени, а оставшиеся — для другой информации. Обзор разделения битов приведен ниже:
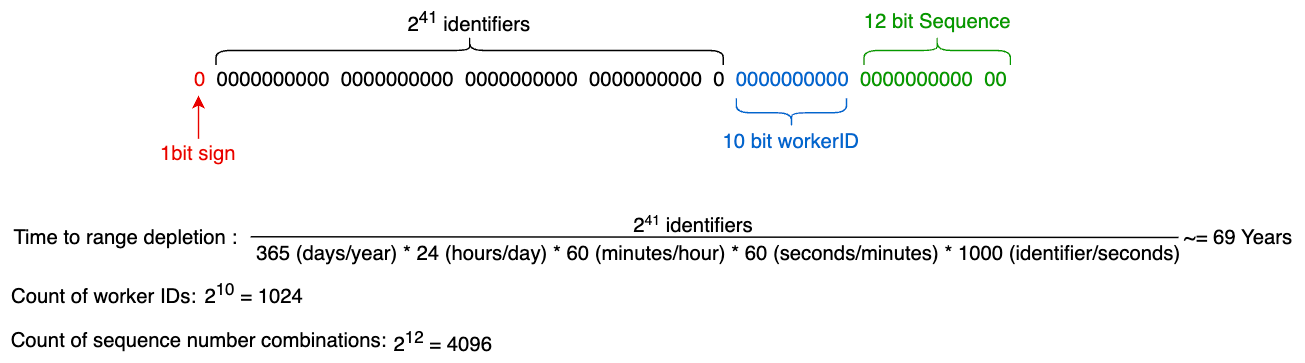
Разделение битов в схеме Twitter Snowflake
1. Бит знака (Sign bit):
- Один бит используется как бит знака, его значение всегда будет равно нулю. Это делает общее число положительным, что гарантирует, что любые программные среды, использующие эти идентификаторы, интерпретируют их как положительные целые числа.
2. Временная метка (Time stamp):
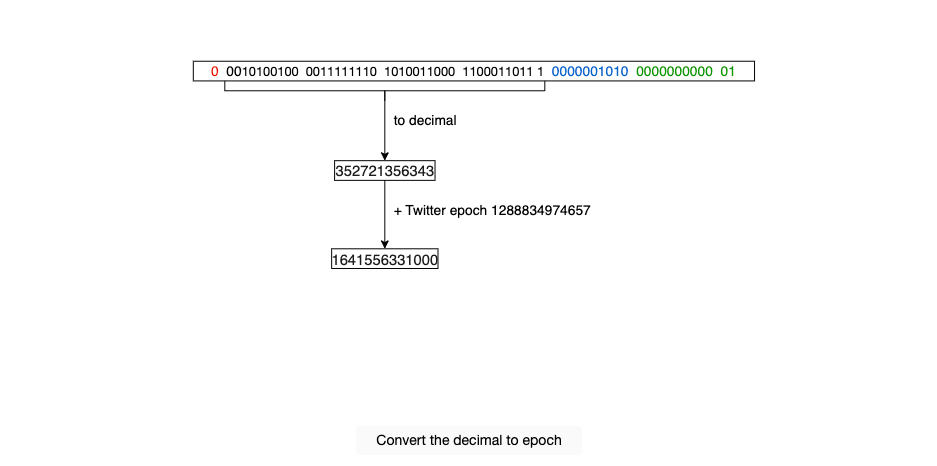
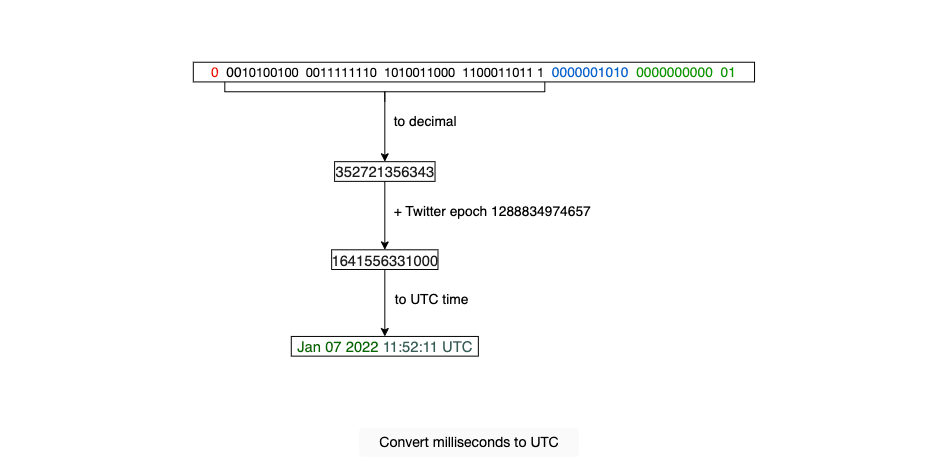
- 41 бит отведен для хранения времени в миллисекундах. Используется стандартная эпоха Twitter Snowflake, значение которой равно
1288834974657, что эквивалентно 4 ноября 2010 года, 01:42:54 UTC. Мы можем установить собственную эпоху, например, начать с 1 января 2022 года в полночь. Максимальное время до истощения этого диапазона составляет около 69 лет:
Время до истощения диапазона = 2^41 идентификаторов / (365 дней/год _ 24 часов/день _ 60 минут/час _ 60 секунд/минуту _ 1000 идентификаторов/секунду) ≈ 69 лет
- Эти расчеты показывают, что у нас есть 69 лет до необходимости использования нового алгоритма для генерации идентификаторов.
3. Номер рабочей машины (Worker number):
- 10 битов отведены под номер рабочей машины, что дает нам 1,024 уникальных ID рабочих машин. Сервер, создающий уникальный ID для своих событий, будет прикреплять свой ID.
4. Порядковый номер (Sequence number):
- 12 битов отведены под порядковый номер. Каждый раз при генерации ID на сервере, порядковый номер увеличивается на один. Это дает 4,096 уникальных порядковых номеров. Когда он достигнет 4,096, он будет сброшен на ноль. Это добавляет еще один уровень защиты от дублирования.
Примечание:
Эта структура позволяет эффективно использовать время и распределять уникальные идентификаторы среди множества серверов, что делает схему Twitter Snowflake мощным и масштабируемым решением для генерации уникальных идентификаторов.

Преимущества и недостатки схемы Twitter Snowflake
Преимущества
- Схема Twitter Snowflake использует временную метку в качестве первого компонента. Это означает, что идентификаторы можно сортировать по времени.
- Генератор ID обладает высокой доступностью, что позволяет справляться с большим количеством запросов.
Недостатки
- Проблемой могут стать идентификаторы, созданные в так называемый "мертвый период" — время, когда на сервер не поступает запросов на генерацию ID. Эти идентификаторы будут потеряны, так как занимают пространство в диапазоне возможных идентификаторов.
- В итоге, возможный уникальный диапазон исчерпывается быстрее, чем ожидалось, и в нашем глобальном наборе идентификаторов пользователей образуются разрывы.
Can you find another shortcoming in the design shown above?
Details
Answer
The physical clocks are unreliable. For such clocks, the error can be 17 seconds per day. If we measure time using these on a server, the time drifts away.Considering a single server, we won’t be affected by the drifting away of time since all transactions land on a single server. But in a distributed environment, the clocks won’t remain synced.
Due to the unreliability of measuring accurate time, no matter how often we synchronize these clocks with each other or other clocks with accurate measurement methods, there will always be skew between the various clocks involved in a distributed system.
Еще один недостаток этой системы — зависимость от времени.
Использование NTP может повлиять на работу этой системы. Например, если на одном из серверов часы отстанут на две секунды вперед, другие серверы будут отставать на эти две секунды. NTP синхронизирует время на всех серверах. Однако в процессе сдвига времени могут быть сгенерированы идентификаторы для времени, которое еще не наступило, что приведет к появлению пар неконкурирующих событий с одинаковой временной меткой. В результате причинно-следственная связь наших событий может быть нарушена.
Заметка: Network Time Protocol (NTP) — это сетевой протокол для синхронизации времени на компьютерных системах через сети с пакетной коммутацией и переменной задержкой. NTP предназначен для синхронизации всех участвующих компьютеров в пределах нескольких миллисекунд от всемирного координированного времени (UTC). Протокол NTP минимизирует влияние переменной задержки сети.
Проблема с точностью времени остается. Даже при использовании точного измерения времени с микросекундной или даже наносекундной точностью риски, связанные с NTP, сохраняются. Поскольку на физические часы нельзя полагаться полностью, давайте рассмотрим возможность использования логических часов.
В следующей таблице приведен обзор требований, которые были выполнены с использованием различных подходов к дизайну:
| Требование | Уникальный ID | Масштабируемость | Доступность | 64-битный числовой ID | Сохранение причинности |
|---|---|---|---|---|---|
| Использование UUID | ✖️ | ✔️ | ✔️ | ✖️ | ✖️ |
| Использование базы данных | ✖️ | ✖️ | ✔️ | ✔️ | ✖️ |
| Использование range handler | ✔️ | ✔️ | ✔️ | ✔️ | ✖️ |
| Использование временных меток UNIX | ✖️ | слабая | ✔️ | ✔️ | слабая |
| Использование схемы Twitter Snowflake | ✔️ | ✔️ | ✔️ | ✔️ | слабая |
Использование логических часов
Мы можем использовать логические часы (Lamport и векторные часы), которые требуют монотонно возрастающих идентификаторов для событий.
Часы Лампорта
-
В часах Лампорта каждый узел имеет свой счетчик. Все узлы системы оснащены числовым счетчиком, который начинается с нуля при первом запуске. Перед выполнением события числовой счетчик увеличивается на единицу. Сообщение, отправляемое от этого события другому узлу, содержит значение счетчика. Когда другой узел получает сообщение, он сначала обновляет свои логические часы, принимая максимальное из своего значения часов и значения, отправленного в сообщении, а затем выполняет сообщение.
-
Часы Лампорта обеспечивают уникальный частичный порядок событий, используя отношение "случилось до". Мы также можем получить полный порядок событий, добавив уникальные идентификаторы узлов/процессов, хотя такой порядок не будет уникальным и изменится при другом назначении идентификаторов узлов. Однако важно отметить, что часы Лампорта не позволяют сделать вывод о причинности на глобальном уровне. Это означает, что мы не можем просто сравнить два значения часов на любом сервере, чтобы сделать вывод о том, какое событие произошло раньше.
Векторные часы
-
Векторные часы сохраняют причинно-следственную историю — то есть всю информацию о "случилось до" отношениях между событиями. Следовательно, необходимо выбрать эффективную структуру данных для хранения причинной истории каждого события.
-
Рассмотрим следующий дизайн. Мы будем генерировать наш идентификатор, объединяя соответствующую информацию, как в схеме Twitter Snowflake, со следующей разбивкой:
Разделение битов:
- Знаковый бит: Один бит назначается как знаковый бит, его значение всегда будет равно нулю.
- Векторные часы: 53 бита отведены под счетчики каждого узла.
- Идентификатор работника: 10 бит, что дает нам 2^10 = 1024 идентификатора работников.
The following slides explain the unique ID generation using vector clocks, where the nodes A, B, and C reside in a data center.
Note: In the following slides, we haven’t converted the data to bits for the sake of understanding. The pattern we’ll use for the unique ID is the following:
[vector-clock][worker-id]
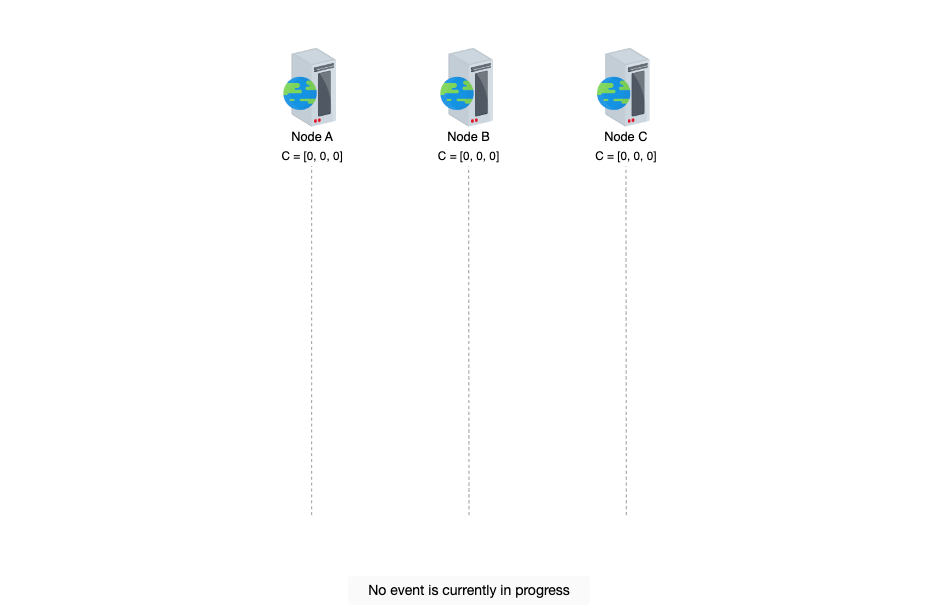
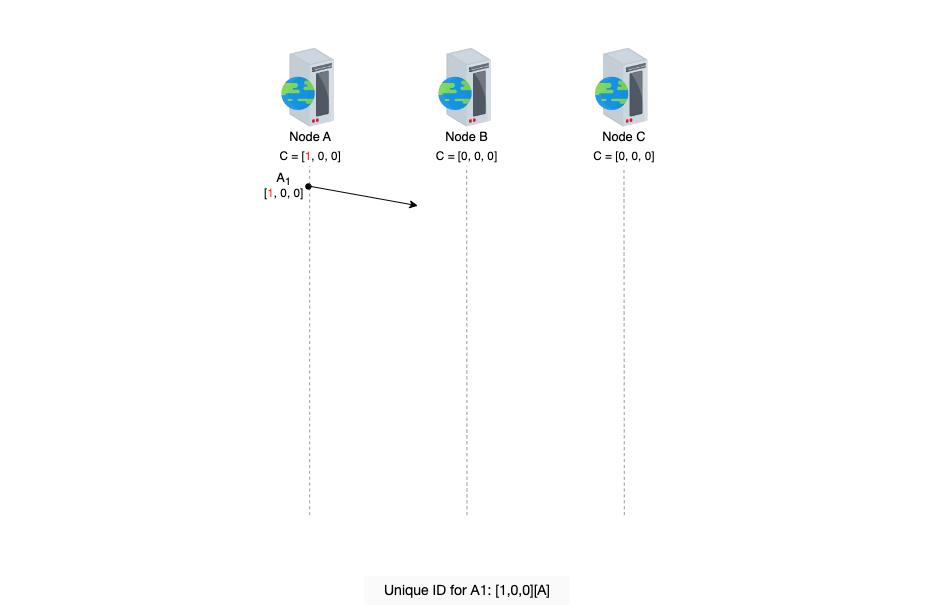
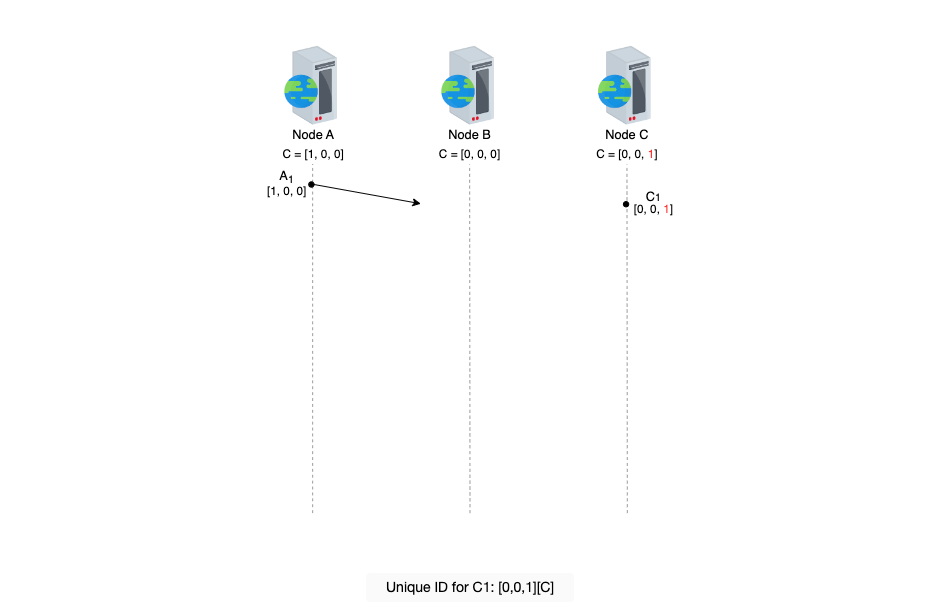
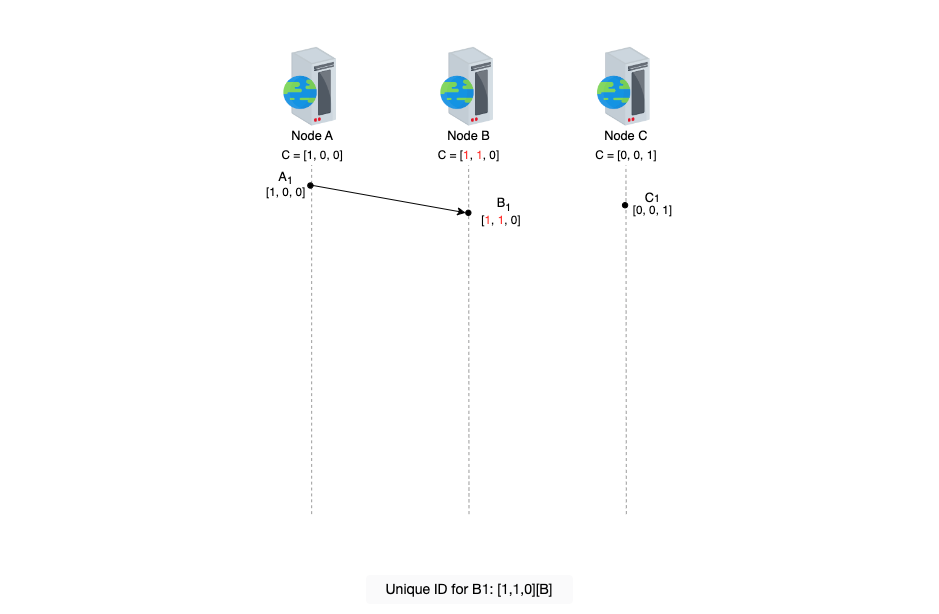
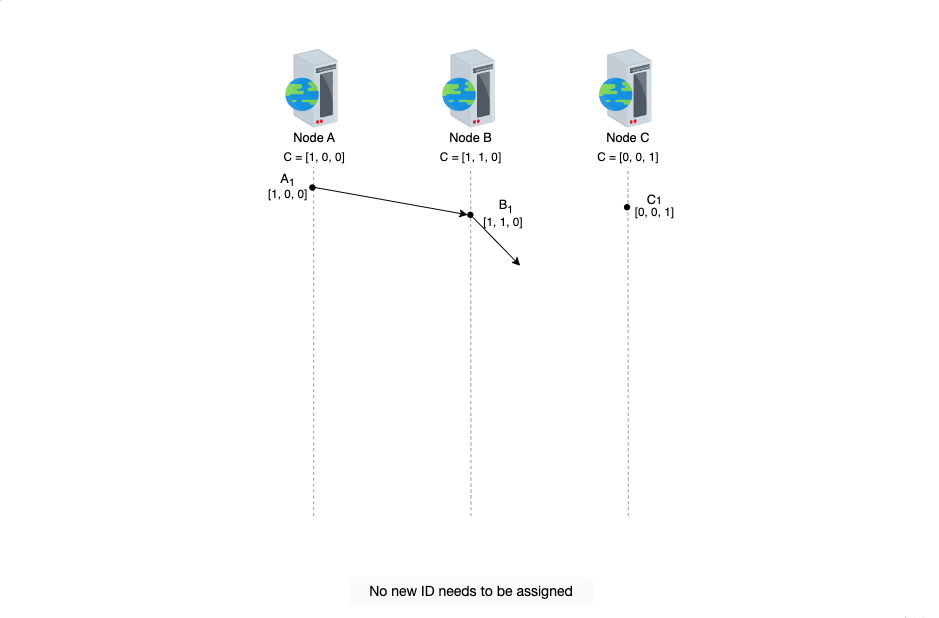
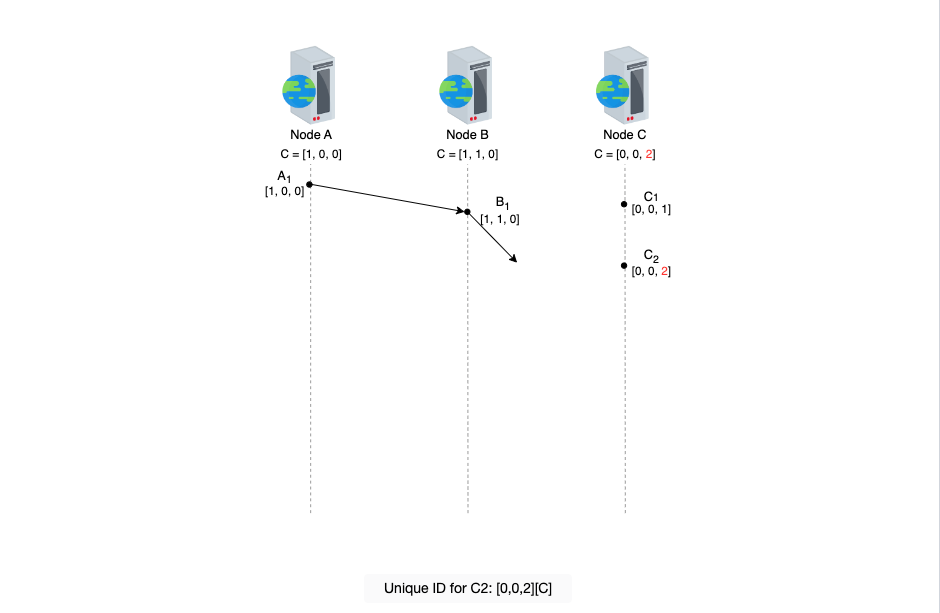
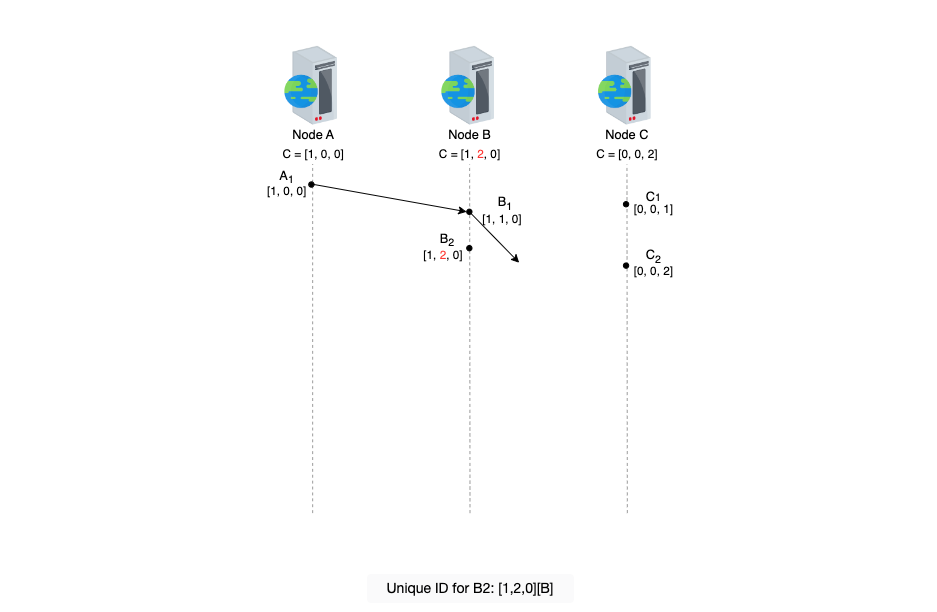
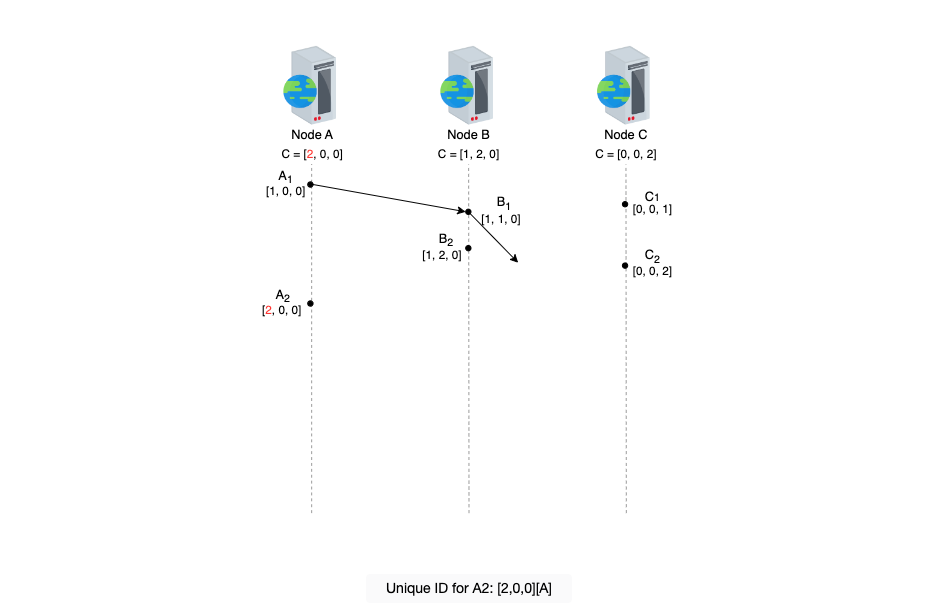
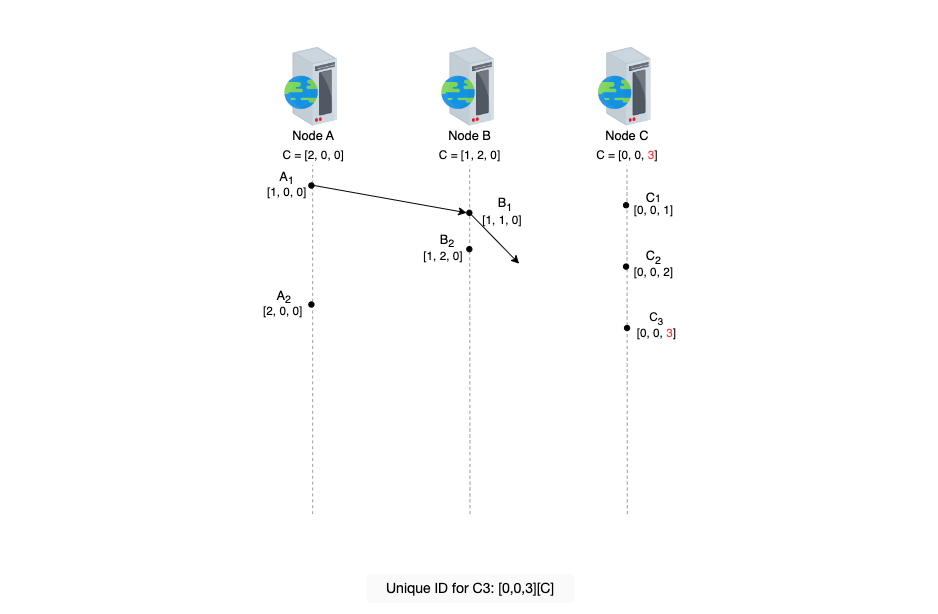
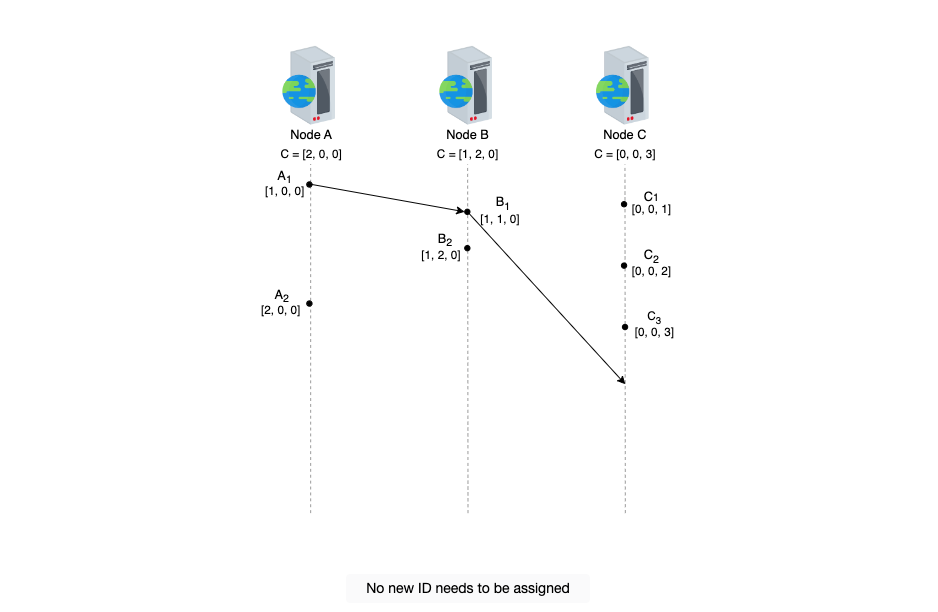
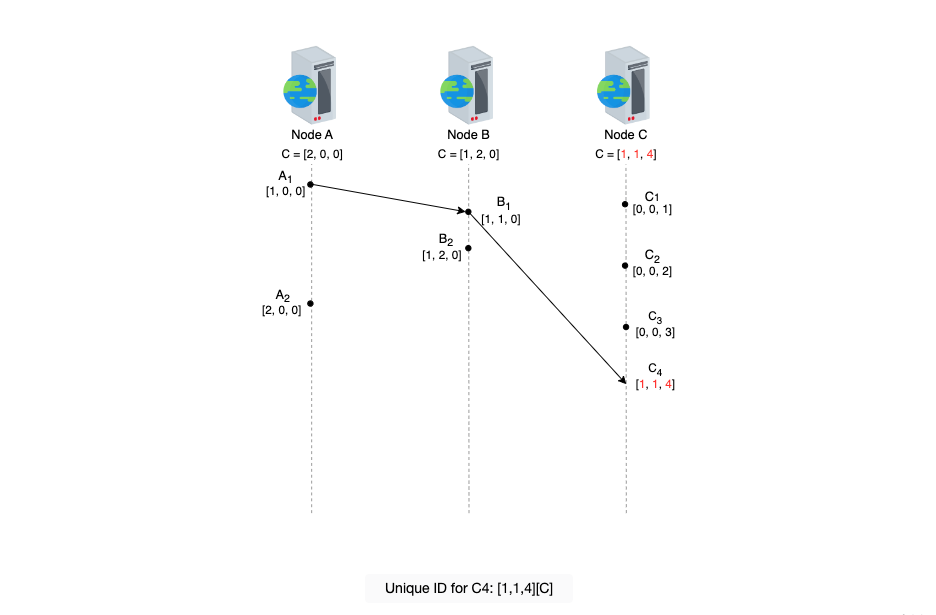
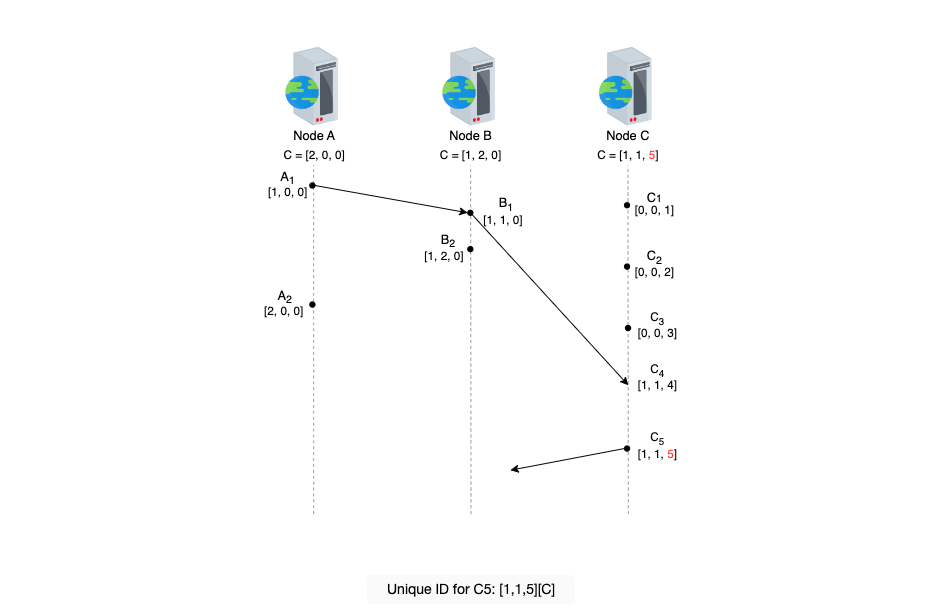
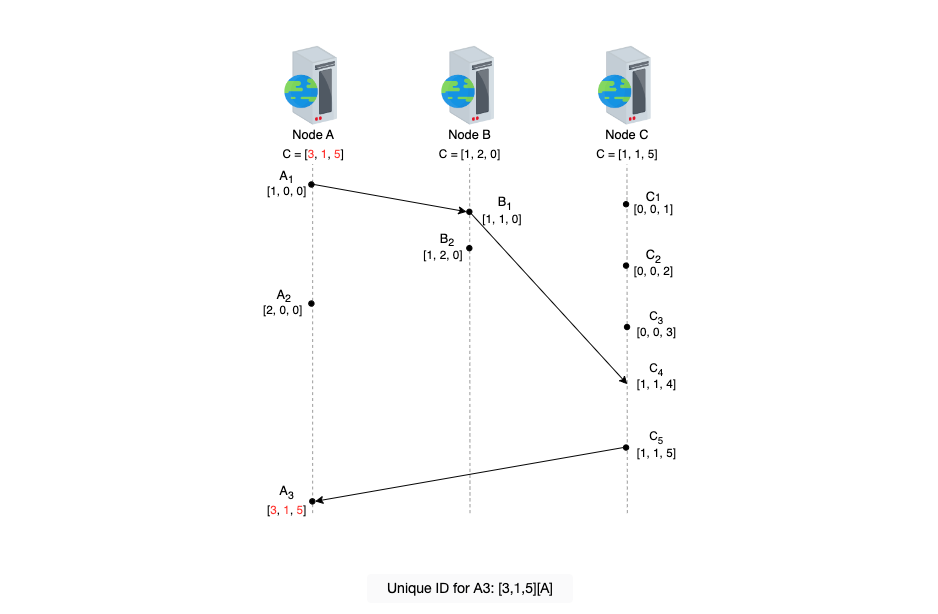
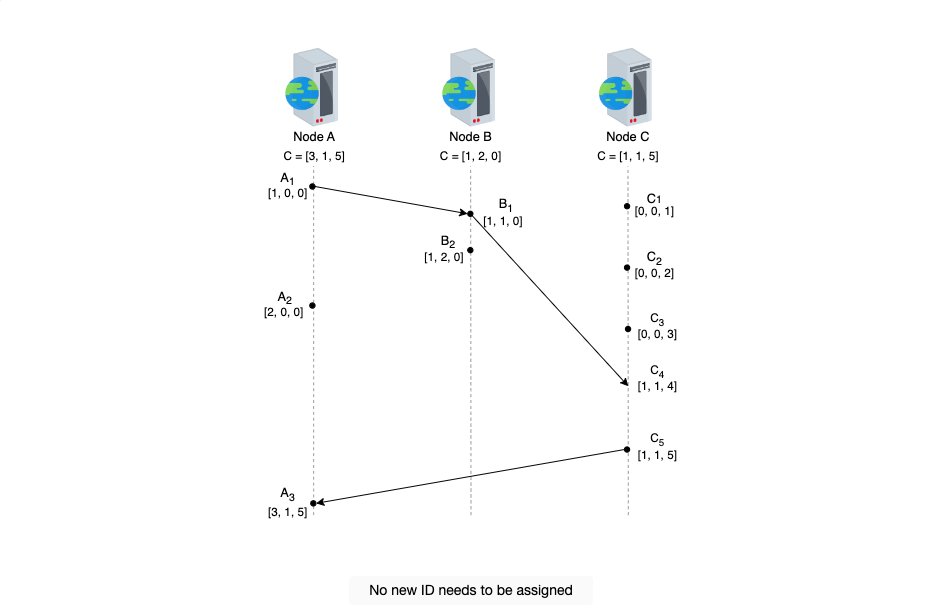
Наш подход с векторными часами работает. Однако для полного захвата причинно-следственных связей размер векторных часов должен составлять не менее n узлов. В результате, когда общее количество участвующих узлов огромное, векторные часы требуют значительного объема хранения. В некоторых современных системах, таких как веб-приложения, каждый браузер считается клиентом системы. Такая информация значительно увеличивает длину идентификатора, что усложняет его обработку, хранение, использование и масштабирование.
Выполнение требований различными подходами
| Требование | Уникальный ID | Масштабируемость | Доступность | 64-битный числовой ID | Сохранение причинности |
|---|---|---|---|---|---|
| Использование UUID | ✖️ | ✔️ | ✔️ | ✖️ | ✖️ |
| Использование базы данных | ✖️ | ✖️ | ✔️ | ✔️ | ✖️ |
| Использование range handler | ✔️ | ✔️ | ✔️ | ✔️ | ✖️ |
| Использование временных меток UNIX | ✖️ | слабая | ✔️ | ✔️ | слабая |
| Использование схемы Twitter Snowflake | ✔️ | ✔️ | ✔️ | ✔️ | слабая |
| Использование векторных часов | ✔️ | слабая | ✔️ | может превышать | ✔️ |
Would a global clock help solve our problem?
Details
Answer
Since we don’t have a global clock, even if each node can assign unique time stamps to the events happening, these time stamps will come from clocks running at different rates. This would make it harder to compare them, and they won’t be unique.However, if we have a global clock that gives us time upon request and is always accurate, then we can maintain the causality of events, as well as a unique ID. Such a clock would be significantly valuable, but time is tricky to handle in distributed systems.
TrueTime API
TrueTime API от Google является важным компонентом системы баз данных Spanner, разработанным для управления распределенными системами, где критически важно точное время событий. Вот подробное объяснение работы TrueTime:
Обзор TrueTime API
-
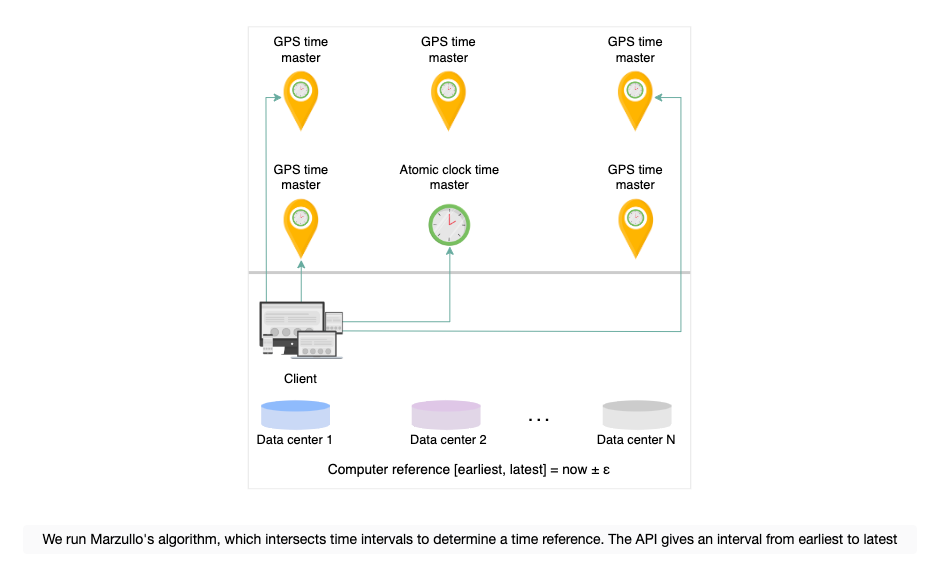
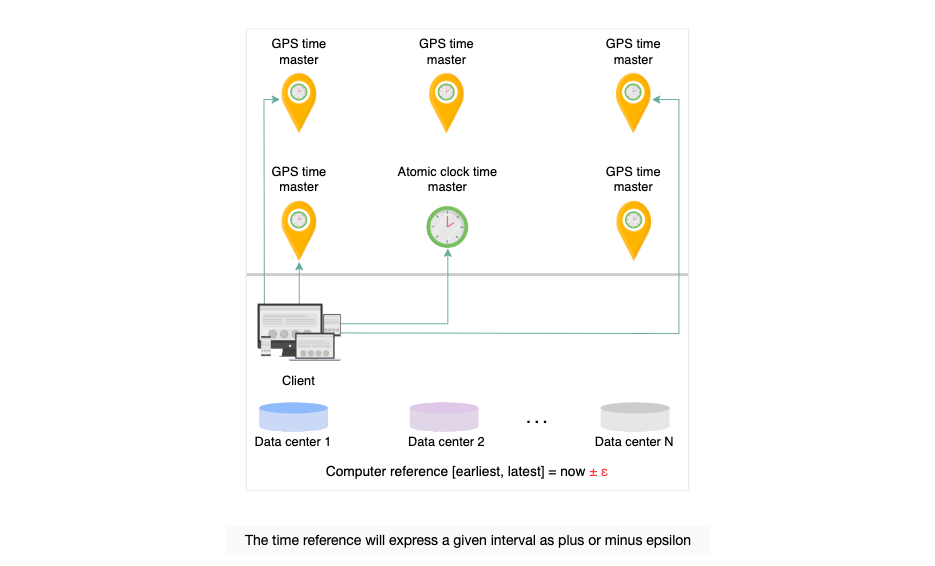
Отчет об интервале времени: Вместо возврата одного временного штампа по запросу, TrueTime предоставляет временной интервал, сообщая самое раннее и самое позднее возможное значение времени. Этот интервал представляет собой неопределенность текущего времени в системе.
-
Неопределенность времени: Фактическое время гарантированно находится в пределах предоставленного интервала. Неопределенность (эпсилон) этого интервала — ключевая особенность TrueTime, отражающая возможное отклонение локальных часов с момента последней синхронизации с более точным источником времени.
Как TrueTime поддерживает точность
- Синхронизация с точными часами:
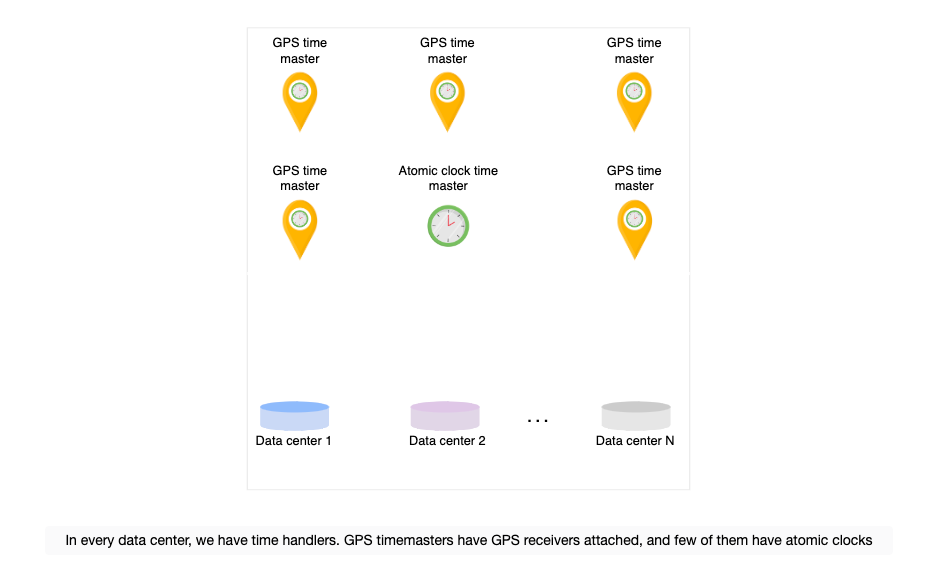
- GPS-приемники и атомные часы: Google устанавливает GPS-приемники и атомные часы в каждом центре обработки данных для обеспечения точной синхронизации времени.
- Синхронизация времени: Часы в разных центрах обработки данных синхронизируются примерно в пределах 7 миллисекунд, что позволяет системе поддерживать минимальную неопределенность (эпсилон) временных интервалов.
- Обработка неопределенности:
- Частота синхронизации часов: Ширина временного интервала, предоставляемого TrueTime, зависит от времени, прошедшего с последней синхронизации. Частая синхронизация с GPS или атомными часами снижает неопределенность.
- Представление эпсилона: Значение эпсилона представляет неопределенность временного интервала. Меньший эпсилон означает, что система недавно синхронизировалась и более уверена в текущем времени.
Роль TrueTime в Spanner
- Глобальная согласованность: TrueTime критически важен для обеспечения строгой согласованности данных в Spanner на разных центрах обработки данных. Используя временные интервалы с минимальной неопределенностью, Spanner может строго соблюдать порядок выполнения событий и транзакций по всему миру.
- Транзакции без блокировок: TrueTime позволяет Spanner выполнять транзакции без использования традиционных механизмов блокировки, обеспечивая соблюдение причинно-следственной связи через временные интервалы.
Иллюстрация работы Time Master Servers TrueTime
TrueTime работает через серверы Time Master в каждом центре обработки данных, которые координируют свою работу с GPS-приемниками и атомными часами, чтобы обеспечить единое представление о времени на всех узлах в разных локациях. Эти серверы часто синхронизируются, чтобы минимизировать неопределенность, что позволяет Spanner использовать TrueTime для точного управления транзакциями в глобально распределенных системах.
Этот подход помогает Google управлять масштабными глобально распределенными системами, поддерживая строгий контроль над порядком событий и согласованностью данных.
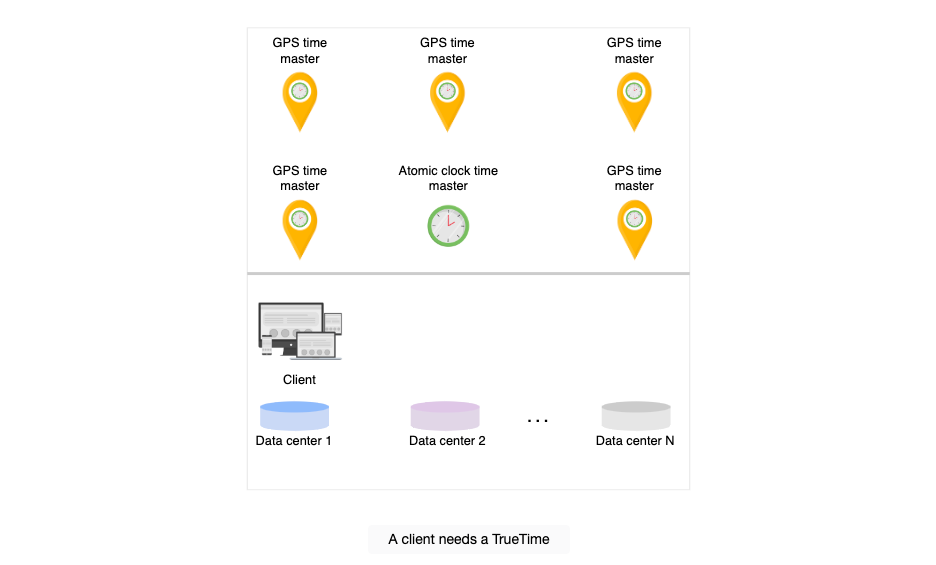
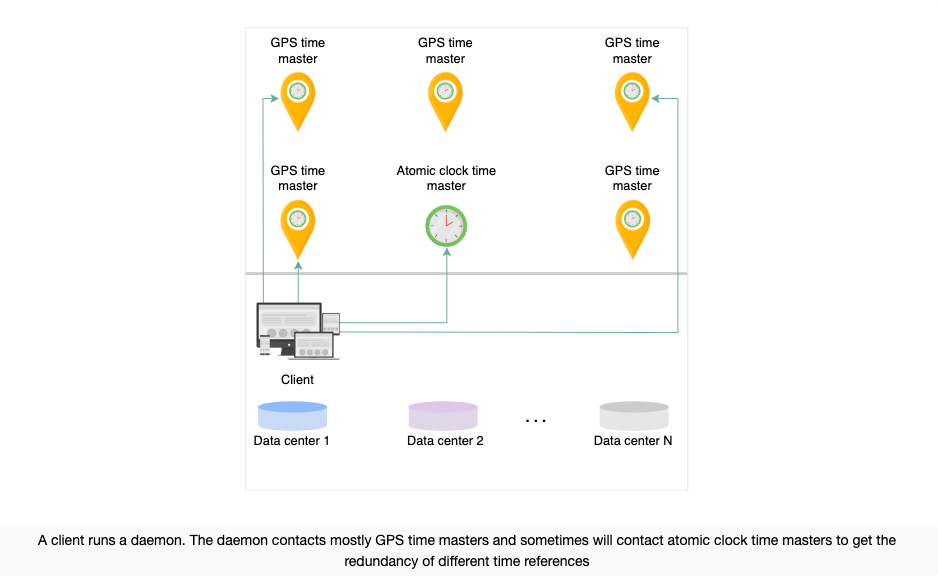
 The following slides explain how time is calculated when the client asks to give TrueTime.
Использование TrueTime для генерации уникальных идентификаторов
Google Spanner гарантирует, что интервалы уверенности не пересекаются (то есть, если
A_{earliest} < A_{latest} < B_{earliest} < B_{latest},
то событие B однозначно произошло после события A).
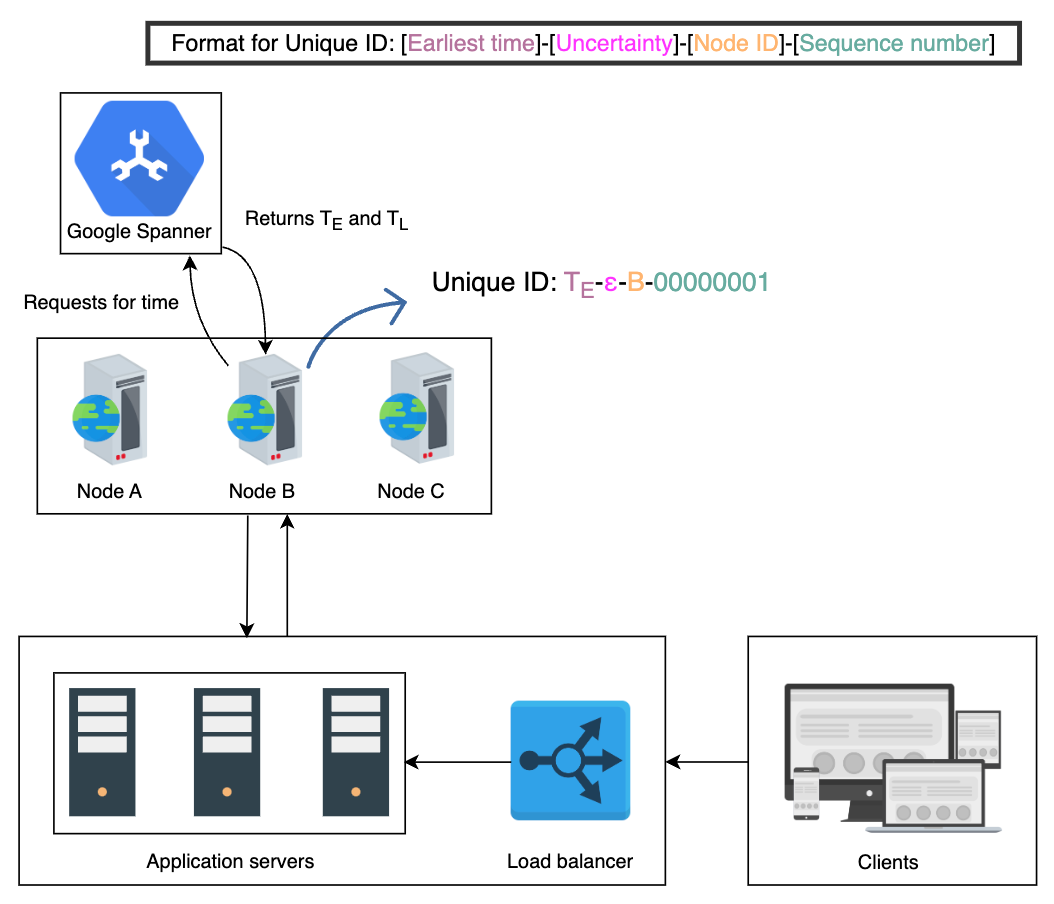
Мы используем интервалы TrueTime для генерации уникальных идентификаторов. Пусть ранний интервал обозначается как
T_E,
поздний как
T_L,
а неопределенность обозначается как ε. Мы используем
T_E
в миллисекундах в качестве временной метки в нашем уникальном идентификаторе.
Структура уникального идентификатора:
-
Временная метка: Временная метка занимает 41 бит. Мы используем
T_Eв качестве временной метки. -
Неопределенность: Неопределенность занимает четыре бита. Так как максимальная неопределенность составляет от 6 до 10 миллисекунд, мы выделим четыре бита для её хранения.
-
Номер рабочей машины: Это поле занимает 10 бит, что дает нам
2^{10} = 1,024возможных идентификатора рабочих машин. -
Порядковый номер: Порядковый номер занимает восемь бит. Для каждого идентификатора, генерируемого сервером, этот номер увеличивается на единицу. Это дает нам
2^{8} = 256комбинаций. После достижения 256, номер сбрасывается на ноль.
Таким образом, используя интервалы TrueTime и комбинируя их с другими полями, мы можем генерировать уникальные идентификаторы, которые не только уникальны, но и сохраняют причинно-следственные отношения между событиями.
Преимущества и недостатки использования TrueTime
Преимущества
TrueTime удовлетворяет все требования. Мы можем генерировать глобально уникальные 64-битные идентификаторы, сохраняя причинно-следственные связи между событиями. Этот подход масштабируем и обладает высокой доступностью.
Недостатки
Если интервалы перекрываются, то мы не можем с уверенностью сказать, в каком порядке произошли события A и B. Возможно, это были параллельные события, но 100% гарантии дать нельзя. Кроме того, Spanner является дорогим решением из-за необходимости поддержания высокой консистентности базы данных. Стоимость создания системы, подобной Spanner, также высока из-за сложной инфраструктуры и постоянного мониторинга.
Обновленная таблица сравнения различных подходов для генерации уникальных идентификаторов
| Требования | UUID | База данных | Обработчик диапазонов | Метки времени UNIX | Twitter Snowflake | Векторные часы | TrueTime |
|---|---|---|---|---|---|---|---|
| Уникальный | ✖️ | ✖️ | ✔️ | ✖️ | ✔️ | ✔️ | ✔️ |
| Масштабируемый | ✔️ | ✖️ | ✔️ | weak | ✔️ | weak | ✔️ |
| Доступный | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ |
| 64-битный числовой ID | ✖️ | ✔️ | ✔️ | ✔️ | ✔️ | Может превышать | ✔️ |
| Поддержка причинности | ✖️ | ✖️ | ✖️ | weak | weak | ✔️ | ✔️ |
Резюме
Избегание дублирования идентификаторов имеет решающее значение, особенно в таких случаях, как создание заказов на оплату или покупку.
UUID обеспечивает вероятностные гарантии отсутствия коллизий ключей. Для детерминированных гарантий может потребоваться консенсус между различными распределенными узлами или чтение из реплицированного хранилища.
Увеличение длины ключа может замедлить обновление кортежей в базе данных. Поэтому идентификаторы должны быть достаточно большими, но не слишком.
Иногда важно, чтобы никто не мог угадать следующий идентификатор. В противном случае это может привести к утечке данных, и конкуренты организации смогут узнать, сколько заказов было обработано за день, просто посмотрев на идентификаторы заказов. Добавление случайных чисел в идентификаторы усложняет их угадывание, хотя это может снизить производительность.
Мы можем использовать простые счетчики для генерации уникальных идентификаторов, если не хотим связывать идентификатор со временем. Получение меток времени медленнее, чем использование простых счетчиков, хотя это требует сохранения сгенерированных идентификаторов. Счетчик нужно хранить в базе данных, что связано с дополнительными проблемами, такими как одновременные записи и возможная точка отказа.
Для некоторых распределенных баз данных, таких как Spanner, использование монотонно увеличивающихся или уменьшающихся идентификаторов может негативно сказаться на производительности из-за создания "горячих точек" в базе данных.
Примечание: Глобальный порядок событий — это дорогостоящая процедура. То, что в централизованной базе данных было быстрым и простым (например, автоинкрементный идентификатор), в распределенной базе данных становится медленным и сложным из-за фундаментальных ограничений (таких как консенсус между удаленными сущностями).